Come una piattaforma musicale leader mondiale ricerca 100M+ brani per suono e testi con Milvus
100M+ brani
L'intero catalogo incorporato e ricercabile, inclusa la coda lunga
~10 ms P99
Una corrispondenza su miliardi di embedding audio, a centinaia di ricerche al secondo.
Per suono e significato
Trova una canzone da un motivo canticchiato, una clip o un testo parafrasato, non solo dal suo titolo.
Informazioni sulla piattaforma musicale
La piattaforma è uno dei più grandi servizi di streaming musicale al mondo, con un catalogo di oltre 100 milioni di brani e centinaia di milioni di ascoltatori in più di 100 paesi.
I suoi ascoltatori fanno molto più che premere play. Alzano il telefono per identificare una canzone che suona dall'altra parte della stanza, digitano una frase ricordata a metà per trovare un brano, chiedono "più roba simile" per riempire una serata e caricano il proprio audio che deve essere verificato rispetto al catalogo per i diritti. Ognuna di queste azioni cerca nell'intero catalogo, e deve centrare il brano giusto all'istante. Quel livello di ricerca funziona su Milvus.
La sfida
Il catalogo della piattaforma supera i 100 milioni di brani, e il modo in cui gli ascoltatori lo cercano ha creato tre esigenze contemporaneamente.
La ricerca musicale deve funzionare su suono e significato, non solo su parole chiave. Un ascoltatore canticchia una melodia, riproduce cinque secondi da un altoparlante o digita un testo come lo ricorda, non come è stato scritto. Non c'è un titolo o un tag su cui basare la corrispondenza. La piattaforma aveva bisogno di una ricerca che funzioni su come suona una canzone e su cosa significa un testo — qualcosa che la sola corrispondenza per parole chiave non può fare.
Il catalogo è fatto di miliardi di vettori, e tutto deve rimanere ricercabile. La corrispondenza basata sul suono significa suddividere ogni brano in brevi segmenti e creare un embedding per ciascuno, così oltre 100 milioni di brani diventano miliardi di vettori audio, più un vettore testuale per ogni set di testi. Tutti devono rimanere online contemporaneamente, inclusa la coda lunga, altrimenti il brano oscuro che nessuno ascolta da un anno è esattamente quello che la ricerca non riesce a trovare.
Ogni ricerca deve restituire risultati in tempo reale, su larga scala. Identificare una canzone o rispondere a una query relativa ai testi è qualcosa che l'ascoltatore attende, quindi deve arrivare in pochi millisecondi, a centinaia di ricerche al secondo, attraverso quei miliardi di vettori. La velocità non può degradare mentre il catalogo continua a crescere.
Perché Milvus
Milvus risponde direttamente a tutte e tre le esigenze, ed è per questo che il team ha costruito la propria ricerca su di esso.
Progettato appositamente per la ricerca vettoriale, full-text e con filtri sui metadati in un'unica query. Milvus memorizza gli embedding audio e dei testi e trova i vicini più prossimi in base a come suona un clip o cosa significa un testo, così un canticchiamento o una frase parafrasata arriva al brano giusto. Per i testi, combina la ricerca full-text per parole chiave con la ricerca vettoriale in un'unica query ibrida — abbinando insieme parole e significato — e applica i filtri sui metadati (artista, genere, territorio, diritti) nella stessa chiamata. Questa è una ricerca ibrida che un sistema basato solo su parole chiave non può offrire.
Collaudato su miliardi di vettori. Milvus è un database distribuito progettato per collezioni su scala di miliardi, quindi l'intero catalogo embedded vive in un unico sistema e scala orizzontalmente con il cluster man mano che la libreria cresce, senza dover riprogettare l'architettura a ogni nuovo traguardo.
Latenza in millisecondi con throughput elevato. Milvus restituisce una corrispondenza in circa 10 millisecondi a centinaia di query al secondo su miliardi di vettori, e isola l'indicizzazione pesante dalle query in tempo reale, così la ricerca rimane veloce mentre vengono aggiunti nuovi brani.
Open source, eseguito sulla propria infrastruttura. Oltre a soddisfare queste esigenze, Milvus è open source, quindi i team che operano a questa scala lo eseguono sulla propria infrastruttura, lo ottimizzano e lo estendono in base al carico di lavoro e lo integrano nel proprio stack senza lock-in del fornitore.
La soluzione
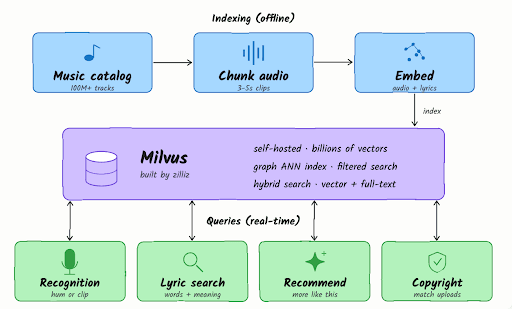
Milvus è il livello di ricerca per similarità alla base di ogni funzione che trova musica in base a come suona o a cosa significa. Sia l'audio che il testo diventano vettori e vivono in Milvus accanto ai metadati usati per filtrarli.
 Anonymous Music Insert.png
Indicizzazione del catalogo. Ogni traccia viene suddivisa in brevi clip sovrapposti e un modello audio trasforma ogni clip in un vettore che cattura il suo suono: timbro, melodia e ritmo. Una traccia diventa quindi una sequenza di vettori, uno ogni pochi secondi, invece di un singolo punto. I testi delle canzoni sono gestiti separatamente da un modello testuale: ogni insieme viene incorporato come vettore e indicizzato per la ricerca full-text, così una query può corrispondere per significato o per parole esatte. Artista, album, genere, data di pubblicazione, popolarità e territorio/diritti sono scritti come campi scalari sugli stessi record. I clip audio formano una collection su scala miliardaria; i vettori dei testi, l'indice full-text e i metadati si trovano accanto ad essi. Un indice ANN basato su grafi (HNSW) mantiene un recall rapido, e gli indici scalari rendono i metadati filtrabili.
Rispondere a una query. Quattro funzionalità di prodotto si risolvono tutte in una ricerca di similarità su Milvus:
- Riconoscimento dei brani. Pochi secondi di audio catturato vengono incorporati e cercati nella collection audio di Milvus, dove ogni traccia è memorizzata come molti brevi clip in ordine. La registrazione corrisponde a una sequenza di clip consecutivi della stessa canzone, cosa che solo la traccia giusta può produrre, così Milvus la associa a quell'unica canzone e la restituisce in tempo reale.
- Ricerca dei testi. Ogni testo è memorizzato in Milvus con un vettore denso semantico e un indice full-text (BM25) sullo stesso record, così una singola ricerca ibrida abbina significato e formulazione e restituisce un'unica lista classificata. Che un ascoltatore ricordi il verso parola per parola o solo il senso generale, la query atterra sulla canzone giusta.
- Raccomandazione. La traccia che un ascoltatore sta riproducendo diventa la query e Milvus restituisce tracce sonicamente simili per la radio e la scoperta, filtrate in base al territorio e ai gusti dell'ascoltatore.
- Corrispondenza per il copyright. Un clip caricato viene suddiviso in blocchi e cercato nel catalogo; una sequenza di corrispondenze ad alta similarità segnala il riutilizzo di materiale protetto e i campi dei diritti risolvono la proprietà.
Tutte e quattro le funzionalità cercano gli stessi dati in Milvus: gli stessi vettori audio e dei testi, gli stessi metadati e gli stessi filtri trasportati in ogni query. Ciò che differisce è la messa a punto. Il team gestisce in self-hosting il livello di recupero come una flotta di cluster Milvus e dimensiona ciascuno per il proprio compito: il percorso di riconoscimento per la latenza più bassa, le collection dell'intero catalogo per throughput e recall man mano che scalano verso i miliardi. La nuova musica scorre attraverso lo stesso percorso di indicizzazione ed è ricercabile nel momento in cui arriva.
Risultati e vantaggi
- Qualsiasi canzone viene identificata in circa 10 millisecondi, a centinaia di ricerche al secondo. Pochi secondi di audio, o una singola riga di testo, restituiscono la traccia esatta abbastanza rapidamente da sembrare istantanea all'ascoltatore, anche sotto carico concorrente elevato.
- Tutte le oltre 100 milioni di tracce restano ricercabili, attraverso miliardi di vettori. Ogni traccia è incorporata e online, inclusa la coda lunga, così nessuna canzone è introvabile perché il catalogo è cresciuto troppo.
- Le canzoni si trovano per suono e per significato, non solo per titolo. Una melodia canticchiata, un clip di cinque secondi o un testo ricordato male si risolvono nella traccia giusta, cosa che la ricerca per parole chiave non potrebbe mai fare.
- Riconoscimento, ricerca dei testi, raccomandazione e corrispondenza per il copyright girano su un unico motore. Una nuova funzionalità audio parte da un livello che cerca già l'intero catalogo in tempo reale, non da un nuovo sistema da avviare.
- Tutto gira sull'infrastruttura del team, scalando tramite la crescita del cluster. Man mano che traffico e catalogo crescono, il team aggiunge capacità ai cluster Milvus che già gestisce, senza riprogettare il livello di ricerca.
Il vantaggio strategico è che "cercare per suono" smette di essere un progetto e diventa una capacità. Qualunque cosa la piattaforma voglia costruire su come suona la musica parte da una base che già cerca tutte le oltre 100 milioni di tracce in tempo reale.
Inizia con Milvus
Milvus è il database vettoriale open source più adottato al mondo, con 46K+ stelle su GitHub, progettato per la ricerca di similarità su scala miliardaria. Funziona ovunque, da un laptop a un cluster distribuito, e offre ai team il pieno controllo su come indicizzare, filtrare e scalare i carichi di lavoro vettoriali.
Inizia con Milvus su GitHub, leggi la documentazione oppure unisciti alla community su Discord.
I team che preferiscono non gestire Milvus direttamente possono utilizzare lo stesso motore come servizio completamente gestito su Zilliz Cloud, con un piano gratuito per iniziare.
- Informazioni sulla piattaforma musicale
- La sfida
- Perché Milvus
- La soluzione
- Risultati e vantaggi
- Inizia con Milvus
Contenuto
Settore
Intrattenimento