Cómo una plataforma musical líder mundial busca más de 100 millones de canciones por sonido y letra con Milvus
100M+ pistas
El catálogo completo integrado y buscable, incluida la cola larga
~10 ms P99
Una coincidencia entre miles de millones de incrustaciones de audio, a cientos de búsquedas por segundo.
Por el sonido y el significado
Encuentra una canción a partir de un tarareo, un clip o una letra parafraseada, no solo su título.
Acerca de la plataforma de música
La plataforma es uno de los servicios de streaming de música más grandes del mundo, con un catálogo de más de 100 millones de pistas y cientos de millones de oyentes en más de 100 países.
Sus oyentes hacen mucho más que presionar play. Levantan el teléfono para identificar una canción que suena al otro lado de la habitación, escriben una línea recordada a medias para encontrar una pista, piden "más como esta" para llenar una noche y suben su propio audio que debe verificarse contra el catálogo por derechos. Cada búsqueda recorre todo el catálogo y debe dar con la pista correcta al instante. Esa capa de búsqueda se ejecuta en Milvus.
El desafío
El catálogo de la plataforma supera los 100 millones de pistas, y la forma en que los oyentes lo buscan creó tres exigencias a la vez.
La búsqueda de música debe funcionar por sonido y significado, no solo por palabras clave. Un oyente tararea una melodía, reproduce cinco segundos desde un altavoz o escribe una letra como la recuerda, no como fue escrita. No hay título ni etiqueta para buscar. La plataforma necesitaba una búsqueda que funcionara por cómo suena una canción y por lo que significa una letra — algo que la coincidencia de palabras clave por sí sola no puede lograr.
El catálogo son miles de millones de vectores, y todo debe seguir siendo buscable. La coincidencia por sonido implica dividir cada pista en segmentos cortos y generar un embedding para cada uno, de modo que más de 100 millones de pistas se convierten en miles de millones de vectores de audio, más un vector de texto por cada conjunto de letras. Todos deben permanecer en línea a la vez, incluida la cola larga; de lo contrario, la pista oscura que nadie ha reproducido en un año es exactamente la que la búsqueda no encuentra.
Cada búsqueda debe responder en tiempo real, a escala. Identificar una canción o responder a una consulta de letra es algo que el oyente espera, por lo que debe devolverse en milisegundos, a cientos de búsquedas por segundo, entre esos miles de millones de vectores. La velocidad no puede degradarse a medida que el catálogo sigue creciendo.
Por qué Milvus
Milvus responde directamente a las tres exigencias, por eso el equipo construyó su búsqueda sobre él.
Diseñado específicamente para búsqueda vectorial, de texto completo y filtrada por metadatos en una sola consulta. Milvus almacena los embeddings de audio y letras y encuentra los vecinos más cercanos según cómo suena un clip o qué significa una letra, de modo que un tarareo o una línea parafraseada se resuelve en la pista correcta. Para las letras, combina la búsqueda por palabras clave de texto completo con la búsqueda vectorial en una única consulta híbrida — uniendo las palabras y el significado — y aplica filtros de metadatos (artista, género, territorio, derechos) en la misma llamada. Eso es búsqueda híbrida que un sistema solo de palabras clave no puede ofrecer.
Probado con miles de millones de vectores. Milvus es una base de datos distribuida diseñada para colecciones a escala de miles de millones, por lo que todo el catálogo embebido vive en un solo sistema y se escala horizontalmente con el clúster a medida que crece la biblioteca, sin necesidad de re-arquitecturar en cada nuevo hito.
Latencia de milisegundos con alto rendimiento. Milvus devuelve una coincidencia en aproximadamente 10 milisegundos a cientos de consultas por segundo entre miles de millones de vectores, y aísla la indexación pesada de las consultas en vivo para que la búsqueda siga siendo rápida mientras se añade música nueva.
Código abierto, ejecutado en su propia infraestructura. Más allá de cumplir con estas exigencias, Milvus es de código abierto, por lo que los equipos que operan a esta escala lo ejecutan en su propia infraestructura, lo ajustan y extienden según su carga de trabajo, y lo integran en su stack sin dependencia del proveedor.
La solución
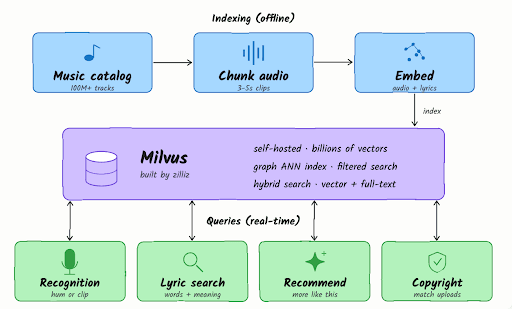
Milvus es la capa de búsqueda por similitud que sustenta toda función que encuentra música por cómo suena o qué significa. Tanto el audio como el texto se convierten en vectores y viven en Milvus junto a los metadatos utilizados para filtrarlos.
 Anonymous Music Insert.png
Indexación del catálogo. Cada pista se corta en clips cortos y superpuestos, y un modelo de audio convierte cada clip en un vector que captura cómo suena: su timbre, melodía y ritmo. Una pista se convierte así en una secuencia de vectores, uno cada pocos segundos, en lugar de un único punto. Las letras se procesan por separado con un modelo de texto: cada conjunto se incrusta como un vector y se indexa para búsqueda de texto completo, de modo que una consulta puede coincidir por significado o por las palabras exactas. Artista, álbum, género, fecha de lanzamiento, popularidad y territorio/derechos se escriben como campos escalares en los mismos registros. Los clips de audio forman una colección a escala de miles de millones; los vectores de letras, el índice de texto completo y los metadatos se encuentran junto a ellos. Un índice ANN basado en grafos (HNSW) mantiene un recall rápido, y los índices escalares hacen que los metadatos sean filtrables.
Responder a una consulta. Cuatro funciones del producto se resuelven mediante una búsqueda de similitud en Milvus:
- Reconocimiento de canciones. Unos segundos de audio capturado se incrustan y se buscan en la colección de audio de Milvus, donde cada pista se almacena como muchos clips cortos en orden. La grabación coincide con una secuencia de clips consecutivos de la misma canción, algo que solo la pista correcta puede producir, por lo que Milvus la asocia a esa única canción y la devuelve en tiempo real.
- Búsqueda de letras. Cada letra se almacena en Milvus con un vector denso semántico y un índice de texto completo (BM25) en el mismo registro, de modo que una única búsqueda híbrida combina significado y redacción y devuelve una lista clasificada. Tanto si el oyente recuerda la frase palabra por palabra como si solo recuerda su esencia, la consulta llega a la canción correcta.
- Recomendación. La pista que está sonando para el oyente se convierte en la consulta, y Milvus devuelve pistas sonoramente similares para radio y descubrimiento, filtradas según el territorio y los gustos del oyente.
- Coincidencia de derechos de autor. Un clip subido se divide en fragmentos y se busca en el catálogo; una serie de coincidencias de alta similitud señala la reutilización de material protegido, y los campos de derechos resuelven la propiedad.
Las cuatro funciones buscan en los mismos datos de Milvus: los mismos vectores de audio y letras, los mismos metadatos y los mismos filtros incluidos en cada consulta. Lo que difiere es la afinación. El equipo aloja la capa de recuperación en sus propias instalaciones como una flota de clústeres de Milvus y dimensiona cada uno según su tarea: la ruta de reconocimiento para la latencia más baja, las colecciones de catálogo completo para rendimiento y recall a medida que crecen hasta los miles de millones. La música nueva fluye por la misma ruta de indexación y se puede buscar en el momento en que llega.
Resultados y beneficios
- Cualquier canción se identifica en unos 10 milisegundos, a cientos de búsquedas por segundo. Unos segundos de audio, o una sola línea de texto, devuelven la pista exacta con la rapidez suficiente para que el oyente lo perciba como instantáneo, incluso bajo alta carga concurrente.
- Todas las más de 100 millones de pistas siguen siendo buscables, entre miles de millones de vectores. Cada pista está incrustada y en línea, incluida la cola larga, de modo que ninguna canción deja de ser encontrable porque el catálogo creció demasiado.
- Las canciones se encuentran por sonido y por significado, no solo por título. Una melodía tarareada, un clip de cinco segundos o una letra recordada a medias se resuelven en la pista correcta, algo que la búsqueda por palabras clave nunca podría hacer.
- El reconocimiento, la búsqueda de letras, la recomendación y la coincidencia de derechos de autor funcionan con un solo motor. Una nueva función de audio parte de una capa que ya busca en el catálogo completo en tiempo real, no de un sistema nuevo que haya que poner en marcha.
- Todo funciona en la infraestructura propia del equipo, escalando al crecer el clúster. A medida que crecen el tráfico y el catálogo, el equipo añade capacidad a los clústeres de Milvus que ya opera, sin rediseñar la capa de búsqueda.
La recompensa estratégica es que la “búsqueda por sonido” deja de ser un proyecto y se convierte en una capacidad. Cualquier cosa que la plataforma quiera construir sobre cómo suena la música parte de una base que ya busca todas las más de 100 millones de pistas en tiempo real.
Primeros pasos con Milvus
Milvus es la base de datos vectorial de código abierto más adoptada del mundo, con más de 46K estrellas en GitHub, diseñada para búsqueda de similitud a escala de miles de millones. Se ejecuta en cualquier lugar, desde una laptop hasta un clúster distribuido, y brinda a los equipos control total sobre cómo indexar, filtrar y escalar cargas de trabajo vectoriales.
Comienza con Milvus en GitHub, lee la documentación o únete a la comunidad en Discord.
Los equipos que prefieran no ejecutar Milvus ellos mismos pueden usar el mismo motor como un servicio totalmente administrado en Zilliz Cloud, con un plan gratuito para comenzar.
- Acerca de la plataforma de música
- El desafío
- Por qué Milvus
- La solución
- Resultados y beneficios
- Primeros pasos con Milvus
Contenido
Industria
Entretenimiento