




Как создать RAG-агента LangChain с отчетностью
Одной из важнейших частей перевода AI Agents в продакшен с вашими приложениями retrieval augmented generation является мониторинг того, что они делают под поверхностью. На рынке доступно множество инструментов мониторинга, таких как Arize, TruEra и Portkey. В этом примере мы создаем AI Agent с LangChain, Milvus и OpenAI. Затем мы используем Portkey для мониторинга использования токенов, количества токенов и задержки запросов. Найдите код для AI Agents Cookbooks в этом репозитории GitHub.
Введение в технологический стек
Прежде чем перейти к коду, давайте кратко рассмотрим компоненты этого технологического стека. В этом руководстве мы используем четыре основные технологии: LangChain для оркестрации вашего приложения retrieval augmented generation, Milvus в качестве нашей векторной базы данных для хранения и отправки релевантной информации в одну из ваших любимых больших языковых моделей (LLM), Portkey для систем мониторинга и OpenAI для нашей LLM.
LangChain
LangChain — самый популярный open-source фреймворк оркестрации LLM по состоянию на май 2024 года. Это один из многих фреймворков на рынке для retrieval augmented generation. Специализация LangChain — chaining. Он особенно подходит для сборки входных данных (или релевантных данных) и выходных данных больших языковых моделей (LLMs) и других связанных функций. Подробнее о различиях между тремя популярными фреймворками можно прочитать в этой статье о LangChain vs. LlamaIndex vs. Haystack.
Milvus
Milvus — самая популярная open-source и единственная распределенная векторная база данных, которую часто используют для хранения ваших многочисленных источников данных при создании приложений retrieval augmented generation. Milvus особенно хорошо выполняет поиск по векторному сходству с точки зрения масштабируемости, гибкости и функций, готовых для enterprise, по сравнению с другими векторными базами данных. Для этого руководства мы запустим Milvus через Docker Compose.
Portkey
Portkey представлял самый популярный open-source LLM Gateway в мае 2024 года. Это одно из многих решений мониторинга для приложений LLM. Portkey обеспечивает мониторинг, маршрутизируя вызовы через свой gateway. Он отслеживает стоимость, количество токенов и задержку ваших вызовов. Portkey также позволяет настраивать вспомогательные инструменты, такие как семантический кэш, аналогичный GPTCache.
OpenAI
OpenAI привлекла внимание широкой публики к LLM через ChatGPT. С тех пор они выпустили несколько разных версий GPT и побудили многих конкурентов, таких как Mistral, Meta AI и другие, выйти на рынок.
Создание LangChain RAG Agent
Теперь, когда мы знаем основные технологии, с которыми работаем, давайте создадим наш LangChain Retrieval Augmented Generation (RAG) Agent. Вы можете выполнить строки ниже в ячейке Python notebook, либо запустить их напрямую в терминале без ! в начале. Нам нужны пять обязательных библиотек и необязательная шестая.
Пять обязательных библиотек:
pymilvusдля действий Milvuslangchainдля LangChainlangchain-communityдля community-интеграций, включая интеграцию Milvus + LangChainlangchain-openaiдля библиотеки OpenAI + LangChainunstructuredдля помощи в загрузке данных
Шестая необязательная библиотека — langchainhub. Мы используем эту библиотеку для доступа к промптам агентов из LangChain hub, чтобы нам не пришлось писать их самим. Вторая команда, `docker compose up—d', запускает Docker compose file для запуска Milvus.
! pip install --upgrade --quiet pymilvus langchain langchain-community langchainhub langchain-openai unstructured
! docker-compose up -d
Настройка
Первая часть создания нашего RAG-агента проста. Здесь мы лишь загружаем переменные окружения и выполняем ряд импортов. Две переменные окружения, которые нам понадобятся, — это API-ключ Portkey и API-ключ OpenAI. От ключа Portkey можно отказаться, если мы размещаем его локально.
from dotenv import load_dotenv
import os

load_dotenv()

OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]
PORTKEY_API_KEY = os.environ["PORTKEY_API_KEY"]
Я разделю импорты на два раздела: связанные с LangChain и связанные с Portkey. Нам нужно девять импортов из LangChain. Нам нужны:
- DirectoryLoader для загрузки данных из указанной директории
- RecursiveCharacterTextSplitter для разбиения текста в наших документах
- Milvus, для подключения к Milvus
- OpenAIEmbeddings для создания векторов эмбеддингов
hub— это LangChain hub, из которого мы берем промптыcreate_retriever_toolдля создания инструмента, который может извлекать данные- ChatOpenAI для использования GPT в качестве чат-эндпоинта
- AgentExecutor для выполнения агента
И
create_openai_tools_agentдля создания агента из инструментов и эндпоинта OpenAI
Нам нужно три импорта для управления Portkey: URL Portkey Gateway, функция для создания заголовков и библиотека UUID для отслеживания каждого запуска.
from langchain_community.document_loaders import DirectoryLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import Milvus
from langchain_openai import OpenAIEmbeddings
from langchain import hub
from langchain.tools.retriever import create_retriever_tool
from langchain_openai import ChatOpenAI
from langchain.agents import AgentExecutor, create_openai_tools_agent

from portkey_ai import PORTKEY_GATEWAY_URL, createHeaders
import uuid
Загрузка документов в Milvus
Первый шаг в создании RAG-агента — отправить ваши источники данных, в данном случае документы, в Milvus. Сначала мы определяем наш разделитель текста. Для этого примера мы задаем размер фрагмента и перекрытие фрагментов. Эти две концепции используются для разбиения большого документа на фрагменты разумного размера. Перекрытие помогает учитывать извлечение контекстной информации и непрерывность.
Когда разделитель текста готов, мы загружаем директорию и разбиваем ее на документы LangChain с помощью разделителя текста. Затем мы определяем нашу функцию эмбеддингов, в данном случае используя языковую модель OpenAIEmbeddings. Теперь, когда документ и функция эмбеддингов готовы, мы подключаемся к Milvus и загружаем фрагменты с помощью функции OpenAI embeddings.
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1024, chunk_overlap=128)
loader = DirectoryLoader("../city_data")
docs = loader.load_and_split(text_splitter=text_splitter)
embeddings = OpenAIEmbeddings()
db = Milvus.from_documents(
   docs,
   embeddings,
   connection_args={"host": "127.0.0.1", "port": "19530"})
Создание инструмента ретривера для RAG
Первый шаг в построении RAG — загрузить документы в векторную базу данных, такую как Milvus. При использовании фреймворка вроде LangChain следующий шаг — компонент извлечения информации, который превращает источники данных векторной базы данных в «ретривер». Этот объект автоматически принимает строку, векторизует ее и ищет в векторной базе данных релевантные ответы.
Поскольку мы создаем AI-агента, мы должны превратить наш ретривер в инструмент. Для создания инструмента ретривера в LangChain требуется три параметра: сама модель ретривера, имя инструмента и описание его функции.
Теперь мы создаем список инструментов и добавляем этот инструмент ретривера. Этот шаг станет важным позже.
retriever = db.as_retriever()
tool = create_retriever_tool(
   retriever,
   "search_cities",
   "Searches and returns excerpts from Wikipedia entries of many cities.",
)
tools = [tool]
Настройка RAG-агента
Мы начинаем настройку RAG-агента с получения промпта. Мы можем создать промпт или получить его напрямую из LangChain hub, где у Harrison Chase уже есть готовый промпт для агента, построенного на OpenAI. Последнее, что нам нужно создать перед получением LLM, — это наши заголовки Portkey.
Мы используем Portkey здесь, чтобы отслеживать наше использование и проверять внутренние детали наших вызовов LLM, такие как задержка, количество использованных токенов и стоимость. Для наших заголовков Portkey нам нужны четыре вещи: Portkey API Key, UUID, имя провайдера LLM (OpenAI) и конфигурация Portkey. Файл конфигурации может быть любой конфигурацией; вы можете создать конфигурацию по умолчанию для пользовательской панели управления.
Далее мы создаем экземпляр нашего LLM через ChatOpenAI. Нам нужны четыре параметра: OpenAI API key, Portkey gateway URL, заголовки Portkey и температура LLM. Когда всё это готово, мы можем создать агента с помощью create_openai_tools_agent. Для создания агента нам нужны всего три параметра: LLM, список инструментов и промпт.
prompt = hub.pull("hwchase17/openai-tools-agent")

portkey_headers = createHeaders(
   api_key=PORTKEY_API_KEY,
   trace_id=uuid.uuid4(),
   provider="openai",
   config="pc-basic-b390c9"
)
llm = ChatOpenAI(api_key=OPENAI_API_KEY, base_url=PORTKEY_GATEWAY_URL, default_headers=portkey_headers, temperature=0)

agent = create_openai_tools_agent(llm, tools, prompt)
Пробуем RAG-агента
Последний шаг — создать функцию для выполнения задач нашим агентом, и тогда наш агент наконец будет готов к работе в поле. Странное название, если задуматься. В любом случае функция, которая может выполнять наш агентный workflow, принимает два параметра: tool agent и сами инструменты.
agent_executor = AgentExecutor(agent=agent, tools=tools)
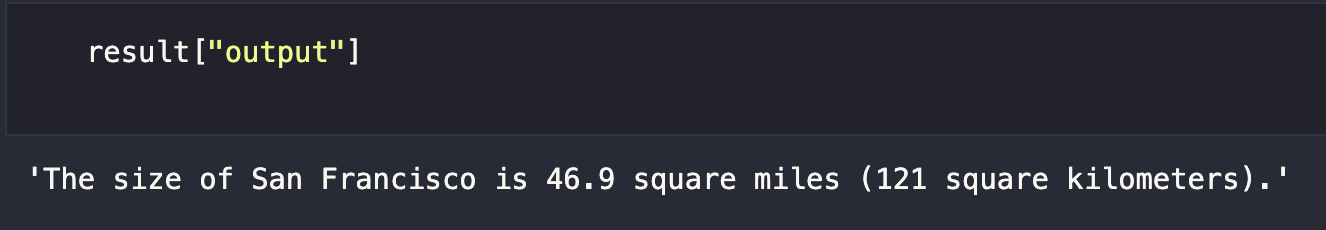
Когда наш агент готов к выполнению, мы можем вызвать его с входными данными. В этом примере мы просим его узнать размер San Francisco.
result = agent_executor.invoke(
   {
       "input": "What is the size of San Francisco?"
   }
)
Агент может извлекать информацию из документов, созданных на странице Wikipedia о San Francisco. Он сообщает нам, что размер San Francisco составляет 46,9 квадратных миль или 121 квадратный километр.
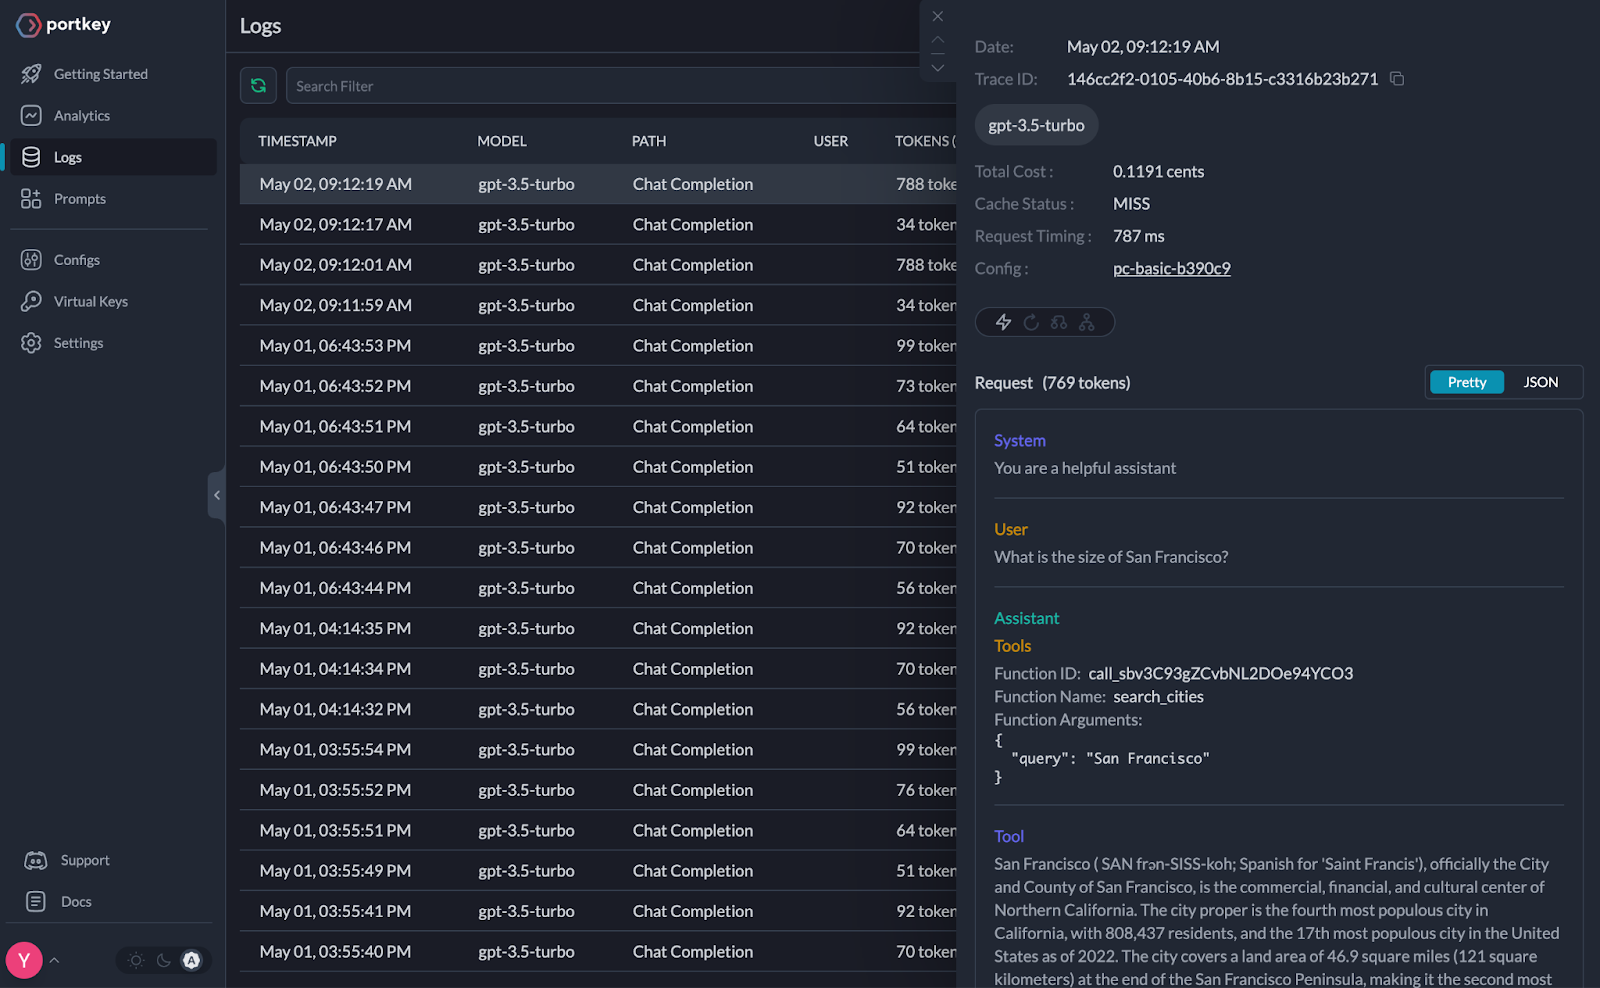
Чтобы проверить наш мониторинг и увидеть, как работает наш LangChain RAG Agent, мы можем просто посмотреть dashboard Portkey. Мы видим, что этот конкретный вопрос RAG-агенту обошелся нам в 0,1191 цента, занял 787 мс и использовал 769 токенов.
Краткое изложение создания LangChain RAG Agent
В этом руководстве мы узнали, как построить AI Agent, который выполняет RAG с использованием LangChain. Помимо AI Agent, мы можем отслеживать стоимость, задержку и использование токенов нашим агентом с помощью gateway. Gateway, который мы выбрали для этого конкретного руководства, — Portkey.
В создании, использовании и мониторинге этого LangChain RAG Agent было пять шагов. Сначала нам пришлось пройти самый скучный шаг — настройку. После базовой настройки мы импортировали наши внешние знания (документы) в Milvus, чтобы выполнять семантический поиск для эффективного извлечения. Затем мы превратили наш объект LangChain Milvus в retriever, а этот retriever — в retriever tool.
Если бы мы остановились на этапе извлечения, у нас была бы основа для стандартного RAG. Создание инструмента позволяет нам построить поверх него агента. Когда инструмент был готов, мы определили LLM, маршрутизируемую через gateway (Portkey), и предоставили ей доступ к инструментам. Затем мы задали нашему RAG Agent вопрос и получили ответ. Этот запуск дал нам понимание того, как агент запускал LLM, а также деталей ответов, стоимости, задержки и использования токенов.
Дополнительные ресурсы по Langchain
Читать далее
Announcing the General Availability of Single Sign-On (SSO) on Zilliz Cloud
SSO is GA on Zilliz Cloud, delivering the enterprise-grade identity management capabilities your teams need to deploy vectorDB with confidence.
Why Not All VectorDBs Are Agent-Ready
Explore why choosing the right vector database is critical for scaling AI agents, and why traditional solutions fall short in production.
Balancing Precision and Performance: How Zilliz Cloud's New Parameters Help You Optimize Vector Search
Optimize vector search with Zilliz Cloud’s level and recall features to tune accuracy, balance performance, and power AI applications.