Революция в автономном ИИ: использование векторных баз данных для расширения возможностей Auto-GPT
ChatGPT, или Chat Generative Pre-trained Transformer, стал революционным прорывом в технологии ИИ благодаря передовым достижениям. Однако даже при наличии больших языковых моделей (LLM), таких как GPT, и специализированных ИИ-приложений, таких как Midjourney, для промптов по-прежнему необходим человеческий ввод. Эта зависимость от людей вызывает вопрос: может ли ИИ функционировать самостоятельно и достигать целей без вмешательства человека? Auto-GPT стал популярным решением этой потребности.
Что такое Auto-GPT?
Auto-GPT — это экспериментальный open-source проект на GitHub. Он объединяет языковую модель GPT с другими инструментами, чтобы создать ИИ-систему, которая может работать непрерывно и самостоятельно с минимальным человеческим вводом или даже без него.
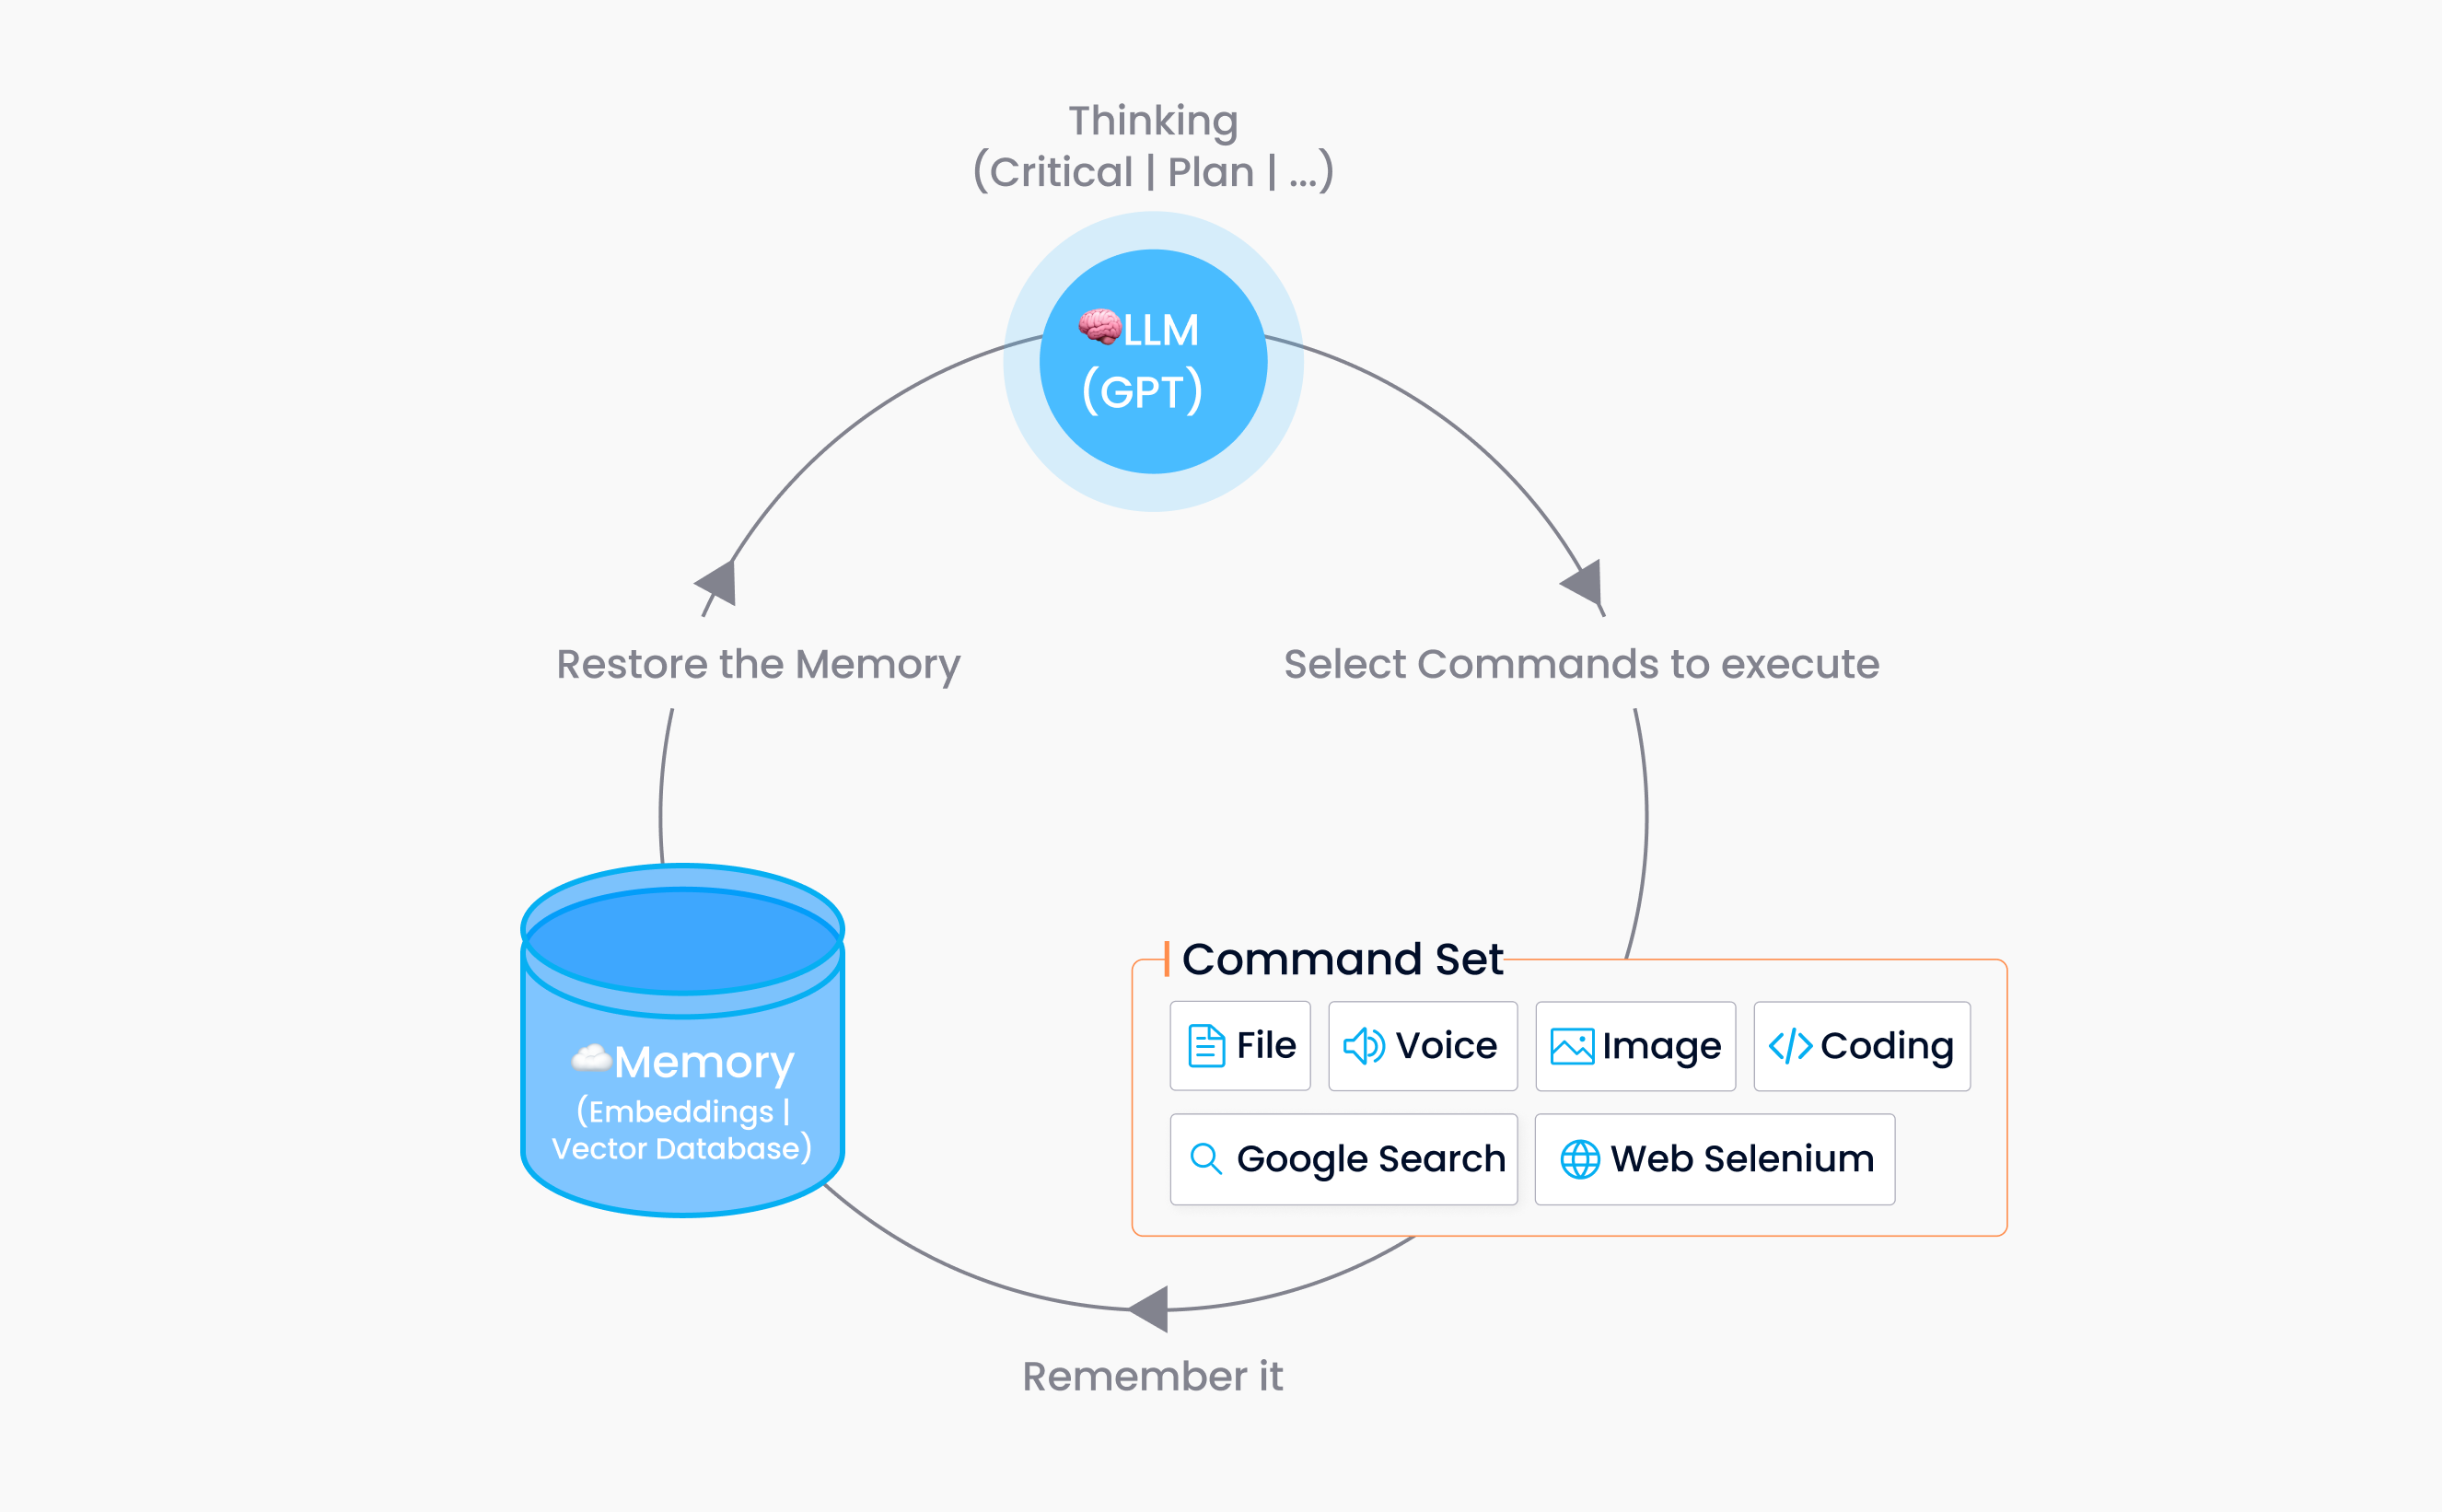
Auto-GPT состоит из двух ключевых частей: LLM и набора команд. LLM, такая как GPT, служит «мозгом» Auto-GPT и выполняет когнитивную обработку. Поэтому промпты Auto-GPT разрабатываются LLM, а не традиционным человеческим вводом. В то же время набор команд автономно выполняет различные задачи, такие как управление файлами, проведение веб-поиска и доступ к социальным сетям. Эти способности эквивалентны «рукам» и «чувствам» Auto-GPT.
Чтобы подробнее объяснить процесс, Auto-GPT использует языковую модель GPT и человеческую обратную связь для анализа и разбиения крупных задач на более мелкие. Затем он назначает этим меньшим задачам конкретные команды, выполняет их и получает вводные данные для следующего раунда когнитивной обработки. Эти процедуры повторяются, пока Auto-GPT не завершит задачу.
Ограничения Auto-GPT
Теперь, когда вы знаете, что такое Auto-GPT, важно понять его возможности и ограничения. Хотя Auto-GPT может выполнять задачи автоматически, у него есть ограничения в понимании и удержании обширной контекстной информации, поскольку модель GPT, которую он использует, имеет лимит токенов. Например, GPT-3 от OpenAI может обрабатывать максимум 4 096 токенов контекста, что означает, что когда разговоры превышают лимит токенов, GPT-3 может забывать предыдущие обсуждения.
Кроме того, чтобы выполнить сложную задачу, Auto-GPT должен предпринять несколько шагов. Однако нельзя отправлять каждый шаг отдельно в модель GPT, потому что это может привести к потере контекста. Такая потеря затруднит определение того, являются ли действия правильными и эффективно ли они приближают к цели. Но если отправлять все предыдущие сообщения в модель GPT на каждом шаге, они быстрее превысят лимит токенов GPT.
Один из способов решить эту контекстную проблему — получить доступ к окну исторических сообщений, например к последним десяти сообщениям или фиксированному числу токенов, не превышая лимит токенов одного разговора. Однако этот метод ограничивает Auto-GPT в доступе к более ранней контекстной информации, что может привести к неспособности Auto-GPT достичь своей цели.
Улучшение контекстных возможностей Auto-GPT с помощью векторной базы данных
Интеграция Auto-GPT с векторной базой данных — более результативное и эффективное решение для улучшения памяти и контекстного понимания Auto-GPT. Вот как работает интеграция:
Интеграция преобразует команды Auto-GPT и результаты выполнения каждого шага в embeddings и сохраняет их в векторной базе данных.
При генерации следующей задачи она извлекает сообщения из окна истории и сохраняет их как входные данные для поиска по векторной базе данных.
Затем она извлекает
top-kисторических сообщений, чтобы улучшить контекст с большим хронологическим охватом.
 image
Кроме того, благодаря возможности поиска по сходству векторной базы данных система может определить, похоже ли последнее действие на текущее и помогает ли оно выполнить задачу, предоставляя более точную информацию для следующей команды.
Как настроить Auto-GPT с Milvus
Milvus — одна из самых популярных векторных баз данных с открытым исходным кодом, способная обрабатывать огромные наборы данных, содержащие миллионы, миллиарды или даже триллионы векторов. Вы можете следовать приведенному ниже руководству, чтобы легко интегрировать Milvus с вашим Auto-GPT.
- Загрузите Docker-образ Milvus и установите его с помощью Docker Compose:
https://github.com/milvus-io/milvus/releases/download/v2.2.8/milvus-standalone-docker-compose.yml
docker compose up -d
- Установите клиент
pymilvusв вашей среде python:
pip install pymilvus==2.2.8
- Обновите ваш файл
.env:
MEMORY_BACKEND=milvus
Если вам сложно развертывать и поддерживать Milvus, рассмотрите возможность использования Zilliz Cloud. Это полностью управляемый облачный нативный сервис для Milvus, который поможет вам легко управлять памятью Auto-GPT. Zilliz Cloud имеет широкую базу пользователей по всему миру и был рекомендован генеральным директором Nvidia Дженсеном Хуангом на GTC 2023. Кроме того, Zilliz Cloud является назначенным OpenAI поставщиком плагина ChatGPT Retrieval.
Вот руководство по использованию Zilliz Cloud в качестве бэкенда памяти Auto-GPT:
Войдите в Zilliz Cloud или зарегистрируйтесь, если у вас нет учетной записи.
Создайте базу данных и получите публичную облачную конечную точку.
Установите
pymilvus, выполнивpip install pymilvus==2.2.8, и обновите ваш файл.envследующими командами:
MEMORY_BACKEND=milvus
MILVUS_ADDR=your-public-cloud-endpoint
MILVUS_USERNAME=your-db-username
MILVUS_PASSWORD=your-db-password
Используя Milvus или Zilliz Cloud в качестве бэкенда памяти для Auto-GPT, вы можете значительно улучшить его возможности и приблизить его на шаг к достижению настоящей автономности.
Ограничения интеграции Auto-GPT с векторной базой данных
Интеграция векторной базы данных с Auto-GPT чрезвычайно полезна и необходима для автоматизации задач и генерации команд, соответствующих целям пользователя. Несмотря на это, некоторые ограничения всё еще существуют.
При извлечении сообщений из векторной базы данных результаты top-k не фильтруются. В результате может присутствовать информация с низким сходством, что может ввести модель GPT в заблуждение и в конечном итоге замедлить ее продвижение к достижению желаемого результата.
Вы можете только добавлять и запрашивать контекстные данные, но не можете удалять данные, которые больше не являются актуальными или необходимыми.
В настоящее время невозможно настроить модель эмбеддингов. Единственный доступный вариант — использовать интерфейс эмбеддингов, предоставляемый OpenAI.
Объяснение Auto-GPT
Auto-GPT — это новая разработка в области технологий ИИ, цель которой — достижение полной автономности при минимальном участии человека или без него. Хотя Auto-GPT всё еще является экспериментальным, он обладает огромным потенциалом, особенно в сочетании с векторными базами данных, такими как Milvus.
Как поставщик инфраструктурного программного обеспечения для технологий ИИ, мы рады видеть, что векторные базы данных играют ключевую роль в разработке и усилении новых систем контента, генерируемого ИИ (AIGC), таких как Auto-GPT. У нас есть множество информативных статей, если вы хотите узнать больше о векторных базах данных с открытым исходным кодом и Milvus, а также о связанных темах, таких как Hierarchical Navigable Small Worlds (HNSW). Итак, давайте работать вместе, чтобы продолжать расширять границы ИИ и создавать более светлое будущее для AIGC.

Читать далее
Migrating Self-Managed Milvus to Zilliz Cloud for >99% Latency Reduction
Step-by-step guide to migrating 50M vectors from self-managed Milvus to Zilliz Cloud using milvus-backup. Achieve >99% query latency reduction with zero data loss.
Why I’m Against Claude Code’s Grep-Only Retrieval? It Just Burns Too Many Tokens
Learn how vector-based code retrieval cuts Claude Code token consumption by 40%. Open-source solution with easy MCP integration. Try claude-context today.
How to Build RAG with Milvus, QwQ-32B and Ollama
Hands-on tutorial on how to create a streamlined, powerful RAG pipeline that balances efficiency, accuracy, and scalability using the QwQ-32B and Milvus.