




Найти правильное соответствие: создание эмбеддингов для AI-поиска (RAG) в конвейерах Zilliz Cloud от OSS, VoyageAI и OpenAI
Этот пост написан Christy Bergman и Jiang Chen.
Добро пожаловать в наш блог-пост о моделях эмбеддингов, адаптированных для AI-приложений Retrieval Augmented Generation (RAG). Вот что мы рассмотрим:
Введение в то, как модели эмбеддингов используются в RAG (генеративный ИИ с поиском)
Введение в SBERT, самый распространенный тип модели эмбеддингов
Рейтинг моделей эмбеддингов MTEB и как им пользоваться
Шесть моделей эмбеддингов, автоматически включенных в Zilliz Cloud Pipelines
Объяснение каждой модели и советы по выбору лучшей модели эмбеддингов для ваших потребностей
Давайте погрузимся!
Добавьте свои данные в AI с помощью Rag: как используются модели эмбеддингов + LLM
Retrieval Augmented Generation (RAG) стало основным подходом для ботов, отвечающих на вопросы. Однако, учитывая дату отсечения обучающих знаний, присущую всем моделям, им может не хватать осведомленности о недавних данных. Большинство производственных сценариев использования дополняют свои модели специфическими знаниями, чтобы устранить этот пробел.
Ваши AI-ответы застряли в прошлом? Устали от ботов, которые знают только то, на чем их обучали?
RAG предлагает решение, интегрируя ваши данные в знания AI. Этот шаблон использует модели эмбеддингов и большие языковые модели (LLM). Вот как это работает:
Подготовка данных с использованием модели эмбеддингов: Запустите RAG, используя модель эмбеддингов для генерации векторных эмбеддингов фрагментов текста из ВСЕХ ваших документов. Это становится ВАШИМ векторным пространством, представляющим ВАШИ предметные знания, где каждый фрагмент информации представлен вектором.
Индексирование и поиск с использованием той же модели эмбеддингов: Компьютеры могут быстро выполнять векторный поиск, когда ваши знания закодированы в векторы. Организация векторов в структуры данных для поисковых алгоритмов называется индексированием. Индексы используются в векторных базах данных, таких как Milvus. Когда вы задаете вопрос, база данных использует индекс, чтобы найти ближайшие векторы (представляющие предложения или абзацы) в векторном пространстве ваших предметных знаний к вектору вашего вопроса. Создайте вектор вашего вопроса с использованием той же модели эмбеддингов, которая использовалась для эмбеддинга ваших данных.
Генерация ответа с помощью LLM-модели: Это часть “Generative AI”. На этом шаге LLM-модель, такая как ChatGPT, использует ваши релевантные предметные знания, чтобы ответить на вопрос. Данные RAG передаются LLM-модели путем вставки Top-K извлеченных текстов в prompt, который включает ваш вопрос, контекст (Top-K текстов) и инструкции, такие как “Ответьте на вопрос, используя только знания в контексте этого prompt”.
С RAG LLM генерирует ответ на основе ваших заданных предметных знаний, мгновенно получая доступ к самым свежим данным и лучше понимая ваши вопросы.
Этот шаблон RAG поддерживается исследованиями; см. статью Lost in the Middle. В статье показано, что точность Recall ответов, сгенерированных LLM, снижается с увеличением количества извлеченных текстов, помещенных в Context prompt модели. Кроме того:
У LLM есть ограничения на размер контекста (сейчас это 128K для GPT-4 Turbo).
Стоимость за токен, поэтому постоянно передавать всю информацию дороже.
Модели эмбеддингов Sentence-BERT
Современные модели эмбеддингов получены из Encoder-части трансформеров; тогда как LLM-модели (такие как ChatGPT) построены из Decoder-части трансформеров. Самый распространенный класс моделей эмбеддингов — SBERT (Sentence-BERT), который основан на BERT, но специализируется на понимании целых предложений. Поэтому SBERT может отличить "The cat sat on the mat" от "The mat sat on the cat" — то, чего базовый BERT не смог бы!
Семантика относится к значению, стоящему за словами. Это особенно важно в контексте LLM, поскольку одни и те же слова могут иметь разные значения в зависимости от контекста, порядка или употребления. Для получения дополнительной информации о SBERT заинтересованным читателям стоит ознакомиться с этими хорошими обзорными статьями об этой модели здесь.
Предположим, вы пишете RAG-приложения с нуля. Отличное место для начала — выбрать модель эмбеддингов из HuggingFace MTEB Leaderboard, отсортированного (по убыванию) по столбцу "Retrieval Average", поскольку он наиболее релевантен для RAG. Затем выберите самую маленькую модель эмбеддингов с наивысшим рейтингом. Лидерборд постоянно меняется! Но смена модели эмбеддингов с HuggingFace в Python так же проста, как изменение одной переменной.
Производительность MTEB Retrieval измеряется с помощью Normalized Discounted Cumulative Gain at 10 (NDCG@10). Эта метрика измеряет качество списков top-K, вычисляя суммы отношений, где элементам с более высоким рейтингом присваивается больший вес, чем элементам с более низким рейтингом, в результатах, возвращаемых пользователю, пропорционально идеальному ранжированному порядку.
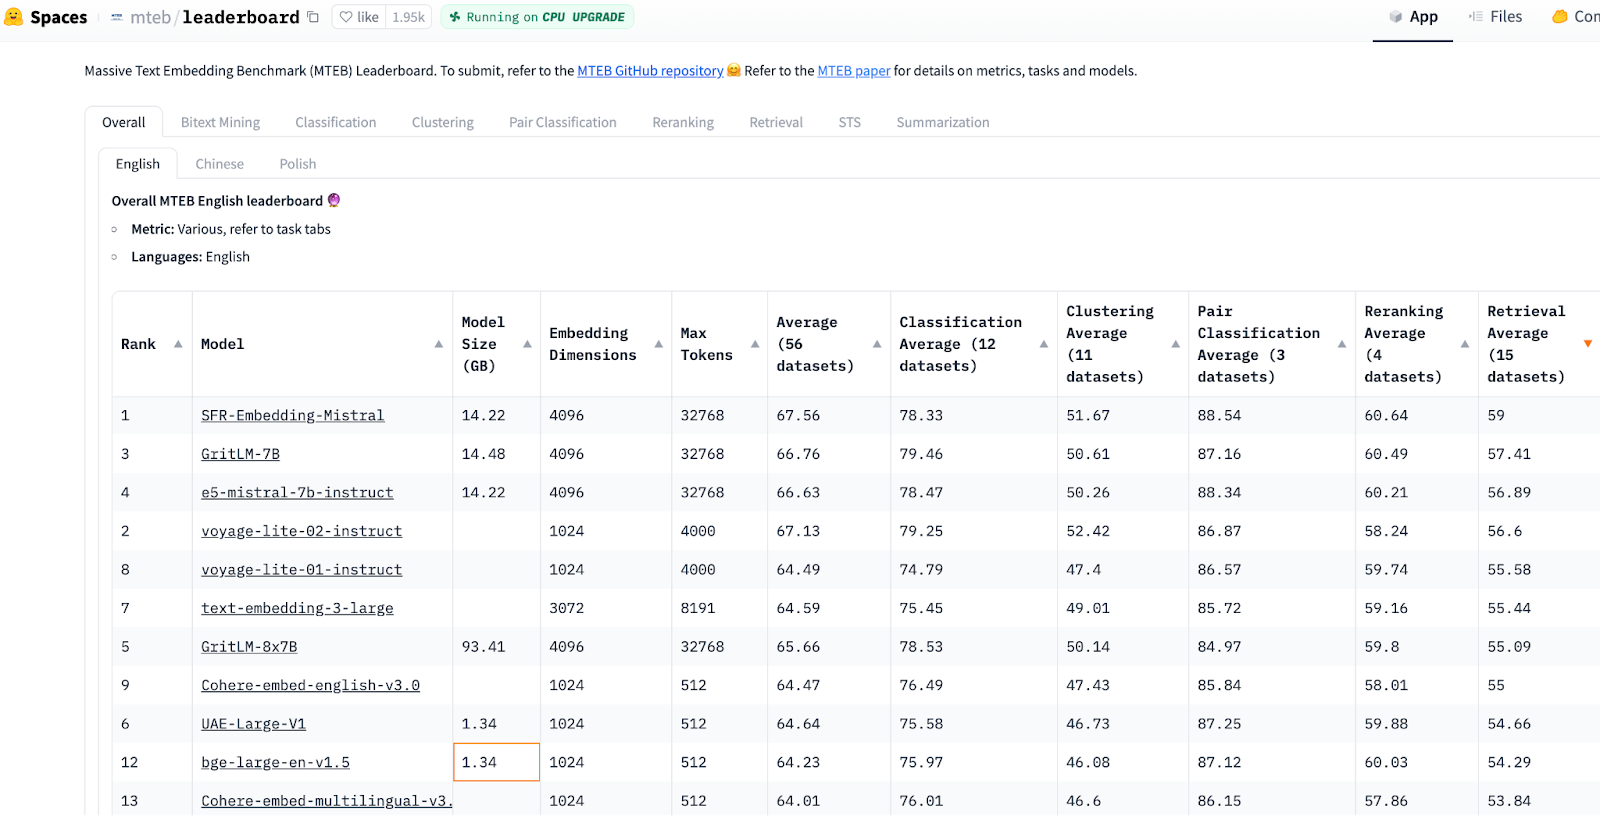
Источник изображения: HuggingFace MTEB Leaderboard, по состоянию на 20 февраля 2024 г.
Massive Text Embedding Benchmark (MTEB) оценивает модели эмбеддингов по 8 задачам и 58 наборам данных (10 многоязычных, 112 языков). Восемь задач: bitext mining, классификация, кластеризация, парная классификация, reranking, retrieval, семантическое текстовое сходство (STS) и суммаризация.
6 ключевых моделей эмбеддингов, встроенных в Zilliz Cloud Pipelines
Zilliz Cloud Pipelines недавно запустил поддержку богатого набора вариантов моделей эмбеддингов.
| Создатель | Модель | Размерность эмбеддинга | Длина контекста | Задачи применения | Открытый исходный код | *Оценка MTEB |
| BAAI | bge-base-en-v1.5 | 768 | 512 | Общий текст EN | Да | 53 |
| BAAI | bge-base-zh-v1.5 | 768 | 512 | Общий текст ZH | Да | 69 |
| VoyageAI | voyage-2 | 1024 | 4K | Высококачественные RAG-чатботы | Нет | Недоступно |
| VoyageAI | voyage-code-2 | 1536 | 16K | Завершение кода с высоким показателем recall | Нет | Недоступно |
| OpenAI | text-embedding-3-small | 512-1536 | 8K | Многоязычные текстовые чатботы в реальном времени | Нет | 62 (512) 62 (1536) |
| OpenAI | text-embedding-3-large | 256-3072 | 8K | Многоязычные текстовые чатботы в реальном времени | Нет | 65 (3072) 62 (256) |
*HuggingFace MTEB Leaderboard, отсортирован по убыванию Retrieval, по состоянию на 26 февраля 2024 г.
Размерность эмбеддинга = длина вектора, создаваемого моделью; более крупные векторы могут захватывать больше смысла, но могут быть менее эффективны с точки зрения хранения.
Длина контекста = максимальное количество токенов, которое модель может обработать одновременно за один временной шаг. Выходные векторы большинства моделей эмбеддингов нормализованы, поэтому скалярное произведение и косинусное сходство равны.
⚠️ Примечание: Хотя бенчмарки MTEB дают ценные ориентиры, известно, что некоторые модели переобучены! Всегда проводите собственные оценки!
С Zilliz Cloud Pipelines вы можете начать бесплатно, зарегистрировавшись и создав свое RAG-приложение без сложностей DevOps или ML-инфраструктуры.
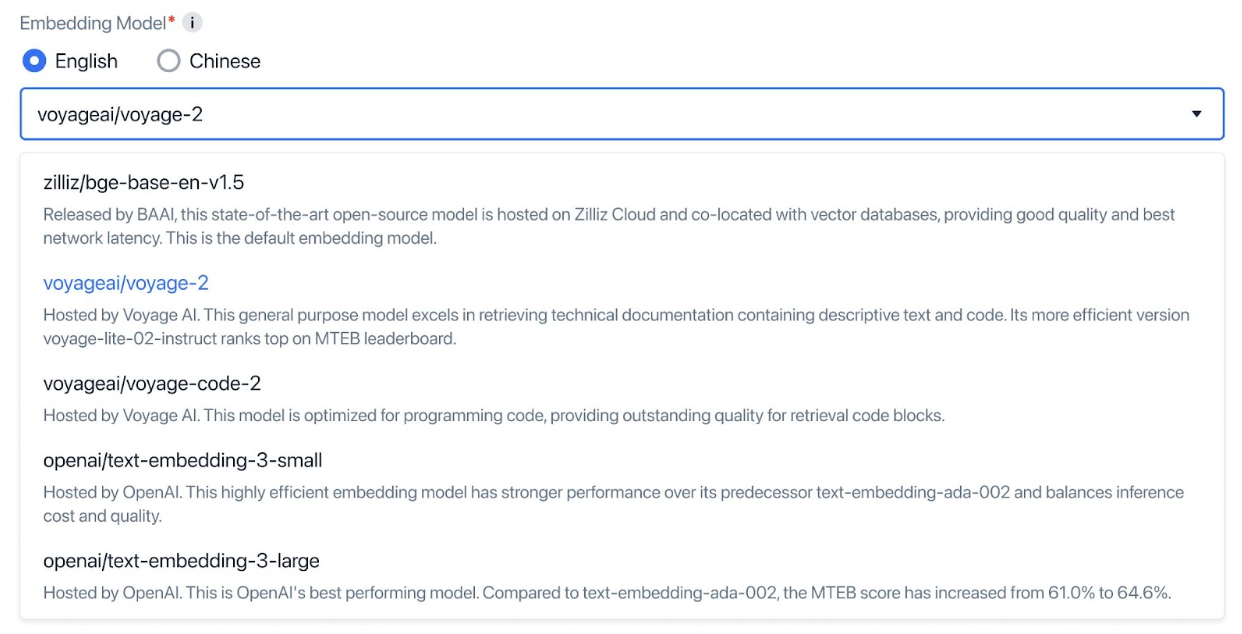
Источник изображения: Блог с анонсом моделей эмбеддингов, встроенных в Zilliz Cloud Pipelines
Модели эмбеддингов BAAI/bge-base-en(or zh)-v1.5
Эти open-source модели SBERT доступны на HuggingFace. Некоторые преимущества этих небольших моделей:
Небольшие, open source и удобные для CPU.
Это хороший выбор для работы на ноутбуке или/или с крошечными облачными ресурсами.
Самые быстрые для загрузки данных при разбиении на чанки и по задержке запросов каждый раз, когда задается вопрос.
Экономически эффективны, поскольку API-вызовы бесплатны и GPU не требуется.
Обучены на китайском и английском языках.
| Создатель | Модель | Размерность****эмбеддинга | Длина контекста | Задачи использования | Open Source | *Оценка MTEB |
| BAAI | bge-base-en-v1.5 | 768 | 512 | Общий текст EN | Да | 53 |
| BAAI | bge-base-zh-v1.5 | 768 | 512 | Общий текст ZH | Да | 69 |
*Лидерборд HuggingFace MTEB, отсортировано по убыванию Retrieval, доступ получен 26 февр. 2024 г.
Модели эмбеддингов VoyageAI voyage-2 и voyage-code-2
Эти проприетарные модели обучены с использованием контрастивного обучения и importance resampling на разных данных и дообучены для разных задач. Voyage-2 обучена на диалоговых данных и дообучена для распознавания намерений в разговоре. Voyage-code-2 обучена на данных кода и дообучена для автодополнения кода.
Примечание: Voyage-lite-02-instruct, указанный в лидерборде MTEB (отсортированном по убыванию STS или категории «diverse corpora»), является другой моделью, и его не следует путать с производственными моделями voyage-2 и voyage-code-2, описанными здесь.
Некоторые преимущества этих моделей:
Для RAG-чатботов по технической документации было показано, что voyage-01 (устаревшая) имеет более высокое качество поиска (измерялось как NDCG@10). Voyage-2 — более новая версия.
Для задач с кодом voyage-code-2 имеет на 14% более высокий recall для текста с большим количеством кода.
| Создатель | Модель | Размерность****эмбеддинга | Длина контекста | Задачи использования | Open Source | Оценка MTEB |
| VoyageAI | voyage-2 | 1024 | 4K | Высококачественные RAG-чатботы | Нет | Недоступно |
| VoyageAI | voyage-code-2 | 1536 | 16K | Высокий recall для автодополнения кода | Нет | Недоступно |
Модели эмбеддингов OpenAI text-embedding-3-small(or large)
От OpenAI: новейшие модели эмбеддингов занимают более высокие позиции в таблице лидеров MTEB, чем их предыдущая ada-002. Эти новые модели эмбеддингов также демонстрируют более высокую многоязычную производительность (MIRACL) и более низкие цены.
Согласно блогу OpenAI, для создания эмбеддингов использовалось обучение с учетом сжатия. Традиционные методы снижения размерности, такие как квантование, экономят место, но приводят к огромной потере точности, поскольку сжатие применяется «post-hoc» после того, как эмбеддинги были обучены. Обучение с учетом сжатия, такое как Matryoshka Representation Learning, обучает эмбеддинги разных размеров (измерений) с некоторой потерей точности, хотя и не такой значительной, как при PCA.
Впечатляет, что обе модели поддерживают меньшие эмбеддинги без существенного ущерба для качества поиска. Например, уменьшение размерности вектора с 3072 до 256 снижает оценку MTEB только с 65% до 62%. Однако это в 12 раз меньшие требования к памяти! Хотя с меньшей размерностью связан компромисс между точностью и стоимостью, в эпоху чатботов на базе ИИ быстрые ответы иногда ставятся выше точности ответа.
Некоторые преимущества этих моделей:
Улучшенные многоязычные возможности.
Векторы меньшей размерности с минимальными накладными расходами на инференс и гораздо меньшей потерей точности, чем при традиционном бинарном или product-квантовании.
| Создатель | Модель | Размерность****эмбеддинга | Длина контекста | Задачи использования | Открытый исходный код | *Оценка MTEB |
| OpenAI | text-embedding-3-small | 512-1536 | 8K | Многоязычные текстовые чатботы реального времени | Нет | 62 (512) 62 (1536) |
| OpenAI | text-embedding-3-large | 256-3072 | 8K | Многоязычные текстовые чатботы реального времени | Нет | 65 (3072) 62 (256) |
*Таблица лидеров HuggingFace MTEB, отсортировано по убыванию по Retrieval, доступ получен 26 февраля 2024 г.
Ниже приведен пример кода для вызова новых моделей эмбеддингов. Полный код находится в нашем bootcamp github.
# STEP 1. CONNECT TO MILVUS

# !pip install pymilvus
from pymilvus import connections, utility
from dotenv import load_dotenv
load_dotenv()
TOKEN = os.getenv("ZILLIZ_API_KEY")

# Connect to Zilliz cloud using endpoint URI and API key TOKEN.
CLUSTER_ENDPOINT="https://in03-xxxx.api.gcp-us-west1.zillizcloud.com:443"
connections.connect(
  alias='default',
  uri=CLUSTER_ENDPOINT,
  token=TOKEN,
)
Далее мы указываем модель эмбеддингов OpenAI.
# STEP 2. EMBEDDING MODEL.

import openai, pprint
from openai import OpenAI

# OpenAI embedding model name, `text-embedding-3-large` or `ext-embedding-3-small`.
EMBEDDING_MODEL = "text-embedding-3-small"
EMBEDDING_DIM = 512
Далее мы создаем коллекцию Milvus без схемы и указываем индекс.
# STEP 3. CREATE A NO-SCHEMA MILVUS COLLECTION AND USE AUTOINDEX.

from pymilvus import MilvusClient

COLLECTION_NAME = "MilvusDocs_text_embedding_3_small"

# https://milvus.io/docs/using_milvusclient.md
mc = MilvusClient(
    uri=CLUSTER_ENDPOINT,
    token=TOKEN)

# Check if collection already exists, if so drop it.
has = utility.has_collection(COLLECTION_NAME)
if has:
    drop_result = utility.drop_collection(COLLECTION_NAME)
    print(f"Successfully dropped collection: `{COLLECTION_NAME}`")

# Создайте коллекцию.
mc.create_collection(COLLECTION_NAME,
                     EMBEDDING_DIM,
                     consistency_level="Eventually",
                     auto_id=True,
                     overwrite=True)
Далее мы читаем техническую документацию LangChain как .html-файлы, загруженные в папку. Разбейте документацию на фрагменты и создайте векторные представления. В примере ниже встроенный HTML-парсер LangChain используется как стратегия разбиения на фрагменты. Ваша стратегия разбиения может быть намного проще.
# STEP 4. PREPARE DATA: CHUNK AND EMBED

# Read docs into LangChain.
from langchain.document_loaders import DirectoryLoader

path = "../RAG/rtdocs/pymilvus.readthedocs.io/en/latest/"
loader = DirectoryLoader(path, glob='*.html')
docs = loader.load()

from langchain.text_splitter import HTMLHeaderTextSplitter, RecursiveCharacterTextSplitter
from bs4 import BeautifulSoup

# Define the headers to split on for the HTMLHeaderTextSplitter
headers_to_split_on = [
    ("h1", "Header 1"),
    ("h2", "Header 2"),
]
# Create an instance of the HTMLHeaderTextSplitter
html_splitter = HTMLHeaderTextSplitter(headers_to_split_on=headers_to_split_on)

# Specify chunk size and overlap.
chunk_size = 511
chunk_overlap = np.round(chunk_size * 0.10, 0)
print(f"chunk_size: {chunk_size}, chunk_overlap: {chunk_overlap}")

# Create an instance of the RecursiveCharacterTextSplitter
child_splitter = RecursiveCharacterTextSplitter(
    chunk_size = chunk_size,
    chunk_overlap = chunk_overlap,
    length_function = len,
)

# Split the HTML text using the HTMLHeaderTextSplitter.
start_time = time.time()
html_header_splits = []
for doc in docs:
    soup = BeautifulSoup(doc.page_content, 'html.parser')
    splits = html_splitter.split_text(str(soup))
    for split in splits:
        # Add the source URL and header values to the metadata
        metadata = {}
        new_text = split.page_content
        for header_name, metadata_header_name in headers_to_split_on:
            # Handle exceptions if h1 does not exist.
            try:
                header_value = new_text.split("¶ ")[0].strip()[:100]
                metadata[header_name] = header_value
            except:
                break
        split.metadata = {
            **metadata,
            "source": doc.metadata["source"]
        }
        # Add the header to the text
        split.page_content = split.page_content
    html_header_splits.extend(splits)

# Split the documents further into smaller, recursive chunks.
chunks = child_splitter.split_documents(html_header_splits)
Вставьте фрагменты и векторные представления в Milvus.
# STEP 5. INSERT CHUNKS AND EMBEDDINGS IN ZILLIZ.

# Convert chunks to a list of dictionaries.
chunk_list = []
for chunk in chunks:

    # Generate the embeddings.
    response = openai_client.embeddings.create(
        input=chunk.page_content,
        model=EMBEDDING_MODEL,
        dimensions=EMBEDDING_DIM
    )
    embeddings = response.data[0].embedding

    # Assemble embedding vector, original text chunk, metadata.
    chunk_dict = {
        'vector': embeddings,
        'chunk': chunk.page_content,
        'source': chunk.metadata['source'],
        'h1': chunk.metadata['h1'][:50],
    }
    chunk_list.append(chunk_dict)

# Insert data into the Milvus collection.
insert_result = mc.insert(
    COLLECTION_NAME,
    data=chunk_list,
    progress_bar=True)

# After the final entity is inserted, call flush to stop growing segments left in memory.
mc.flush(COLLECTION_NAME)
Задайте вопрос Milvus, который теперь загружен векторными представлениями технической документации Milvus.
# Define a sample question about your data.
SAMPLE_QUESTION = "What do the parameters for HNSW mean?"

# Embed the question using the same encoder.
response = openai_client.embeddings.create(
    input=SAMPLE_QUESTION,
    model=EMBEDDING_MODEL,
   dimensions=EMBEDDING_DIM
)
query_embeddings = response.data[0].embedding

# Define output fields to return.
OUTPUT_FIELDS = ["h1", "h2", "source", "chunk"]

# Выполните семантический векторный поиск, используя ваш запрос и векторную базу данных Milvus.
start_time = time.time()
results = mc.search(
    COLLECTION_NAME,
    data=[query_embeddings],
    output_fields=OUTPUT_FIELDS,
    limit=2,
    consistency_level="Eventually"
    )
Сгенерируйте ответ с помощью ChatGPT и извлеченных фрагментов текстового контекста.
LLM_NAME = "gpt-3.5-turbo"
TEMPERATURE = 0.1
RANDOM_SEED = 415

# Объедините весь контекст вместе через пробел.
contexts_combined = ' '.join(context)

SYSTEM_PROMPT = f"""Используйте приведенный ниже Context, чтобы ответить на вопрос пользователя. Будьте ясны, фактичны, полны и кратки.
Если ответа нет в Context, скажите "Я не знаю".
В противном случае ответьте менее чем 4 предложениями и укажите обосновывающие источники.
Context: contexts_combined
Answer: Ответ на вопрос.
Grounding sources: {context_metadata[0]['source']}
"""

# Сгенерируйте ответ с помощью OpenAI API.
response = openai_client.chat.completions.create(
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT,},
        {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
    ],
    model=LLM_NAME,
    temperature=TEMPERATURE,
    seed=RANDOM_SEED,
)

# Выведите вопрос и ответ вместе с обосновывающими источниками и цитатами.
print(f"Question: {SAMPLE_QUESTION}")
for i, choice in enumerate(response.choices, 1):
    pprint.pprint(f"Answer: {choice.message.content}")
    print("\n")
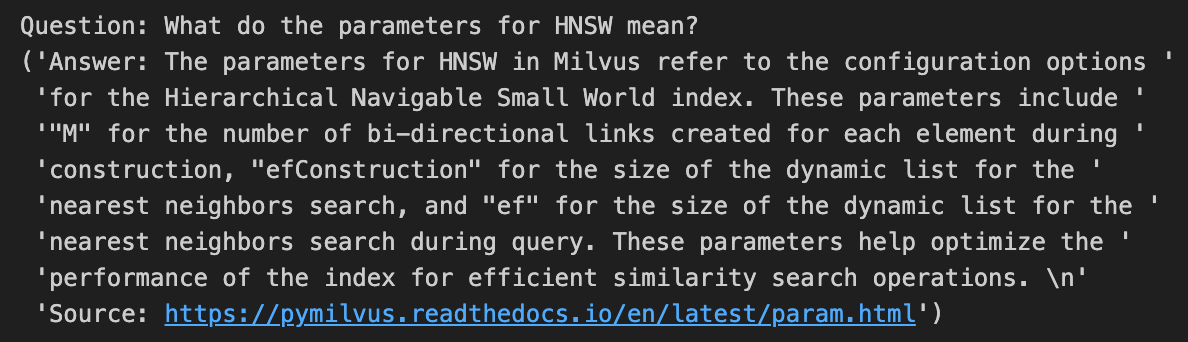
Ответ с использованием text-embedding-3-small с уменьшенной размерностью embeddings dim=256 идеален по сравнению с тем же ответом при dim=1536, по крайней мере для этого примера RAG!
Заключение
В этом блоге мы рассказали, как embedding-модели используются в RAG и SBERT, самом распространенном типе embedding-модели. Мы показали MTEB leaderboard embedding-моделей и объяснили, как им пользоваться. Затем мы рассмотрели шесть различных embedding-моделей, автоматически включенных в Zilliz Pipelines. Разные embedding-модели лучше всего подходят для разных сценариев использования; мы обсудили, когда какую модель выбирать. Наконец, мы показали код для вызова новых embedding-моделей OpenAI; а полный код находится в нашем bootcamp github.
Ссылки
Milvus (поставьте нам звезду!)
Tutorial о частях Encoder-Decoder в transformers
Tutorial об embedding-моделях SBERT Encoder
HuggingFace MTEB Leaderboard embedding-моделей
Карточка модели HuggingFace для BAAI/bg-large-en-v1.5
Embedding-модели VoyageAI
Embedding-модели OpenAI
Читать далее
Introducing Zilliz CLI and Agent Skills for Zilliz Cloud
Manage your vector database from your terminal or AI coding agent. Zilliz CLI and Agent Skills work with Claude Code, Cursor, Codex, and Copilot.
Vector Databases vs. Key-Value Databases
Use a vector database for AI-powered similarity search; use a key-value database for high-throughput, low-latency simple data lookups.
Introducing DeepSearcher: A Local Open Source Deep Research
In contrast to OpenAI’s Deep Research, this example ran locally, using only open-source models and tools like Milvus and LangChain.