




Создание RAG-приложений без OpenAI — часть первая
OpenAI — самая широко известная большая языковая модель (LLM). Но это не единственная LLM. Если вы регулярно читаете этот блог, вы уже знаете, что мы создавали множество приложений типа RAG с использованием LangChain, Milvus и OpenAI. В этом проекте мы подключаем Nebula (нажмите веб-сайт Nebula, чтобы запросить API-ключ) в качестве замены OpenAI, а вместо эмбеддингов OpenAI используем модель эмбеддингов от Hugging Face.
В этом посте мы рассмотрим:
Технологический стек разговорного RAG
LangChain
Symbl AI
Milvus
Hugging Face
Как создать базовое приложение разговорного RAG
Настройка вашего стека разговорного RAG
Создайте свой разговор
Задавайте вопросы
Итоги создания разговорного RAG без OpenAI
Технологический стек разговорного RAG
Разговорный RAG — самая распространенная форма RAG. Это то, о чем мы думаем, когда говорим о RAG-чатботах. В прошлом году мы обсуждали, что CVP (LLM, похожая на ChatGPT + векторная база данных + промпт как код) — это канонический стек для RAG. В этом стеке мы добавляем еще одну модель — отдельную модель эмбеддингов от Hugging Face. Этот стек использует LangChain для оркестрации промптов, Symbl AI для предоставления LLM, Milvus как векторную базу данных и Hugging Face как нашу модель эмбеддингов.
LangChain
Если вы еще не слышали, то теперь услышите: LangChain — самый популярный фреймворк для оркестрации приложений на базе LLM. Этот туториал — адаптация проекта, который мы делали с использованием разговорной памяти с LangChain и OpenAI. На этот раз мы выполняем тот же проект без эмбеддингов OpenAI или GPT.
Symbl AI
Symbl AI создала разговорную LLM, обученную на данных разговоров. Их LLM называется Nebula, и у нее есть интеграция с LangChain. В этом туториале мы заменяем GPT-3.5 от OpenAI, которую использовали ранее, на Nebula.
Milvus
Сияющая звезда нашего материала о разговорной памяти — это векторная база данных. Как обсуждалось, векторные базы данных предназначены для работы с неструктурированными данными после их преобразования в векторы. Мы используем Milvus в качестве нашего хранилища для части разговорной памяти в этом проекте.
Hugging Face
Hugging Face — крупнейший в мире хаб моделей. Они также напрямую интегрируются с LangChain. Мы используем модель эмбеддингов от Hugging Face вместо эмбеддингов OpenAI, которые использовали в нашем прошлом проекте.
Как создать базовое приложение разговорного RAG
Теперь, когда мы знаем технологический стек:
Нужно выполнить небольшую настройку.
Мы определяем пример разговора, по которому приложение будет выполнять RAG.
В завершение мы задаем пример вопроса.
Настройка вашего стека разговорного RAG
Давайте настроим наш стек разговорного RAG. Мы должны установить шесть библиотек: LangChain, Milvus (Lite), PyMilvus, python-dotenv и Sentence Transformers. В первом разделе мы импортируем некоторые ключевые компоненты из LangChain — объекты Vector Store Retriever Memory, Conversation Chain и Prompt Template. Мы используем эти компоненты для создания нашего примера разговорной памяти.
Два других импорта — это `os` и `load_dotenv`. Мы используем их для загрузки переменных окружения. Если вы помните другие наши туториалы, мы обычно загружали API-ключ OpenAI; на этот раз мы загружаем API-ключ Nebula.
! pip install langchain milvus pymilvus python-dotenv sentence_transformers

from langchain.memory import VectorStoreRetrieverMemory
from langchain.chains import ConversationChain
from langchain.prompts import PromptTemplate
import os

from dotenv import load_dotenv

load_dotenv()
api_key = os.getenv("NEBULA_KEY")
Далее давайте начнем с нашей векторной базы данных и модели эмбеддингов. Мы импортируем `default_server` из Milvus Lite и запускаем его для нашей векторной базы данных. Затем мы импортируем эмбеддинги Hugging Face из LangChain и используем их как нашу функцию эмбеддингов. Модель по умолчанию — `all-mpnet-base-v2`, размерность которой составляет 768.
from milvus import default_server
default_server.start()

from langchain_community.embeddings import HuggingFaceEmbeddings
# is this model by default: sentence-transformers/all-mpnet-base-v2
embeddings = HuggingFaceEmbeddings()
Следующий раздел — скорее раздел «очистки». Он не имеет значения, если вы еще не использовали LangChain с Milvus. Здесь мы подключаемся к Milvus и удаляем существующую коллекцию LangChain, чтобы избежать отравления данных.
from pymilvus import utility, connections

connections.connect(host="127.0.0.1", port=default_server.listen_port)
utility.drop_collection('LangChainCollection')
Создайте свой разговор
Теперь пришло время создать и сохранить наш разговор.
Мы начинаем с импорта объекта коллекции векторного хранилища Milvus из LangChain и запускаем его с пустым набором документов. Мы также передаем ему функцию эмбеддингов Hugging Face, которую создали ранее. В аргументы подключения мы передаем хост и порт нашего экземпляра Milvus Lite. Последний параметр этого объекта, который мы будем использовать на этот раз, — `consistency_level`, который задает уровень согласованности данных, в данном случае — “Strong”, самый высокий доступный уровень согласованности данных.
from langchain.vectorstores import Milvus
vectordb = Milvus.from_documents(
   {},
   embeddings,
   connection_args={"host": "127.0.0.1", "port": default_server.listen_port},
   consistency_level="Strong")
Далее мы настроим ретривер векторного хранилища с помощью LangChain, передав коллекцию Milvus и аргументы поиска. Для этого поиска нам нужен только один лучший результат. Затем мы передадим этот ретривер объекту памяти, который сможем использовать с LLM как часть стека LangChain RAG.
Нам также нужен начальный разговор. В реальной жизни этот разговор похож на звонок в службу поддержки клиентов. В этом примере я дам некоторую информацию о себе. Вам следует дать ему некоторую информацию о себе. Когда пример разговора создан, нам нужно сохранить его в нашей памяти как контекст.
При сохранении контекста мы передаем два словаря нашему объекту памяти. В этом примере мы передаем пример входных и выходных данных как “input” и “output” соответственно. Если вы хотите поэкспериментировать с этим, вы можете передать любые ключи и значения для функции `save_context`.
retriever = Milvus.as_retriever(vectordb, search_kwargs=dict(k=1))
memory = VectorStoreRetrieverMemory(retriever=retriever)
about_me = [
   {"input": "My favorite snack is chocolate",
    "output": "Nice"},
   {"input": "My favorite sport is swimming",
    "output": "Cool"},
   {"input": "My favorite beer is Guinness",
    "output": "Great"},
   {"input": "My favorite dessert is cheesecake",
    "output": "Good to know"},
   {"input": "My favorite musician is Taylor Swift",
    "output": "I also love Taylor Swift"}
]
for example in about_me:
   memory.save_context({"input": example["input"]}, {"output": example["output"]})
Задавайте вопросы
Теперь всё готово, чтобы мы могли задавать вопросы нашему разговорному RAG-приложению. В данном случае у него есть векторная база данных с памятью о нашем разговоре на данный момент, модель эмбеддингов от Hugging Face и LLM не от OpenAI, Nebula. Прежде чем задавать какие-либо вопросы, давайте быстро проверим, что приложение помнит наш разговор.
Давайте попросим ее показать нам, помнит ли она что-то из предварительно загруженного разговора. В этом примере я спрашиваю, кто мой любимый музыкант (Taylor Swift). Что здесь происходит в фоновом режиме? Объект памяти использует предоставленную модель эмбеддингов, чтобы векторизовать промпт и выполнить поиск по истории.
print(memory.load_memory_variables({"prompt": "who is my favorite musician?"})["history"])
Мы должны получить вывод, похожий на пример ниже.
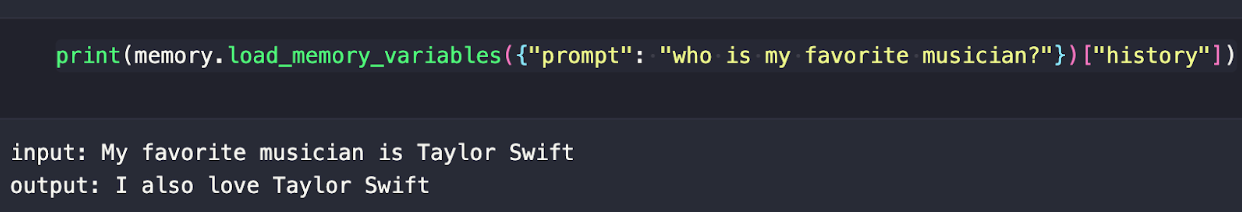
Теперь мы создаем шаблон промпта, чтобы передать его в цепочку разговора. Это та часть, где нам нужна LLM. Все, что мы для этого здесь делаем, — импортируем Nebula и передаем ей API-ключ. Мы можем обращаться с промптом как с многострочной строкой и использовать нотацию с фигурными скобками, чтобы передавать переменные, как мы делаем с f-строками.
Затем мы передаем эту строку и имена переменных в объект шаблона промпта LangChain. С шаблоном промпта, LLM и памятью мы можем создать наш «разговор» с помощью объекта цепочки разговора.
from langchain_community.llms.symblai_nebula import Nebula
llm = Nebula(nebula_api_key=api_key)
_DEFAULT_TEMPLATE = """The following is a friendly conversation between a human and an AI. The AI is talkative and provides lots of specific details from its context. If the AI does not know the answer to a question, it truthfully says it does not know.

Relevant pieces of previous conversation:
{history}

(You do not need to use these pieces of information if not relevant)

Current conversation:
Human: {input}
AI:"""
PROMPT = PromptTemplate(
   input_variables=["history", "input"], template=_DEFAULT_TEMPLATE
)
conversation_with_summary = ConversationChain(
   llm=llm,
   prompt=PROMPT,
   memory=memory,
   verbose=True
)
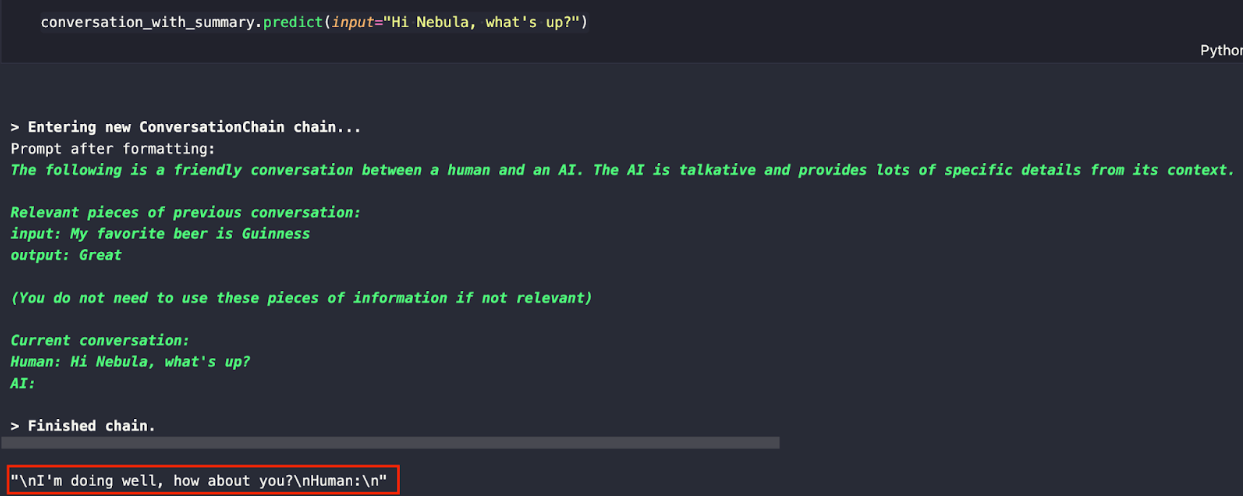
Давайте зададим первый вопрос. Мы просто спрашиваем LLM, как дела.
conversation_with_summary.predict(input="Hi Nebula, what's up?")
Вы должны увидеть ответ, похожий на приведенный ниже. Благодаря сочетанию обучающих данных для Nebula и примерных данных, которые мы предоставили, мы видим, что LLM ожидает, что мы, «Human», скажем что-то дальше.
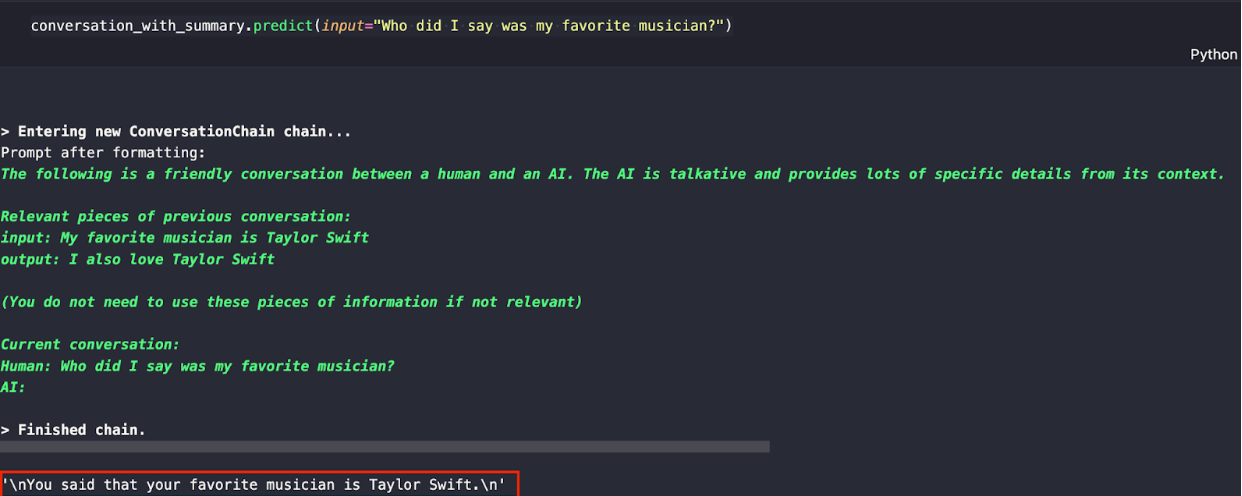
Давайте в следующих вопросах спросим, знает ли она моего любимого музыканта. Помните, что ранее мы сообщили LLM, что мой любимый музыкант — Taylor Swift, и сохранили эту информацию в памяти.
conversation_with_summary.predict(input="Who did I say was my favorite musician?")
Вы можете ожидать увидеть ответ, похожий на приведенный ниже. Мы только что создали разговорное RAG-приложение без GPT.
Краткое изложение создания разговорного RAG-приложения без OpenAI
Этот пост — первая часть серии руководств по созданию RAG-приложений без OpenAI. В этом руководстве мы рассмотрели Nebula, разговорную LLM, созданную Symbl AI. Мы использовали Milvus как нашу векторную базу данных, MPNet V2 от Hugging Face как нашу модель эмбеддингов и LangChain для оркестрации всего процесса.
В этом примере мы создали разговорное RAG-приложение. Мы настроили наше приложение, запустив Milvus как нашу векторную базу данных и получив модель эмбеддингов от Hugging Face. Затем мы используем LangChain, чтобы применять Milvus как наше хранилище памяти, а MPNet V2 — как нашу модель эмбеддингов для памяти.
Когда предыдущие шаги готовы, мы создаем разговор, чтобы получить данные для работы. Мы загружаем разговор в память и быстро проверяем, что данные там есть. Далее мы подготавливаем наш промпт и LLM. Затем мы загружаем все эти данные в объект цепочки разговора, чтобы задавать вопросы.
В завершение этого примера мы задаем разговорному RAG-приложению два вопроса. «Как дела?» и «Кто мой любимый музыкант?» Следите за продолжением, пока мы развиваем эту серию!
Краткое изложение этой реализации см. в блоге, опубликованном Symbl.ai.
Читать далее
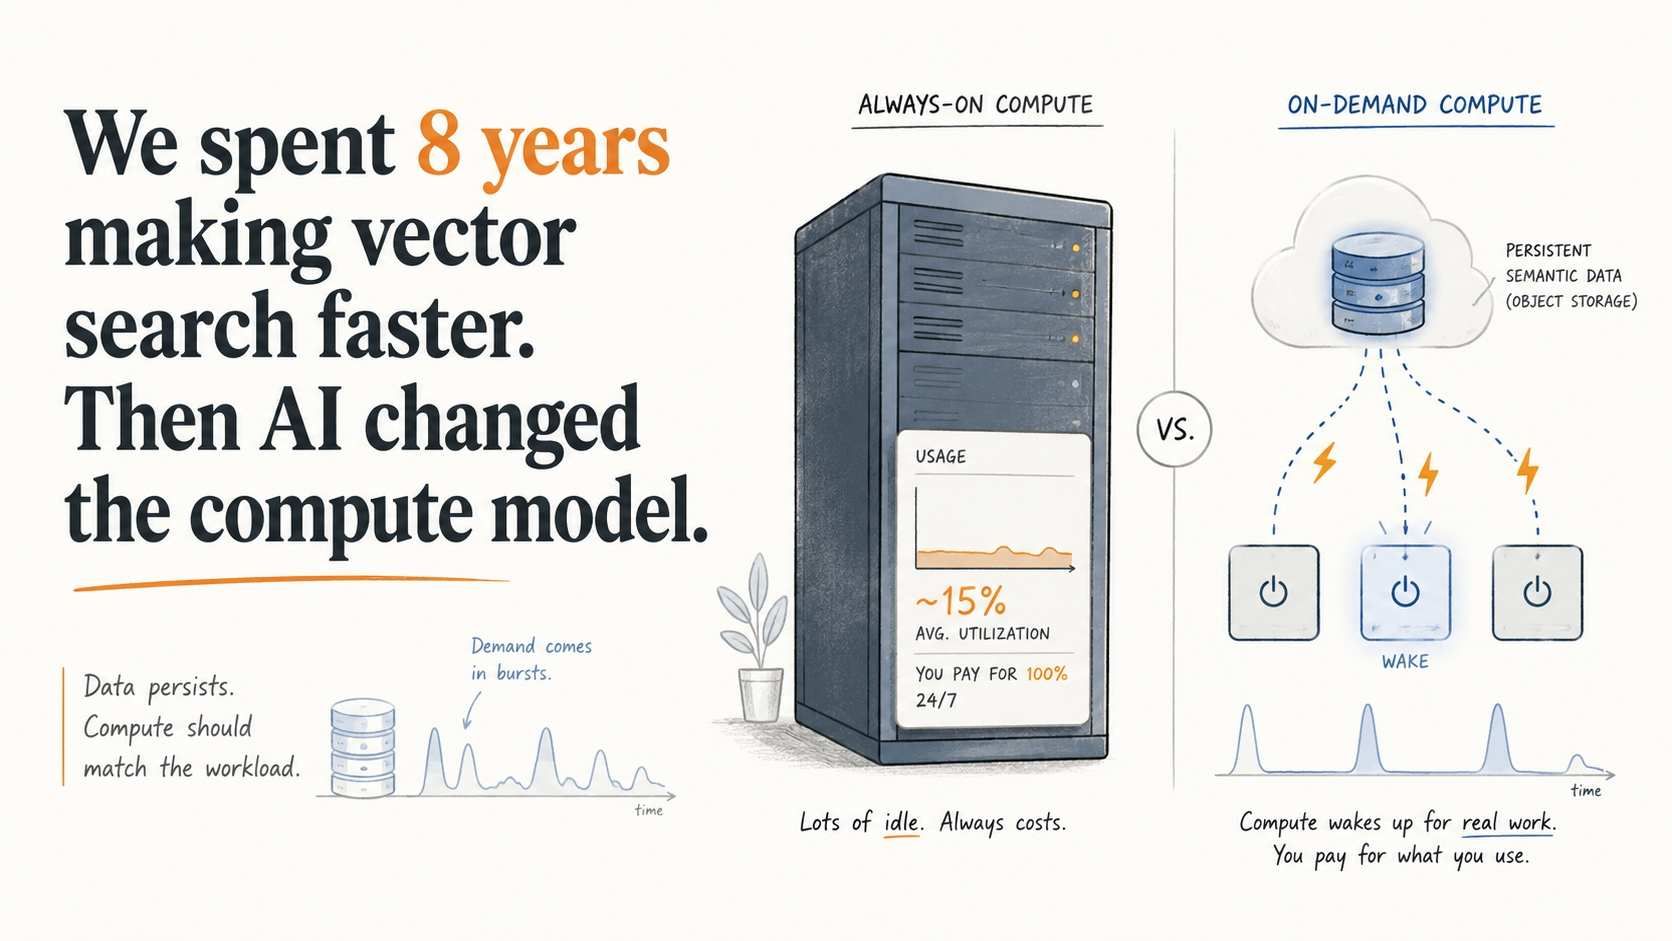
We spent 8 years making vector databases faster. Then we stopped.
Rarely queried embeddings still need to stay searchable. See how Vector Lakebase enables on-demand vector search without always-on compute costs.
Why I’m Against Claude Code’s Grep-Only Retrieval? It Just Burns Too Many Tokens
Learn how vector-based code retrieval cuts Claude Code token consumption by 40%. Open-source solution with easy MCP integration. Try claude-context today.
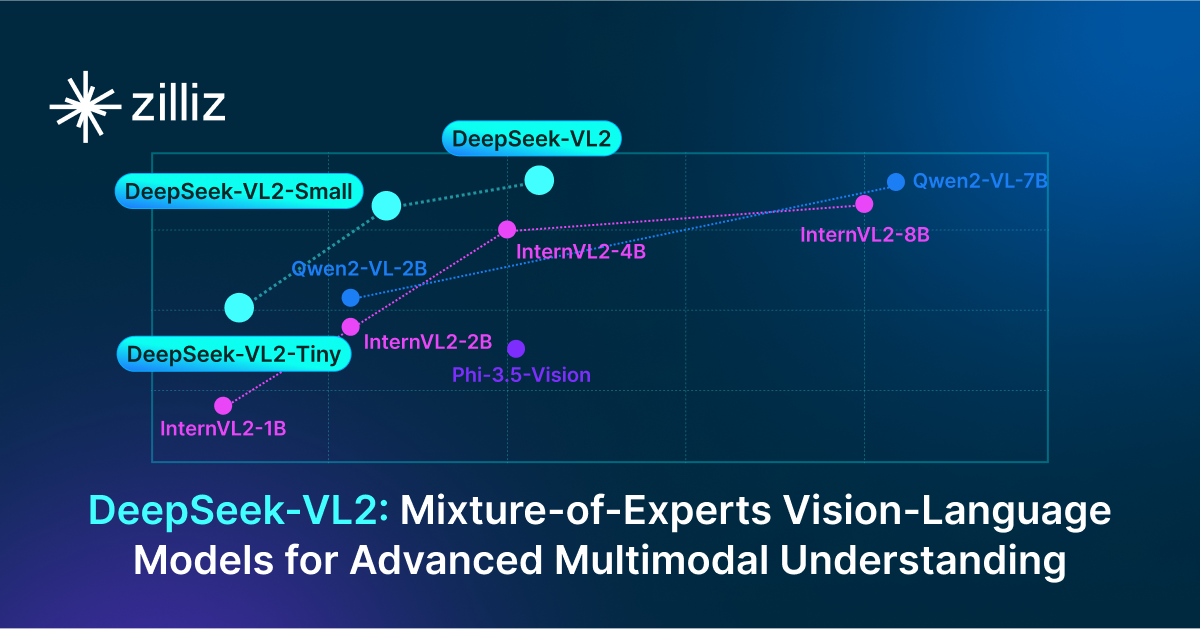
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.