Database vettoriali vs. database di serie temporali
Introduzione
I database vettoriali sono specializzati nell’archiviazione e nell’interrogazione di embedding vettoriali ad alta dimensionalità, alimentando tutto, dalla ricerca semantica ai sistemi di raccomandazione. I database time series gestiscono punti dati cronologici, rendendoli la spina dorsale dei sistemi di monitoraggio, delle piattaforme IoT e dell’analisi finanziaria.
Ma è qui che la cosa si fa interessante: man mano che le applicazioni di IA diventano più popolari e l’analisi delle serie temporali diventa semanticamente più ricca, i confini tra questi tipi di database iniziano a sfumare. Alcuni database time series ora offrono funzionalità di ricerca vettoriale, mentre i database vettoriali stanno aggiungendo funzionalità di indicizzazione basate sul tempo.
Se stai progettando sistemi di dati nel 2025, capire quando sfruttare ciascuna tecnologia—e quando potrebbero completarsi a vicenda—è fondamentale per creare applicazioni robuste e a prova di futuro.
Il panorama dei database di oggi: la specializzazione domina
Ricordi quando usavamo tutti semplicemente database relazionali per tutto? Quei giorni sono ormai lontani. L’ecosistema moderno dei database si è evoluto in un ricco mosaico di soluzioni progettate per scopi specifici, ciascuna ottimizzata per particolari tipi di dati e pattern di accesso.
In questo panorama sempre più specializzato:
I database relazionali continuano a eccellere nei carichi di lavoro transazionali con relazioni strutturate
I database documentali gestiscono dati flessibili simili a JSON con strutture annidate
Gli archivi chiave-valore forniscono un accesso semplice ai dati estremamente rapido
I database a grafo rendono interrogabili e navigabili i dati con molte relazioni
Gli archivi a colonne larghe gestiscono enormi set di dati strutturati su cluster distribuiti
I database vettoriali e i database time series rappresentano due delle categorie specializzate in più rapida crescita, ciascuna pensata per affrontare sfide moderne specifiche:
I database vettoriali sono diventati componenti essenziali dello stack infrastrutturale dell’IA, colmando efficacemente il divario tra i modelli che generano embedding e le applicazioni che devono interrogarli in modo efficiente. La crescita esplosiva dell’IA generativa e della ricerca semantica li ha resi sempre più centrali nelle applicazioni moderne.
I database time series si sono evoluti per gestire i volumi senza precedenti di dati temporali generati da dispositivi, applicazioni e infrastrutture. Con i dati marcati temporalmente in crescita esponenziale grazie all’adozione dell’IoT e ai requisiti di osservabilità, questi sistemi specializzati sono diventati indispensabili.
Ciò che rende questo confronto particolarmente rilevante è il numero crescente di applicazioni che attraversano entrambi i domini: dal rilevamento di anomalie basato sull’IA nei dati dei sensori ai sistemi di raccomandazione consapevoli della dimensione temporale.
Perché potresti trovarti a scegliere tra questi tipi di database
Se stai leggendo questo, probabilmente ti trovi di fronte a uno di questi scenari:
Stai creando un’applicazione di IA con componenti temporali: forse stai sviluppando un sistema di rilevamento delle anomalie che necessita sia di comprensione semantica sia di riconoscimento di pattern basati sul tempo.
Stai arricchendo l’analisi delle serie temporali con funzionalità semantiche: magari vuoi potenziare la tua piattaforma di monitoraggio con query in linguaggio naturale o raggruppamento semantico delle metriche.
Stai ottimizzando i costi infrastrutturali: con risorse limitate, stai cercando di determinare quale database specializzato offrirà il maggior valore per i tuoi casi d’uso specifici.
Stai valutando approcci ibridi: stai considerando se un database time series con funzionalità vettoriali possa soddisfare le tue esigenze o se hai bisogno di sistemi separati e specializzati.
Stai rendendo la tua architettura a prova di futuro: vuoi capire come queste tecnologie potrebbero convergere o completarsi a vicenda con l’evoluzione delle tue applicazioni.
In quanto persona che ha implementato entrambi i tipi di sistemi in settori diversi, posso dirti che fare la scelta giusta richiede di comprendere non solo ciò che ciascun tipo di database sa fare bene, ma anche come le loro differenze architetturali influenzano le applicazioni nel mondo reale.
Database vettoriali: la spina dorsale della moderna ricerca AI
Fondamenti architetturali
Alla base, i database vettoriali come Milvus e Zilliz Cloud sono progettati appositamente attorno a un concetto semplice ma potente: rappresentare gli elementi di dati come punti in uno spazio ad alta dimensionalità, in cui la vicinanza equivale alla somiglianza. La loro architettura include in genere:
Motori di archiviazione vettoriale ottimizzati per array numerici densi che possono variare da decine a migliaia di dimensioni
Indici ANN (Approximate Nearest Neighbor) come HNSW, IVF o PQ che rendono pratica la ricerca vettoriale su scala di miliardi
Ottimizzazioni del calcolo della distanza per calcolare la somiglianza usando metriche come coseno, euclidea o prodotto scalare
Sottosistemi di filtraggio che combinano la ricerca vettoriale con vincoli sui metadati
Meccanismi di sharding progettati specificamente per distribuire carichi di lavoro vettoriali
L’intuizione chiave: i database vettoriali sacrificano l’accuratezza perfetta della ricerca del vicino più prossimo esatto a favore dei notevoli guadagni prestazionali dei metodi approssimati, rendendo pratiche su larga scala applicazioni di ricerca per somiglianza precedentemente impraticabili.
Cosa distingue i database vettoriali
Nella mia esperienza di implementazione di questi sistemi, queste capacità fanno davvero risaltare i database vettoriali:
Compromessi accuratezza-prestazioni regolabili: la possibilità di modificare i parametri dell’indice per bilanciare la velocità di ricerca con la precisione dei risultati
Supporto a record multi-vettore: memorizzazione di più vettori di embedding per elemento per rappresentare diversi aspetti o modalità
Capacità di ricerca ibrida: combinazione della somiglianza vettoriale con il filtraggio tradizionale per risultati precisi
Flessibilità delle metriche di distanza: supporto di diverse misure di somiglianza per diversi tipi di embedding
Filtraggio dei metadati: restringimento dei risultati in base ad attributi tradizionali insieme alla somiglianza vettoriale
Le innovazioni recenti hanno ulteriormente ampliato le loro capacità:
Ricerca ibrida sparsa-densa: combinazione dei punti di forza del tradizionale abbinamento per parole chiave con la comprensione semantica
Reranking con cross-encoder: affinamento dei risultati iniziali della ricerca vettoriale con modelli più intensivi dal punto di vista computazionale
Scalabilità serverless: adeguamento automatico delle risorse in base ai carichi di query e indicizzazione
Pipeline di recupero multi-stadio: orchestrazione di flussi di recupero complessi con fasi di filtraggio e reranking
Zilliz Cloud e Milvus: leader dell’ecosistema dei database vettoriali
All’interno del crescente ecosistema di soluzioni di database vettoriali, Zilliz Cloud e il progetto open-source Milvus sono emersi come attori significativi:
Milvus è un database vettoriale open-source ampiamente adottato che ha guadagnato popolarità tra gli sviluppatori che creano applicazioni AI. Creato per gestire la ricerca di somiglianza vettoriale su larga scala, fornisce le fondamenta per molti sistemi di produzione in ambiti che spaziano dai motori di raccomandazione alla ricerca di immagini. Il progetto ha alle spalle una comunità solida ed è progettato tenendo a mente prestazioni e scalabilità.
Zilliz Cloud è la versione come servizio gestito di Milvus, che offre la stessa funzionalità di base senza la complessità operativa. Per i team di sviluppo che cercano di implementare capacità di ricerca vettoriale senza dedicare risorse alla gestione del database, Zilliz Cloud offre un percorso semplificato verso la produzione. Questo approccio cloud-native è in linea con le pratiche di sviluppo moderne, in cui i team preferiscono sempre più consumare i database come servizi anziché gestire direttamente l’infrastruttura sottostante.
Organizzazioni che vanno dalle startup alle imprese stanno sfruttando queste piattaforme per creare applicazioni basate sull’AI senza gestire la complessa infrastruttura tipicamente associata alla ricerca vettoriale su larga scala.
Casi d’uso popolari: database vettoriali
I database vettoriali stanno trasformando vari settori grazie alla loro capacità di alimentare applicazioni basate sulla similarità:
- Retrieval-Augmented Generation (RAG): I database vettoriali collegano i modelli linguistici a fonti di informazioni pertinenti. Gli utenti possono porre domande complesse come "Quali sono stati i nostri risultati di vendita del Q2 in Europa?" e ricevere risposte accurate tratte direttamente da documenti interni, garantendo che le risposte siano fattuali e aggiornate.
Ricerca semantica: I database vettoriali consentono una ricerca in linguaggio naturale che comprende l’intento dell’utente invece di limitarsi a corrispondere parole chiave. Gli utenti possono cercare con query conversazionali come "mete per vacanze economiche per famiglie" e ricevere risultati semanticamente pertinenti, anche quando queste parole esatte non compaiono nel contenuto.
Sistemi di raccomandazione: Le piattaforme di e-commerce, i servizi di streaming e le piattaforme di contenuti utilizzano database vettoriali per fornire raccomandazioni personalizzate basate sulla similarità semantica anziché solo sul filtering collaborativo. Questo approccio riduce il problema del "cold start" per i nuovi elementi e può spiegare meglio perché vengono formulate determinate raccomandazioni.
Ricerca di immagini e visiva: I rivenditori e le piattaforme visive utilizzano database vettoriali per abilitare la funzionalità di ricerca tramite immagine. Gli utenti possono caricare una foto per trovare prodotti, opere d’arte o design visivamente simili, particolarmente utile nella moda, nell’interior design e nei settori creativi.
Rilevamento delle anomalie: I sistemi di sicurezza e monitoraggio sfruttano i database vettoriali per identificare pattern insoliti che non corrispondono ai comportamenti attesi. Questo è particolarmente utile per il rilevamento delle frodi, la sicurezza di rete e il controllo qualità nella produzione.
Database di serie temporali: padroneggiare la dimensione temporale
Fondamenti architetturali
I database di serie temporali sono costruiti da zero attorno a una verità fondamentale: i dati ordinati temporalmente hanno proprietà uniche che possono essere sfruttate per drastiche ottimizzazioni delle prestazioni. La loro architettura presenta tipicamente:
Archiviazione partizionata per tempo che organizza i blocchi di dati per intervalli temporali per query efficienti
Archiviazione orientata alle colonne ottimizzata per la natura write-once, read-many dei dati di serie temporali
Algoritmi di compressione specializzati che sfruttano i pattern prevedibili nelle misurazioni sequenziali
Strutture di indicizzazione basate sul tempo che accelerano query per intervallo e aggregazioni
Sistemi di gestione della retention che gestiscono automaticamente il ciclo di vita dei dati invecchiati
L’intuizione fondamentale: accettando determinati vincoli (principalmente dati append-only e indicizzati temporalmente), questi database ottengono prestazioni migliori di ordini di grandezza per workload incentrati sul tempo rispetto alle alternative general-purpose.
Cosa distingue i DB di serie temporali
Avendo implementato questi sistemi in casi d’uso di monitoraggio, IoT e finanza, ho trovato queste capacità particolarmente preziose:
Funzioni di aggregazione basate sul tempo: supporto integrato per finestre, rollup e downsampling su intervalli temporali
Query continue: query permanenti che elaborano i flussi di dati man mano che arrivano
Policy di retention flessibili: regole automatizzate per la riduzione della risoluzione dei dati e l’eventuale eliminazione
Percorsi di ingest ad alta velocità: percorsi di scrittura ottimizzati per gestire milioni di punti dati al secondo
Linguaggi di query orientati al tempo: capacità di query progettate appositamente per operazioni temporali
I progressi recenti includono:
Livelli di compatibilità SQL: portano funzioni specifiche per il tempo nella sintassi SQL familiare
Analytics in-database: forecasting integrato, rilevamento delle anomalie e machine learning
Analisi di correlazione: strumenti per identificare relazioni tra diverse serie temporali
Architetture edge-to-cloud: spostamento fluido dei dati di serie temporali dalla fonte allo storage centrale
Metriche e log unificati: riuniscono tipi di dati di osservabilità tradizionalmente separati
Casi d’uso popolari: database di serie temporali
I database di serie temporali sono diventati essenziali in numerosi ambiti in cui l’analisi dei dati cronologici è critica:
Monitoraggio e osservabilità DevOps: I database di serie temporali costituiscono la spina dorsale delle moderne piattaforme di monitoraggio, archiviando metriche provenienti da infrastrutture, applicazioni e servizi. Consentono ai team di monitorare lo stato dei sistemi, rilevare anomalie, creare soglie di avviso e visualizzare le tendenze delle prestazioni in ambienti complessi.
Gestione dei dati IoT: Le implementazioni IoT industriali sfruttano i database di serie temporali per gestire l’enorme afflusso di dati dei sensori provenienti da dispositivi connessi. Questi database archiviano in modo efficiente le letture di migliaia o milioni di dispositivi, consentendo il monitoraggio delle condizioni, la manutenzione predittiva e l’ottimizzazione operativa.
Analisi finanziaria: Le piattaforme di trading e i sistemi finanziari utilizzano i database di serie temporali per archiviare e analizzare dati di mercato, dalle informazioni di trading tick-by-tick alle metriche finanziarie aggregate. Questi database supportano il backtesting delle strategie di trading, l’analisi del rischio e i requisiti di reporting normativo.
Gestione dell’energia: Le utility e le aziende energetiche impiegano database di serie temporali per monitorare i modelli di generazione, distribuzione e consumo di energia. Questi dati aiutano a ottimizzare le operazioni di rete, bilanciare i carichi e integrare fonti di energia rinnovabile con produzione variabile.
Monitoraggio ambientale: La ricerca climatica, il monitoraggio meteorologico e i sistemi di monitoraggio ambientale si affidano ai database di serie temporali per archiviare misurazioni provenienti da stazioni meteorologiche, satelliti e reti di sensori. Questi database aiutano gli scienziati ad analizzare le tendenze, modellare previsioni e monitorare i cambiamenti ambientali nel tempo.
Confronto diretto: Vector DB vs Time Series DB
| Funzionalità | Database vettoriali (Milvus, Zilliz Cloud, ecc.) | Database di serie temporali | Perché è importante |
| Modello dei dati | Vettori ad alta dimensionalità con metadati | Misurazioni con timestamp e tag | Determina come modelli i concetti del tuo dominio |
| Pattern di query | Ricerca per similarità, k-NN, query di intervallo | Scansioni per intervallo temporale, aggregazioni, downsampling | Determina l'espressività e la complessità delle query |
| Scalabilità | Scalabilità orizzontale con sharding, spesso ad alta intensità di memoria | Partizionamento basato sul tempo, ottimizzato per il throughput in scrittura | Impatta la tua traiettoria di crescita e i costi |
| Pattern di scrittura | Inserimenti batch, aggiornamenti incrementali | Stream ad alta frequenza, solo in append | Influisce sull'architettura di ingestione e sulla latenza |
| Pattern di lettura | Accesso casuale, ricerca approssimata | Scansioni sequenziali entro limiti temporali | Influenza le prestazioni e l'ottimizzazione delle query |
| Efficienza di archiviazione | Quantizzazione vettoriale, riduzione della dimensionalità | Codifica delta, codifica run-length | Determina i costi di archiviazione su larga scala |
| Linguaggio di query | API specifiche per vettori, funzioni di similarità | Linguaggi di query orientati al tempo, funzioni temporali | Influisce sulla curva di apprendimento e sulla produttività degli sviluppatori |
| Complessità di deployment | Da moderata ad alta, tuning dell'indice critico | Moderata, strategia di partizionamento importante | Impatta l'overhead operativo e le competenze necessarie |
| Maturità dell'ecosistema | Più recente, in rapida evoluzione | Standard e strumenti più consolidati | Influenza le risorse disponibili e il supporto della community |
| Tipi di offerta cloud | Opzioni fully-managed e serverless in crescita | Servizi gestiti maturi ampiamente disponibili | Influisce sul modello operativo e sui requisiti di staffing |
Database vettoriali in azione: storie di successo reali
I database vettoriali eccellono in questi casi d'uso:
Retrieval-Augmented Generation (RAG) per la conoscenza aziendale
Una società di consulenza globale ha implementato un sistema RAG utilizzando Zilliz Cloud per alimentare la propria piattaforma interna di conoscenza. Ha convertito milioni di documenti, presentazioni e report di progetto in embedding archiviati in un database vettoriale. Quando i consulenti pongono domande, il sistema recupera il contesto più rilevante dalla loro base di conoscenza e lo passa a un large language model per generare risposte accurate e contestualmente rilevanti.
Questo approccio ha migliorato drasticamente la scoperta della conoscenza, ridotto il tempo di ricerca del 65% e garantito che le risposte fossero basate sull'esperienza e sulle metodologie effettive dell'azienda, anziché su output generici di LLM. Il database vettoriale è stato fondamentale per abilitare il retrieval in tempo reale su enormi raccolte di documenti mantenendo tempi di risposta alle query inferiori al secondo.
Vedi altri case study RAG:
Shulex utilizza Zilliz Cloud per scalare e ottimizzare i suoi servizi VOC
Scopri come MindStudio sfrutta Zilliz Cloud per potenziare la creazione di app AI
Ivy.ai scala la comunicazione basata su GenAI con il database vettoriale Zilliz Cloud
RAG agentico per flussi di lavoro complessi
Agentic RAG è un framework RAG avanzato che potenzia il framework RAG tradizionale incorporando capacità di agenti intelligenti. Un fornitore di tecnologia sanitaria ha creato un sistema RAG agentico che utilizza la ricerca vettoriale per alimentare uno strumento di supporto alle decisioni cliniche. Il sistema memorizza conoscenze mediche, linee guida terapeutiche e storie di casi clinici dei pazienti come embedding in un database vettoriale. Quando i medici inseriscono scenari clinici complessi, il sistema agentico:
Scompone la query complessa in sotto-domande
Esegue ricerche vettoriali mirate per ciascuna sotto-domanda
Valuta e sintetizza le informazioni recuperate
Determina se sono necessarie ulteriori ricerche
Fornisce una risposta completa e basata su evidenze
Questa implementazione avanzata ha ridotto il tempo decisionale clinico del 43% e migliorato l’accuratezza delle raccomandazioni terapeutiche del 28% negli studi di validazione. La capacità del database vettoriale di eseguire più ricerche rapide di similarità con contesti diversi è stata essenziale per il processo di ragionamento multi-step dell’agente.
DeepSearcher, sviluppato dagli ingegneri di Zilliz, è un esempio primario di RAG agentico ed è anche un’alternativa locale e open-source a Deep Research di OpenAI. Ciò che distingue DeepSearcher è la sua combinazione unica di modelli di ragionamento avanzati, funzionalità di ricerca sofisticate e un assistente di ricerca integrato. Sfruttando Milvus (un database vettoriale ad alte prestazioni creato da Zilliz) per l’integrazione dei dati locali, offre risultati di ricerca più rapidi e pertinenti, consentendo al contempo una facile sostituzione dei modelli per esperienze personalizzate.
Ricerca semantica oltre le parole chiave
Una società fintech con cui ho lavorato ha sostituito la propria ricerca tradizionale con un approccio basato su database vettoriale, consentendo ai clienti di cercare nelle cronologie delle transazioni con query in linguaggio naturale come "bar lo scorso weekend" o "abbonamenti mensili." Il loro database vettoriale indicizzava embedding delle descrizioni delle transazioni, delle categorie dei commercianti e del contesto specifico dell’utente.
I risultati sono stati notevoli: la pertinenza della ricerca è migliorata del 37%, le richieste al supporto clienti sono diminuite del 22% e gli utenti hanno segnalato una soddisfazione significativamente più elevata per la funzione di ricerca, il tutto riducendo effettivamente i costi infrastrutturali rispetto alla precedente implementazione di ricerca per parole chiave.
Vedi altri casi di studio sulla ricerca semantica:
HumanSignal offre una scoperta dei dati più rapida utilizzando Milvus e AWS
Credal AI sblocca una GenAI sicura e governabile con il database vettoriale Milvus
Shulex utilizza Zilliz Cloud per scalare e ottimizzare i suoi servizi VOC
Tokopedia ha ottenuto una ricerca 10 volte più intelligente con Milvus
Raccomandazione di contenuti che funziona davvero
Una piattaforma di streaming multimediale ha sostituito il proprio motore di raccomandazione tradizionale con un approccio basato su database vettoriale, codificando sia le caratteristiche dei contenuti sia le preferenze degli utenti come embedding nello stesso spazio vettoriale. Questo ha permesso loro di trovare una reale similarità tra contenuti invece di affidarsi esclusivamente al filtraggio collaborativo.
Il cambiamento ha ridotto il problema del "cold start" per i nuovi contenuti del 64% e aumentato il coinvolgimento degli spettatori con contenuti di nicchia del 42%. Ancora più importante, ha consentito loro di spiegare le raccomandazioni agli utenti in modi intuitivi ("visivamente simile a X ma con temi come Y"), aumentando la fiducia nel sistema di raccomandazione.
Ricerca di immagini basata sull’AI
Un cliente retail ha implementato la ricerca visuale utilizzando un database vettoriale per archiviare gli embedding delle immagini del proprio catalogo prodotti. I clienti potevano ora caricare immagini o screenshot per trovare prodotti visivamente simili—qualcosa che era praticamente impossibile con la loro precedente infrastruttura di ricerca.
Questa funzionalità ha generato un aumento del 28% delle conversioni da mobile e ha aperto percorsi di acquisto completamente nuovi, in particolare per le categorie moda e arredamento per la casa, dove la somiglianza visiva spesso conta più delle descrizioni testuali.
Scopri altri casi di studio sulla ricerca di immagini:
Bosch Gets 80% Cost Cut and Better Image Search Performance using Milvus
Picdmo Revolutionizes Photo Management with Zilliz Cloud Vector Database
Database per serie temporali in azione: storie di successo reali
I database per serie temporali eccellono in questi scenari:
Osservabilità DevOps su larga scala
Un’azienda SaaS alle prese con una visibilità insufficiente sul monitoraggio ha consolidato la propria infrastruttura di metriche su un database per serie temporali. È passata dall’archiviazione di metriche di sistema di base alla raccolta di centinaia di misurazioni specifiche dell’applicazione su migliaia di microservizi.
Questa visibilità granulare ha ridotto del 76% il tempo medio di rilevamento degli incidenti e ha consentito di implementare uno scaling predittivo che ha ridotto i costi dell’infrastruttura del 23%. Il database per serie temporali gestiva milioni di punti dati al secondo mantenendo la latenza delle query sotto i 200ms per le loro dashboard.
Trasformazione della gestione di flotte IoT
Un produttore di apparecchiature industriali ha implementato un database per serie temporali per raccogliere telemetria dai macchinari distribuiti. Il sistema acquisiva letture dei sensori da oltre 50.000 dispositivi, con ogni dispositivo che riportava 20-30 metriche ogni pochi secondi.
Questa visibilità in tempo reale ha permesso di sviluppare algoritmi di manutenzione predittiva che hanno ridotto i tempi di inattività non pianificati del 38% e prolungato la vita utile delle apparecchiature di un 15% stimato. Le funzionalità di downsampling automatico del database per serie temporali hanno mantenuto gestibili i costi di archiviazione nonostante la raccolta di oltre 15 miliardi di punti dati al mese.
Evoluzione dell’analisi dei mercati finanziari
Una società di trading ha sostituito il proprio database tradizionale con un database per serie temporali per l’analisi dei dati di mercato. Ha archiviato dati tick-by-tick per migliaia di titoli, abilitando sia analisi in tempo reale sia il riconoscimento di pattern storici.
La migrazione ha prodotto miglioramenti delle prestazioni delle query da 50 a 200 volte per le analisi basate sul tempo, consentendo ai trader di eseguire backtest delle strategie su dataset storici molto più ampi e di identificare più rapidamente opportunità di mercato. La capacità del database per serie temporali di archiviare e interrogare in modo efficiente anni di dati ad alta frequenza ha trasformato le loro capacità di ricerca quantitativa.
Ricerca vettoriale nei database per serie temporali: pronta per il grande salto?
Diversi database per serie temporali come InfluxDB hanno aggiunto funzionalità di ricerca vettoriale, ma come si confrontano con i database vettoriali dedicati? Ecco la mia valutazione basata sull’implementazione di entrambi gli approcci:
Implementazioni attuali
InfluxDB offre la ricerca vettoriale tramite il suo motore di archiviazione IOx, supportando metriche di distanza standard ma con limitazioni dimensionali
TimescaleDB sfrutta l’estensione pgvector di PostgreSQL, fornendo solide operazioni vettoriali all’interno di un ambiente SQL familiare
KDB.ai dispone di funzionalità vettoriali sperimentali con impegni futuri nella roadmap
Aspettative realistiche sulle prestazioni
Nei miei benchmark, ho riscontrato:
Prestazioni delle query: i database vettoriali dedicati in genere offrono query vettoriali 5-20 volte più veloci su larga scala rispetto alle estensioni vettoriali nei database per serie temporali
Creazione degli indici: i database vettoriali ricostruiscono gli indici 3-10 volte più velocemente dopo aggiornamenti significativi
Efficienza della memoria: i database vettoriali purpose-built generalmente richiedono il 30-50% di memoria in meno per raccolte vettoriali comparabili
Qualità del recall: i database vettoriali nativi raggiungono tassi di recall migliori a parità di obiettivi di latenza
Tuttavia, i database time series con funzionalità vettoriali possono essere sufficienti quando:
La tua collezione di vettori è di dimensioni moderate (inferiore a ~5 milioni di vettori)
Stai lavorando con embedding a dimensionalità inferiore (in genere <100 dimensioni)
La ricerca vettoriale è un carico di lavoro supplementare piuttosto che primario
Le tue query combinano frequentemente intervalli temporali con ricerca per similarità
Framework decisionale: scegliere la giusta architettura di database
Dopo aver aiutato numerose organizzazioni a prendere questa decisione, ho sviluppato questo framework pratico:
Scegli un database vettoriale quando:
La similarità basata sull'AI è la tua proposta di valore principale - Lo scopo primario della tua applicazione ruota attorno alla ricerca di elementi correlati basati sulla similarità semantica o percettiva
La qualità della ricerca è critica per il business - Anche piccoli miglioramenti nella pertinenza della ricerca si traducono in risultati aziendali misurabili
Stai lavorando con embedding ad alta dimensionalità - I tuoi vettori hanno centinaia o migliaia di dimensioni da moderni modelli di embedding
Hai bisogno di operazioni vettoriali sofisticate - La tua applicazione richiede ricerca avanzata dei vicini più prossimi, clustering o operazioni matematiche sui vettori
Le prestazioni della ricerca vettoriale sono il collo di bottiglia - La latenza delle query per le operazioni vettoriali influisce direttamente sull'esperienza utente
Scegli un database time series quando:
Il tempo è la tua dimensione di query principale - La maggior parte delle tue query coinvolge intervalli temporali, aggregazioni o trend
Stai raccogliendo metriche ad alta frequenza - Devi ingerire migliaia o milioni di misurazioni al secondo
La gestione del ciclo di vita dei dati è complessa - Hai requisiti specifici per downsampling, conservazione e accesso ai dati storici
L'analisi basata sul tempo è il tuo focus principale - I tuoi casi d'uso primari riguardano la comprensione di pattern e trend nel tempo
L'ingestione continua non può avere downtime - Il tuo percorso di scrittura deve essere estremamente resiliente e costantemente performante
Considera un approccio ibrido quando:
Hai carichi di lavoro distinti con confini chiari - Alcune applicazioni traggono beneficio da database dedicati per i loro specifici pattern di query
I tuoi dati fluiscono naturalmente tra domini temporali e semantici - I dati time series alimentano la generazione di embedding e l'analisi semantica
Hai bisogno delle migliori prestazioni per entrambi i tipi di carico di lavoro - I database specializzati supereranno le prestazioni delle soluzioni "tuttofare"
Puoi giustificare la complessità operativa - Il tuo team ha l'esperienza per gestire efficacemente più sistemi di database
Considera un DB time series con funzionalità vettoriali quando:
Il tuo carico di lavoro principale è time series con query vettoriali occasionali - La funzionalità vettoriale è supplementare alla tua analisi basata sul tempo principale
La semplicità operativa supera le prestazioni di picco - Gestire un singolo sistema di database è una priorità più alta rispetto a massimizzare le prestazioni delle query
Le tue esigenze di ricerca vettoriale sono modeste - Sia in termini di dimensione della collezione sia di dimensionalità
Le tue query combinano frequentemente intervalli temporali con similarità - Devi integrare senza soluzione di continuità entrambi i tipi di query
Benchmarking delle tue soluzioni di ricerca vettoriale in autonomia
VectorDBBench è uno strumento di benchmarking open-source progettato per utenti che richiedono sistemi di archiviazione e recupero dei dati ad alte prestazioni, in particolare database vettoriali. Questo strumento consente agli utenti di testare e confrontare le prestazioni di diversi sistemi di database vettoriali utilizzando i propri dataset e di determinare quello più adatto ai loro casi d'uso. Utilizzando VectorDBBench, gli utenti possono prendere decisioni informate basate sulle prestazioni effettive del database vettoriale anziché affidarsi a dichiarazioni di marketing o prove aneddotiche.
VectorDBBench è scritto in Python e rilasciato con licenza open-source MIT, il che significa che chiunque può usarlo, modificarlo e distribuirlo liberamente. Lo strumento è mantenuto attivamente da una community di sviluppatori impegnati a migliorarne le funzionalità e le prestazioni.
Dai un'occhiata alla classifica di VectorDBBench per uno sguardo rapido alle prestazioni dei principali database vettoriali.
Realtà dell'implementazione: ciò che avrei voluto sapere prima
Dopo aver implementato entrambi i tipi di database in più organizzazioni, ecco alcune considerazioni pratiche che spesso vengono trascurate:
Pianificazione delle risorse
I database vettoriali possono essere sorprendentemente avidi di memoria, spesso richiedendo 2-4 volte più RAM di quanto potresti stimare inizialmente in base alla dimensione dei dati grezzi
I database di serie temporali richiedono un'attenta pianificazione dello storage, con carichi di lavoro ad alta intensità di scrittura che potrebbero richiedere SSD o NVMe per prestazioni ottimali
Le considerazioni sullo scaling differiscono fondamentalmente: i database vettoriali spesso scalano con la dimensione della raccolta e la complessità delle query, mentre i database di serie temporali scalano con il tasso di ingestione e il periodo di conservazione
Esperienza di sviluppo
I paradigmi di query sono fondamentalmente diversi e richiedono modelli mentali distinti da parte del tuo team di sviluppo
La gestione degli errori varia in modo significativo tra questi tipi di database, con diverse modalità di guasto che richiedono un monitoraggio specializzato
Le tecniche di ottimizzazione delle prestazioni sono specifiche per il database e richiedono competenze specialistiche
Realtà operative
Le strategie di backup differiscono sostanzialmente a causa dei diversi modelli di dati e pattern di aggiornamento
I requisiti di monitoraggio variano, con metriche chiave diverse che indicano lo stato di salute del sistema
I pattern di aggiornamento influiscono sulle procedure operative, con i database vettoriali che spesso richiedono una reindicizzazione periodica per prestazioni ottimali
Conclusione: scegli lo strumento giusto, ma resta flessibile
La scelta tra database vettoriali e database di serie temporali non consiste nello scegliere un vincitore: si tratta di abbinare l'architettura del tuo database alle caratteristiche specifiche dei tuoi dati e ai tuoi pattern di query.
Se il tuo caso d'uso principale implica trovare elementi simili o relazioni semantiche, un database vettoriale probabilmente ha senso come base. Se la tua esigenza fondamentale è tracciare e analizzare come i valori cambiano nel tempo, un database di serie temporali è probabilmente il tuo punto di partenza.
Le architetture dati più sofisticate che ho contribuito a costruire non evitano i database specializzati: li adottano creando al contempo interfacce pulite che nascondono la complessità agli sviluppatori di applicazioni. Questo approccio ti offre i vantaggi prestazionali dei sistemi specializzati mantenendo al tempo stesso la velocità di sviluppo.
Qualunque percorso tu scelga, la chiave è costruire con sufficiente flessibilità per evolvere man mano che sia i tuoi requisiti sia il panorama dei database continuano a cambiare. La convergenza tra funzionalità vettoriali e di serie temporali è appena iniziata, e le architetture di maggior successo saranno quelle in grado di adattarsi per incorporare il meglio di entrambi i mondi.

Continua a leggere
Introducing Business Critical Plan: Enterprise-Grade Security and Compliance for Mission-Critical AI Applications
Discover Zilliz Cloud’s Business Critical Plan—offering advanced security, compliance, and uptime for mission-critical AI and vector database workloads.
Our Journey to 35K+ GitHub Stars: The Real Story of Building Milvus from Scratch
Join us in celebrating Milvus, the vector database that hit 35.5K stars on GitHub. Discover our story and how we’re making AI solutions easier for developers.
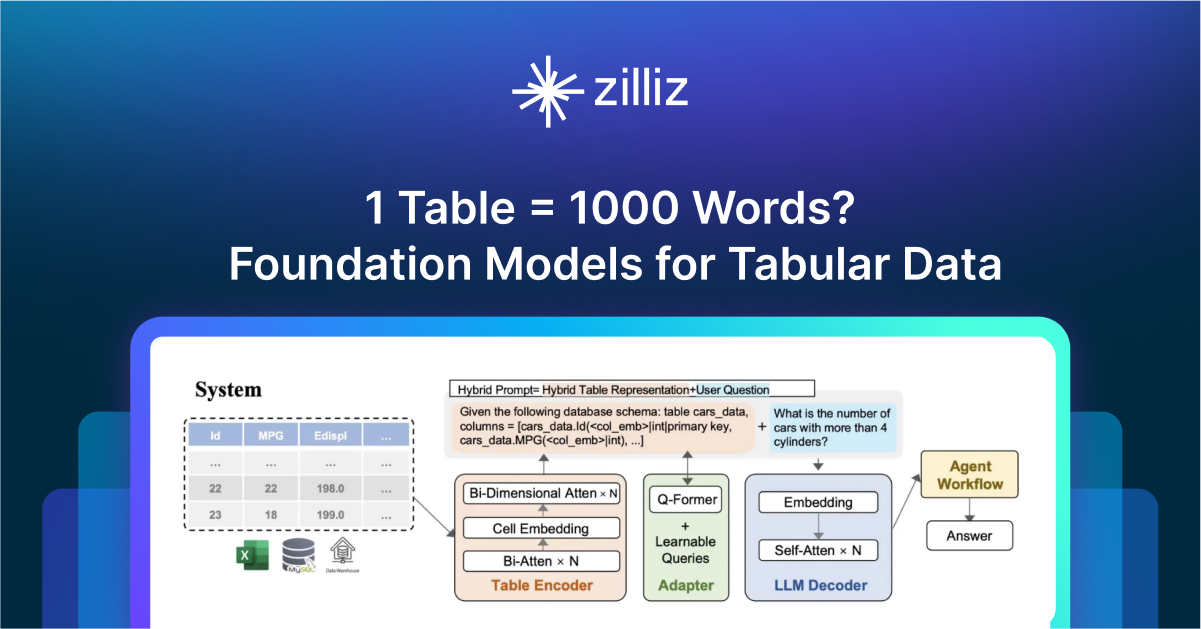
1 Table = 1000 Words? Foundation Models for Tabular Data
TableGPT2 automates tabular data insights, overcoming schema variability, while Milvus accelerates vector search for efficient, scalable decision-making.