GPTCache, LangChain, сильный альянс
Введение в GPTCache
ChatGPT и другие большие языковые модели (LLM) обладают невероятной универсальностью, которую можно использовать для разработки широкого спектра приложений. Однако по мере роста популярности приложений, разработанных с использованием LLM, и увеличения уровня трафика стоимость, связанная с вызовами LLM API, может стать непомерно высокой. Кроме того, сервисы LLM могут демонстрировать медленное время отклика при обработке больших объемов запросов.
Чтобы решить эту задачу, мы создали проект GPTCache, предназначенный для создания семантического кэша для хранения ответов LLM.
Введение в LangChain
Большие языковые модели (LLM) становятся преобразующей технологией, которая позволяет разработчикам создавать приложения, ранее невозможные. Однако опора исключительно на одну LLM часто затрудняет создание действительно мощного приложения. Настоящая сила заключается в их сочетании с другими вычислительными источниками или источниками знаний. Поэтому библиотека LangChain направлена на помощь в разработке таких типов приложений.
Текущее состояние LangChain Cache
До интеграции GPTCache кэш LangChain основывался на сопоставлении строк. При таком подходе сопоставления строк последующий запрос может получить соответствующие данные из кэша, когда два запроса имеют идентичные строки. Реализация включает Memory Cache, SQLite Cache и Redis Cache.
Использование примерно следующее:
import langchain
from langchain.cache import InMemoryCache
langchain.llm_cache = InMemoryCache()
llm = OpenAI(model_name="text-davinci-002", n=2, best_of=2)

// CPU times: user 14.2 ms, sys: 4.9 ms, total: 19.1 ms
// Wall time: 1.1 s
llm("Tell me a joke")

// CPU times: user 162 µs, sys: 7 µs, total: 169 µs
// Wall time: 175 µs
llm("Tell me a joke")
Анализ LangChain Cache
С точки зрения времени выполнения очевидно, что если запрос попадает в кэш, это значительно сократит время отклика. В то же время текущая стоимость использования LLM относительно высока. Использование онлайн-сервисов, таких как OpenAI и Cohere, обычно влечет за собой оплату через токены или самостоятельное развертывание соответствующей модели LLM, при этом время однократного вывода зависит от количества компьютерных ресурсов, включая CPU, память, GPU и т. д. В то же время, если несколько запросов обрабатываются одновременно, предъявляются более высокие требования к вычислительным ресурсам. Если запросы многократно попадают в кэш, это может снизить нагрузку на компьютерные ресурсы и предоставить больше вычислительных ресурсов другим задачам.
Условие попадания LangChain в кэш заключается в том, что два вопроса должны быть идентичными. К сожалению, при фактическом использовании по-прежнему сложно добиться попадания в кэш, и существует большой потенциал для повышения коэффициента использования кэша.
Интеграция GPTCache
Интеграция GPTCache значительно улучшит функциональность модуля кэша LangChain, повысит коэффициент попадания в кэш и, таким образом, снизит затраты на использование LLM и время отклика. Это связано с тем, что GPTCache сначала выполняет операции embedding над входными данными для получения вектора, а затем выполняет поиск векторного приближения в хранилище кэша. После получения результатов поиска он выполняет оценку сходства и возвращает результат при достижении установленного порога. Настройка порога может изменить точность результатов его нечеткого поиска.
Пример использования GPTCache для поиска по сходству в LangChain:
from gptcache import Cache
from gptcache.adapter.api import init_similar_cache
from langchain.cache import GPTCache
import hashlib
def get_hashed_name(name):
   return hashlib.sha256(name.encode()).hexdigest()
def init_gptcache(cache_obj: Cache, llm: str):
   hashed_llm = get_hashed_name(llm)
   init_similar_cache(cache_obj=cache_obj, data_dir=f"similar_cache_{hashed_llm}")
langchain.llm_cache = GPTCache(init_gptcache)

# В первый раз этого ещё нет в кэше, поэтому это должно занять больше времени
# CPU times: user 1.42 s, sys: 279 ms, total: 1.7 s
# Wall time: 8.44 s
llm("Tell me a joke")

# Это точное совпадение, поэтому он находит это в кэше
# CPU times: user 866 ms, sys: 20 ms, total: 886 ms
# Wall time: 226 ms
llm("Tell me a joke")

# Это не точное совпадение, но семантически находится в пределах расстояния, поэтому происходит попадание!
# CPU times: user 853 ms, sys: 14.8 ms, total: 868 ms
# Wall time: 224 ms
llm("Tell me joke")
Мы продолжаем развивать функциональность GPT-Cache, и если у вас будет возможность попробовать его, дайте нам знать, что вы думаете. У нас также есть несколько отличных ресурсов, с которыми вам стоит ознакомиться!
Ссылки:

Читать далее
What Is a Vector Lakebase?
A Vector Lakebase is a unified, lake-native data architecture for AI that combines vector-database-grade serving with open lake storage, reusable lake-level indexes, and a shared semantic layer.
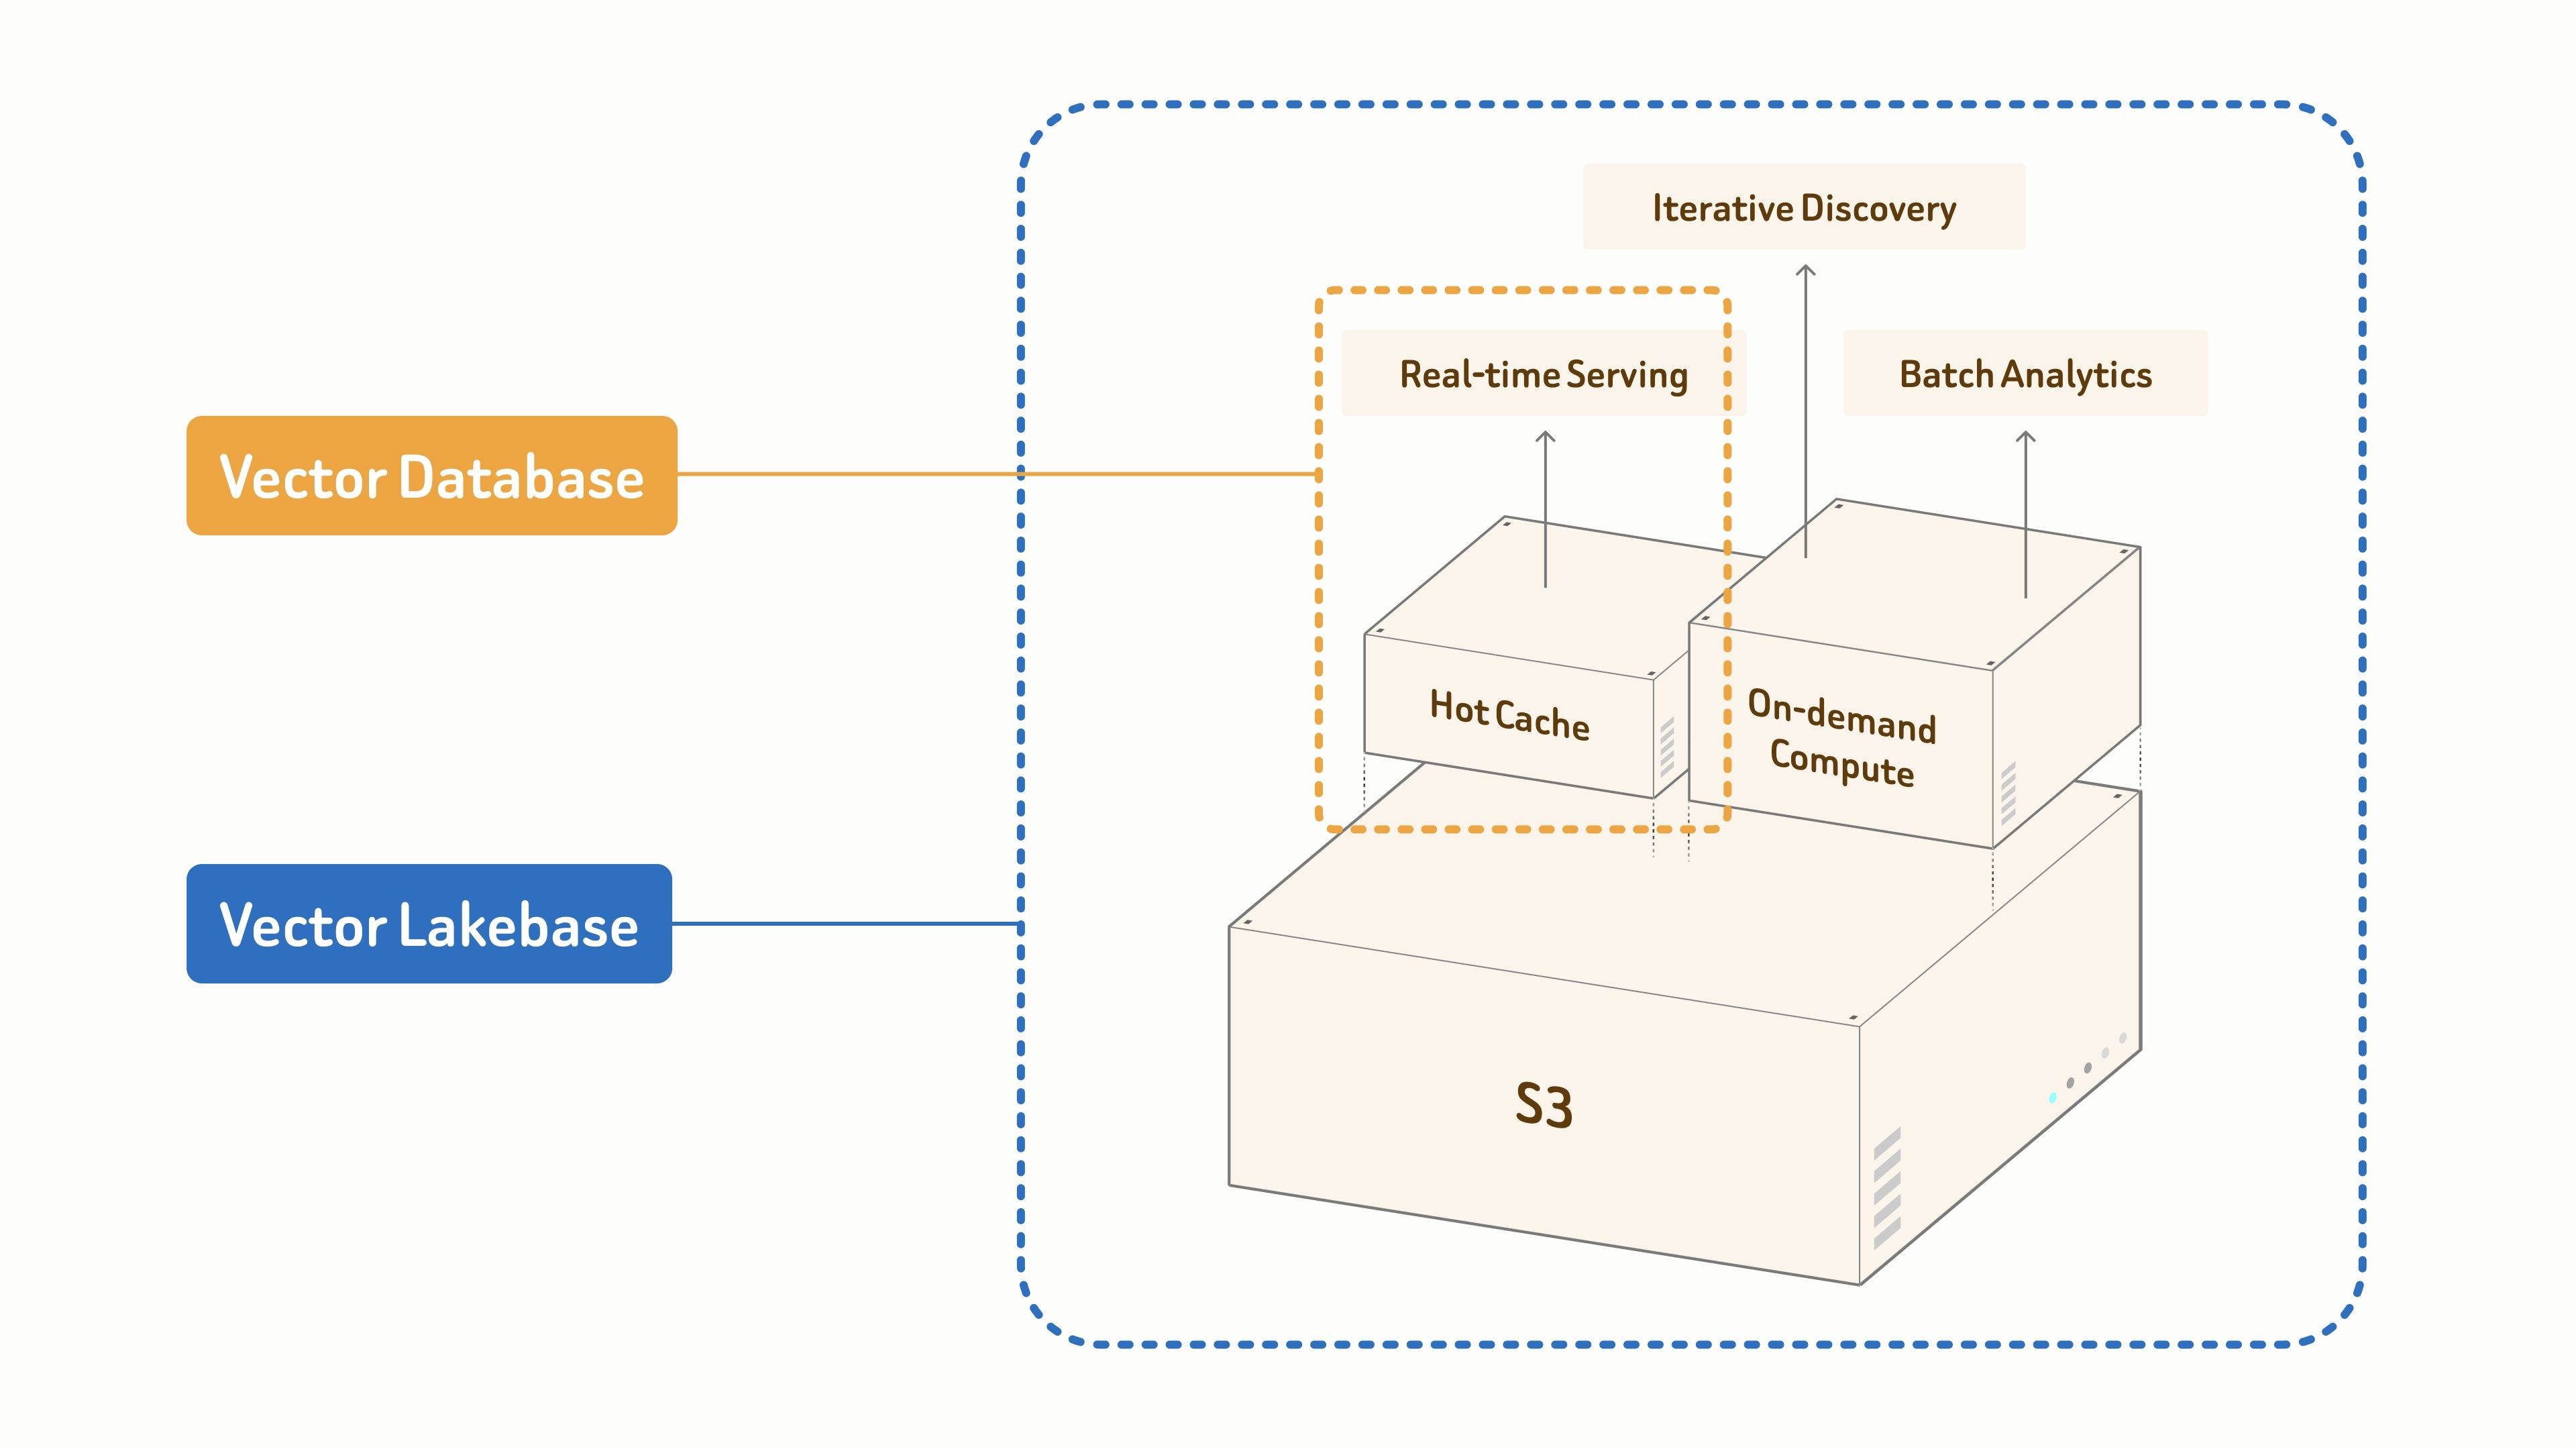
From Vector Database to Vector Lakebase
Zilliz offers a fully managed Vector Lakebase powered by Milvus, unifying real-time vector search, lake-scale discovery, and Al data operations.
Legal Document Analysis: Harnessing Zilliz Cloud's Semantic Search and RAG for Legal Insights
Enhance legal document analysis with Zilliz Cloud’s Semantic Search and RAG. Improve accuracy, efficiency, and scalability for contracts, case law, and compliance.