Создание интеллектуальных RAG-приложений с LangServe, LangGraph и Milvus
Эта публикация в блоге является продолжением моей предыдущей статьи о Local Agentic RAG with LangGraph and Llama 3.
В этой публикации в блоге мы рассмотрим, как создавать приложения с использованием LangServe и LangGraph, двух мощных инструментов из экосистемы LangChain. Мы также будем использовать Milvus в качестве векторной базы данных. Мы покажем вам, как настроить приложение FastAPI, сконфигурировать LangServe и LangGraph и использовать Milvus для эффективного извлечения данных.
Следуйте за видеоуроком
Чему вы научитесь
Настройка приложения FastAPI с LangServe и LangGraph.
Интеграция Milvus для векторного хранения и поиска.
Создание LLM-агента с LangGraph
Предварительные требования
Прежде чем мы начнем, убедитесь, что у вас установлены следующие зависимости:
Python 3.9+
Docker
Базовые знания FastAPI и Docker
Введение в LangServe и Milvus
LangServe — это расширение FastAPI, предназначенное для упрощения создания динамических и мощных конечных точек, использующих LangChain. Оно позволяет определять сложные рабочие процессы обработки, которые можно предоставлять в виде конечных точек API.
LangGraph — расширение Langchain, предназначенное для создания надежных и сохраняющих состояние многоакторных приложений с LLM путем моделирования шагов как ребер и узлов в графе.
Milvus — это высокопроизводительная векторная база данных с открытым исходным кодом, созданная для масштабирования. Milvus Lite, легковесная и локальная версия Milvus, может запускаться на вашем личном устройстве без необходимости в Docker или Kubernetes.
Создание агентов с вызовом инструментов с помощью LangGraph
В нашей предыдущей публикации в блоге мы обсуждали, как LangGraph может значительно расширить возможности языковых моделей, обеспечивая вызов инструментов. Здесь мы продемонстрируем, как создавать таких агентов с LangServe и развертывать их в различных инфраструктурах с использованием Docker.
Введение в Agentic RAG
Агенты могут превращать языковые модели в мощные механизмы рассуждения, которые определяют действия, выполняют их и оценивают результаты. Этот процесс известен как Agentic RAG (Retrieval Augmented Generation). Агенты могут:
Выполнять веб-поиск
Просматривать электронную почту
Проводить самоанализ или самооценку извлеченных документов
Выполнять пользовательские функции, определенные пользователем
И многое другое…
Настройка
LangGraph: расширение LangChain для создания приложений с сохранением состояния с LLM, использующее графы для моделирования шагов и решений.
Ollama & Llama 3: Ollama позволяет запускать языковые модели с открытым исходным кодом, такие как Llama 3, локально, обеспечивая автономное использование и больший контроль.
Milvus Lite: локальная версия Milvus для эффективного векторного хранения и извлечения данных, подходящая для запуска на личных устройствах.
Использование LangServe и Milvus
LangServe позволяет предоставлять сложные рабочие процессы обработки в виде API-эндпоинтов. Здесь мы показываем пример для функции analyze_text: мы добавляем эндпоинт /analyze в наше приложение FastAPI, что делает возможным отправлять к нему запросы.
- Определите ваше приложение FastAPI:
import uvicorn

from fastapi import FastAPI
from pydantic import BaseModel
from langchain_core.runnables import RunnableLambda
from langserve import add_routes

# Define Pydantic model for request body
class QuestionRequest(BaseModel):
    question: str

fastapi_app = FastAPI()

# Define LangServe route for text analysis
@fastapi_app.post("/analyze")
async def analyze_text(request: QuestionRequest):
    # Simulate text analysis (replace with your actual LangServe logic)
    entities = ["entity1", "entity2"]
    processed_data = f"Processed entities: {entities}"
    return {"entities": entities, "processed_data": processed_data}
add_routes(fastapi_app, RunnableLambda(analyze_text))

if __name__ == "__main__":
    uvicorn.run(fastapi_app, host="0.0.0.0", port=5001)
- Интегрируйте LangGraph для управления рабочими процессами:
Используйте LangGraph, чтобы создать кастомного RAG-агента на базе Llama3, который может справляться с различными задачами, например направлять пользовательские запросы к наиболее подходящему методу извлечения или выполнять самокоррекцию для повышения качества ответов. Ознакомьтесь с нашим блогом о LangGraph, чтобы увидеть, как это можно сделать.
- Используйте Milvus для эффективного извлечения данных:
Интегрируйте Milvus для эффективного хранения и извлечения векторных данных. Этот шаг обеспечит быстрый доступ к релевантной информации и повысит производительность вашего приложения.
from langchain_core.documents import Document

def load_and_split_documents(urls: list[str]) -> list[Document]:
    docs = [WebBaseLoader(url).load() for url in urls]
    docs_list = [item for sublist in docs for item in sublist]
    text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(chunk_size=250, chunk_overlap=0)
    return text_splitter.split_documents(docs_list)

def add_documents_to_milvus(doc_splits: list[Document], embedding_model: Embeddings, connection_args: Any):
    vectorstore = Milvus.from_documents(documents=doc_splits, collection_name="rag_milvus", embedding=embedding_model, connection_args=connection_args)
    return vectorstore.as_retriever()

urls = [
"https://lilianweng.github.io/posts/2023-06-23-agent/",
"https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/",
"https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/",
]

doc_splits = load_and_split_documents(urls)
embedding_model = HuggingFaceEmbeddings()
connection_args = {"uri": "./milvus_rag.db"}
retriever = add_documents_to_milvus(doc_splits, embedding_model, connection_args)

#Function that the Agent will call when needed.
def retrieve(state: Dict[str, Any]) -> Dict[str, Any]:
    print("---RETRIEVE---")
    question = state["question"]
    documents = retriever.invoke(question)
    return {"documents": [doc.page_content for doc in documents], "question": question}
Пожалуйста, ознакомьтесь с кодом на моем GitHub.
Заключение
В этой публикации блога мы показали, как создать RAG-систему с использованием агентов с LangServe, LangGraph, Llama 3 и Milvus. Эти агенты расширяют возможности LLM за счет включения планирования, памяти и использования инструментов, что приводит к более надежным и информативным ответам. Интегрируя LangServe, вы можете предоставлять эти сложные рабочие процессы в виде API-эндпоинтов, что упрощает создание и развертывание интеллектуальных приложений.
Если вам понравилась эта публикация блога, поставьте нам звезду на Github и присоединяйтесь к нашему Discord, чтобы поделиться своим опытом с сообществом.
Читать далее
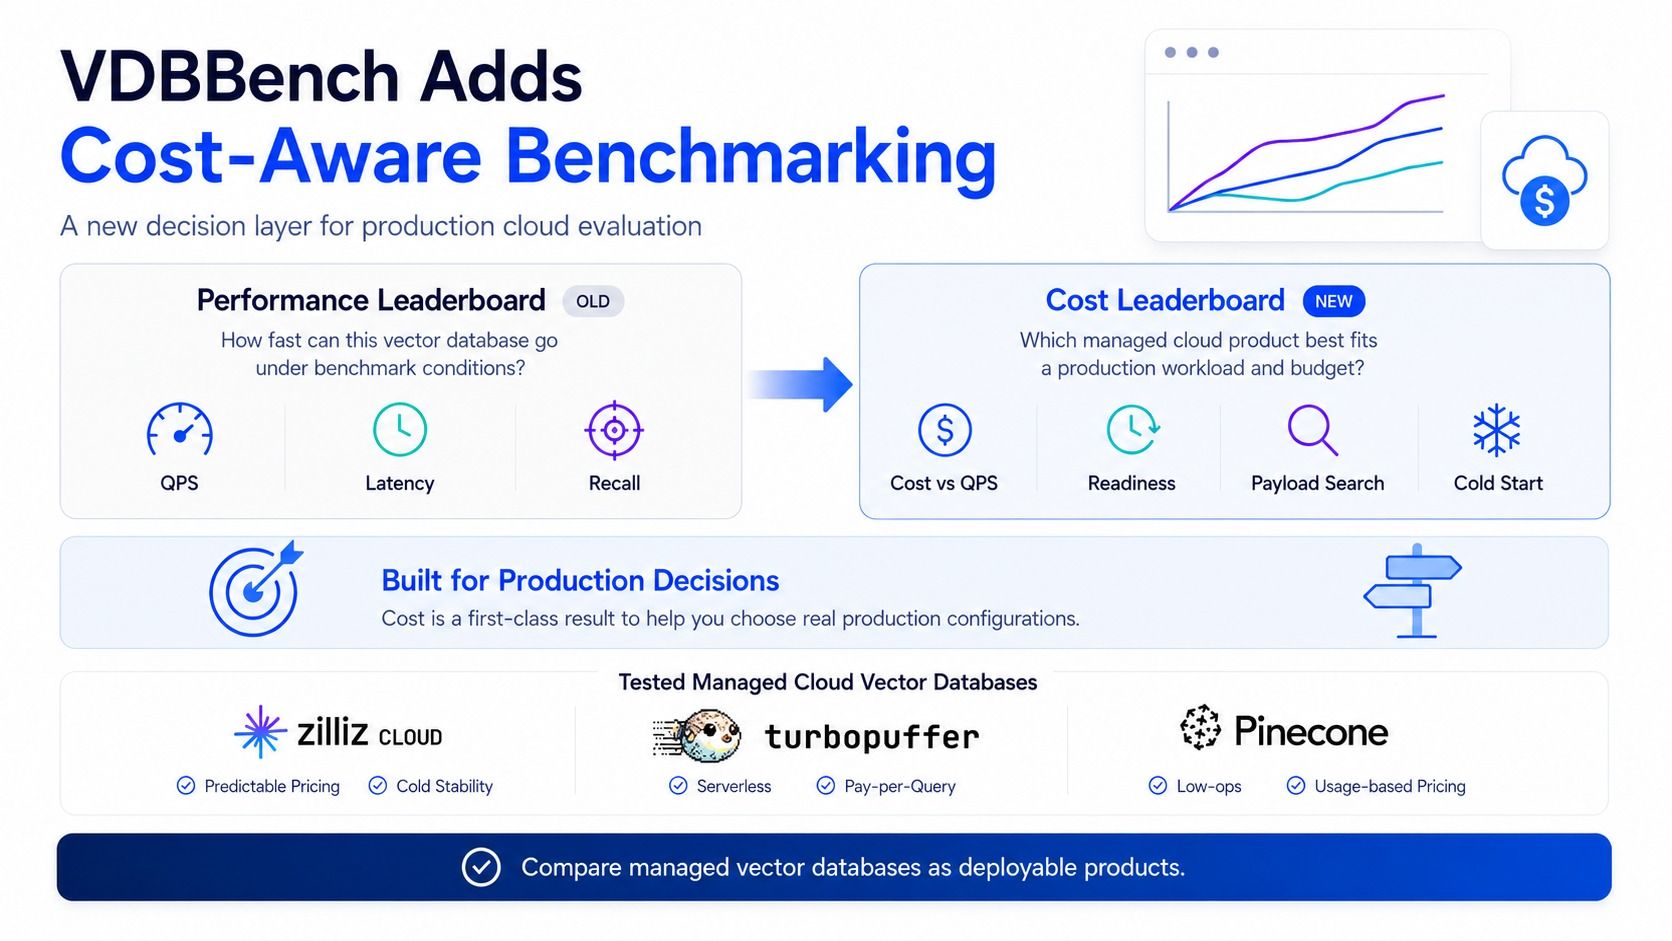
VDBBench Adds Cost-Aware Benchmarking for Vector Databases
Compare Zilliz Cloud, Pinecone, and turbopuffer with VDBBench cost-aware vector database benchmarks across latency, freshness, multitenancy, and cold starts.
Announcing the General Availability of Single Sign-On (SSO) on Zilliz Cloud
SSO is GA on Zilliz Cloud, delivering the enterprise-grade identity management capabilities your teams need to deploy vectorDB with confidence.
Why Context Engineering Is Becoming the Full Stack of AI Agents
Discover how context engineering unifies prompts, RAG, and tools to build smarter, production-ready AI agents powered by Milvus.