Итоги вебинара: улучшите свою LLM с помощью частных данных, используя LlamaIndex
Популярность ChatGPT продемонстрировала возможности больших языковых моделей (LLMs) в генерации знаний и рассуждении. Однако ChatGPT предварительно обучен на общедоступных данных, которые могут не предоставлять конкретных ответов и результатов, релевантных вашему бизнесу. Так как же лучше всего дополнить наши LLMs частными данными? LlamaIndex — одно из самых популярных решений. Это простой, гибкий, централизованный интерфейс, соединяющий ваши внешние данные и LLMs.
В нашем недавнем вебинаре Jerry Liu, соучредитель и CEO LlamaIndex, объяснил, как LlamaIndex может усилить ваши LLMs с помощью частных данных. Кроме того, Frank Liu, архитектор машинного обучения и директор по операционной деятельности в Zilliz, также поделился своими взглядами на LLMs. Присоединяйтесь ко мне, чтобы изучить ключевые выводы из этого вебинара и ответить на некоторые оставшиеся без ответа вопросы аудитории.
Тонкая настройка и обучение в контексте
«Как улучшить LLMs с помощью частных данных» — это вопрос, который задают многие разработчики LLM. На вебинаре Jerry обсудил два метода: тонкую настройку и обучение в контексте. Тонкая настройка требует повторного обучения сети на частных данных, но это может быть дорогостоящим и недостаточно прозрачным. Кроме того, она может быть эффективна только в некоторых случаях. С другой стороны, обучение в контексте предполагает объединение предварительно обученной модели с внешними знаниями и моделью поиска, чтобы добавить контекст к входному промпту. Однако возникают сложности при объединении поиска и генерации, извлечении подходящего контекста и управлении обширными исходными данными. LlamaIndex — это инструментарий, разработанный для решения задач обучения в контексте.
Что такое LlamaIndex?
LlamaIndex — это инструмент с открытым исходным кодом, который предоставляет центральный интерфейс управления данными и запросов для ваших LLM-приложений. Его инструментарий содержит три основных компонента:
- Коннекторы данных для получения данных из различных источников.
- Индексы данных для структурирования данных под разные сценарии использования.
- Интерфейс запросов для ввода промптов и получения выходных данных, дополненных знаниями.
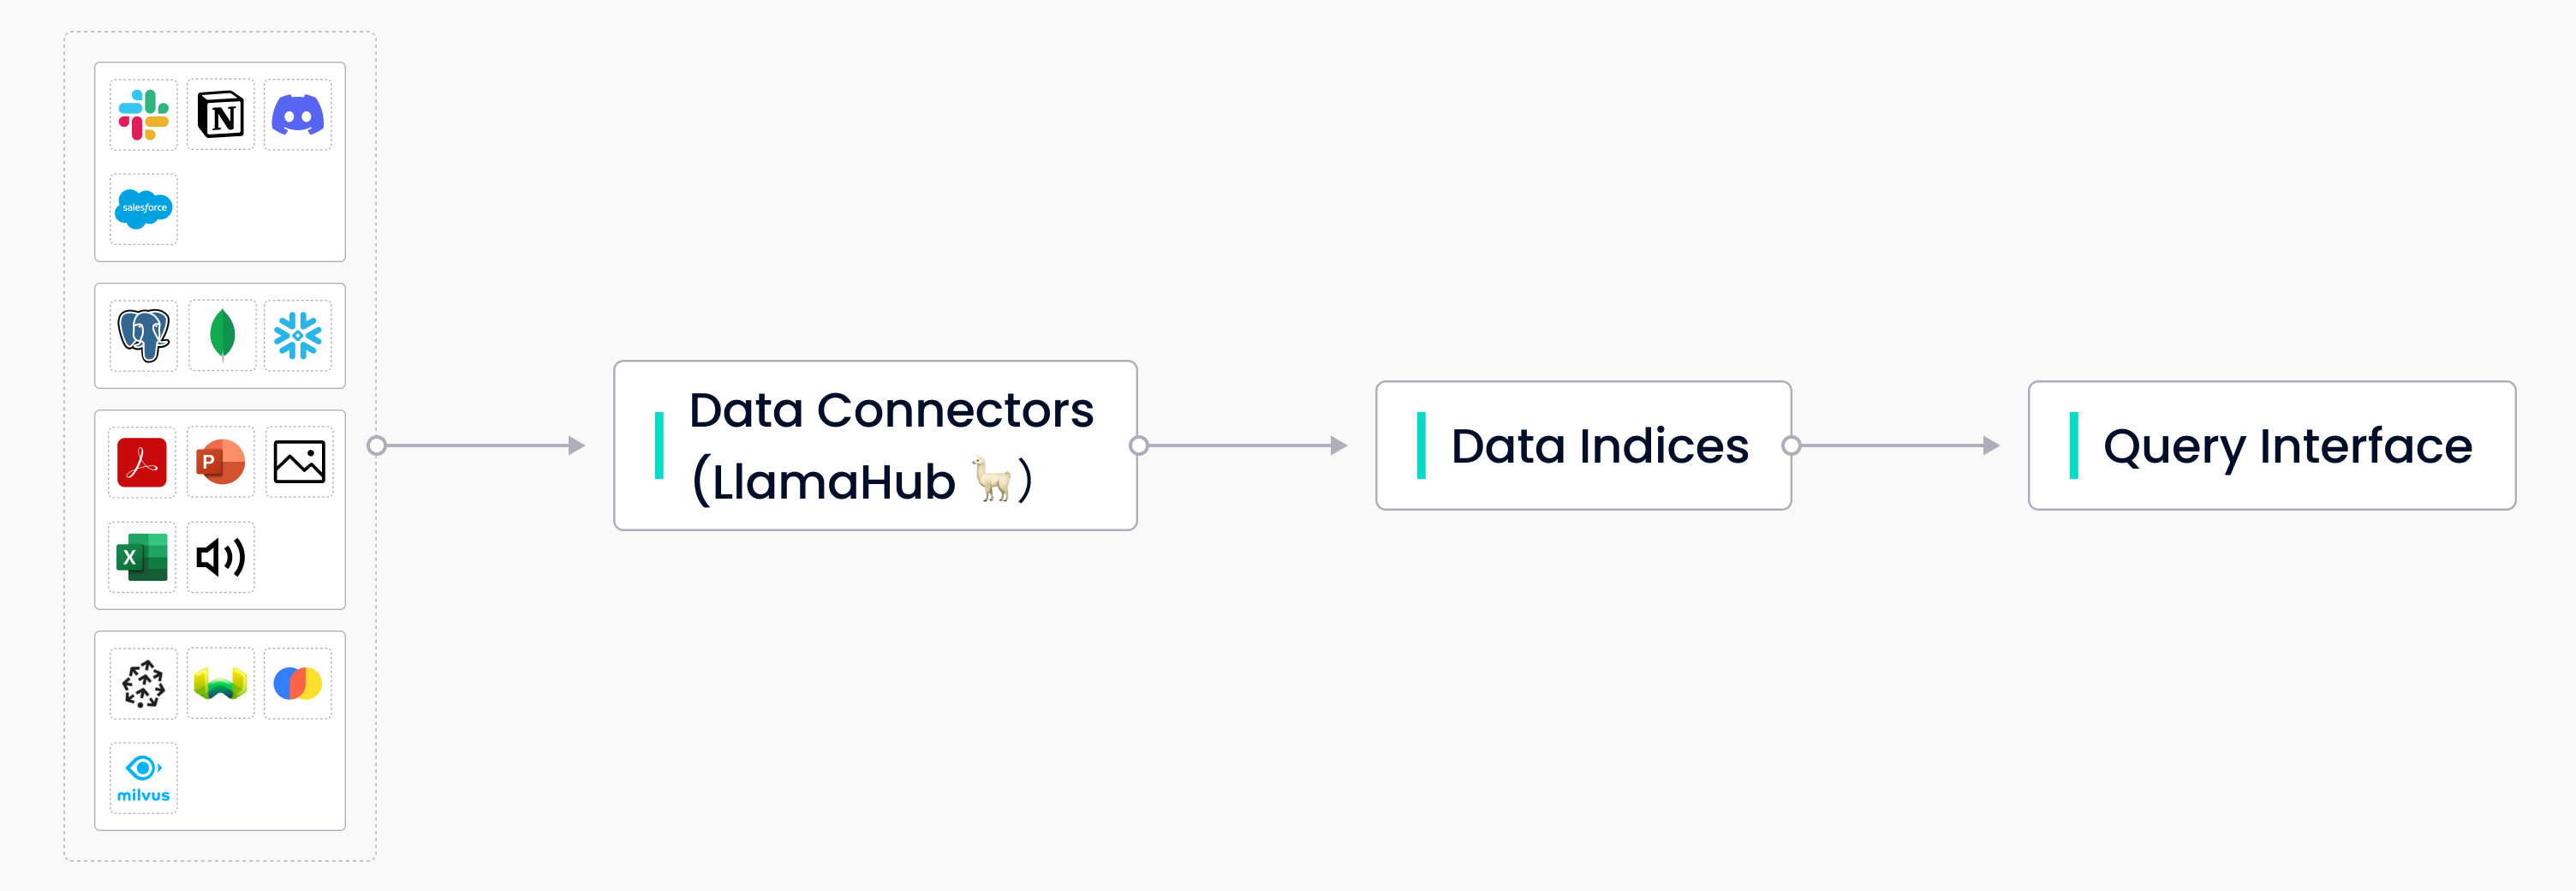 Три основных компонента LlamaIndex
LlamaIndex также является ценным инструментом для разработки LLM-приложений. Он работает как черный ящик, принимая подробные описания запросов и предоставляя насыщенные ответы, включающие ссылки и действия. LlamaIndex также управляет взаимодействиями между языковой моделью и частными данными, чтобы предоставлять точные и желаемые результаты.
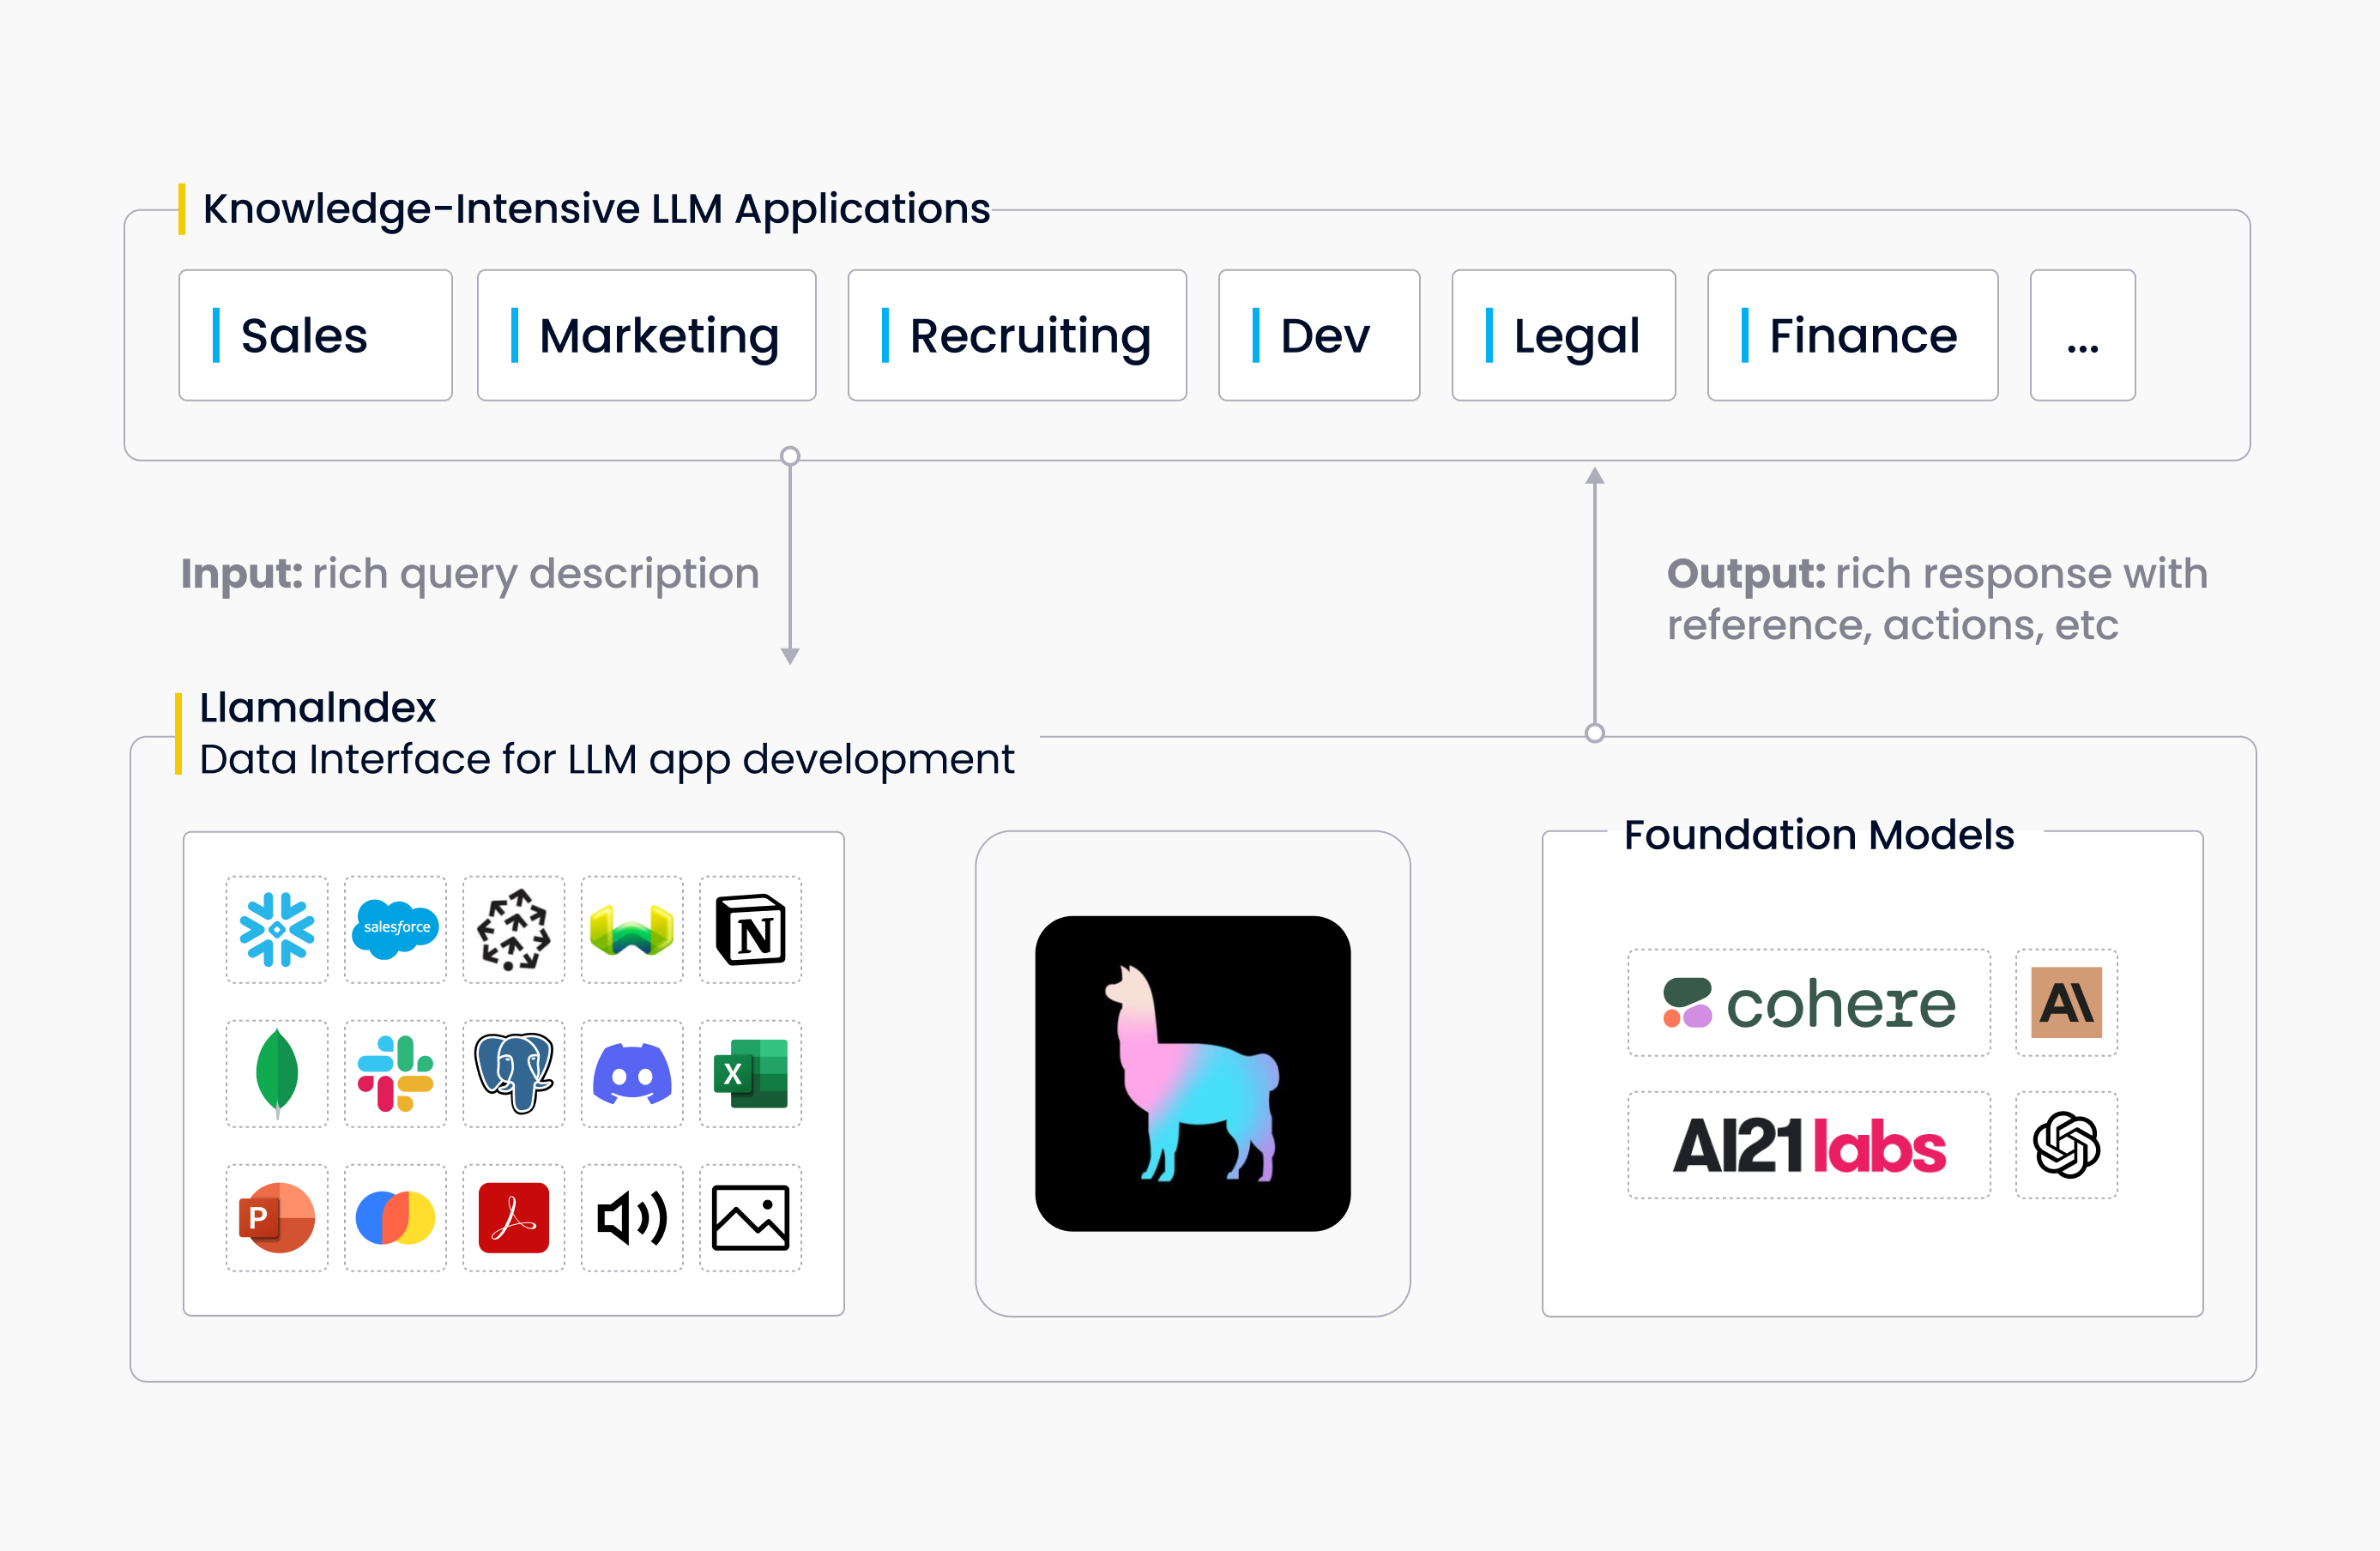 LlamaIndex в контексте
Как работает индекс векторного хранилища LlamaIndex
У LlamaIndex есть различные индексы, включая списочный индекс, индекс векторного хранилища, древовидный индекс и индекс ключевых слов. Jerry использовал индекс векторного хранилища на вебинаре, чтобы показать, как работают индексы LlamaIndex.
Индекс векторного хранилища — это популярный режим поиска и синтеза, который объединяет векторное хранилище с языковой моделью. Набор исходных документов загружается, разбивается на текстовые узлы и сохраняется в векторном хранилище с эмбеддингом, прикрепленным к каждому узлу. Когда вы выполняете запрос, эмбеддинг запроса ищет в векторном хранилище top-k наиболее похожих узлов, затем эти узлы используются в модуле синтеза ответа для генерации ответа.
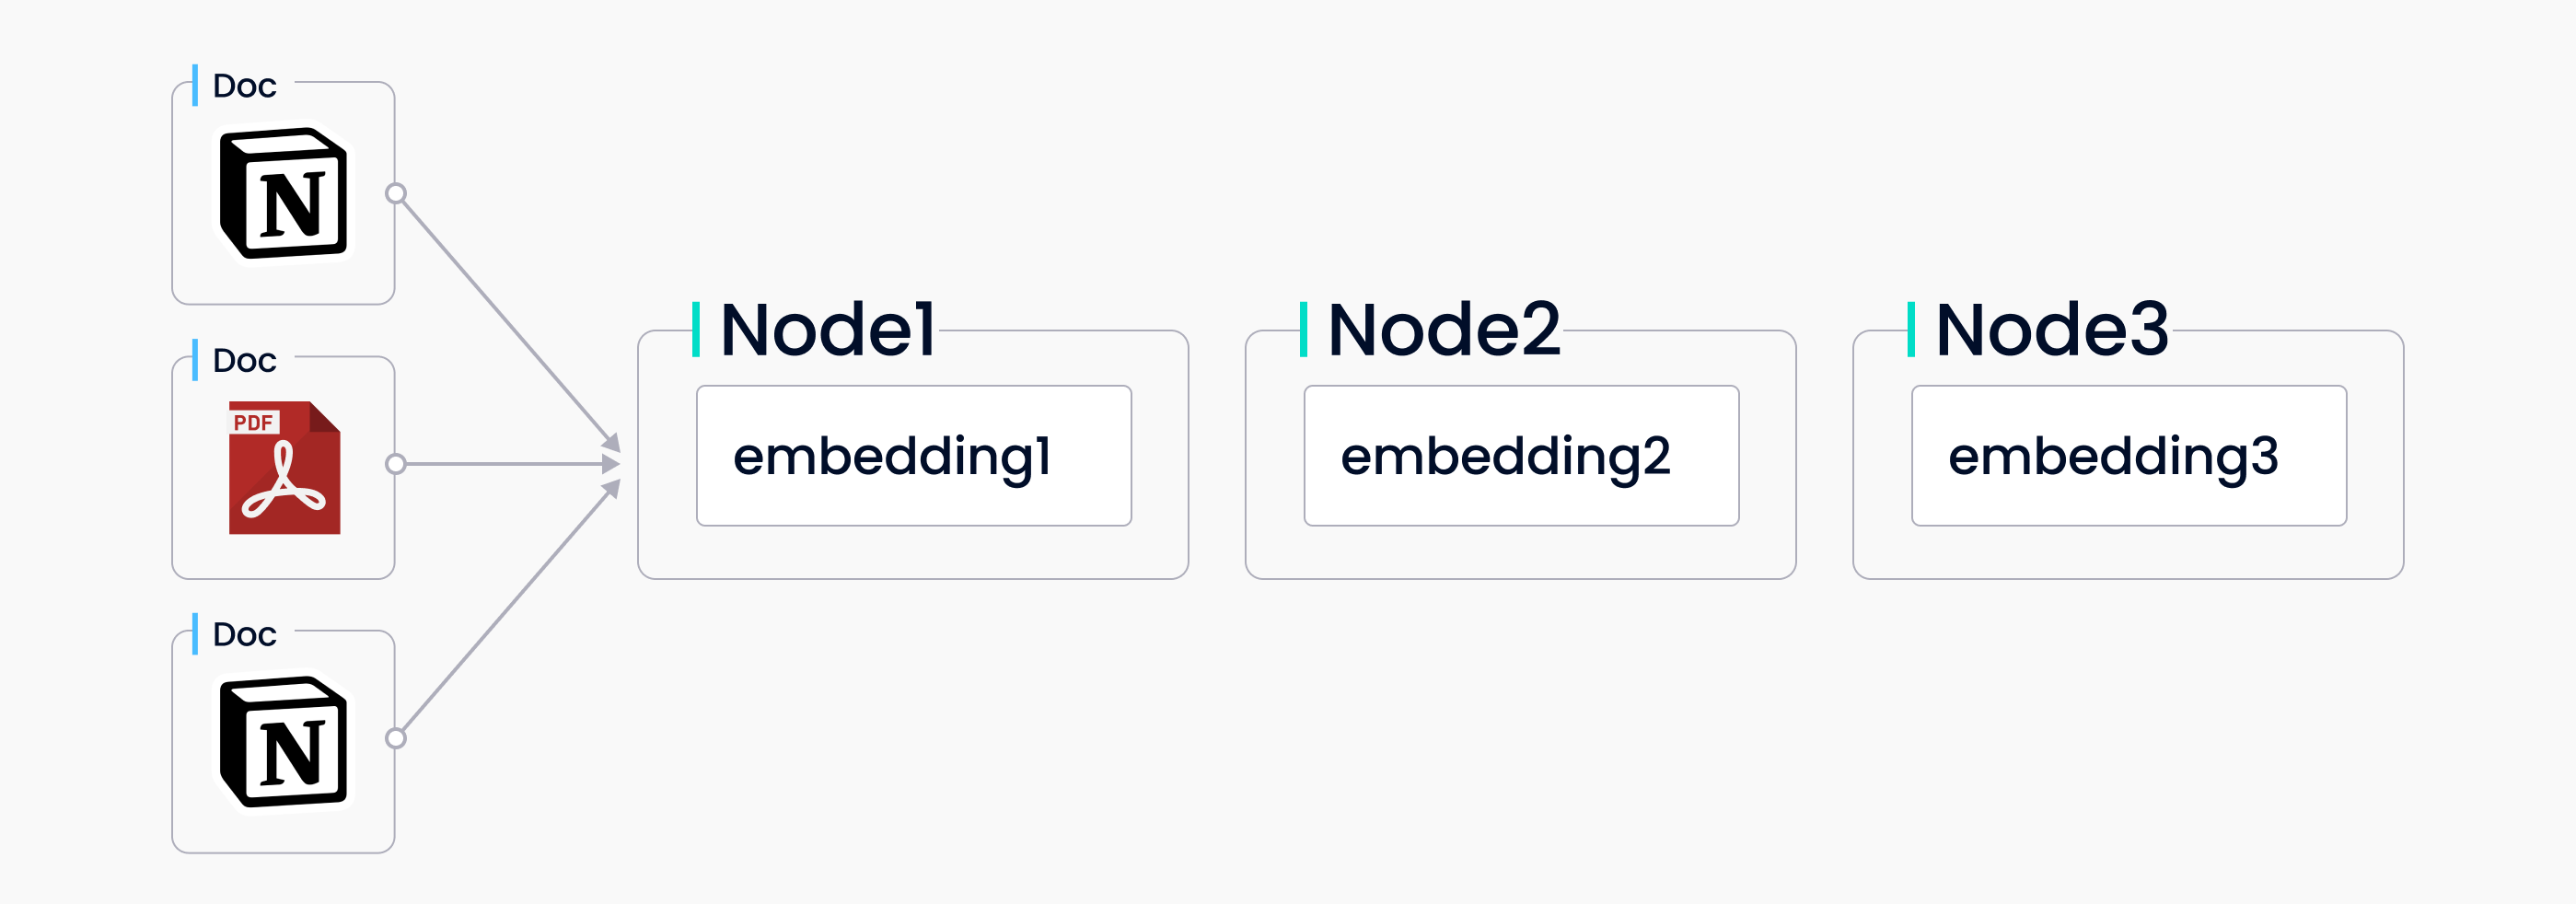 Загрузка данных в LlamaIndex
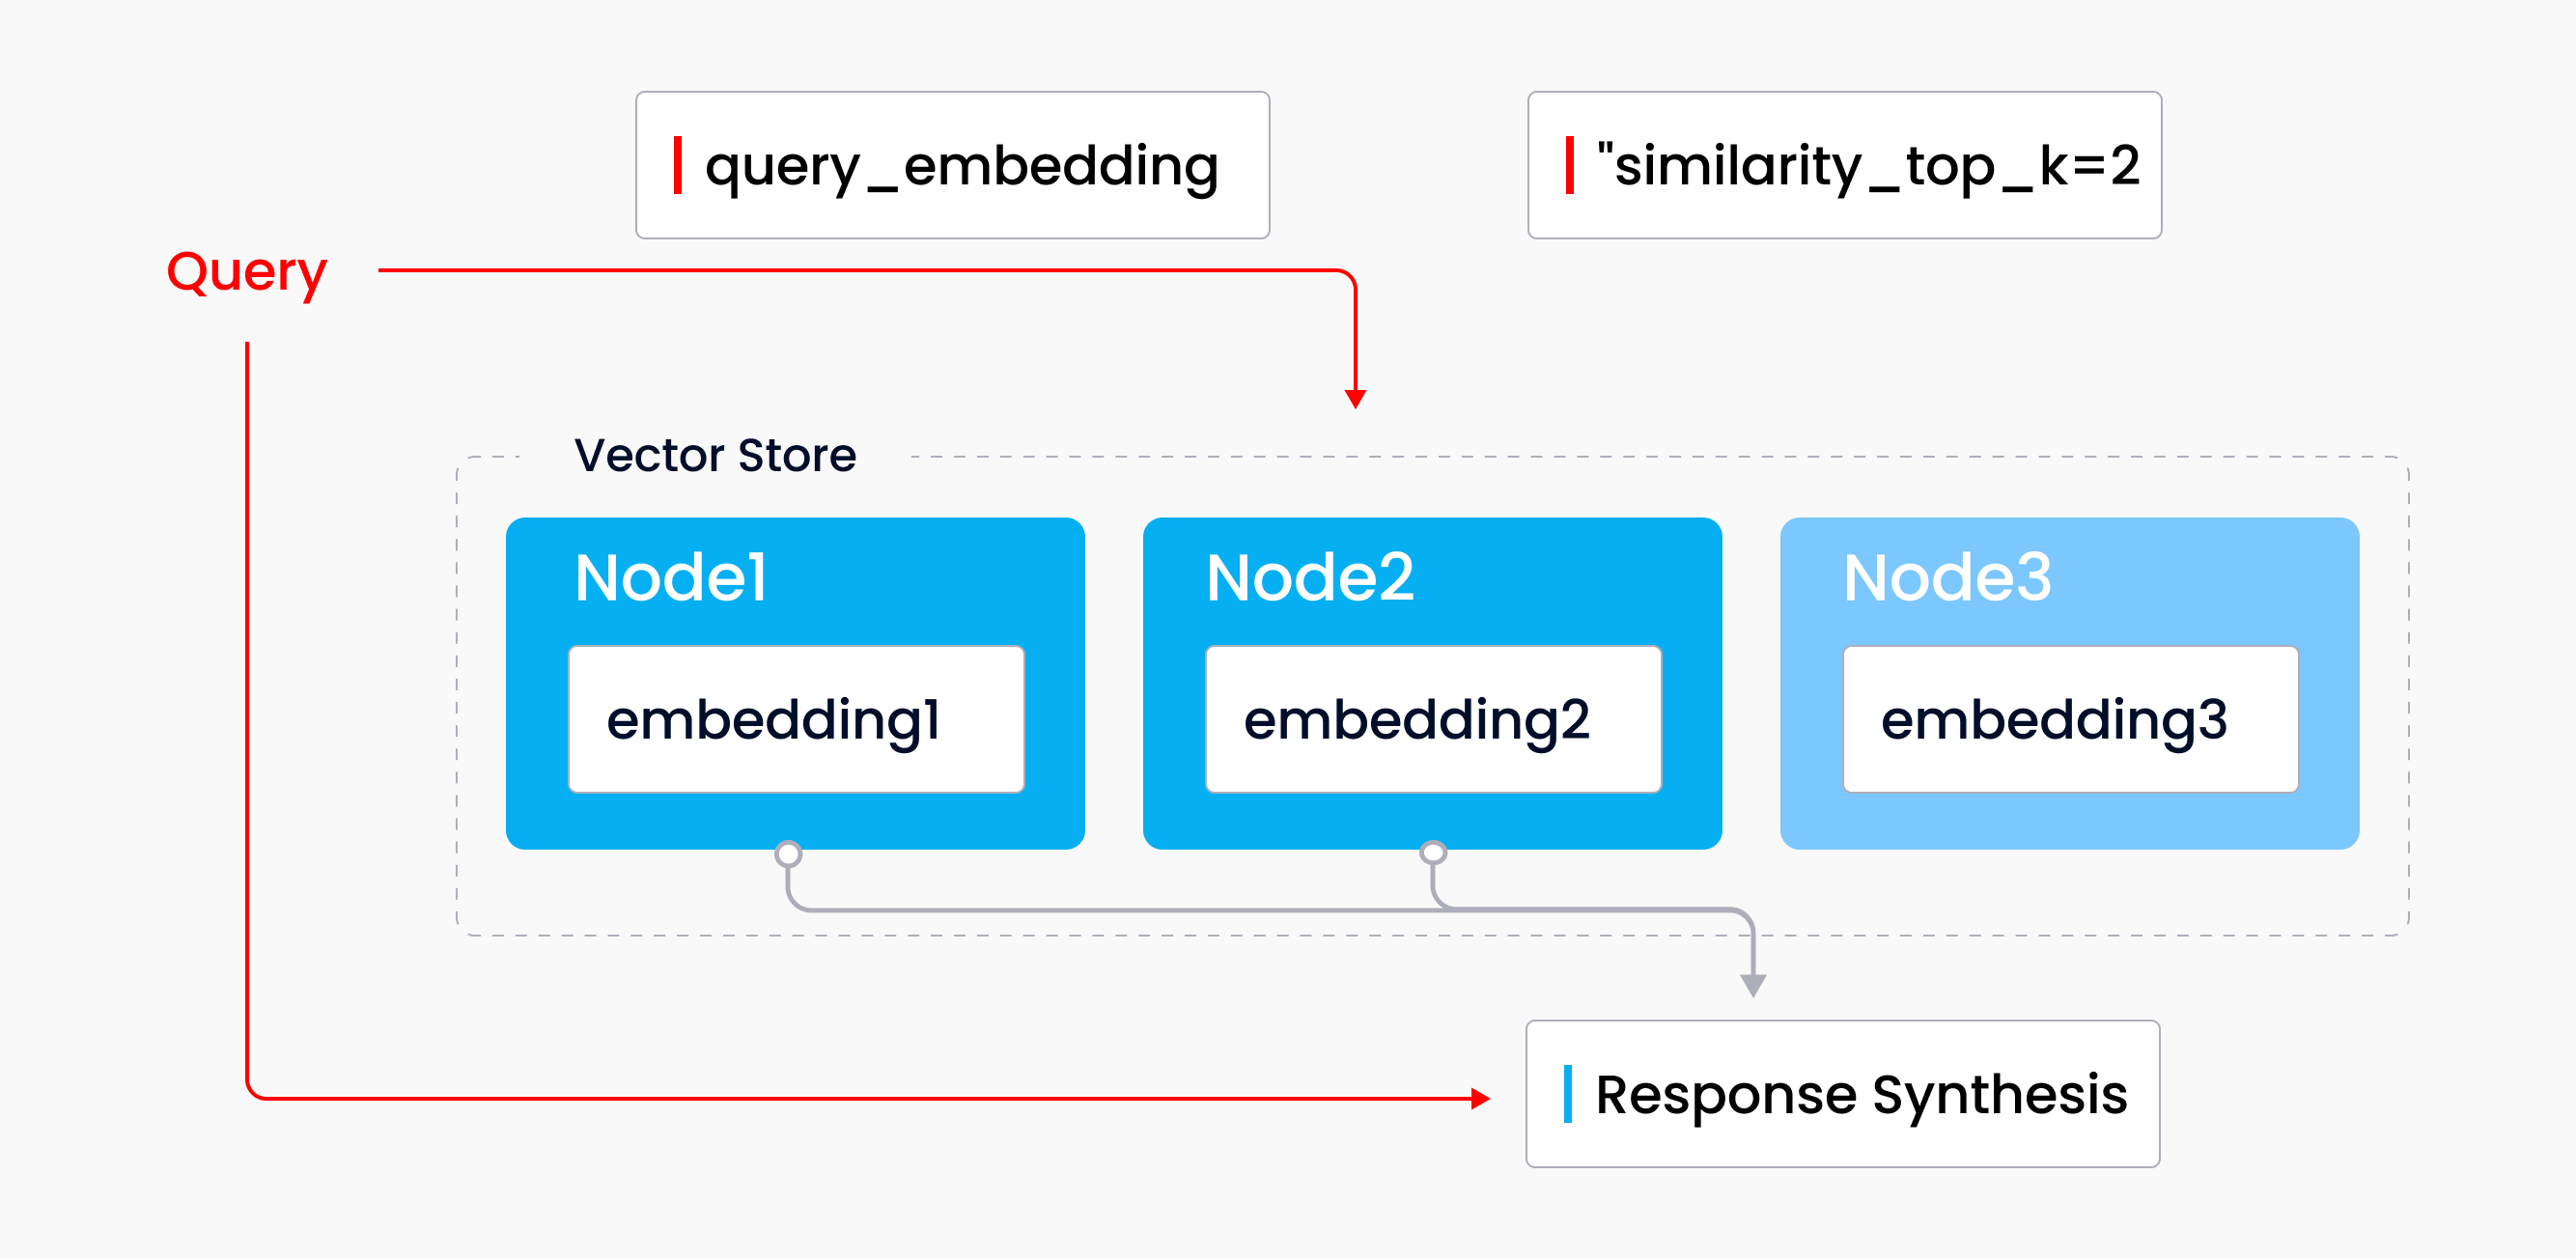 Выполнение запросов через индекс векторного хранилища
Использование индекса векторного хранилища — лучший подход для внедрения сходства в ваше LLM-приложение. Этот тип индекса идеально подходит для рабочих процессов, которые сравнивают тексты на предмет семантического сходства. Например, индекс векторного хранилища подойдет для задания вопросов о конкретном программном обеспечении с открытым исходным кодом.
Интеграция Milvus и LlamaIndex
LlamaIndex предоставляет многочисленные интеграции, которые одновременно мощные и легковесные. На вебинаре Jerry отметил интеграцию Milvus и LlamaIndex.
Milvus — это векторная база данных с открытым исходным кодом, способная обрабатывать огромные наборы данных, содержащие миллионы, миллиарды или даже триллионы векторов. Благодаря интеграции Milvus выступает в качестве серверного векторного хранилища для эмбеддингов и текста. Настроить интеграцию просто: ввести несколько параметров, обернуть их в некоторый контекст хранения, а затем поместить их в индекс векторного хранилища. Запрос к индексу выполняется через механизм запросов, и вы получите нужные ответы.
Zilliz Cloud — это полностью управляемый cloud-native сервис для Milvus, и интеграция LlamaIndex и Zilliz Cloud также доступна.
Варианты использования LlamaIndex
На вебинаре Jerry также поделился многими популярными вариантами использования LlamaIndex, включая:
- Семантический поиск
- Суммаризацию
- Text to SQL (структурированные данные)
- Синтез по гетерогенным данным
- Запросы на сравнение/противопоставление
- Многошаговые запросы
- Использование временных отношений
- Фильтрация по актуальности / устаревшие узлы
Для подробных описаний и информации посмотрите полную запись вебинара.
Вопросы и ответы
Во время вебинара мы получили много вопросов от нашей аудитории и оценили их вовлеченность. Jerry ответил на некоторые вопросы во время сессии вопросов и ответов, но из-за ограничений по времени часть осталась без ответа. Ниже мы составили список наиболее часто задаваемых вопросов и вопросов, оставшихся без ответа, вместе с ответами Jerry.
В: Что вы думаете о плагинах OpenAI, и как LlamaIndex будет работать с ними?
Это хороший вопрос. Мы видим себя по обе стороны ландшафта плагинов. С одной стороны, мы видим себя как действительно хороший плагин, который может вызываться любой внешней агентной абстракцией (будь то ChatGPT, LangChain или другие). Клиентский агент передавал бы нам входной запрос, а мы выясняли бы, как лучше всего выполнить этот запрос под капотом. Например, мы являемся плагином в репозитории chatgpt-retrieval-plugin. На стороне клиента мы поддерживаем интеграцию с любыми сервисами, которые реализуют chatgpt-retrieval-plugin — абстракцию «векторного хранилища».
В: Вы упомянули компромиссы в производительности и задержке. С какими узкими местами и проблемами в этой области вы сталкиваетесь?
Большие объемы контекста + больший размер фрагмента = более высокая задержка. Существуют споры о том, всегда ли большие размеры фрагментов приводят к лучшим результатам (эмпирически GPT-4 лучше справляется с более длительными объемами контекста, чем GPT-3). Тем не менее в целом здесь наблюдается положительная корреляция. Еще один компромисс заключается в том, что любая «продвинутая» LLM-система, например с участием агентов, требует цепочек вызовов LLM. Цепочки вызовов LLM по своей природе выполняются дольше.
В: Я понимаю, что мы используем внешнюю модель для выполнения запросов. Насколько защищены передаваемые приватные данные?
Это зависит от API-сервиса. Например, OpenAI не использует данные API для обучения/улучшения своих моделей, но у предприятий всё равно будут опасения по поводу отправки конфиденциальных данных третьей стороне. Недавно мы добавили несколько модулей PII, чтобы помочь смягчить эту проблему. Ещё одна альтернатива — использовать локальные модели.
В: Каковы плюсы и минусы двух подходов: (a) использование векторной базы данных, такой как Milvus, для расширенного поиска по сходству и графовых оптимизаций ДО загрузки в LlamaIndex, индексирования в нём и взаимодействия с LLM; (b) использование нативных интеграций LlamaIndex с векторными хранилищами?
Вы можете использовать любой из них. Мы планируем немного больше объединить эти два подхода, так что следите за обновлениями. На очень высоком уровне использование Milvus сначала в качестве загрузчика данных позволяет использовать существующие данные с LlamaIndex. Напротив, если вы используете наш векторный индекс на базе Milvus, мы определим дополнительные структуры поверх этих данных. Плюс первого подхода в том, что вы можете использовать существующие данные, а плюс второго — в том, что у нас больше контроля при определении метаданных.
В: Мне нужно локально проанализировать примерно 6 000 PDF-файлов и PowerPoint-презентаций. Что бы вы порекомендовали, чтобы получить наилучшие результаты без использования OpenAI, LlamaIndex, с llama65b?
Вы можете попробовать использовать Llama, если вас устраивает лицензия. Посмотрите модели с открытым исходным кодом на GitHub.
Посмотрите полную запись вебинара!
Посмотрите запись вебинара, чтобы узнать больше о LlamaIndex и обсуждениях между Jerry Liu и Frank Liu.

Читать далее
Our Journey to 35K+ GitHub Stars: The Real Story of Building Milvus from Scratch
Join us in celebrating Milvus, the vector database that hit 35.5K stars on GitHub. Discover our story and how we’re making AI solutions easier for developers.
Proactive Monitoring for Vector Database: Zilliz Cloud Integrates with Datadog
we're excited to announce Zilliz Cloud's integration with Datadog, enabling comprehensive monitoring and observability for your vectorDB deployments.
Vector Databases vs. Spatial Databases
Use a vector database for AI-powered similarity search; use a spatial database for geographic and geometric data analysis and querying.