Como migrar do Chroma para a Zilliz Cloud
Chroma Cloud deixa de aceitar gravações em 22 de novembro de 2026 e deixa de servir leituras em 22 de dezembro de 2026, de acordo com o cronograma de descontinuação da Chroma. Se a sua aplicação grava no Chroma Cloud, ela precisa de um novo lar antes da primeira data, e os seus dados precisam sair antes da segunda.
O Chroma de código aberto não é afetado. Mas se você o executa por conta própria e o está levando para produção, com mais dados do que uma máquina suporta confortavelmente, uma meta de disponibilidade e ninguém disposto a ficar de plantão por ele, a mudança é a mesma, sem o prazo.
Este guia move qualquer um deles para o Zilliz Cloud, o banco de dados vetorial totalmente gerenciado construído sobre o Milvus de código aberto. Seus embeddings são transferidos como estão, de modo que nada é reembedado, e seus IDs, documentos, URIs e metadados vêm junto. Se preferir executar o Milvus de código aberto você mesmo, os mesmos passos se aplicam; consulte Movendo Chroma para o Milvus de código aberto na Etapa 1.
A migração inclui quatro etapas: mover seus dados, verificá-los, atualizar sua aplicação e fazer a transição.
Antes de começar
Você precisa de:
- Um cluster do Zilliz Cloud, com seu endpoint público e uma chave de API. Cadastre-se se você não tiver um. O plano gratuito comporta até 5 coleções; para mais, use um cluster Serverless ou Dedicated.
- Os detalhes de conexão do seu Chroma. No Chroma Cloud, o painel Connect no dashboard mostra sua chave de API, o ID do locatário e o nome do banco de dados. Para Chroma auto-hospedado, você precisa do endereço do servidor, além de um token ou de um nome de usuário e senha se você ativou a autenticação.
- Python 3.10 ou posterior com ambos os clientes, para verificar a cópia e atualizar sua aplicação:
pip install chromadb==1.5.9 pymilvus==3.0.2
- Docker, se você usar o Vector Transport Service de código aberto (Opção B na Etapa 1).
Como seus dados são mapeados
Cada coleção do Chroma se torna uma coleção do Zilliz Cloud com quatro campos. Os metadados vão para o campo dinâmico da coleção, de modo que cada chave de metadados continua filtrável, exatamente como era no Chroma. A página de documentação do Zilliz Cloud Migrar do Chroma para o Zilliz Cloud tem o mapeamento completo, incluindo como os tipos de metadados são convertidos em campos tipados.
| Chroma | Zilliz Cloud |
|---|---|
| Coleção | Coleção com o mesmo nome, com - convertido para _: support-docs vira support_docs. Os nomes do Zilliz Cloud aceitam apenas letras, dígitos e sublinhados e não podem começar com um dígito, então um nome como kb.v2 ou 2024-notes precisa de um novo nome ao configurar a cópia. O mesmo vale para um de quaisquer dois nomes que resultem no mesmo nome, como support-docs e support_docs |
id | id, a chave primária VARCHAR. Os IDs não mudam |
embedding | embedding, um campo FLOAT_VECTOR com a mesma dimensão |
document | document, um campo VARCHAR anulável de até 65.535 bytes |
uri | uri, um campo VARCHAR anulável. A string URI é copiada; o arquivo para o qual ela aponta não é |
| Metadados | Chaves no campo dinâmico. Você também pode transformar chaves escolhidas em campos tipados ao configurar a cópia |
Espaço de distância: cosine, l2 ou ip | Métrica do índice: COSINE, L2 ou IP. A métrica não é copiada; você a define quando o índice é construído |
| Função de embedding | Não é armazenada no banco de dados. Sua aplicação gera embeddings das consultas (Etapa 3) |
Uma coleção por usuário? Cada coleção do Chroma se torna uma coleção própria no Zilliz Cloud, e um cluster comporta um número limitado delas: 5 no Free, 100 no Serverless e, em clusters Dedicated, 1.024 por unidade de computação, até 16.384. Se você tiver mais coleções por usuário do que isso, ou esperar ter, fale conosco antes de migrar: o melhor design é uma coleção com chave de partição, que suporta milhões de locatários.
Etapa 1: Mova seus dados
Você pode copiar os dados de duas maneiras. Qual delas se encaixa depende de onde o seu Chroma é executado:
| Seu Chroma | Uso |
|---|---|
| Chroma Cloud | Opção A: Serviço de Migração Integrado |
| Seu próprio servidor Chroma, acessível pela internet | Opção A: Serviço de Migração Integrado |
| Seu próprio Chroma em uma rede privada ou no seu laptop, ou incorporado no seu aplicativo | Opção B: Vector Transport Service (código aberto) |
A diferença é quem se conecta a quem. O Serviço de Migração é executado na Zilliz Cloud e lê dados do seu Chroma, por isso precisa de um endereço que consiga alcançar. O Vector Transport Service é executado em uma máquina que você escolhe e grava na Zilliz Cloud, então funciona de qualquer lugar que consiga alcançar ambos.
Primeiro, anote a contagem de registros e o espaço de distância de cada coleção. Você precisa do espaço de distância para definir a métrica do índice, seja qual for a opção usada, e da contagem para verificar a cópia:
import chromadb

client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud: chromadb.CloudClient(api_key=..., tenant=..., database=...)

for collection in client.list_collections():
    config = collection.configuration_json
    space = (config.get("hnsw") or config.get("spann") or {}).get("space") or "l2"
    print(f"{collection.name}: {collection.count()} records, space {space}")
O Chroma usa l2 para coleções criadas sem um espaço de distância. Deixe as coleções vazias de fora da cópia: o Chroma não registra uma dimensão até que o primeiro embedding chegue, portanto, não há nada com que criar o destino.
Opção A: Serviço de Migração da Zilliz Cloud
O Migration Service é integrado ao console da Zilliz Cloud e é gratuito para usar. Você precisa da função de Proprietário da Organização ou Administrador do Projeto. Um servidor Chroma auto-hospedado deve servir a API REST v2 do Chroma e ser acessível a partir da Zilliz Cloud. Se ele estiver atrás de um firewall, adicione os endereços IP da Zilliz Cloud à sua lista de permissões.
- Conectar. No console, abra Migrações e escolha Chroma como origem. Digite o endpoint, tenant, banco de dados e credenciais do Chroma. Para o Chroma Cloud, copie-os do painel Conectar: o endpoint é
https://api.trychroma.com, ou o endpoint da sua região se o seu banco de dados estiver fora da AWS us-east-1, e a credencial é a sua chave de API. O Chroma auto-hospedado pode usar sem autenticação, um token, ou um nome de usuário e senha, e seu tenant e banco de dados padrão sãodefault_tenantedefault_database. Em seguida, escolha o cluster e o banco de dados de destino.
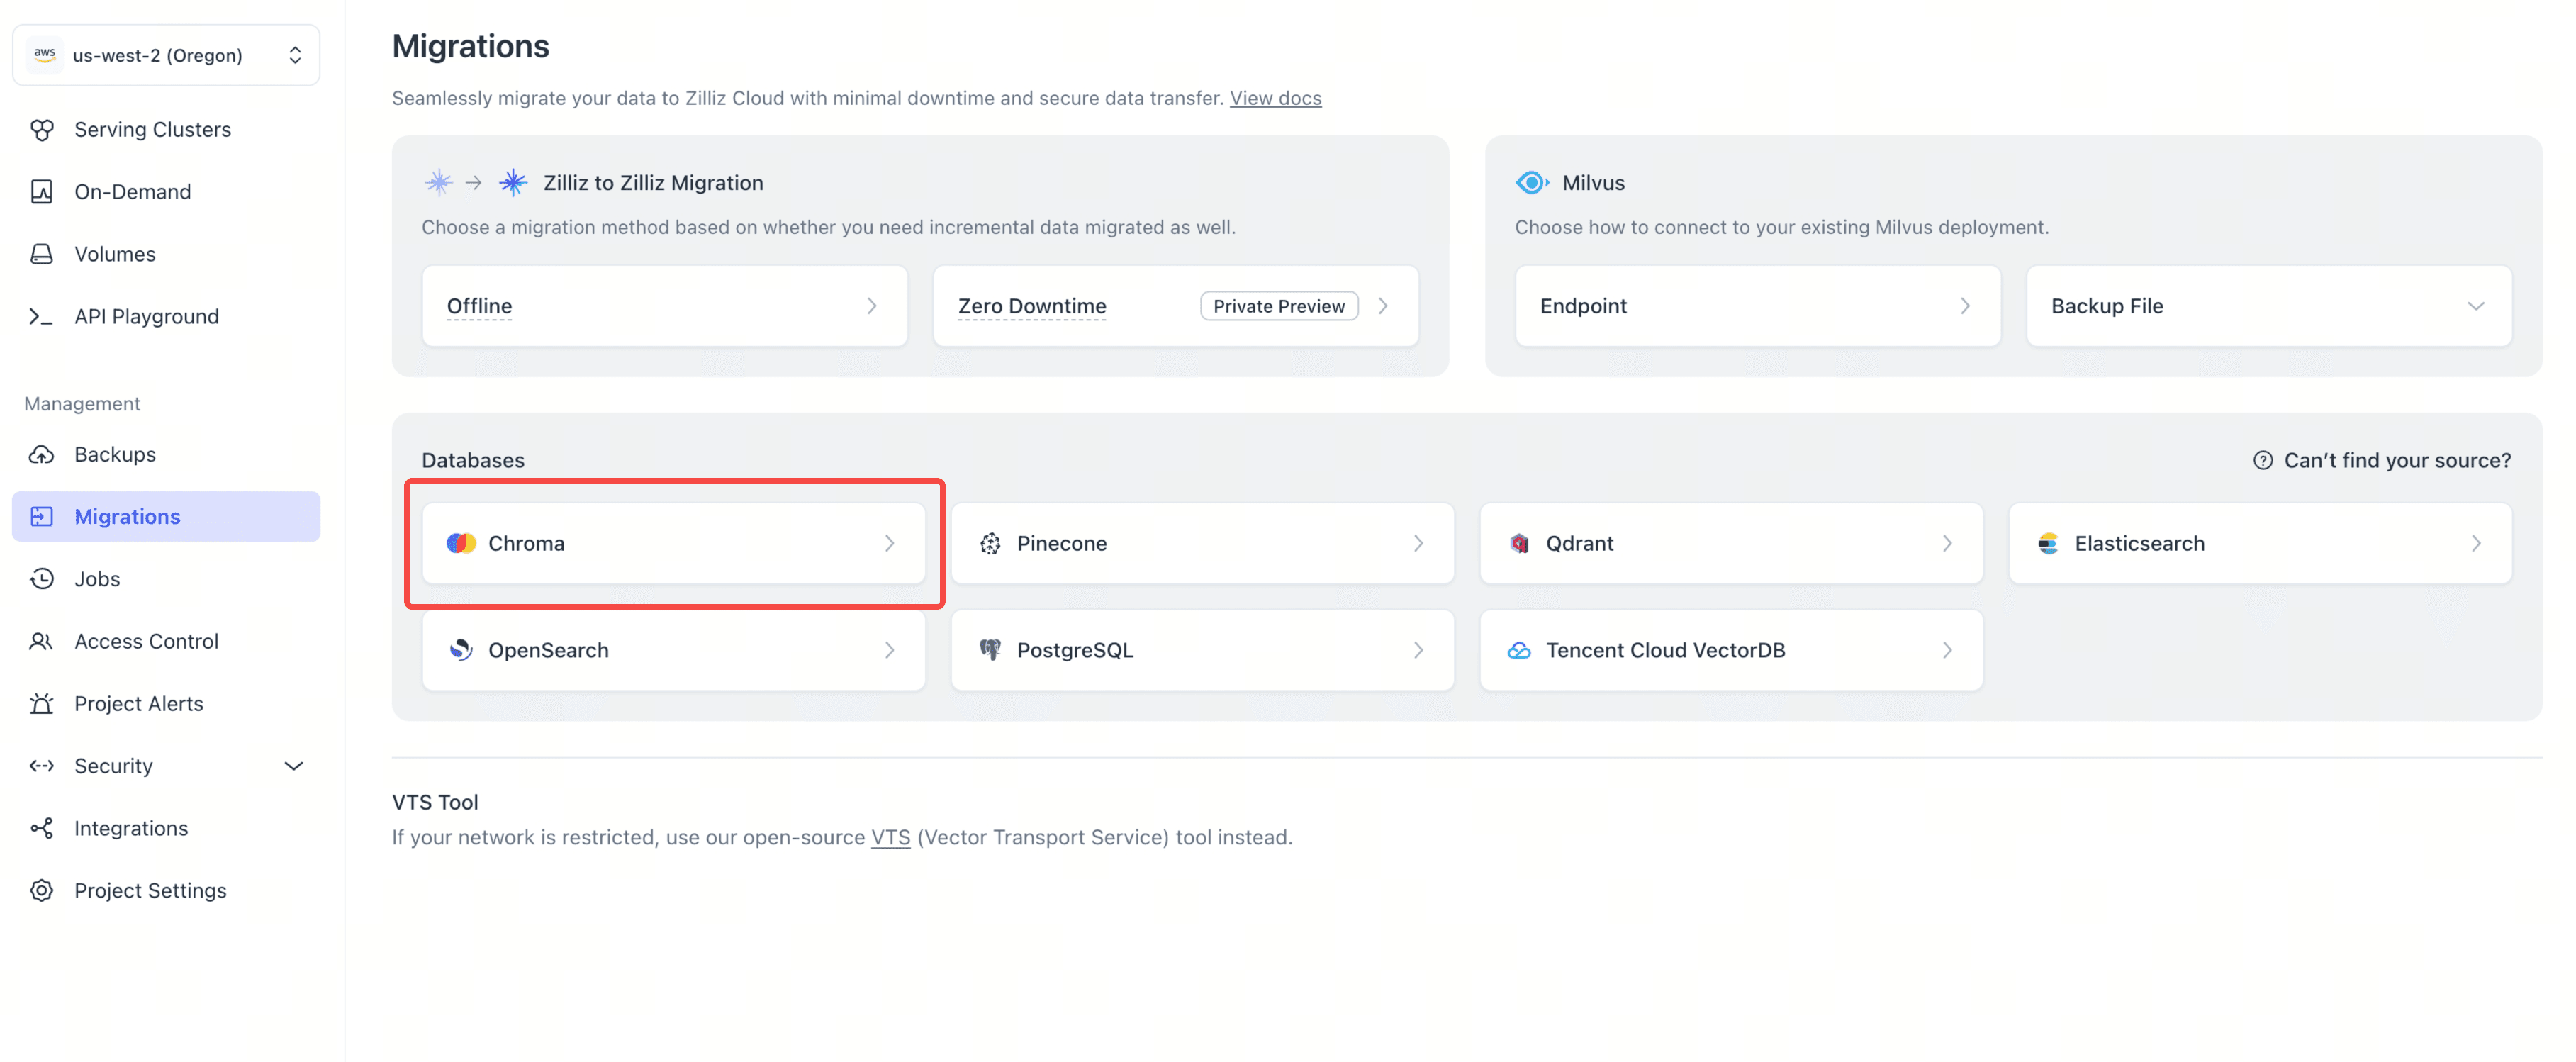
- Selecionar e revisar. Selecione as coleções a serem movidas. Verifique cada nome de destino e renomeie qualquer um que a Zilliz Cloud não possa usar ou que já esteja em uso. Revise o mapeamento de campos: os metadados vão para o campo dinâmico por padrão, e você pode transformar chaves escolhidas em campos tipados aqui.
- Definir o índice. Deixe Criar índices após a migração ativado, para que as coleções sejam pesquisáveis assim que a tarefa for concluída. Defina a métrica de cada coleção para corresponder ao seu espaço de distância do Chroma:
cosineparaCOSINE,l2paraL2eipparaIP. A métrica não é copiada do Chroma. Consulte configurações de índice. - Executar. Inicie a tarefa e acompanhe-a na página Tarefas. Quando ela terminar, a tarefa reporta a contagem de linhas que verificou.
Cada campo e opção é descrito em Migrar do Chroma para a Zilliz Cloud na documentação da Zilliz Cloud. Em seguida, vá para a Etapa 2.
Opção B: Vector Transport Service
O Vector Transport Service (VTS) é a ferramenta de migração de código aberto da Zilliz, e o mecanismo no qual o Migration Service é executado. Você mesmo o executa em Docker, a partir de um arquivo de configuração. Ele lê o Chroma por meio da API REST v2, que qualquer servidor Chroma da versão 0.6 ou posterior disponibiliza.
Se o seu Chroma estiver embutido na sua aplicação, com os dados em um diretório local por meio de chromadb.PersistentClient, ainda não há um servidor para o VTS ler. Inicie um servidor nesse diretório:
chroma run --path ./chroma_data --port 8000
Em seguida, escreva a configuração do job. Salve-a como migration.conf e substitua cada espaço reservado $ por um valor real; eles não são variáveis de ambiente e não são expandidos para você.
hocon
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  ChromaDB {
    url = "$CHROMA_URL"                  # e.g. http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # e.g. ["support-docs"]

    # If your Chroma requires auth, see the table below
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"

    id_split_size = 300
    batch_size = 300
  }
}

sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"                 # must already exist
    batch_size = 50
    enable_dynamic_field = true          # required, this is where metadata goes
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
A configuração contém credenciais, então restrinja-a com chmod 600 migration.conf.
| Parâmetro | O que colocar ali |
|---|---|
url (origem) | A raiz do servidor Chroma, sem /api/v2, que o VTS acrescenta. O VTS roda em um contêiner, onde localhost significa o próprio contêiner. Se o Chroma rodar na mesma máquina, use http://host.docker.internal:8000 no macOS e no Windows; no Linux, adicione --network host ao docker run e mantenha localhost. Para o Chroma Cloud, use https://api.trychroma.com ou o endpoint da sua região |
tenant e database | default_tenant e default_database, a menos que você tenha criado outros. No Chroma Cloud, seu ID de tenant e nome do banco de dados |
auth_type e token | Deixe ambos de fora se o servidor rodar sem autenticação. Caso contrário, use X_CHROMA_TOKEN ou BEARER com um token, ou BASIC com username e password. O Chroma Cloud usa X_CHROMA_TOKEN com sua chave de API |
id_split_size e batch_size | 300 para ambos funciona em qualquer lugar e, no Chroma Cloud, ambos devem ficar em 300 ou menos. Para uma coleção auto-hospedada grande, 10000000 e 1000 fazem a varredura de IDs em massa e depois buscam registros por ID, o que evita a paginação profunda lenta |
collection_rename (sink) | Opcional, { "source" = "target" }. Obrigatório para qualquer nome de origem que não seja um nome válido do Zilliz Cloud depois que - vira _ |
Para transformar as chaves de metadados escolhidas em campos tipados, adicione um bloco field_schema ao sink. O guia de sink do Milvus aborda field_schema e collection_rename, e o guia de origem do ChromaDB aborda tamanhos de lote, autenticação e as outras opções de origem.
Execute o job:
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
O job é bem-sucedido quando o log termina com end with state FINISHED, Total Read Count é igual a Total Write Count e Total Failed Count é 0.
O job acrescenta dados, então não execute novamente na mesma coleção. Uma segunda execução grava todos os registros novamente. Se um job falhar parcialmente, ou você precisar de uma cópia nova, exclua primeiro a coleção de destino ou envie o job para uma nova com collection_rename.
Construa o índice. Use o espaço de distância que você anotou para essa coleção:
from pymilvus import MilvusClient
client = MilvusClient( uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY", )
index_params = client.prepare_index_params() index_params.add_index( field_name="embedding", index_type="AUTOINDEX", metric_type="COSINE", # cosine -> COSINE, l2 -> L2, ip -> IP ) client.create_index(collection_name="support_docs", index_params=index_params) client.load_collection("support_docs")
### Migrando Chroma para Milvus de código aberto

Tudo neste guia funciona com o Milvus de código aberto 2.5 ou posterior. Use a Opção B, que grava em qualquer Milvus que consiga alcançar: defina o `url` do sink como o endereço do seu Milvus, como `http://host.docker.internal:19530` quando o Milvus roda na mesma máquina, e `token` para `username:password`, ou remova a linha `token` se a autenticação estiver desativada. Os passos 2 a 4 são os mesmos, e no seu aplicativo apenas `uri` e `token` mudam. Como o Milvus e o Zilliz Cloud compartilham a mesma API, você pode migrar entre eles mais tarde sem tocar no seu código.

## Passo 2: Verifique seus dados

Primeiro, compare as contagens de registros. O Migration Service informa a contagem de linhas que verificou; para o VTS, é `Total Write Count` no log. Qualquer uma deve corresponder à contagem no Chroma.

As contagens informam que todos os registros chegaram. Elas não informam se o índice responde às consultas da mesma forma que o Chroma fazia: um índice criado com a métrica errada passa na verificação de contagem e ainda assim retorna os vizinhos errados. Então execute algumas buscas em ambos os lados e compare:

```python
import chromadb
from pymilvus import MilvusClient

chroma = chromadb.CloudClient(api_key="YOUR_CHROMA_API_KEY", tenant="YOUR_TENANT_ID", database="YOUR_DATABASE_NAME")
# Self-hosted Chroma: chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY")

source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(query_embeddings=[vector], n_results=10, include=[])["ids"][0]
    hits = milvus.search("support_docs", data=[vector.tolist()], limit=10)[0]
    overlaps.append(len(set(expected) & {hit["id"] for hit in hits}) / len(expected))
print(f"top-10 overlap: {sum(overlaps) / len(overlaps):.0%}")
Isso usa 20 registros como consultas e conta quantos dos 10 principais resultados correspondem. Ambos os sistemas usam índices aproximados, portanto um valor um pouco abaixo de 100% é normal. Um valor muito mais baixo quase sempre significa que a métrica do índice não corresponde ao espaço de distância da coleção.
Nenhuma das verificações examina o conteúdo dos registros. Antes de a cópia final entrar em produção, compare também esses dados: verifique se cada ID chegou, depois compare vetores, documentos, URIs e metadados. Em uma coleção pequena, compare cada registro; em uma grande, uma amostra aleatória.
Se o seu aplicativo continuou gravando no Chroma durante a cópia, as contagens podem diferir. Isso é aceitável para uma primeira passagem; para a cópia final, quando você fizer a troca, elas devem corresponder.
Passo 3: Atualize seu aplicativo
A maioria das chamadas é traduzida um para um. Duas coisas precisam de atenção: seu aplicativo agora cria os embeddings de consulta por conta própria, e os scores das coleções cosine e ip funcionam na direção contrária.
Conecte-se ao Zilliz Cloud:
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
Para o Milvus de código aberto, defina uri para o endereço do seu Milvus e token para username:password, ou omita token se a autenticação estiver desativada. Tudo abaixo é o mesmo.
Gere os embeddings das consultas com o mesmo modelo de antes. Quando você passava query_texts para o Chroma, o Chroma executava a função de embedding da coleção para você. As coleções migradas não carregam essa função, então chame o mesmo modelo no seu código. Se você deixou o Chroma gerar os embeddings do seu texto e nunca definiu uma função de embedding, ele usou o modelo padrão, all-MiniLM-L6-v2. O pacote chromadb ainda pode executá-lo localmente:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction() query_vector = embed(["How do I get a refund?"])[0].tolist()
Se você usou OpenAI ou outro provedor, chame o mesmo modelo com as mesmas configurações.

**Busca com filtros.** Antes, no Chroma:

```python
results = collection.query(
    query_embeddings=[query_vector],
    n_results=5,
    where={"category": "billing"},
    where_document={"$contains": "refund"},
)
Depois, no Zilliz Cloud:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
Cada resultado é um dicionário com id, distance e os campos que você pediu em entity. Os filtros where e where_document do Chroma se tornam uma expressão de filtro:
| Chroma | Zilliz Cloud |
|---|---|
{"category": "billing"} | category == "billing" |
{"category": {"$ne": "billing"}} | category != "billing" |
{"year": {"$gte": 2023}} (também $gt, $lt, $lte) | year >= 2023 (também >, <, <=) |
{"category": {"$in": ["billing", "account"]}} | category in ["billing", "account"] |
{"category": {"$nin": ["billing", "account"]}} | category not in ["billing", "account"] |
{"$and": [...]} e {"$or": [...]} | ... and ... e ... or ... |
{"is_public": True} | is_public == true |
{"tags": {"$contains": "faq"}} (metadados de array) | array_contains(tags, "faq") |
where_document={"$contains": "refund"} | document like "%refund%" |
where_document={"$not_contains": "refund"} | not (document like "%refund%") |
Leia as pontuações ao contrário. O Chroma retorna distâncias, em que valores menores significam mais semelhantes. Para COSINE e IP, o Zilliz Cloud retorna pontuações de similaridade, em que valores maiores significam mais semelhantes. A ordenação não muda, mas qualquer limite no seu código muda. Em nosso teste, o principal resultado da busca acima tinha uma distância de 0.0545 no Chroma e uma pontuação de 0.9455 no Zilliz Cloud.
| Espaço Chroma | O Chroma retorna | O Zilliz Cloud retorna | Um limite como distance < 0.3 se torna |
|---|---|---|---|
cosine | 1 − similaridade de cosseno | Similaridade de cosseno | score > 0.7 |
ip | 1 − produto interno | Produto interno | score > 0.7 |
l2 | Distância L2 ao quadrado | Distância L2 ao quadrado | Sem alteração |
Gravar e excluir registros. As chaves de metadados ficam ao lado dos outros campos em cada linha, portanto, não há um argumento metadatas separado. add e upsert são mapeados para upsert (ou insert para novos IDs), e delete funciona por ID ou por filtro:
client.upsert(
    collection_name="support_docs",
    data=[{"id": "doc-1001", "embedding": vector, "document": "How to change your billing address", "category": "billing"}],
)
client.delete(collection_name="support_docs", ids=["doc-1001"])
client.delete(collection_name="support_docs", filter='category == "archived"')
Aqui, vector é um embedding do mesmo modelo usado no restante da coleção. Você pode omitir uri; ele é anulável.
Usando LangChain? Troque a classe do armazenamento de vetores e aponte-a para os nomes de campos migrados. Antes:
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, filter={"category": "billing"})
Depois, com pip install langchain-milvus:
from langchain_milvus import Milvus
vector_store = Milvus( embedding_function=embeddings, collection_name="support_docs", connection_args={"uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT", "token": "YOUR_ZILLIZ_CLOUD_API_KEY"}, primary_field="id", text_field="document", vector_field="embedding", enable_dynamic_field=True, ) docs = vector_store.similarity_search("How do I get a refund?", k=5, expr='category == "billing"')
`embeddings` é o mesmo objeto de embeddings do LangChain que você usou com o Chroma, e os filtros mudam de `filter={...}` para `expr="..."`. Usuários do LlamaIndex podem migrar para o [Milvus vector store](https://developers.llamaindex.ai/python/examples/vector_stores/milvusindexdemo/) da mesma forma.

## Passo 4: Transição

1.  Copie seus dados, verifique-os e aponte um build de staging do seu aplicativo para o Zilliz Cloud.
2.  Pause as gravações no Chroma. Depois de 22 de novembro, o Chroma Cloud as bloqueia de qualquer forma.
3.  Copie novamente, para obter todas as gravações até a pausa, e verifique se as contagens agora correspondem exatamente. Exclua a primeira cópia antes de começar ou envie esta para outro banco de dados.
4.  Implante seu aplicativo no Zilliz Cloud.
5.  No Chroma Cloud, remova ou rotacione suas credenciais antes de 22 de dezembro, conforme pede o aviso de encerramento do Chroma.

**Lendo isto depois de 22 de novembro? Seus dados do Chroma Cloud já estão somente leitura, então pule o passo 2 e copie uma vez. Você ainda pode copiá-los até 22 de dezembro.**

No Chroma auto-hospedado, não há prazo, mas mantenha a ordem: copie, pause as gravações, copie novamente, mude. Mantenha seu servidor Chroma por um tempo depois disso. Até que seu aplicativo grave algo novo no Zilliz Cloud, fazer rollback é uma mudança de configuração.

## Próximos passos

-   **Migrando uma carga de trabalho grande ou de produção?** Fale com [nossa equipe de suporte](https://zilliz.com/contact-sales) sobre o planejamento da transição.
-   **Comparando as opções primeiro?** [Chroma vs. Zilliz Cloud](https://zilliz.com/comparison/chroma-vs-zilliz-cloud) aborda recursos, escala e o que é mapeado do Chroma Cloud.
-   **Usou busca híbrida no Chroma Cloud?** A [busca híbrida](https://docs.zilliz.com/docs/hybrid-search) do Zilliz Cloud combina vetores densos com BM25 ou outros vetores esparsos em uma única solicitação.
- **Migrando outros bancos de dados também?** O mesmo [Serviço de Migração](https://docs.zilliz.com/docs/external-migration-basics) lida com Pinecone, Qdrant, Elasticsearch, OpenSearch e PostgreSQL. Fendy Feng
 is the Product Marketing Manager at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Sebastian Huang
Staff Software Engineer at Zilliz
 Shawn He
Senior Software Engineer at Zilliz
Continue lendo
Introducing Functions and Model Inference on Zilliz Cloud: Automatic Embedding and Reranking with Hosted Models
Zilliz Cloud Functions auto-generate embeddings via OpenAI, Voyage AI, Cohere, or Zilliz Hosted Models. Built-in reranking — just insert text and search.
Why Teams Are Migrating from Weaviate to Zilliz Cloud — and How to Do It Seamlessly
Explore how Milvus scales for large datasets and complex queries with advanced features, and discover how to migrate from Weaviate to Zilliz Cloud.
Announcing VDBBench 1.0: Open-Source VectorDB Benchmarking with Your Real-World Production Workloads
Discover VDBBench 1.0, an open-source tool for benchmarking vector databases with real-world production data, streaming ingestion, and concurrent workloads.