Использование SelfQueryRetriever с LangChain для запросов к векторной базе данных
LangChain хорошо известен тем, что оркестрирует взаимодействия с большими языковыми моделями (LLM). Недавно LangChain представил способ выполнения self-querying, позволяющий им запрашивать саму «цепочку» или модули с помощью пользовательского запроса. В этом посте мы покажем, как выполнять self-querying в Milvus, самой популярной в мире векторной базе данных. Интерпретируя пользовательский запрос, система может уточнять поиск в векторных хранилищах, улучшая результаты извлечения. Код для этого примера можно найти в CoLab здесь.
Давайте настроим self-querying в Milvus с помощью LangChain. Этот процесс состоит из четырех логических шагов.
Настроить основы LangChain и Milvus.
Получить или создать необходимые данные.
Сообщить модели об ожидаемом формате данных.
Продемонстрировать self-querying и объяснить, как он работает.
Введение в Self-Querying
Self-querying — это мощная техника, используемая в обработке естественного языка (NLP) и поиске информации. Она позволяет системе запрашивать саму себя, используя пользовательский запрос, обеспечивая более точные и релевантные результаты. В контексте LangChain self-querying используется для извлечения информации из векторного хранилища, то есть базы данных, которая хранит векторы, представляющие документы или точки данных. Self-query retriever — ключевой компонент фреймворка LangChain, позволяющий создавать сложные запросы и извлечения с использованием естественного языка.
Используя self-querying, LangChain может преобразовать пользовательский запрос в структурированный формат, понятный векторному хранилищу. Этот процесс гарантирует, что извлеченные документы будут высоко релевантны пользовательскому запросу, упрощая поиск нужной информации. Независимо от того, создаете ли вы разговорную AI-модель или поисковую систему, self-querying может значительно повысить точность и релевантность ваших результатов.
Настройка LangChain и Milvus
Первый шаг — настроить необходимые библиотеки. Вы можете установить требуемые библиотеки с помощью pip install openai langchain milvus python-dotenv. Если вы следовали моим предыдущим руководствам, вы уже знакомы с python-dotenv, моей предпочтительной библиотекой для работы с переменными окружения. Мы используем библиотеку OpenAI вместе с LangChain для доступа к GPT и применяем Milvus как наше векторное хранилище.
После подключения к ключу OpenAI API импортируйте необходимые модули LangChain. Нам понадобятся следующие шесть модулей:
Document: тип данных LangChain для хранения данных.OpenAIиOpenAIEmbeddings: две функциональности для доступа к OpenAI и ее embeddings.Milvus: модуль для доступа к Milvus из LangChain.SelfQueryRetriever: модуль retriever.AttributeInfo: модуль, определяющий нашу структуру данных для LangChain.
После импорта модулей мы устанавливаем переменную embeddings в функцию по умолчанию OpenAI Embeddings. Последний шаг в процессе настройки — использовать библиотеку milvus, чтобы запустить экземпляр Milvus Lite в нашем notebook.
Теперь давайте посмотрим на данные.
import os
from dotenv import load_dotenv

load_dotenv()
import openai

openai.api_key = os.getenv("OPENAI_API_KEY")
from langchain.schema import Document
from langchain.embeddings.openai import OpenAIEmbeddings
from langchain.vectorstores import Milvus
from langchain.llms import OpenAI
from langchain.retrievers.self_query.base import SelfQueryRetriever
from langchain.chains.query_constructor.base import AttributeInfo

embeddings = OpenAIEmbeddings()
from milvus import default_server
default_server.start()
Давайте соберем немного данных. Вы можете спарсить свои данные, использовать предоставленные данные как есть или использовать их как шаблон для создания своих данных. Для этого примера я подготовил список документов о фильмах, включая Jurassic Park, Toy Story, Finding Nemo, The Unbearable Weight of Massive Talent, Lord of War и Ghost Rider. Хотя я не включаю названия в наши данные, я хочу, чтобы вы знали, к каким фильмам они относятся.
Я храню каждый из этих фильмов как объект LangChain Document. Он содержит ключ page_content, соответствующий строке, в данном случае описанию фильма. Он также включает metadata, такие как год, рейтинг и жанр фильма.
docs = [
    # jurassic park
    Document(page_content="A bunch of scientists bring back dinosaurs and mayhem breaks loose",
    metadata={"year": 1993, "rating": 7.7, "genre": "action"}),
    # toy story
    Document(page_content="Toys come alive and have a blast doing so",
    metadata={"year": 1995, "genre": "animated", "rating": 9.3 }),
    # finding nemo
    Document(page_content="A dad teams up with a mentally disabled partner to break into a dentist\'s office to save his son.",
    metadata={"year": 2003, "genre": "animated", "rating": 8.2 }),
    # unbearable weight of massive talent
    Document(page_content="Nicholas Cage plays Nicholas Cage in this movie about Nicholas Cage.",
    metadata={"year": 2022, "genre": "comedy", "rating": 7.0 }),
    # lord of war
    Document(page_content="Nicholas Cage sells guns until he has enough money to marry his favorite model. Then he sells more guns.",
    metadata={"year": 2005, "genre": "comedy", "rating": 7.6 }),
    # ghost rider
    Document(page_content="Nicholas Cage loses his skin and sets his skull on fire. Then he rides a motorcycle.",
    metadata={"year": 2007, "genre": "action", "rating": 5.3 }),
]
Определение метаданных self-query и self query retriever для LangChain и Milvus
Мы завершили первые два шага головоломки, и теперь пришло время третьего.
Сначала давайте настроим нашу векторную базу данных для загрузки. Мы можем использовать реализацию LangChain Milvus, чтобы загрузить наши документы и создать векторную базу данных на основе существующих документов. На этом шаге также вступает в действие функция эмбеддингов, использующая переменную embeddings, которую мы создали ранее. Оператор сравнения учитывает конкретные форматы и рекомендации, необходимые для создания условий фильтрации, которые направляют процессы извлечения данных.
Параметр connection_args — единственный обязательный параметр для подключения к Milvus. В этом руководстве я также использую параметр collection_name, чтобы назначить имя коллекции, в которой мы храним наши данные. Каждая коллекция в Milvus должна иметь имя. По умолчанию LangChain использует LangChainCollection.
vector_store = Milvus.from_documents(
    docs,
    embedding=embeddings,
    connection_args={"host": "localhost", "port": default_server.listen_port},
    collection_name="movies"
)
Далее давайте определим информацию о метаданных с помощью функциональности AttributeInfo, чтобы LangChain знал, чего ожидать. В этом разделе будет создан список информации об атрибутах для данных. Мы укажем имя, описание и тип данных каждого атрибута. Именно здесь логическое условное выражение становится неотъемлемой частью формулирования сравнений и логических операций в процессе построения запроса.
metadata_field_info = [
    AttributeInfo(
        name="genre",
        description="The genre of the movie",
        type="string",
    ),
    AttributeInfo(
        name="year",
        description="The year the movie was released",
        type="integer",
    ),
    AttributeInfo(
        name="rating",
        description="A 1-10 rating for the movie",
        type="float"
    ),
]
Последние несколько фрагментов описывают документ, инициализируют LLM и определяют Self-Query Retriever. Мы определяем self-query retriever, вызывая его метод ‘from_llm’. Мы должны использовать этот метод, чтобы связать LLM, векторное хранилище, описание содержимого документа и информацию о полях метаданных. В этом примере мы также задаем ‘verbose = True’, чтобы включить подробный вывод для этого self-query retriever. Строка запроса должна включать только релевантный текст, соответствующий содержимому документов, гарантируя, что любые условия в фильтрах четко отделены и не включены в саму строку запроса.
document_content_description = "Brief summary of a movie"
llm = OpenAI(temperature=0)
retriever = SelfQueryRetriever.from_llm(
    llm, vector_store, document_content_description, metadata_field_info, verbose=True
)
Результаты self-querying
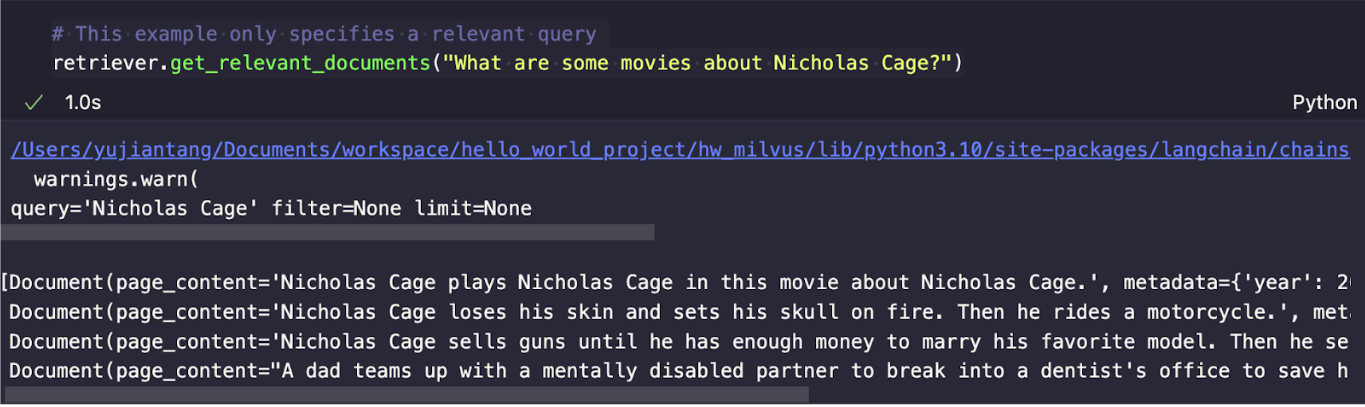
Мы завершили настройку self-query retriever. Теперь давайте посмотрим, как он работает на практике. В этом примере я использовал три описания фильмов, связанных с Nicholas Cage. Итак, вопрос, который мы задаем: какие есть фильмы о Nicholas Cage?
# This example only specifies a relevant query
retriever.get_relevant_documents("What are some movies about Nicholas Cage?")
Мы должны получить вывод, похожий на приведенный ниже.
 langchain-query-vector-database.png
Установив verbose=True, мы можем увидеть запрос, фильтр и лимит. LLM преобразует наш запрос из “What are some movies about Nicholas Cage?” в “Nicholas Cage.” Рассматривая результаты, мы можем заметить, что первые три результата — это все фильмы с участием Nicholas Cage. Однако четвертый результат, Finding Nemo, нерелевантен из-за параметра, установленного на получение четырех результатов.
Надеюсь, пошаговый разбор кода прояснил концепцию self-querying в векторной базе данных. На сайте LangChain LangChain описывает self-querying как метод, позволяющий LLM запрашивать самого себя с использованием базового векторного хранилища. Другими словами, LangChain разрабатывает простое приложение retrieval augmented generation (RAG) в CVP framework, которое включает функцию self-querying.
В этом руководстве мы рассмотрели функцию self-query в LangChain, используя Milvus в качестве базового векторного хранилища. Self-querying позволяет создать простое RAG-приложение, объединяя LLM и векторную базу данных. LLM разбивает запрос на естественном языке на строку, которая затем векторизуется для выполнения запроса.
В нашем примере мы сгенерировали некоторые примерные данные, связанные с фильмами. Один из способов расширить этот пример — собрать ваши данные. При определении self-query retriever не забудьте предоставить описания как для векторного хранилища, так и для метаданных.
Чтобы начать работу и поэкспериментировать с функцией self-query в LangChain, обратитесь к colab notebook.
Запрос к векторному хранилищу с помощью операторов логических операций
При выполнении запроса к векторному хранилищу операторы логических операций используются для указания условий фильтрации документов. Оператор логической операции имеет форму op(statement1, statement2, …), где op — логический оператор, такой как AND, OR или NOT. Каждый statement может быть оператором сравнения, который имеет форму comp(attr, val), где comp — компаратор, такой как EQ, LT или GT, а attr и val — соответственно сравниваемые атрибут и значение.
Например, оператор логической операции может выглядеть так: AND(EQ(language, “English”), GT(rating, 4)). Этот оператор будет фильтровать документы, у которых атрибут language равен “English”, а атрибут rating больше 4. Используя операторы логических операций, вы можете создавать сложные запросы, которые объединяют несколько условий, обеспечивая более точную фильтрацию документов в векторном хранилище.
Обработка запроса пользователя
Когда пользователь вводит запрос, ретривер с самозапросом использует конструктор запросов для генерации структурированного запроса. Затем структурированный запрос преобразуется в запросы к векторному хранилищу, которые выполняются в векторном хранилище для извлечения релевантных документов. Конструктор запросов использует промпт и парсер вывода для генерации структурированного запроса, который отражает фильтры, указанные пользователем.
Например, если пользователь вводит запрос «Найти фильмы с рейтингом выше 4 и продолжительностью менее 2 часов», конструктор запросов может сгенерировать такой структурированный запрос: AND(GT(rating, 4), LT(runtime, 120)). Затем этот структурированный запрос будет преобразован в запросы к векторному хранилищу и выполнен в векторном хранилище для извлечения релевантных документов. Обрабатывая запрос пользователя таким образом, ретривер с самозапросом гарантирует, что результаты будут адаптированы к конкретным требованиям пользователя.
Лучшие практики и заключение
При использовании ретривера с самозапросом важно следовать лучшим практикам, чтобы обеспечить точные и релевантные результаты. Вот несколько советов:
Используйте конкретный и лаконичный язык при вводе запросов.
Используйте операторы логических операций, чтобы задавать условия для фильтрации документов.
Используйте операторы сравнения, чтобы сравнивать атрибуты и значения.
Используйте компаратор EQ, чтобы указывать точные совпадения.
Используйте компараторы LT и GT, чтобы задавать диапазонные запросы.
Используйте логические операторы AND и OR, чтобы объединять условия.
В заключение, ретривер с самозапросом — это мощный инструмент для создания разговорных моделей ИИ, которые могут извлекать и обрабатывать информацию из различных источников. Используя операторы логических операций и операторы сравнения, пользователи могут задавать сложные запросы и извлекать релевантные документы из векторного хранилища. Следуя лучшим практикам и эффективно используя ретривер с самозапросом, разработчики могут создавать более точные и релевантные модели ИИ, способные обрабатывать широкий спектр пользовательских запросов.
Читать далее
How to Improve Retrieval Quality for Japanese Text with Sudachi, Milvus/Zilliz, and AWS Bedrock
Learn how Sudachi normalization and Milvus/Zilliz hybrid search improve Japanese RAG accuracy with BM25 + vector fusion, AWS Bedrock embeddings, and practical code examples.
Why Teams Are Migrating from Weaviate to Zilliz Cloud — and How to Do It Seamlessly
Explore how Milvus scales for large datasets and complex queries with advanced features, and discover how to migrate from Weaviate to Zilliz Cloud.
How AI and Vector Databases Are Transforming the Consumer and Retail Sector
AI and vector databases are transforming retail, enhancing personalization, search, customer service, and operations. Discover how Zilliz Cloud helps drive growth and innovation.