Zilliz Cloud Pipelines를 사용한 메타데이터 필터링
제가 자주 듣는 질문은 “벡터 데이터베이스에 더해 일반 SQL 데이터베이스도 필요한가요?”입니다. 비정형 데이터와 함께 추가 정보를 포함하는 경우 이 질문이 필요할 수 있습니다. 또한 시맨틱 유사도 검색을 수행하기 전에 비즈니스 목적에 맞게 데이터를 필터링할 수 있습니다. 예를 들어:
법률 분야에서는 계약 데이터베이스 또는 특정 계약에서만 텍스트 청크를 검색해야 할 수 있습니다.
리테일에서는 남성 신발의 특정 사이즈로 검색 범위를 좁히고 싶을 수 있습니다.
이미지 검색에서는 2010~2016년에 개봉한 영화 포스터 중 IMDB 점수가 7.0보다 높은 것을 찾고 싶을 수 있습니다.
위 질문으로 돌아가면, 제 답은 “아니요, Milvus 벡터 데이터베이스나 완전 관리형 Milvus인 Zilliz Cloud를 사용할 때는 걱정하지 않아도 됩니다.”입니다. Milvus를 사용하면 하이브리드 벡터 및 스칼라 검색을 수행하여 더 높은 정밀도를 달성할 수 있습니다.
다음 섹션에서는 스칼라 또는 메타데이터 필터링과 Zilliz Cloud에서 메타데이터 필터링을 수행하는 방법에 대해 논의하겠습니다. 이 블로그는 단 5분 만에 RAG 시작하기에 대한 제 이전 블로그의 연속입니다. 코드는 이 노트북에서 찾을 수 있으며 Cell #27까지 아래로 스크롤하면 됩니다.
Milvus에서 메타데이터 필터링을 이해하는 방법은?
Milvus 벡터 데이터베이스를 사용하면 불리언 표현식을 적용하고 데이터 속성에 대한 조건으로 제한하여 벡터 검색을 수행할 수 있습니다. 속성은 비정형 데이터 임베딩 벡터를 제외한 모든 필드가 될 수 있습니다. 또한 메타데이터 필터링은 Milvus에서 벡터 검색과 공존합니다. 필터 표현식에서 임베딩 벡터 필드 이외의 모든 필드를 사용할 수 있으며, 벡터 인덱스를 사용해 임베딩 벡터 필드를 검색할 수 있습니다. 검색 명령에서 필터 표현식을 지정하면 Milvus가 두 작업을 모두 자동으로 처리합니다.
Zilliz Cloud에서 메타데이터 필터링을 수행하는 방법은?
빠르게 반복 작업을 시작하기 위해, 이 가이드에서는 완전 관리형 Milvus인 Zilliz Cloud (Free Tier)를 사용하겠습니다. 이는 서버리스 클라우드 서버에서 데이터베이스를 호스팅하지만, PyMilvus API 호출을 통해 로컬에서도 여전히 상호작용할 수 있습니다. 또한 간소화된 작업을 위해 비정형 데이터를 벡터 임베딩으로 인코딩하는 기본 제공 기능인 Zilliz Cloud Pipelines도 사용하겠습니다.
아래 데이터는 저희 Milvus Documentation 문서 페이지에서 가져온 것입니다.
Step 1: 컬렉션(데이터베이스 테이블)과 파이프라인 만들기
데이터를 S3 또는 GCS에 업로드합니다.
다른 브라우저 창에서 https://cloud.zilliz.com/을 열고 “Starter” Cluster를 만듭니다.
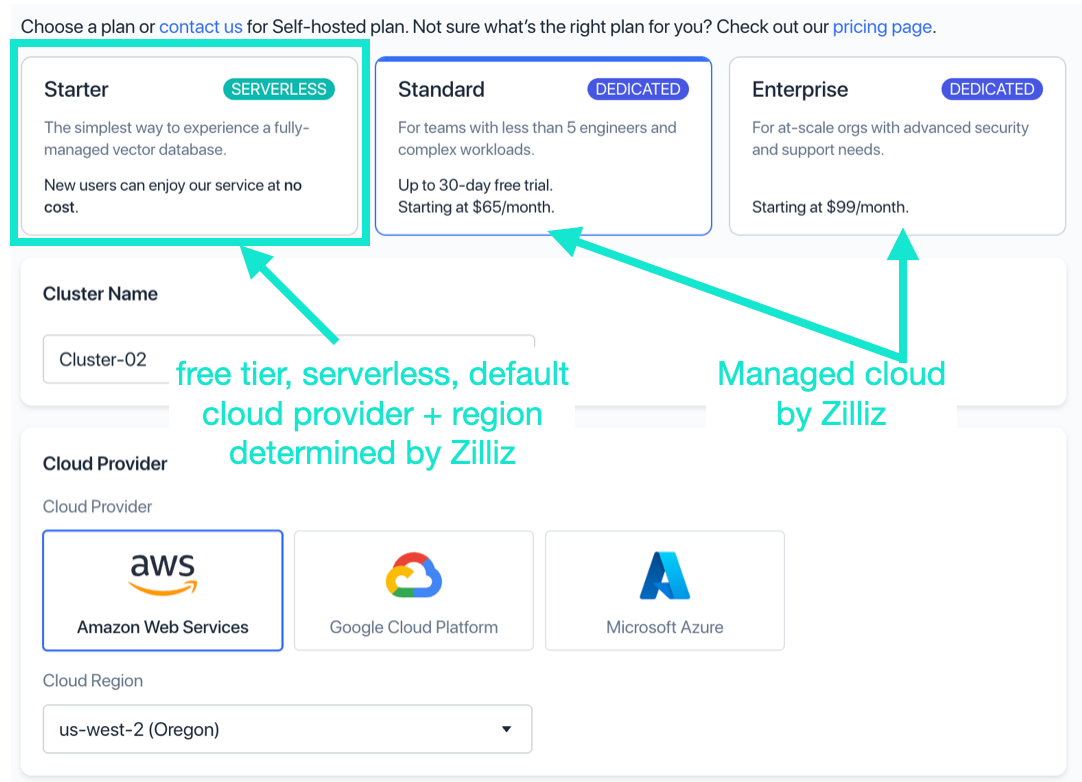
- 컬렉션 이름을 추가하고 “Create Collection and Cluster”를 클릭합니다.

참고: 첫 번째 Zilliz Cloud 클러스터를 만들 때 기본적으로 새 컬렉션도 함께 생성됩니다. Zilliz Cloud Pipelines를 사용하면 또 다른 새 컬렉션을 만들게 됩니다.
- 왼쪽 메뉴에서 Pipelines로 이동하고 안내 단계에 따라 데이터를 업로드합니다.
a. “Ingestion Pipeline”으로 시작합니다.
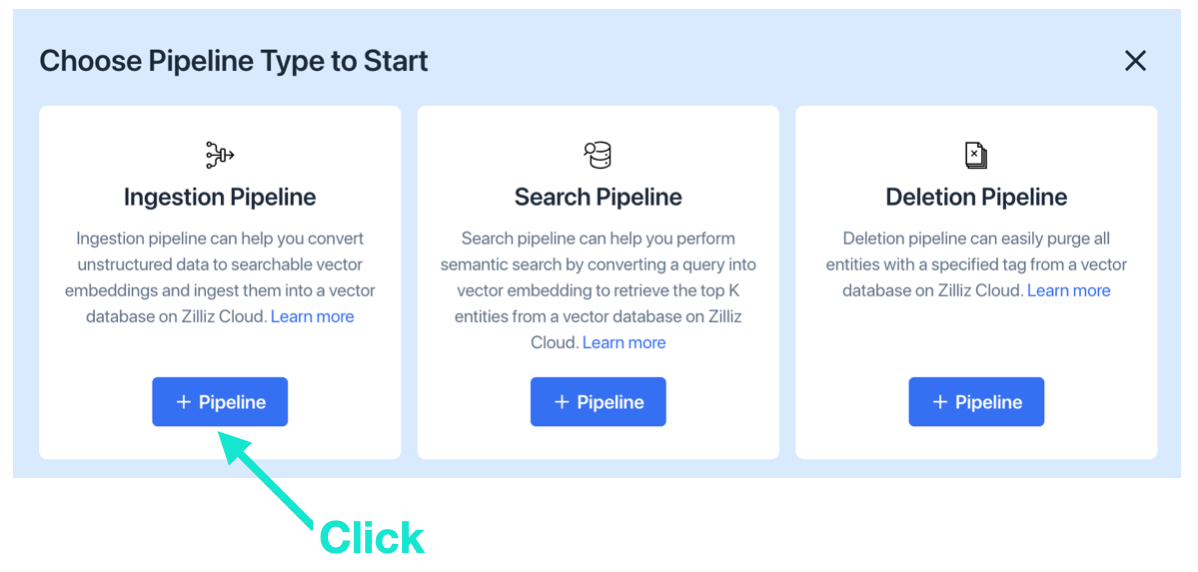
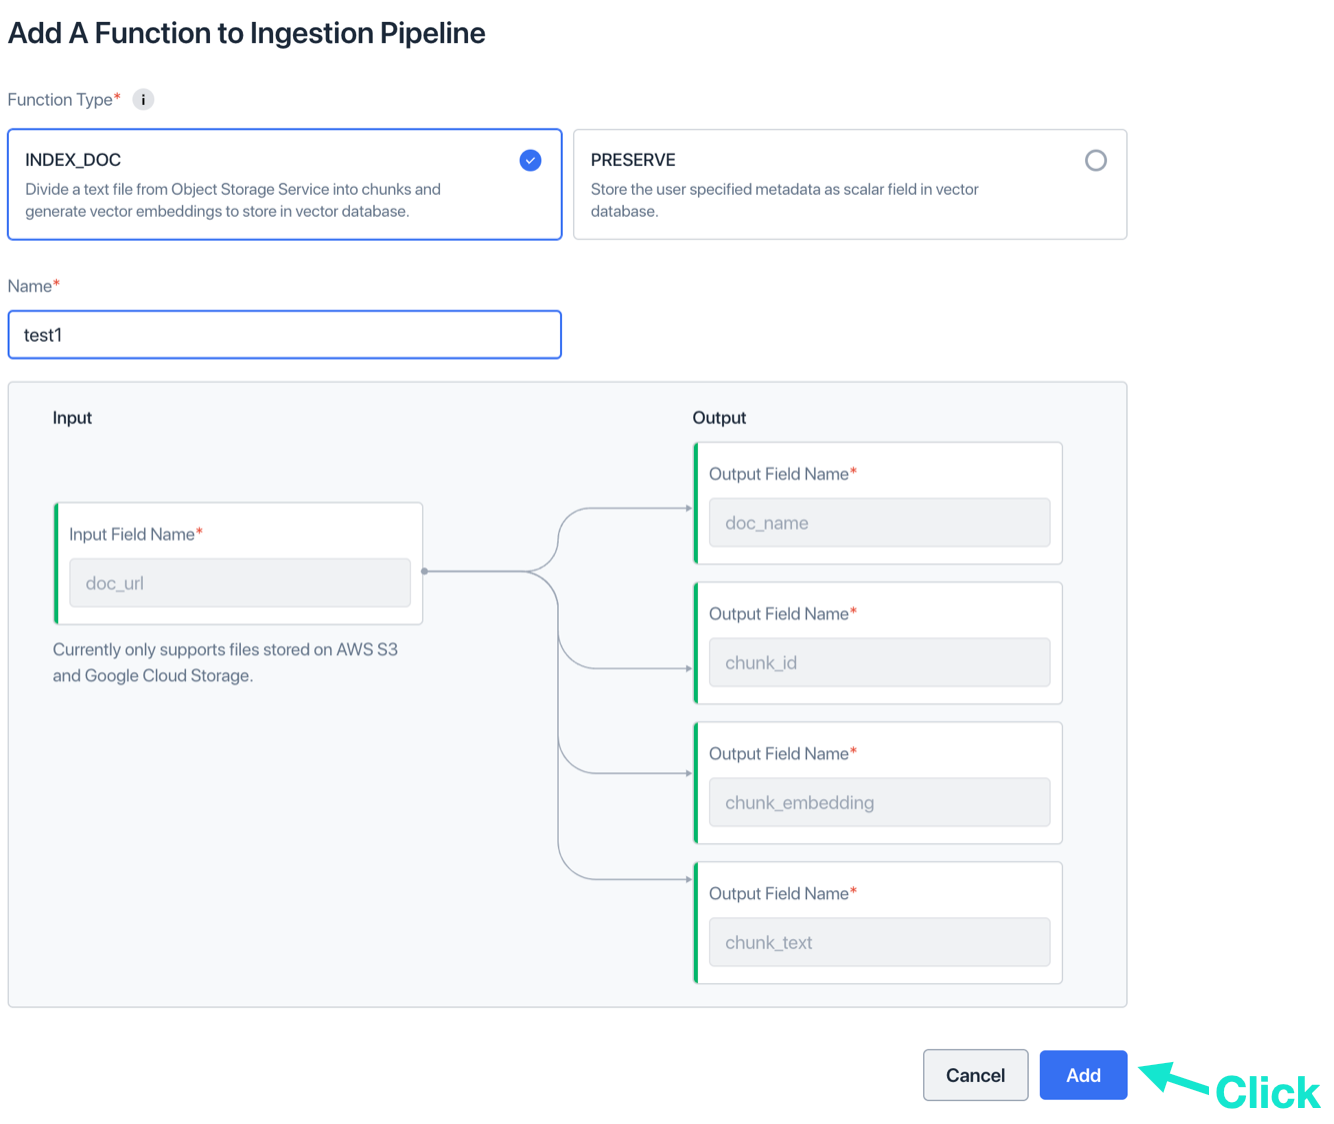
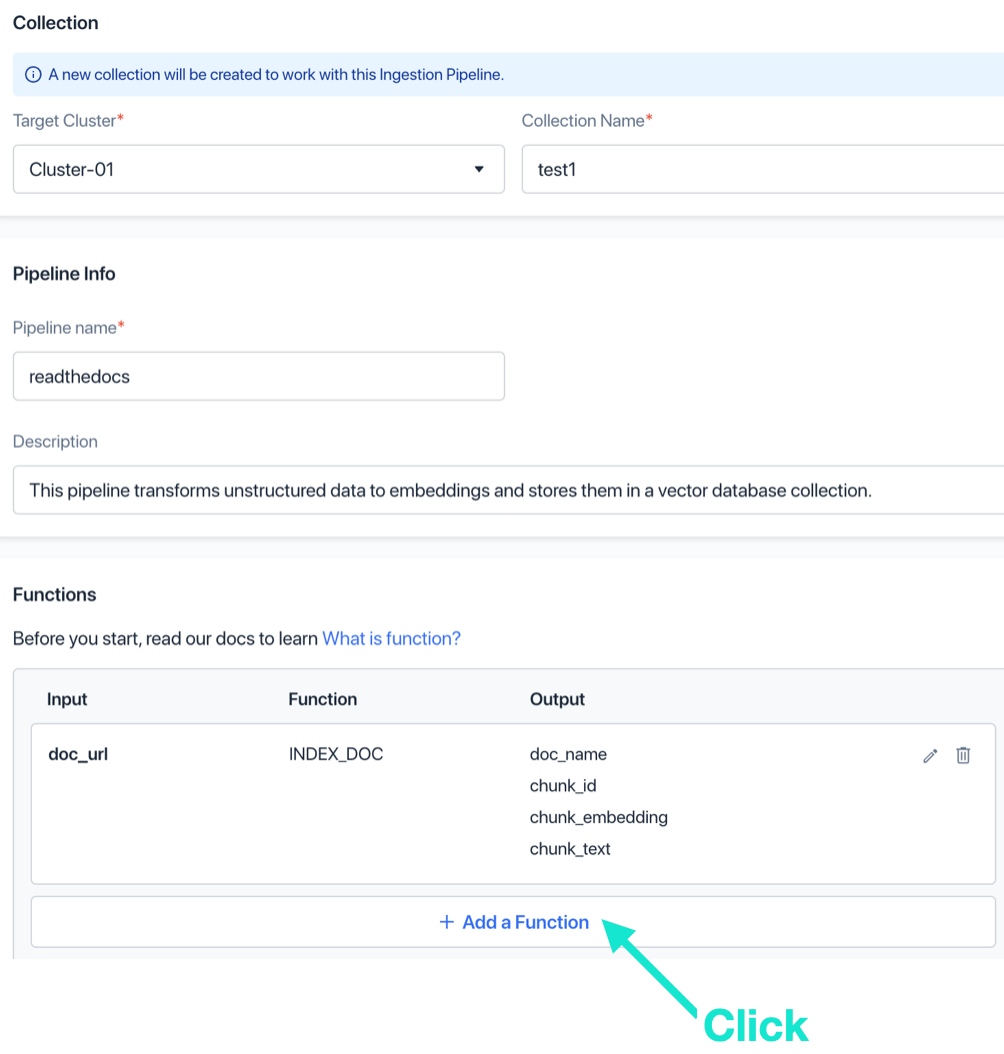
b. 클러스터 이름을 선택하고, 컬렉션 및 파이프라인 이름을 추가한 다음 “Add a Function”을 클릭합니다.
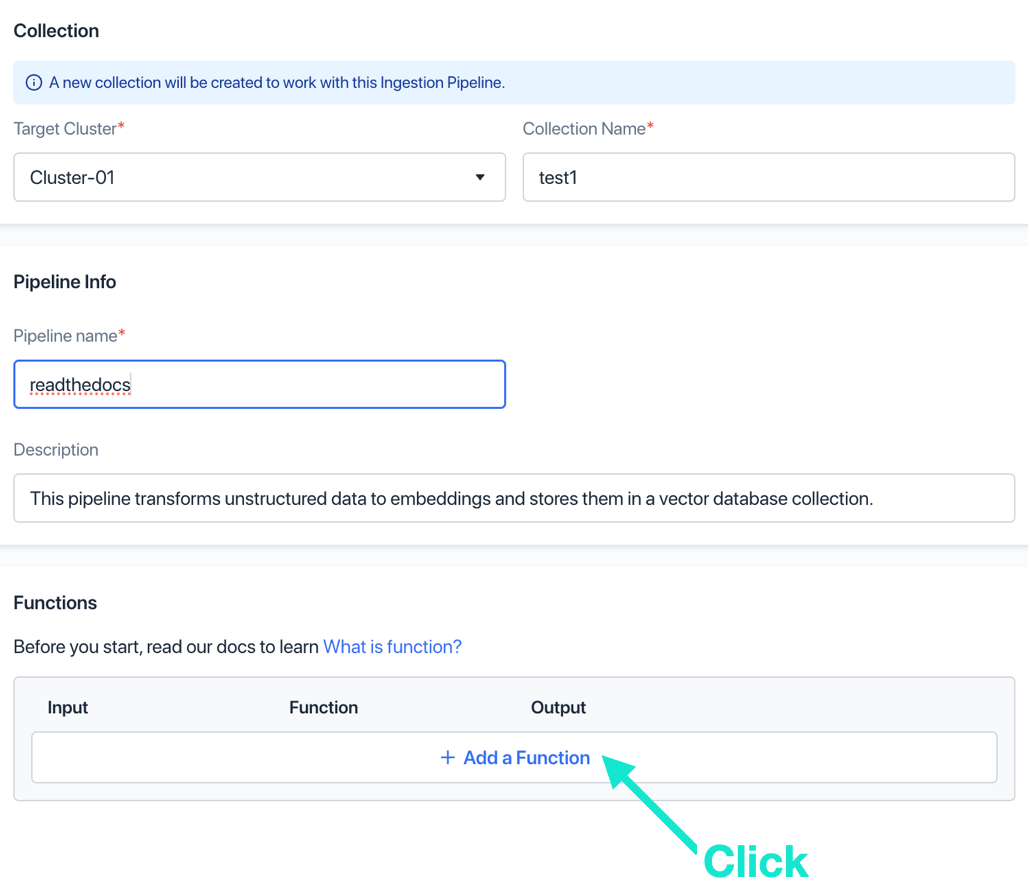
c. 이름을 추가하고 “Add”를 클릭합니다. 파이프라인의 이 단계에서는 아무것도 수정할 수 없습니다.
d. 선택 사항: “Add a Function”을 다시 클릭합니다
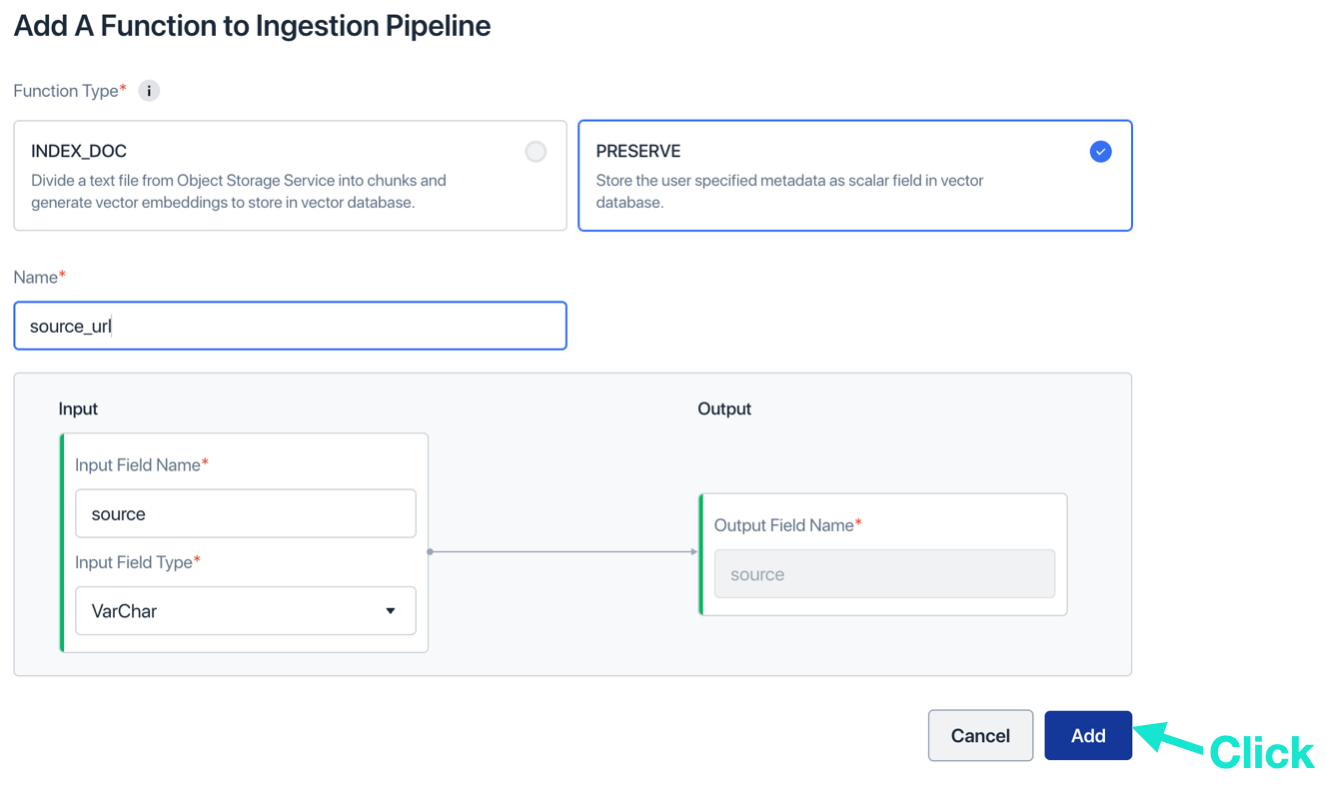
e. 선택 사항: 메타데이터 필드 단계, 메타데이터 필드, 유형의 이름을 지정합니다. “Add”를 클릭합니다.
- “Create Ingestion Pipeline”을 클릭합니다. 이제 새 Ingestion Pipeline과 새 Collection을 만들었습니다.

“Create Deletion and Search Pipelines”를 클릭하여 삭제 및 검색 파이프라인을 만듭니다.
파이프라인 “Ingestion”을 찾으려면 “Actions” 아래에서 Run 아이콘 > 을 클릭합니다.

- 데이터를 지정합니다. AWS에서 가장 쉬운 방법은 임시 사전 서명된 URL을 사용하는 것입니다. 공유할 시점을 선택한 다음 Copy the pre-signed URL을 클릭합니다.
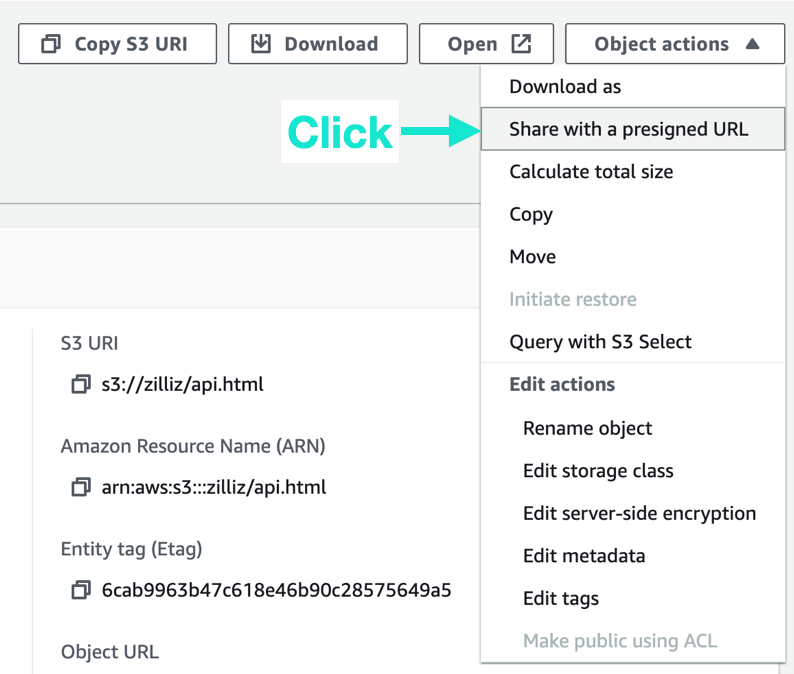
- 사전 서명된 URL을 붙여넣고 “Run”을 클릭합니다.
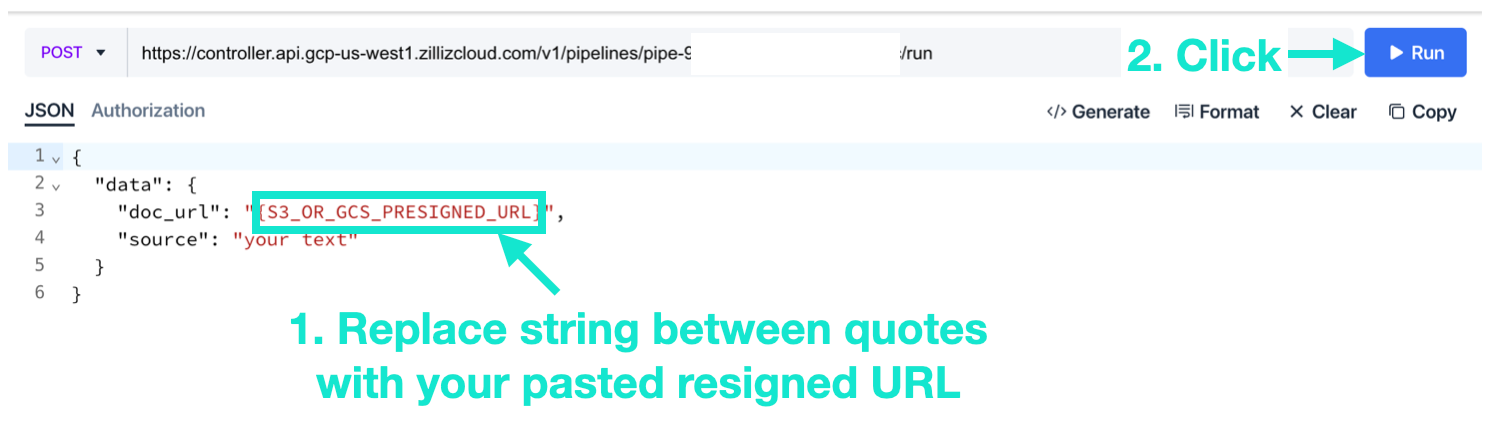
- 브라우저를 새로 고치고 새 컬렉션과 스키마가 올바른지 확인합니다.
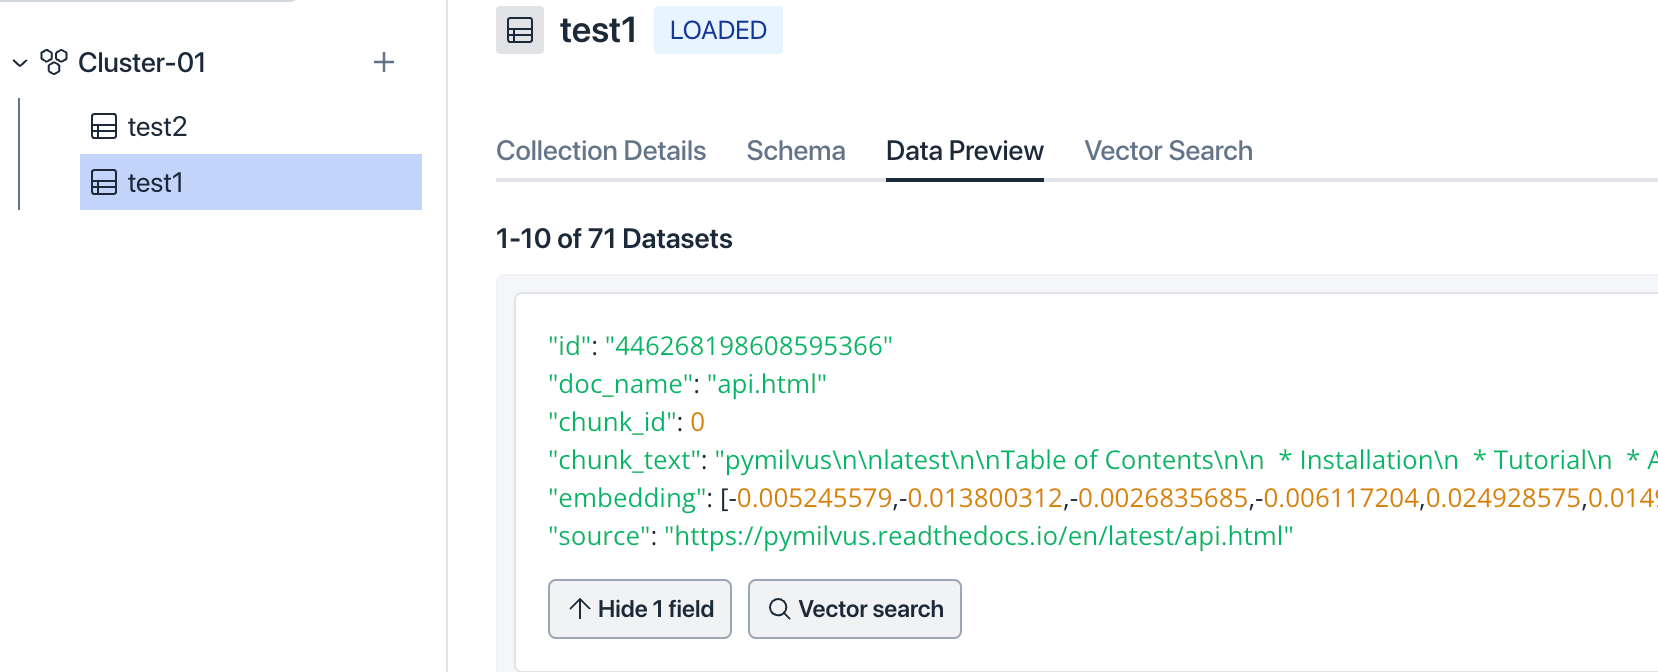
웹 콘솔에서 또는 API 호출을 사용하여 쿼리합니다.
2단계. 웹 콘솔에서 검색
Actions 아래에서 Pipeline “Search”를 찾고 > Run 아이콘을 클릭합니다.
UI에서 질문을 입력하고 “Run”을 클릭합니다.
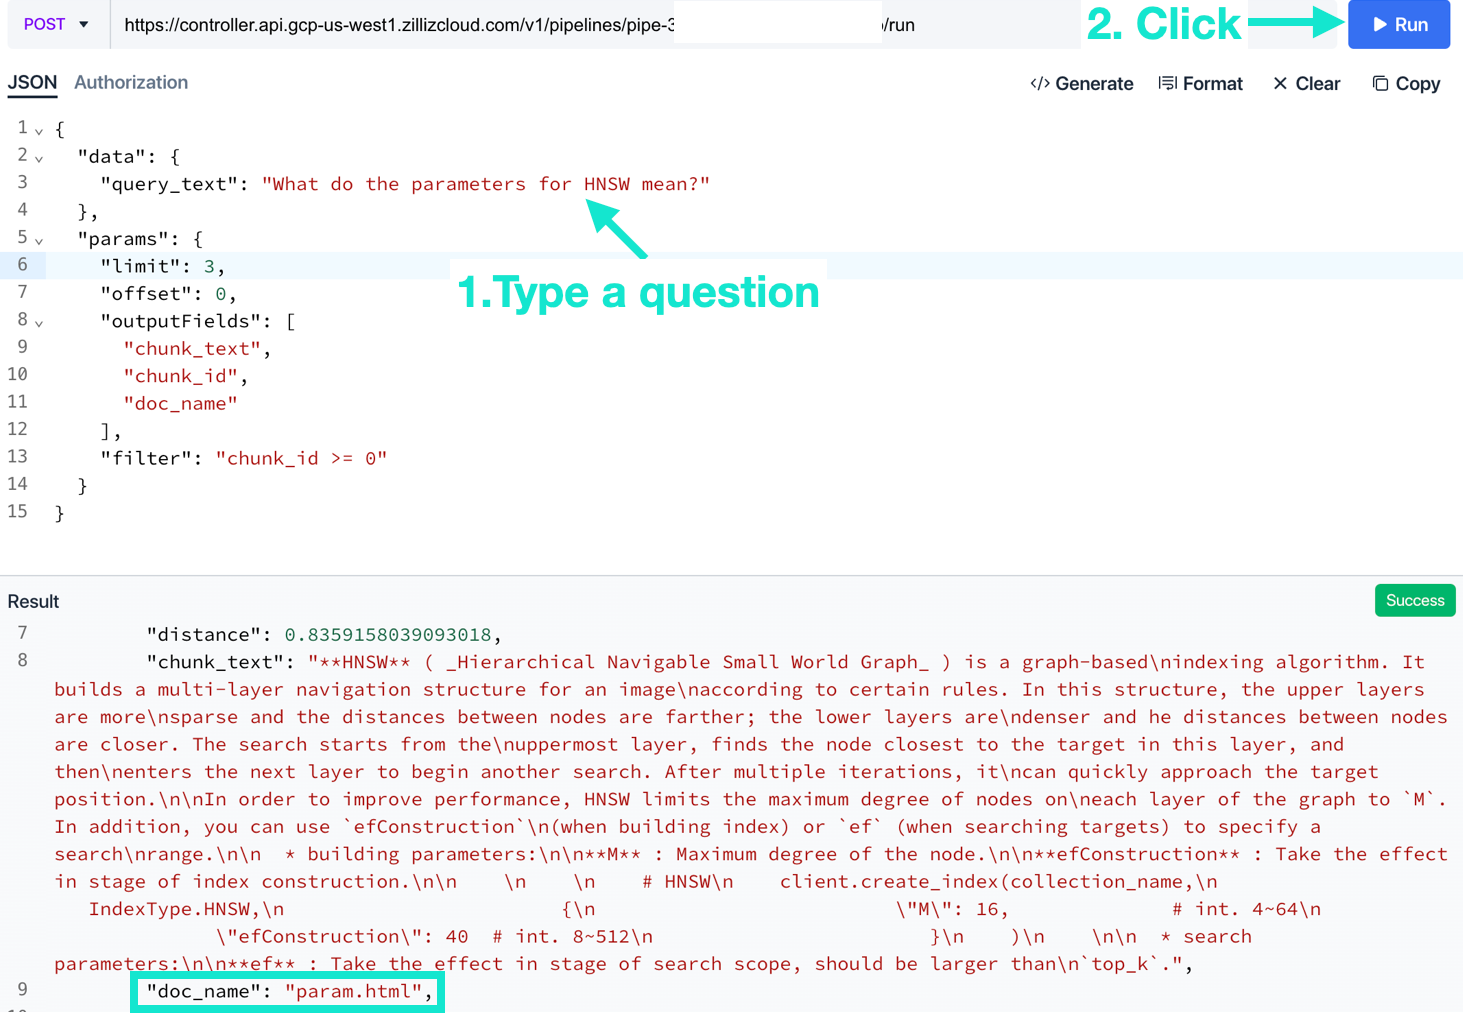
불리언 표현식을 사용하여 “filter”를 편집합니다. 필터가 검색 결과에 적용된 것을 확인할 수 있습니다.
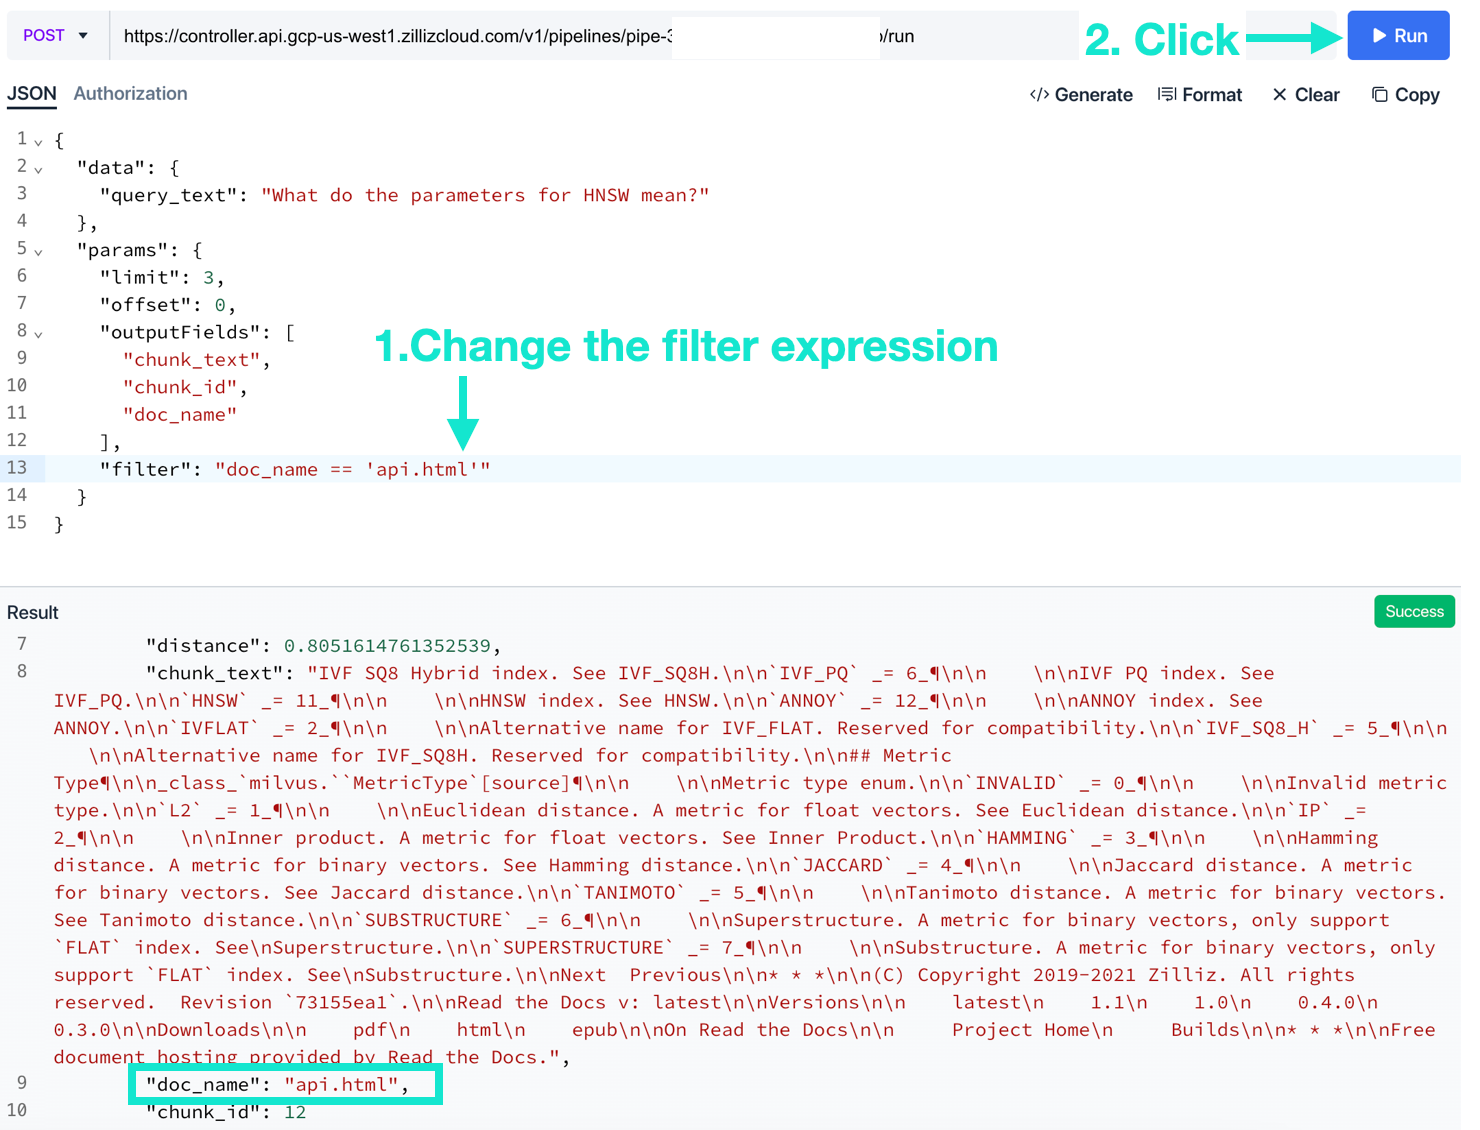
이상입니다! 불리언 표현식을 사용하여 비정형 데이터 임베딩 벡터를 제외한 모든 필드로 검색을 필터링할 수 있습니다. 임베딩 벡터 필드는 Pipelines에서 벡터 인덱스 AUTOINDEX를 사용해 검색됩니다.
또한 Pipelines에서는 임베딩이 정규화되어 IP와 코사인 거리 메트릭이 동일하게 작동합니다. 현재 Pipelines에서 사용되는 기본 임베딩 모델은 bge-large-en-v1.5입니다.
3단계. API를 통한 검색
API 호출을 사용하여 검색할 수도 있습니다(Python 코드는 이 노트북에 있습니다. Cell#27까지 아래로 스크롤하세요. )
두 가지가 필요합니다.
Zilliz API Token
Pipeline-ID
API Token은 Cluster 기본 화면에서 가져올 수 있습니다.
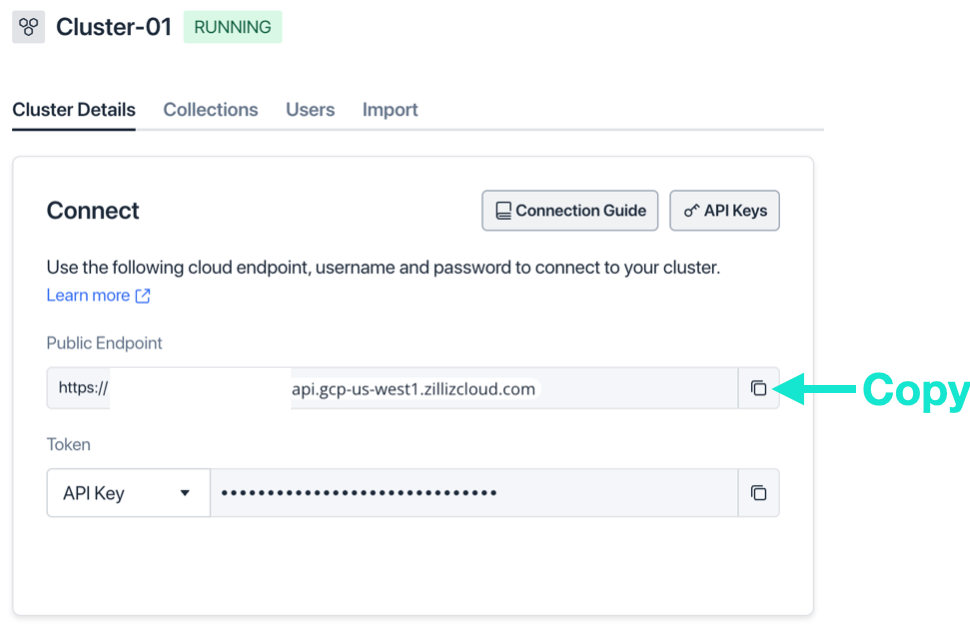
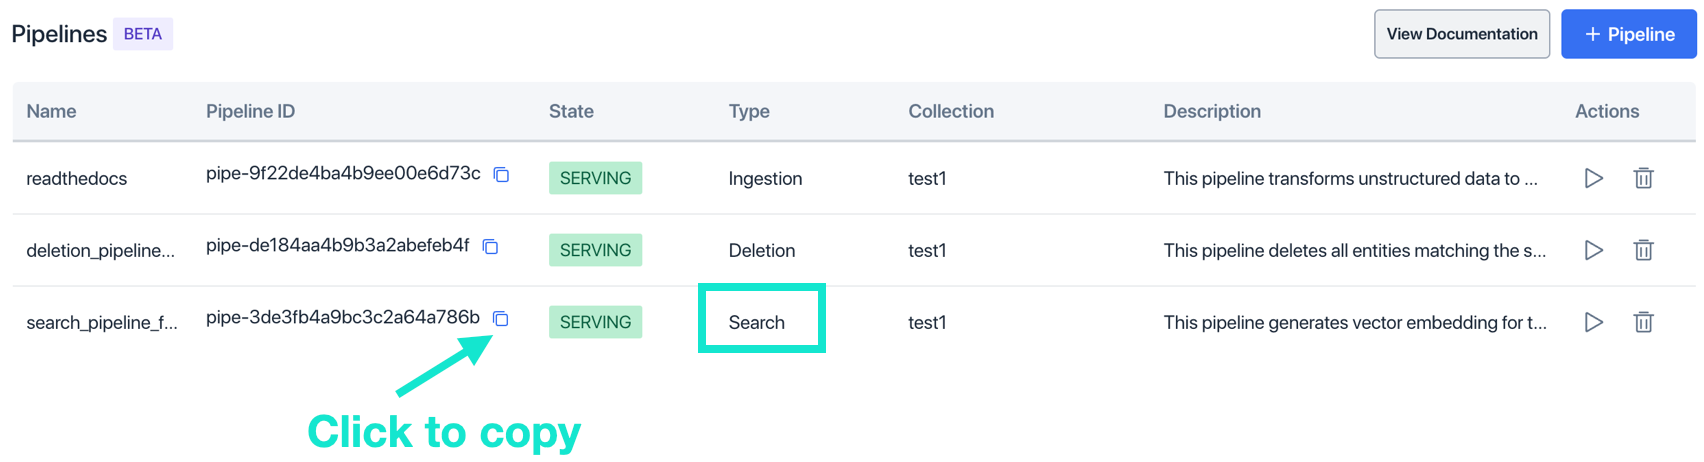
Pipeline-ID를 가져오려면 Pipeline “Search”를 찾고, “Pipeline-ID” 열을 확인한 다음 복사 아이콘을 클릭합니다. API 호출의 URL에 Pipeline ID를 붙여넣습니다.
import requests, json

url = "https://controller.api.gcp-us-west1.zillizcloud.com/v1/pipelines/pipe-xxxx/run"
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {TOKEN}",
}
data = {
    "data": {
        "query_text": SAMPLE_QUESTION
    },
    "params": {
        "limit": TOP_K,
        "offset": 0,
      # Any of these fields can be used in filter expression.
        "outputFields": ["chunk_text", "chunk_id", "doc_name", "source"],
        "filter": "doc_name == 'param.html'"
    }
}

# Send the POST request
response = requests.post(url, headers=headers, json=data)
이제 끝입니다! 이제 API를 통해 Zilliz Cloud에서 필터 검색을 수행하는 방법을 배웠습니다.
요약
SQL 데이터베이스에서 데이터를 조인하여 SQL 쿼리를 수행할 수 있게 하는 것처럼, 메타데이터 필터링을 사용하면 Milvus 또는 Zilliz Cloud에서 하이브리드 벡터 및 스칼라 검색을 수행하여 특정 요구 사항에 맞는 더 정확한 결과를 얻을 수 있습니다. 스칼라 필드 또는 기본 키 필드를 필터링하는 boolean expressions를 지정하여 특정 조건으로 검색을 제한할 수 있습니다. 임베딩 벡터를 제외한 모든 필드를 필터 표현식에 사용할 수 있으며, vector index를 사용하여 임베딩 벡터 필드를 검색할 수 있습니다. 검색 명령에서 필터 표현식을 지정하면 Milvus 또는 Zilliz Cloud가 두 작업을 모두 자동으로 처리합니다.
이 데모의 전체 code는 이 노트북에 있습니다. Cell#27까지 아래로 스크롤하세요. 한번 시도해 보세요.
계속 읽기
A Developer's Guide to Exploring Milvus 2.6 Features on Zilliz Cloud
Milvus 2.6 marks a shift from “vector search + glue code” to a more advanced retrieval engine, and it is now Generally Available (GA) on Zilliz Cloud (a managed Milvus service).
Build for the Boom: Why AI Agent Startups Should Build Scalable Infrastructure Early
Explore strategies for developing AI agents that can handle rapid growth. Don't let inadequate systems undermine your success during critical breakthrough moments.
How AI Is Transforming Information Retrieval and What’s Next for You
This blog will summarize the monumental changes AI brought to Information Retrieval (IR) in 2024.