Zilliz REST API 시작하기
Zilliz Cloud는 인공지능(AI) 및 분석 애플리케이션을 대규모로 구현하고 가속화할 수 있는 포괄적인 벡터 데이터베이스 서비스입니다. 수십억 개의 벡터 임베딩을 쉽게 처리할 수 있는 강력하고 확장 가능한 오픈 소스 벡터 데이터베이스인 Milvus를 기반으로 구축되었습니다.
Milvus는 비정형 데이터 처리를 단순화하여 기업이 방대한 양의 데이터를 효율적으로 분석하고 인사이트를 도출할 수 있게 해줍니다. 확장 가능하고 클라우드에 바로 사용할 수 있는 벡터 데이터베이스를 제공함으로써 Zilliz Cloud는 원스톱 솔루션 역할을 합니다.
Milvus와 Zilliz Cloud의 사용 사례는 광범위하고 다양합니다. 고객의 탐색 및 구매 패턴을 분석하여 맞춤형 쇼핑 경험을 제공하는 추천 시스템을 구동할 수 있습니다. 의료 분야에서는 대규모 의료 데이터셋에서 패턴을 인식하는 AI 모델 구축을 지원하여 더 정확한 진단과 개인화된 치료 계획으로 이어질 수 있습니다.
Zilliz Cloud가 Milvus에 추가하는 기능 중 하나는 벡터 데이터베이스를 관리하기 위한 REST API로, 컬렉션을 조작하고, 데이터를 업로드 및 삭제하고, 쿼리를 제출하는 간단한 메서드를 제공합니다. 이 게시물에서는 이러한 API를 사용하는 방법을 보여드립니다. 시작해 보겠습니다!
시작하기 전에
이 튜토리얼을 따라 하려면 몇 가지가 필요합니다:
먼저 Zilliz Cloud 계정이 필요합니다. 이미 계정이 있다면 클러스터의 URL과 API 키를 가져오는 단계로 건너뛰어도 됩니다.
이 게시물에서 다루는 모든 내용은 무료 계정으로 작동하므로 여기로 이동하여 Get Started Free를 클릭하기만 하면 됩니다. 그런 다음 Zilliz 대시보드에 로그인하고 안내에 따라 클러스터를 생성하세요.
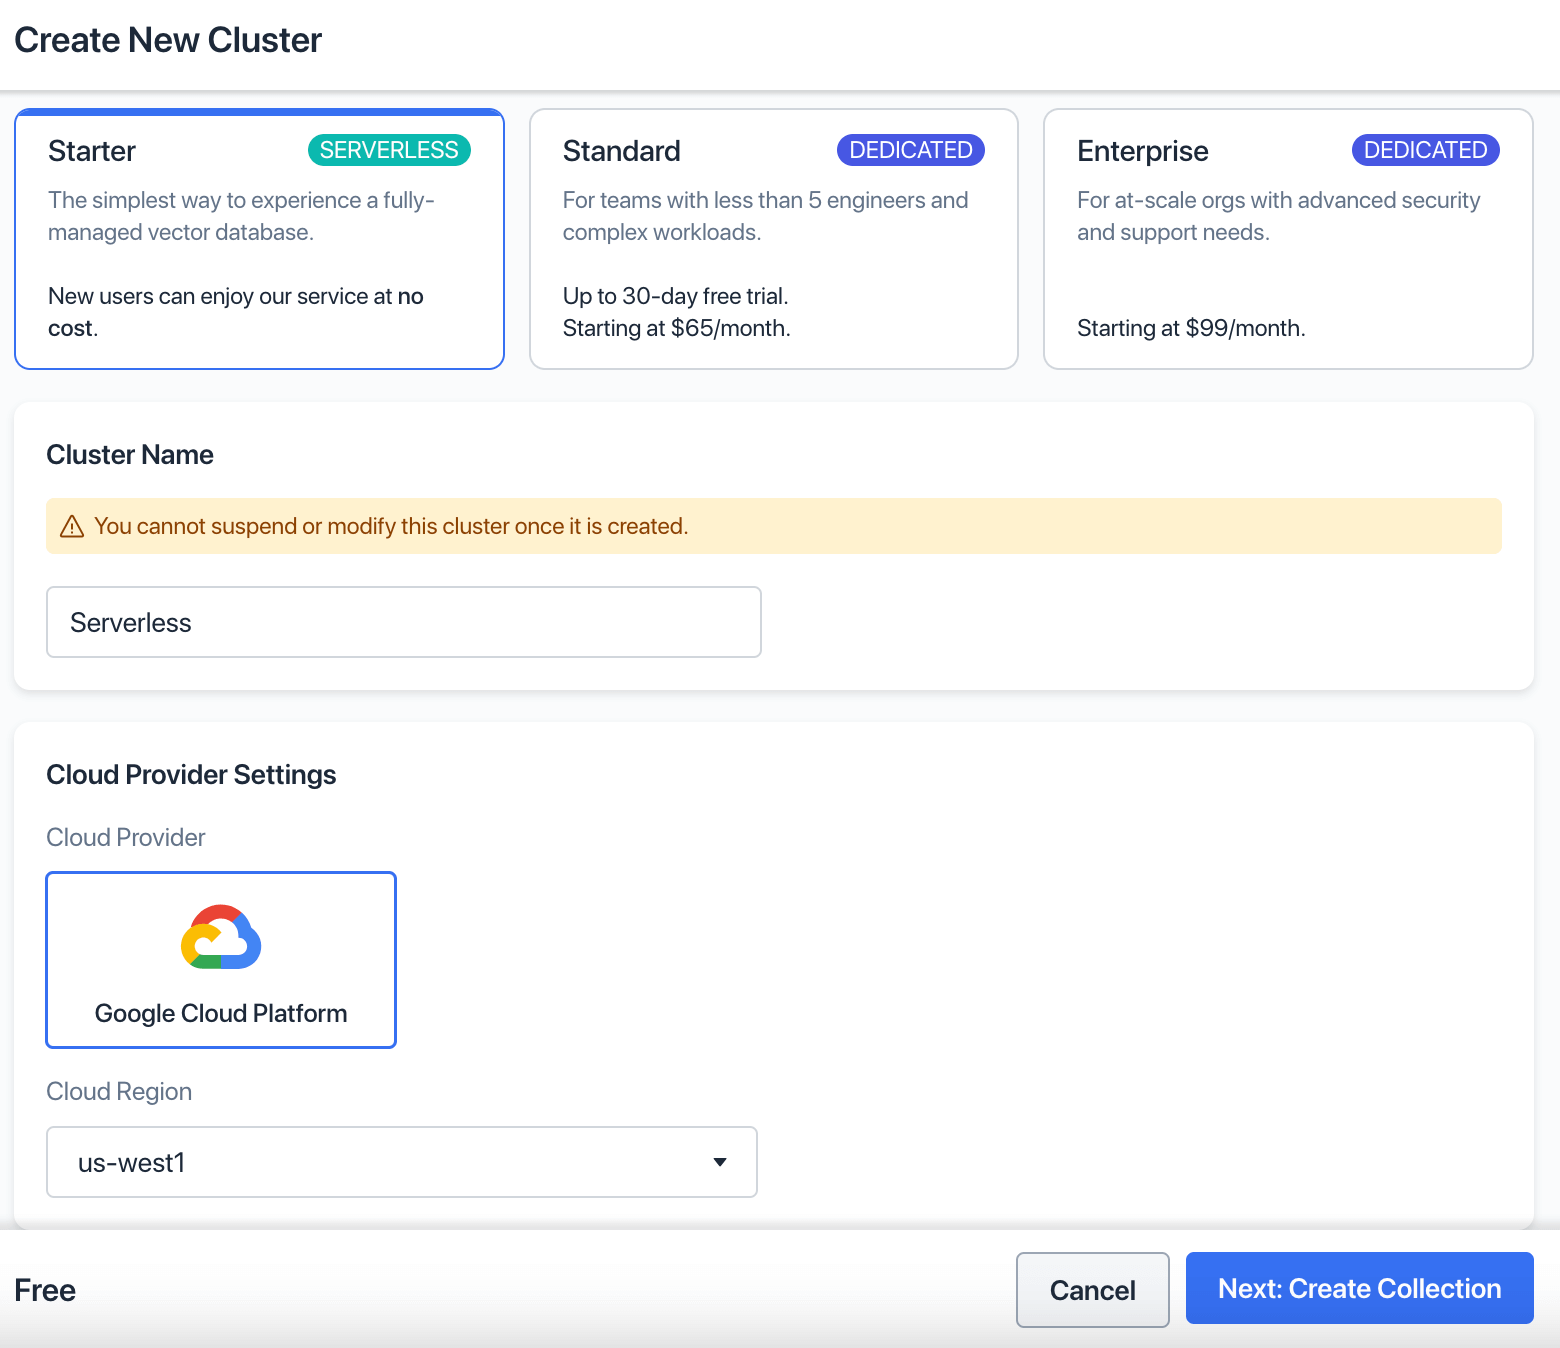 새 클러스터 생성
이름을 지정하세요. 기본 옵션으로 이 튜토리얼에는 충분합니다. Next: Create Collection을 클릭하세요.
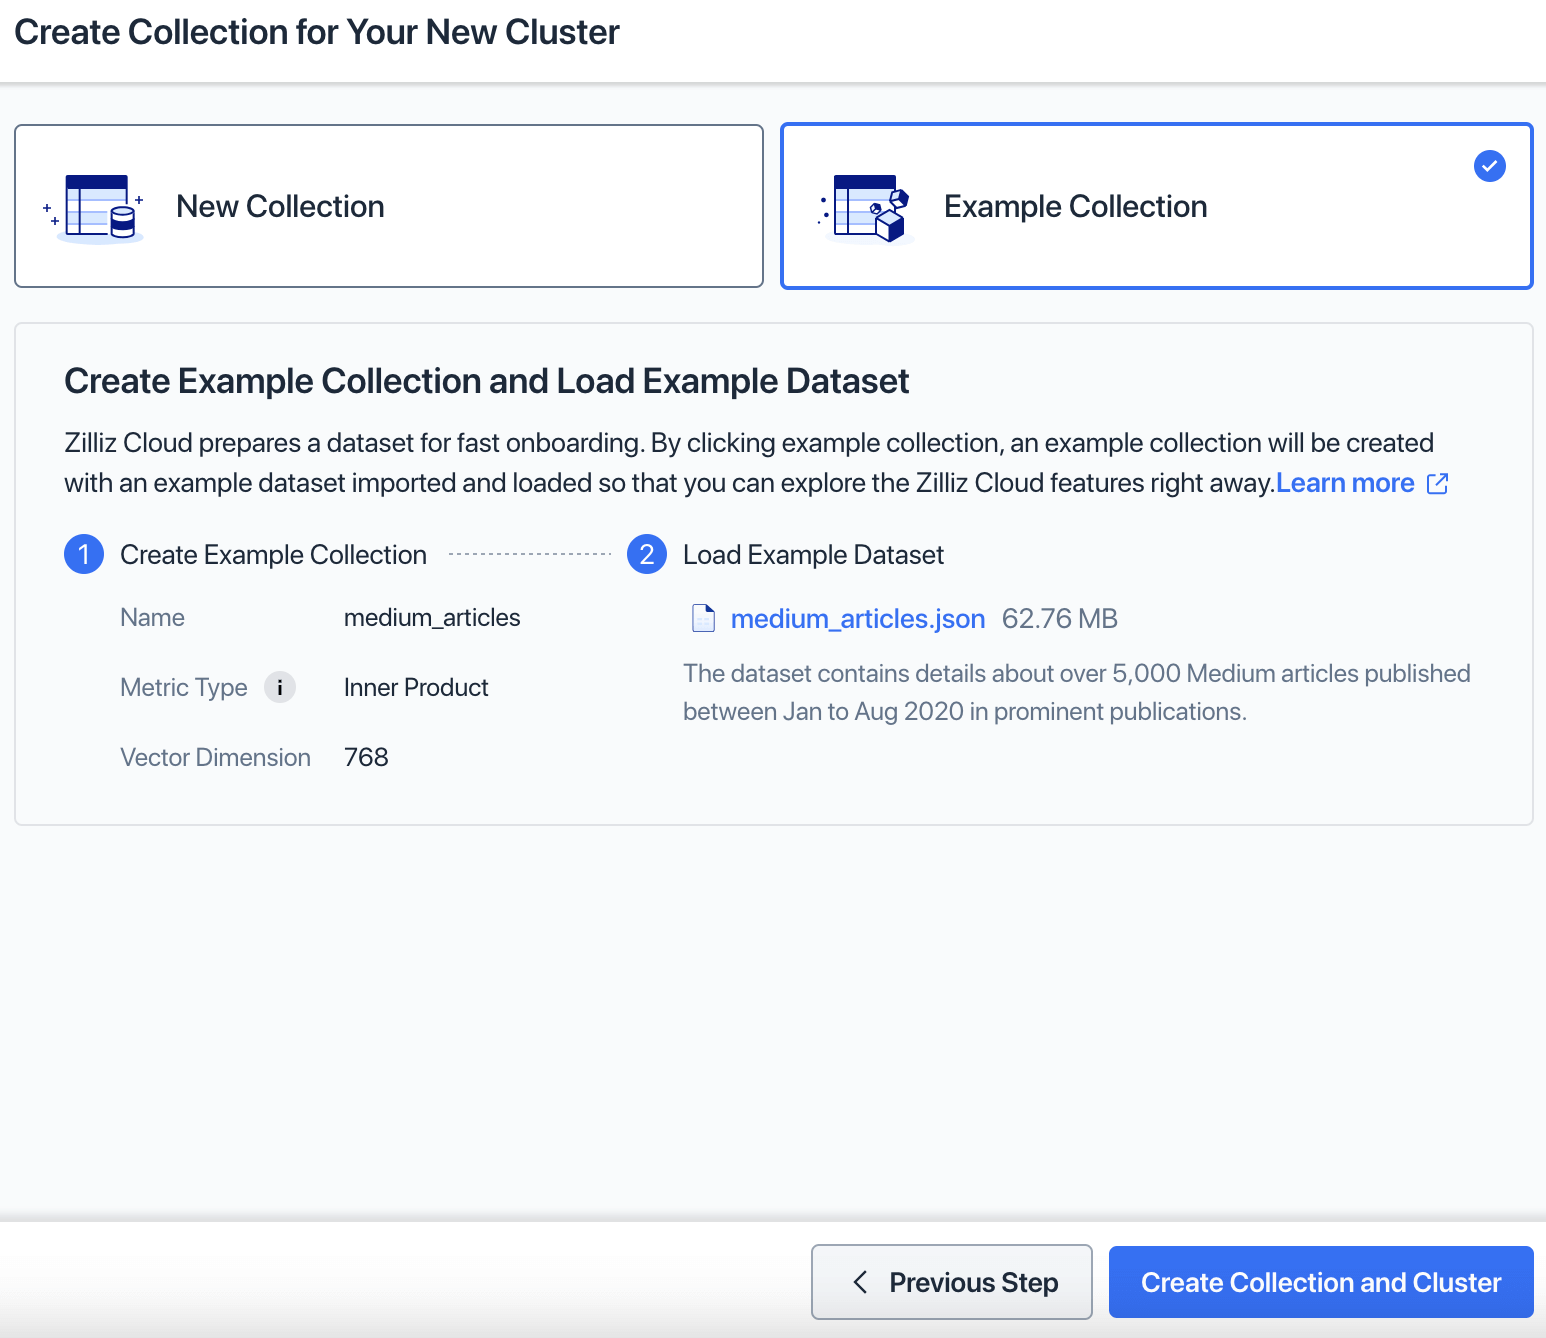 새 클러스터용 컬렉션 생성
Example Collection을 선택한 다음 Create Collection and Cluster를 선택하세요.
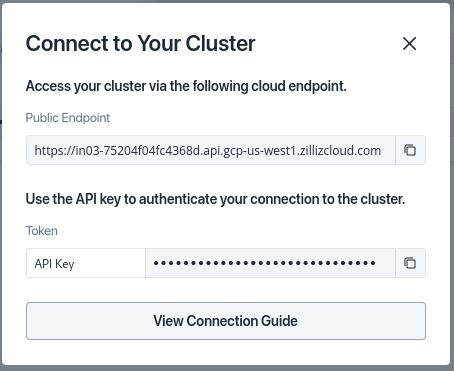 클러스터에 연결
이 대화 상자에는 클러스터 URL과 API 키가 있습니다. 나중에 사용할 수 있도록 복사하세요. 대시보드에서 클러스터를 선택하여 가져올 수도 있습니다.
이 튜토리얼의 예제에는 Visual Studio Code와 vscode-restclient 플러그인의 코드가 포함됩니다.
쿼리는 여기, gist에서 찾을 수 있습니다. 모든 HTTP 클라이언트로 따라 하거나 Zilliz 대시보드의 Playground를 사용할 수 있습니다.
Zilliz REST API 개요
Zilliz REST API에는 클러스터, 컬렉션, 벡터 데이터를 관리하기 위한 메서드가 있습니다. 여기서는 마지막 두 범주, 즉 데이터를 저장할 컬렉션 생성과 컬렉션 내부 데이터 관리에 집중하겠습니다.
컬렉션 작업에는 다음이 포함됩니다:
목록
생성
설명
삭제
벡터 작업에는 다음이 포함됩니다:
쿼리
가져오기
삽입
삭제
검색
API 호출 구성 요소
모든 API 엔드포인트의 첫 번째 부분은 위에서 복사한 클러스터의 공용 엔드포인트이며, 그 뒤에 API 버전과 API 메서드의 최상위 디렉터리인 /vector/가 옵니다.
예를 들어, 제 클러스터의 URL은 다음으로 시작했습니다:
https://in03-75204f04fc4368d.api.gcp-us-west1.zillizcloud.com/v1/vector
예제 호출에서는 클러스터의 호스트 이름에 대한 자리 표시자로 $PUBLIC_ENDPOINT를 사용합니다.
각 API 호출에는 두 개의 헤더가 필요합니다:
content_type - 이는 항상 application/json입니다. 이는 사용자가 보내는 모든 데이터가 JSON임을 웹 서버에 알려줍니다.
Authorization - 모든 요청에는 API 키가 포함된 이 헤더가 필요합니다.
예제 호출에서는 클러스터의 호스트 이름에 대한 자리 표시자로 $YOUR_API_KEY를 사용합니다.
컬렉션부터 시작해 보겠습니다.
Zilliz API 시작하기
컬렉션 생성, 설명, 삭제 및 나열
먼저 클러스터의 컬렉션을 나열해 보겠습니다.
컬렉션 작업을 위한 엔드포인트는 /collections입니다. 여기에 GET 호출을 하면 목록이 반환됩니다.
VS Code Rest Client에서의 호출은 다음과 같습니다.
GET https://$PUBLIC_ENDPOINT/v1/vector/collections HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY
그리고 모든 헤더가 포함된 응답은 다음과 같습니다. 앞으로는 헤더를 생략하겠습니다.
HTTP/1.1 200 OK
content-type: application/json; charset=utf-8
Content-Length: 40
x-ratelimit-remaining-second: 999
x-ratelimit-limit-second: 1000
ratelimit-limit: 1000
ratelimit-remaining: 999
ratelimit-reset: 1 x-sso-plugin-version: v0.0.1
date: Mon, 10 Jul 2023 17:53:12 GMT
vary: Origin access-control-allow-origin: *
requestid: 8c5a2031-afbe-4fa2-9a28-8195e1f20357
strict-transport-security: max-age=31536000; includeSubDomains
x-content-type-options: nosniff via: 1.1 google Alt-Svc: h3=":443"; ma=2592000,h3-29=":443"; ma=2592000
Connection: close
{
  "code": 200,
   "data": [
      "medium_articles"
    ]
}
서버는 성공 코드 200과 컬렉션 이름의 벡터가 포함된 data 필드를 반환합니다.
새 컬렉션을 추가한 다음, 새 목록을 가져와 보겠습니다.
이를 위해 컬렉션을 설명하는 문서를 /collections/create에 POST합니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/collections/create HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName": "large_articles",
    "dimension": 256,
    "metricType": "L2",
    "primaryField": "id",
    "vectorField": "vector"
}
컬렉션을 설명하기 위해 다섯 개의 필드를 지정할 수 있습니다.
collectionName - 이름은 필수입니다.
dimension - 벡터 필드의 차원 수도 필수입니다.
metricType - 벡터 간 유사도를 측정하는 데 사용되는 유사도 메트릭의 유형입니다. 이 예에서 기본 메트릭 유형은 유클리드 거리를 나타내는 L2입니다.
primaryField - 기본 기본 필드는 id입니다.
vectorField - 기본 벡터 필드는 vector입니다.
성공하면 Zilliz는 200과 빈 문서로 응답합니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": {}
}
컬렉션을 다시 나열하면 두 개의 이름이 표시됩니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": [
    "medium_articles",
    "large_articles"
  ]
}
기존 컬렉션에 대한 설명을 가져올 수 있습니다. 이를 위해 collectionName을 요청 매개변수로 사용하여 GET을 보냅니다.
GET https://$PUBLIC_ENDPOINT/v1/vector/collections/describe?collectionName=medium_articles HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY
이 응답은 컬렉션의 현재 상태에 대한 자세한 설명입니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": {
    "collectionName": "medium_articles",
    "shardsNum": 2,
    "description": "demo collection",
    "load": "loaded",
    "enableDynamicField": true,
    "fields": [
      {
        "name": "id",
        "type": "int64",
        "primaryKey": true,
        "autoId": true,
        "description": ""
      },
      {
        "name": "title_vector",
        "type": "floatVector(256)",
        "primaryKey": false,
        "autoId": false,
        "description": ""
      }
    ],
    "indexes": [
      {
        "indexName": "vector_idx",
        "fieldName": "vector",
        "metricType": "L2"
      }
    ]
  }
}
마지막으로, 방금 만든 컬렉션을 삭제하며 마무리해 보겠습니다. 이는 /collections/drop에 대한 POST 요청이므로, 이름을 매개변수로 전달하는 대신 JSON 문서를 사용합니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/collections/drop HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName": "large_articles"
}
응답은 Zilliz가 컬렉션을 생성할 때 보내는 것과 비슷합니다.
HTTP/1.1 200 OK

{
"code": 200,
"data": {}
}
컬렉션 목록을 다시 요청하면 다시 하나로 돌아간 것을 볼 수 있습니다. 이제 몇 가지 데이터로 작업해 보겠습니다.
데이터 삽입
데이터를 삽입하려면 데이터를 설명하는 문서를 /insert에 POST로 보냅니다.
위에서 가져온 설명을 보면, 샘플 컬렉션에는 두 개의 필드가 있습니다.
id - 정수 값
title_vector - 768개의 float가 있는 벡터
따라서 insert 요청의 data 필드 안에 이 두 필드를 포함하는 값을 가진 문서가 필요합니다. Data는 목록이므로 둘 이상의 값을 삽입할 수 있습니다.
다음은 하나의 값이 있는 요청입니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/insert HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName":"medium_articles",
    "data": [
        {
            "id": 1,
            "title_vector": [
                    0.2109777665089908,
                    0.6424190129752343,
                    (768 values)...
                    0.9818514815450557
            ],
        },
    ]
}
이 코드를 제출하세요. 응답은 삽입된 항목 수와 해당 id입니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": {
    "insertCount": 1,
    "insertIds": [
      "1"
    ]
  }
}
데이터 쿼리, 검색 및 가져오기
Zilliz REST API에는 데이터를 가져오는 세 가지 방법이 있습니다: 쿼리, 검색, 가져오기.
벡터 쿼리는 기준을 사용해 데이터베이스의 항목을 일치시킵니다. id 필드를 기반으로 한 쿼리부터 시작해 보겠습니다.
이 쿼리에서는 검색 문서를 /query에 POST합니다. in 연산자를 사용하여 id가 1 또는 2인 항목을 일치시킵니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/query HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY
{
    "collectionName": "medium_articles",
    "filter": "id in (1, 2)"
}
Milvus는 방금 삽입한 값과 샘플 컬렉션의 데이터를 함께 응답합니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": [
    {
      "id": 1,
      "title_vector": [
        0.21097776,
        0.5381259,
        0.48835102,
        0.15038285,
        0.94545513,
        (768 values)...
        ]
    },
   {
      "claps": 500,
      "id": 2,
      "link": "https://medium.com/swlh/how-can-we-best-switch-in-python-458fb33f7835",
      "publication": "The Startup",
      "reading_time": 6,
      "responses": 7,
      "title": "How Can We Best Switch in Python?",
      "title_vector": [
        0.031961977,
        0.00047043373,
        -0.018263113,
        0.027324716,
        -0.0054595284,
        -0.014779159,
        (768 values)...
      ]
   }
}
결과를 필터링하려면 outputFields를 사용할 수 있습니다.
결과의 크기를 줄이면서 몇 개의 문서를 더 쿼리해 보겠습니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/query HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName": "medium_articles",
    "filter": "id in (1, 2, 4, 99)",
    "outputFields": ["id", "publication"]
}
이 결과는 훨씬 읽기 쉽습니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": [
    {
      "id": 1,
      "publication": null
    },
    {
      "id": 2,
      "publication": "The Startup"
    },
    {
      "id": 4,
      "publication": "The Startup"
    },
    {
      "id": 99,
      "publication": "Towards Data Science"
    }
  ]
}
벡터 검색은 벡터 필드에 대한 유사도 검색을 사용하여 데이터를 찾습니다.
새 값을 삽입할 때 사용한 것과 동일한 값을 사용하여 검색을 제출해 보겠습니다.
Search는 쿼리와 동일한 filter 및 outputFields 필드와 함께, 검색 기준을 위한 vector 필드, 검색 결과에 대한 limit, 그리고 offset을 지원합니다. offset을 생략하면 하나 이상의 일치 항목을 얻습니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/search HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName": "medium_articles",
    "filter": "id in (1,2,3,4,5,6,7,8,9,99)",
    "limit": 5,
    "outputFields": ["id", "publication"],
    "vector": [
                    0.2109777665089908,
                    0.0375565730811388,
                    0.6424190129752343,
                    0.9818514815450557,
                    0.10598735548499805,
                    ...
              ]
    }
}
검색을 다섯 개의 값으로 제한했으므로 결과는 다음과 같습니다. 새 항목을 추가할 때 사용한 값에 따라 결과는 달라질 수 있습니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": [
    {
      "distance": 0,
      "id": 1,
      "publication": null
    },
    {
      "distance": 211.61267,
      "id": 2,
      "publication": "The Startup"
    },
    {
      "distance": 211.71194,
      "id": 5,
      "publication": "The Startup"
    },
    {
      "distance": 211.719,
      "id": 6,
      "publication": "The Startup"
    },
    {
      "distance": 211.9408,
      "id": 7,
      "publication": "The Startup"
    }
  ]
}
마지막으로, ids 목록을 /get에 게시하여 벡터를 가져올 수 있습니다. 이 get 요청은 위의 쿼리와 동일한 결과를 반환합니다.
POST https://$PUBLIC_ENDPOINT/v1/vector/get HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName": "medium_articles",
    "id": [1, 2, 4, 99],
    "outputFields": ["id", "publication"]
}
데이터 삭제
마지막 작업은 벡터 삭제입니다. get과 마찬가지로 delete는 id 필드를 사용합니다. 데이터베이스에서 해당 항목을 제거하려면 ids 목록을 /delete에 게시하세요.
POST https://$PUBLIC_ENDPOINT/v1/vector/delete HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY

{
    "collectionName": "medium_articles",
    "id": [1]
}
결과는 빈 문서입니다.
HTTP/1.1 200 OK

{
  "code": 200,
  "data": {}
}
id를 검색하여 삭제되었는지 확인해 보세요.
POST https://$PUBLIC_ENDPOINT/v1/vector/get HTTP/1.1
content-type: application/json
Authorization: Bearer $YOUR_API_KEY
{
    "collectionName": "medium_articles",
    "id": [1],
    "outputFields": ["id", "publication"]
}
Milvus는 빈 결과 집합을 반환합니다.
결론
이번 게시물에서는 Zilliz Cloud를 사용하여 Milvus 클러스터를 생성한 다음 Zilliz REST API를 사용하여 쿼리하는 방법을 다뤘습니다. 컬렉션을 생성, 나열, 제거하는 방법과 Zilliz Cloud 및 Milvus 클러스터를 위해 생성되는 REST 엔드포인트를 통해 데이터를 조작하는 방법을 살펴보았습니다.
이제 Zilliz Cloud로 Milvus를 배포하고 사용하는 것이 얼마나 쉬운지 확인하셨으니, 무료 계정에 가입하고 오늘 바로 시작해 보세요!
계속 읽기
A Developer's Guide to Exploring Milvus 2.6 Features on Zilliz Cloud
Milvus 2.6 marks a shift from “vector search + glue code” to a more advanced retrieval engine, and it is now Generally Available (GA) on Zilliz Cloud (a managed Milvus service).
Zilliz Cloud Update: Tiered Storage, Business Critical Plan, Cross-Region Backup, and Pricing Changes
This release offers a rebuilt tiered storage with lower costs, a new Business Critical plan for enhanced security, and pricing updates, among other features.
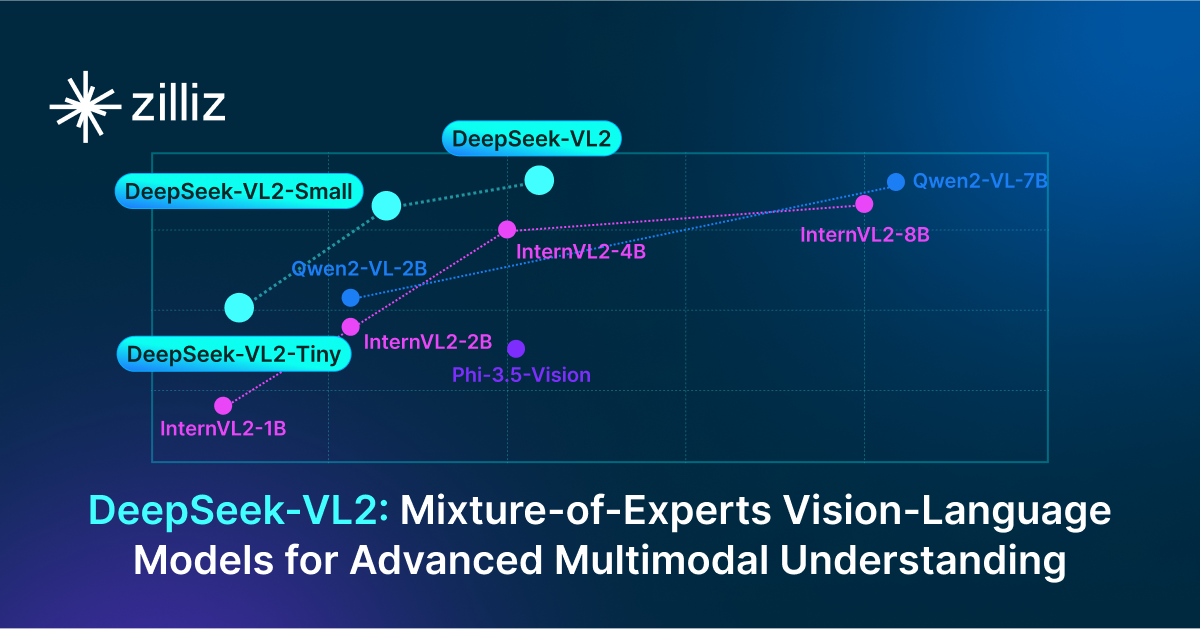
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.