Desmitificando la herramienta de dimensionamiento de Milvus
Introducción
Seleccionar la configuración óptima para tu despliegue de Milvus es fundamental para optimizar el rendimiento, utilizar los recursos de manera eficiente y gestionar los costos. Ya sea que estés construyendo un prototipo o planificando un despliegue en producción, dimensionar correctamente tu instancia de Milvus puede marcar la diferencia entre una base de datos vectorial que funciona sin problemas y una que tiene dificultades de rendimiento o genera costos innecesarios.
Para simplificar este proceso, hemos renovado nuestra Herramienta de dimensionamiento de Milvus, una calculadora fácil de usar que genera estimaciones de recursos recomendadas en función de tus requisitos específicos. En esta guía, te mostraremos cómo usar la herramienta y proporcionaremos información más detallada sobre los factores que influyen en el rendimiento de Milvus.
Cómo usar la Herramienta de dimensionamiento de Milvus
Es muy fácil usar esta herramienta de dimensionamiento. Simplemente sigue los siguientes pasos.
Visita la página de la Herramienta de dimensionamiento de Milvus.
Introduce tus parámetros clave:
Número de vectores y dimensiones por vector
Tipo de índice
Tamaño de datos de campos escalares
Tamaño de segmento
Tu modo de despliegue preferido
Revisa las recomendaciones de recursos generadas
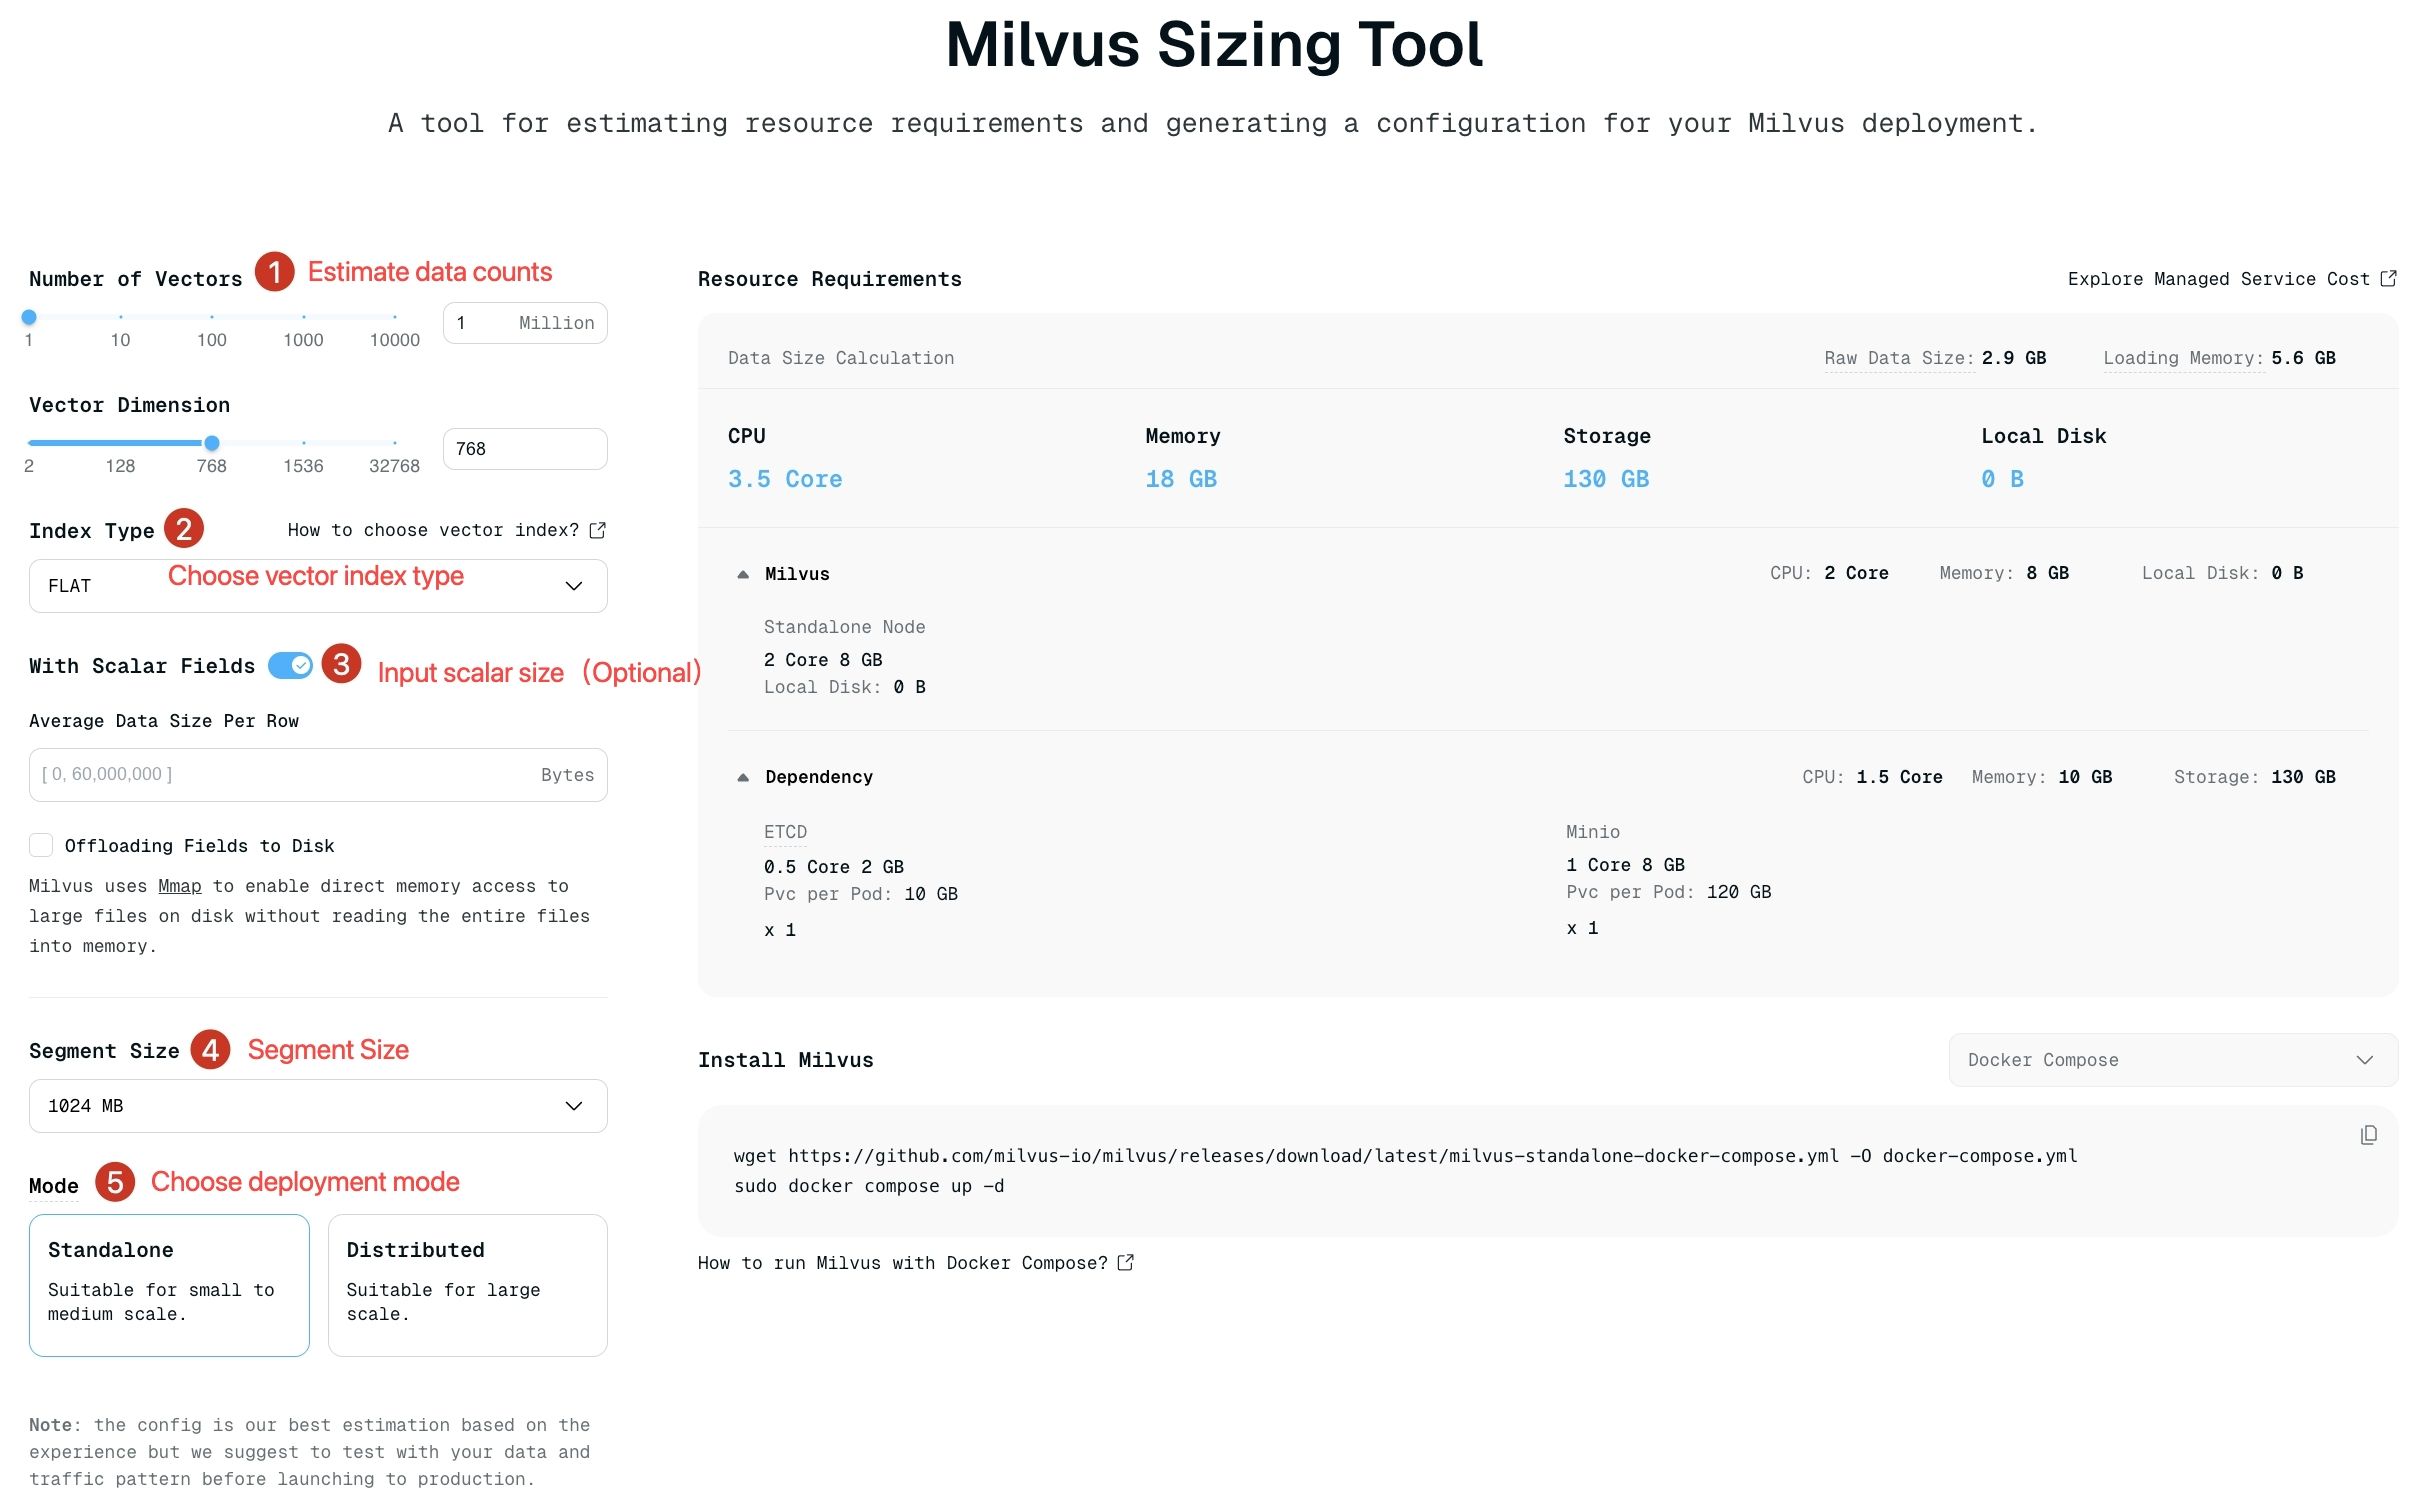 herramienta de dimensionamiento de milvus
Exploremos cómo cada uno de estos parámetros afecta a tu despliegue de Milvus.
Selección de índices: equilibrio entre almacenamiento, costo, precisión y velocidad
Milvus ofrece varios algoritmos de índice, incluidos HNSW, FLAT, IVF_FLAT, IVF_SQ8, ScaNN, DiskANN, y más, cada uno con distintas compensaciones en uso de memoria, requisitos de espacio en disco, velocidad de consulta y precisión de búsqueda.
Esto es lo que necesitas saber sobre las opciones más comunes:
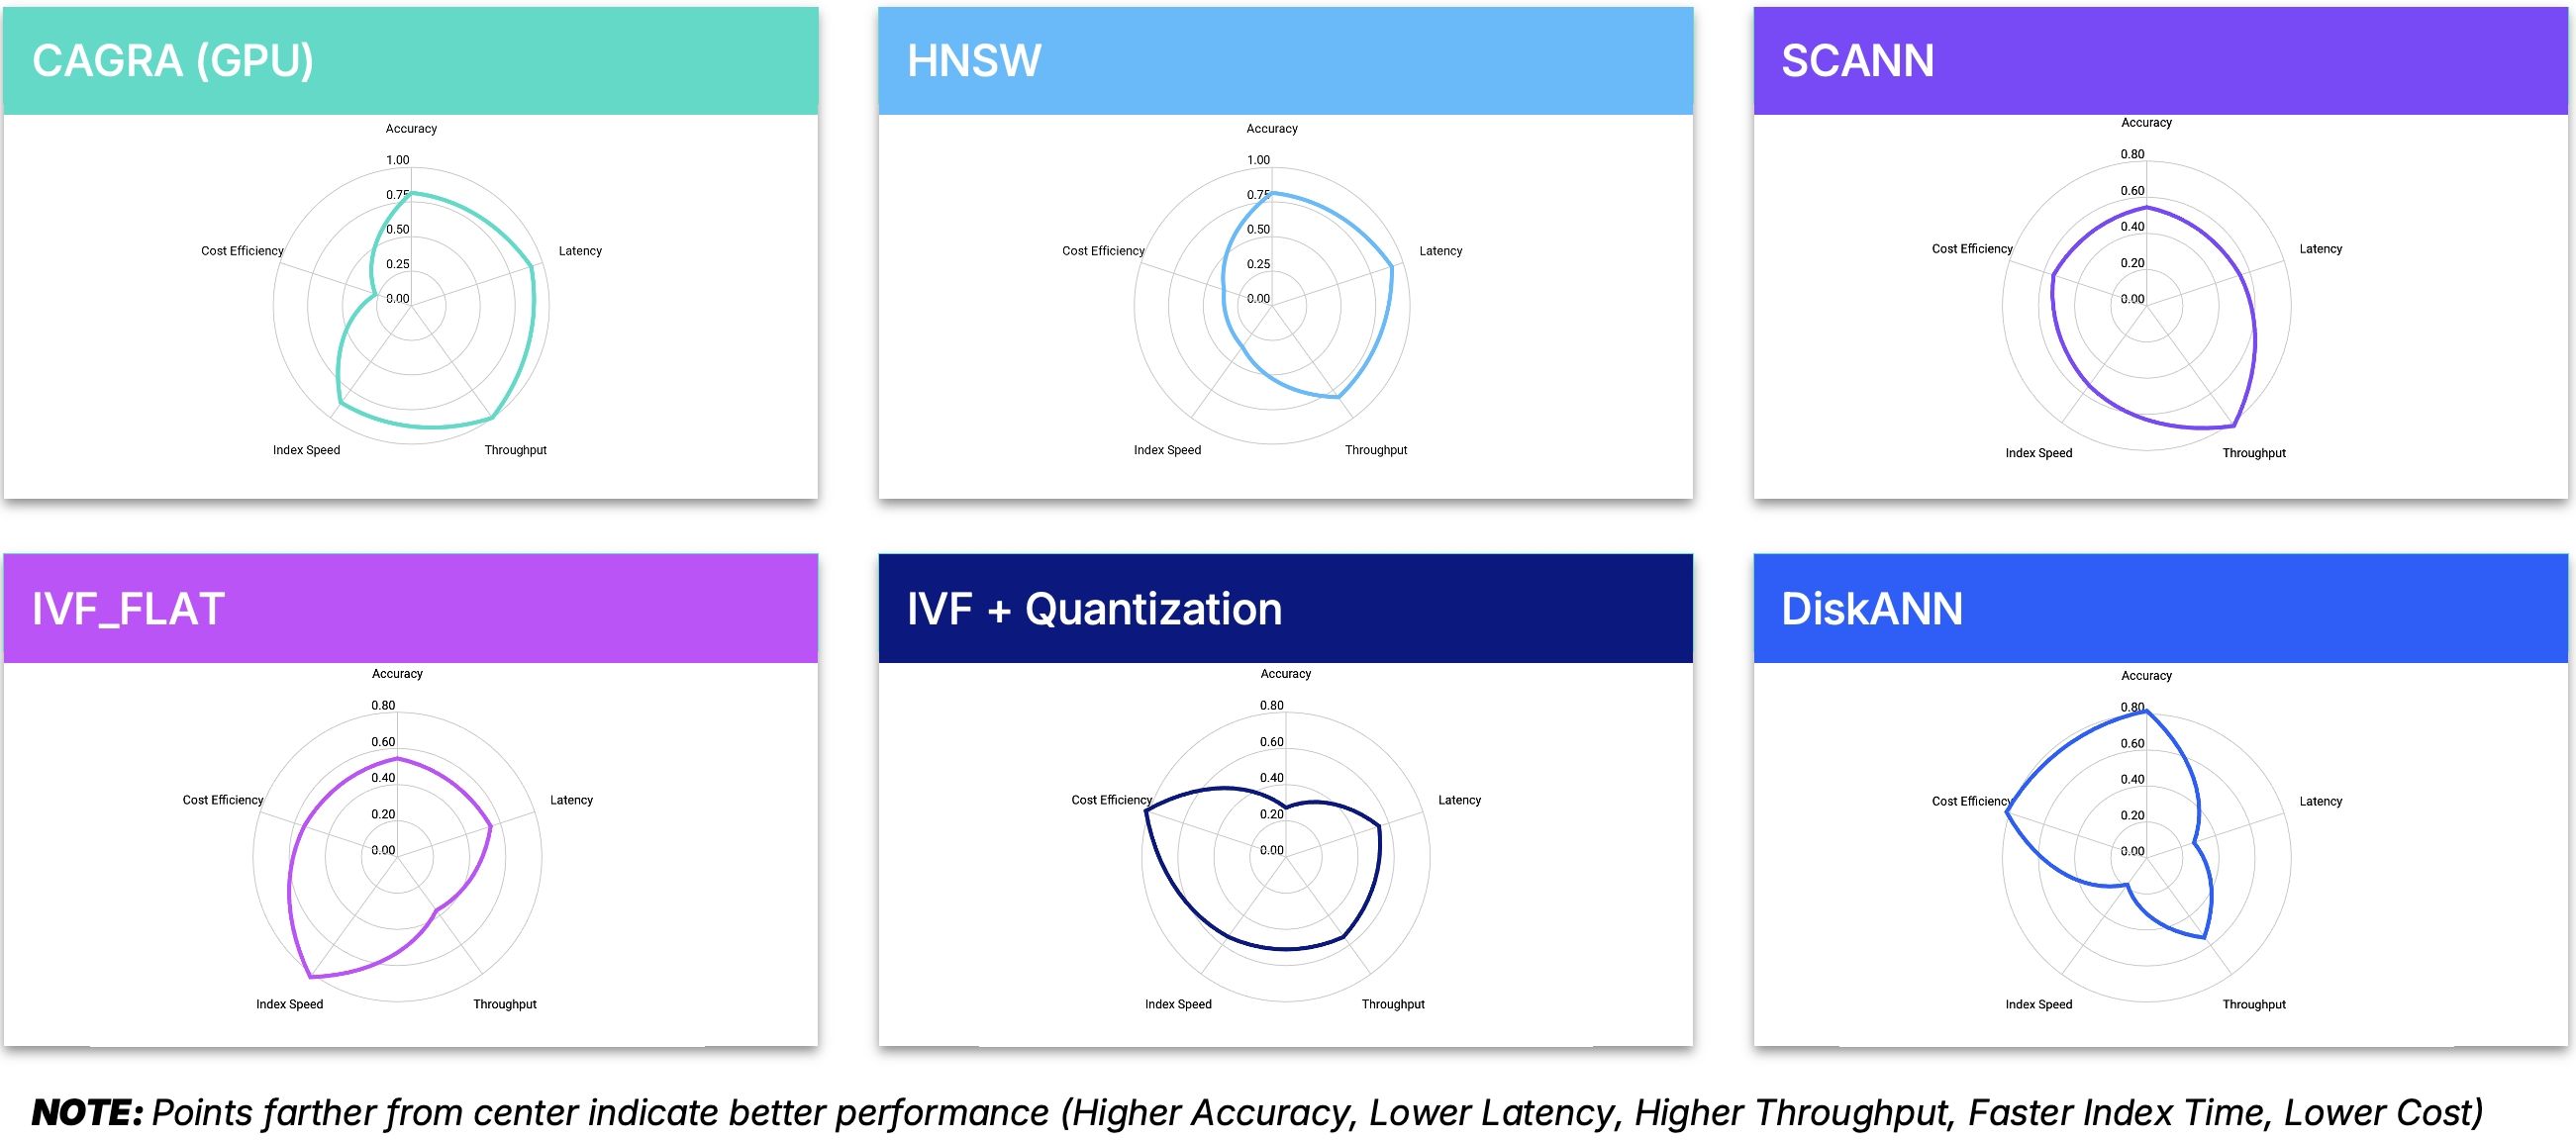 índice
HNSW (Hierarchical Navigable Small World)
Arquitectura: Combina listas de salto con grafos Navigable Small Worlds (NSWs) en una estructura jerárquica
Rendimiento: Consultas muy rápidas con excelentes tasas de recall
Uso de recursos: Requiere la mayor cantidad de memoria por vector (costo más alto)
Ideal para: Aplicaciones donde la velocidad y la precisión son críticas y las restricciones de memoria son menos preocupantes
Nota técnica: La búsqueda comienza en la capa superior con menos nodos y atraviesa hacia abajo capas cada vez más densas
FLAT
Arquitectura: Búsqueda exhaustiva simple sin aproximación
Rendimiento: 100% de recall, pero tiempos de consulta extremadamente lentos (
O(n)para un tamaño de datosn)Uso de recursos: El tamaño del índice es igual al tamaño de los datos vectoriales sin procesar
Ideal para: Conjuntos de datos pequeños o aplicaciones que requieren recall perfecto
Nota técnica: Realiza cálculos completos de distancia entre el vector de consulta y cada vector de la base de datos
IVF_FLAT
Arquitectura: Divide el espacio vectorial en clústeres para una búsqueda más eficiente
Rendimiento: Recall medio-alto con velocidad de consulta moderada (más lento que HNSW pero más rápido que FLAT)
Uso de recursos: Requiere menos memoria que FLAT pero más que HNSW
Ideal para: Aplicaciones equilibradas donde parte del recall puede intercambiarse por un mejor rendimiento
Nota técnica: Durante la búsqueda, solo se examinan
nlistclústeres, lo que reduce significativamente el cálculo
IVF_SQ8
Arquitectura: Aplica cuantización escalar a IVF_FLAT, comprimiendo los datos vectoriales
Rendimiento: Recall medio con velocidad de consulta medio-alta
Uso de recursos: Reduce el consumo de disco, cómputo y memoria en un 70-75% en comparación con IVF_FLAT
Ideal para: Entornos con recursos limitados donde la precisión puede comprometerse ligeramente
Nota técnica: Comprime valores de punto flotante de 32 bits a valores enteros de 8 bits
Opciones de índice avanzadas: ScaNN, DiskANN, CAGRA, y más
Para desarrolladores con requisitos especializados, Milvus también ofrece:
ScaNN: 20% más rápido en CPU que HNSW con tasas de recall similares
DiskANN: Un índice híbrido de disco/memoria que es ideal cuando necesitas admitir una gran cantidad de vectores con alto recall y puedes aceptar una latencia ligeramente mayor (~100ms). Equilibra el uso de memoria con el rendimiento manteniendo solo parte del índice en memoria mientras el resto permanece en disco.
Índices basados en GPU:
GPU_CAGRA: Este es el más rápido de los índices GPU, pero requiere una tarjeta de inferencia con memoria GDDR en lugar de una con memoria HBM
GPU_BRUTE_FORCE: Búsqueda exhaustiva implementada en GPU
GPU_IVF_FLAT: Versión acelerada por GPU de IVF_FLAT
GPU_IVF_PQ: Versión acelerada por GPU de IVF con Product Quantization
HNSW-PQ/SQ/PRQ:
HNSW_SQ: Consulta de muy alta velocidad, recursos de memoria limitados; acepta un compromiso menor en la tasa de recall.
HNSW_PQ: Consulta de velocidad media; recursos de memoria muy limitados; acepta un compromiso menor en la tasa de recall
HNSW_PRQ: Consulta de velocidad media; recursos de memoria muy limitados; acepta un compromiso menor en la tasa de recall
AUTOINDEX: Usa HNSW de forma predeterminada en Milvus de código abierto (o usa índices propietarios de mayor rendimiento en Zilliz Cloud, el Milvus administrado).
Índices binarios, dispersos y otros especializados: Para tipos de datos y casos de uso específicos. Consulta esta página de documentación de índices para obtener más detalles.
Tamaño de segmento y configuración de despliegue
Los segmentos son los bloques de construcción fundamentales de la organización interna de datos de Milvus. Funcionan como fragmentos de datos que permiten la búsqueda distribuida y el balanceo de carga en todo tu despliegue. Esta herramienta de dimensionamiento de Milvus ofrece tres opciones de tamaño de segmento (512 MB, 1024 MB, 2048 MB), con 1024 MB como valor predeterminado.
Comprender los segmentos es crucial para la optimización del rendimiento. Como guía general:
Segmentos de 512 MB: mejores para nodos de consulta con 4-8 GB de memoria
Segmentos de 1 GB: óptimos para nodos de consulta con 8-16 GB de memoria
Segmentos de 2 GB: recomendados para nodos de consulta con >16 GB de memoria
Información para desarrolladores: Menos segmentos y de mayor tamaño suelen ofrecer un rendimiento de búsqueda más rápido. Para despliegues a gran escala, los segmentos de 2 GB a menudo proporcionan el mejor equilibrio entre eficiencia de memoria y velocidad de consulta.
Selección del sistema de cola de mensajes
Al elegir entre Pulsar y Kafka como tu sistema de mensajería:
Pulsar: Recomendado para proyectos nuevos debido a una menor sobrecarga por tema y mejor escalabilidad
Kafka: Puede ser preferible si ya cuentas con experiencia o infraestructura de Kafka en tu organización
Optimizaciones empresariales en Zilliz Cloud
Para despliegues de producción con requisitos estrictos de rendimiento, Zilliz Cloud (la versión totalmente administrada y empresarial de Milvus en la nube) ofrece optimizaciones adicionales en indexación y cuantización:
Prevención de falta de memoria (OOM): Gestión de memoria sofisticada para prevenir fallos por falta de memoria
Optimización de compactación: Mejora el rendimiento de búsqueda y la utilización de recursos
Almacenamiento por niveles: Gestiona eficientemente los datos calientes y fríos con unidades de cómputo adecuadas
Unidades de cómputo estándar (CUs) para datos de acceso frecuente
CUs de almacenamiento por niveles para el almacenamiento rentable de datos de acceso poco frecuente
Para opciones detalladas de dimensionamiento empresarial, visita la documentación de planes de servicio de Zilliz Cloud.
Consejos de configuración avanzada para desarrolladores
Múltiples tipos de índice: La herramienta de dimensionamiento se centra en un solo índice. Para aplicaciones complejas que requieren diferentes algoritmos de índice para varias colecciones, crea colecciones separadas con configuraciones personalizadas.
Asignación de memoria: Al planificar tu implementación, ten en cuenta tanto los datos vectoriales como los requisitos de memoria del índice. HNSW normalmente requiere entre 2 y 3 veces la memoria de los datos vectoriales sin procesar.
Pruebas de rendimiento: Antes de finalizar tu configuración, evalúa tus patrones de consulta específicos en un conjunto de datos representativo.
Consideraciones de escala: Ten en cuenta el crecimiento futuro. Es más fácil empezar con un poco más de recursos que reconfigurar más adelante.
Conclusión
La herramienta de dimensionamiento de Milvus proporciona un excelente punto de partida para la planificación de recursos, pero recuerda que cada aplicación tiene requisitos únicos. Para un rendimiento óptimo, querrás ajustar tu configuración en función de las características específicas de tu carga de trabajo, los patrones de consulta y las necesidades de escalado.
Mejoramos continuamente nuestras herramientas y documentación en función de los comentarios de los usuarios. Si tienes preguntas o necesitas más ayuda para dimensionar tu implementación de Milvus, ponte en contacto con nuestra comunidad en GitHub o Discord.
Referencias
 Fendy Feng
 is the Technical Marketing Writer at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Ken Zhang
 is a Senior Product Manager at Zilliz, leading the development of the Milvus vector database by setting its strategic direction and key features. Prior to Zilliz, he served as a kernel engineer at SAP HANA and enhanced his product management skills at PingCAP. Ken holds a master's degree from Fudan University and has over eight years of experience specializing in database development and big data infrastructure management.
Sigue leyendo
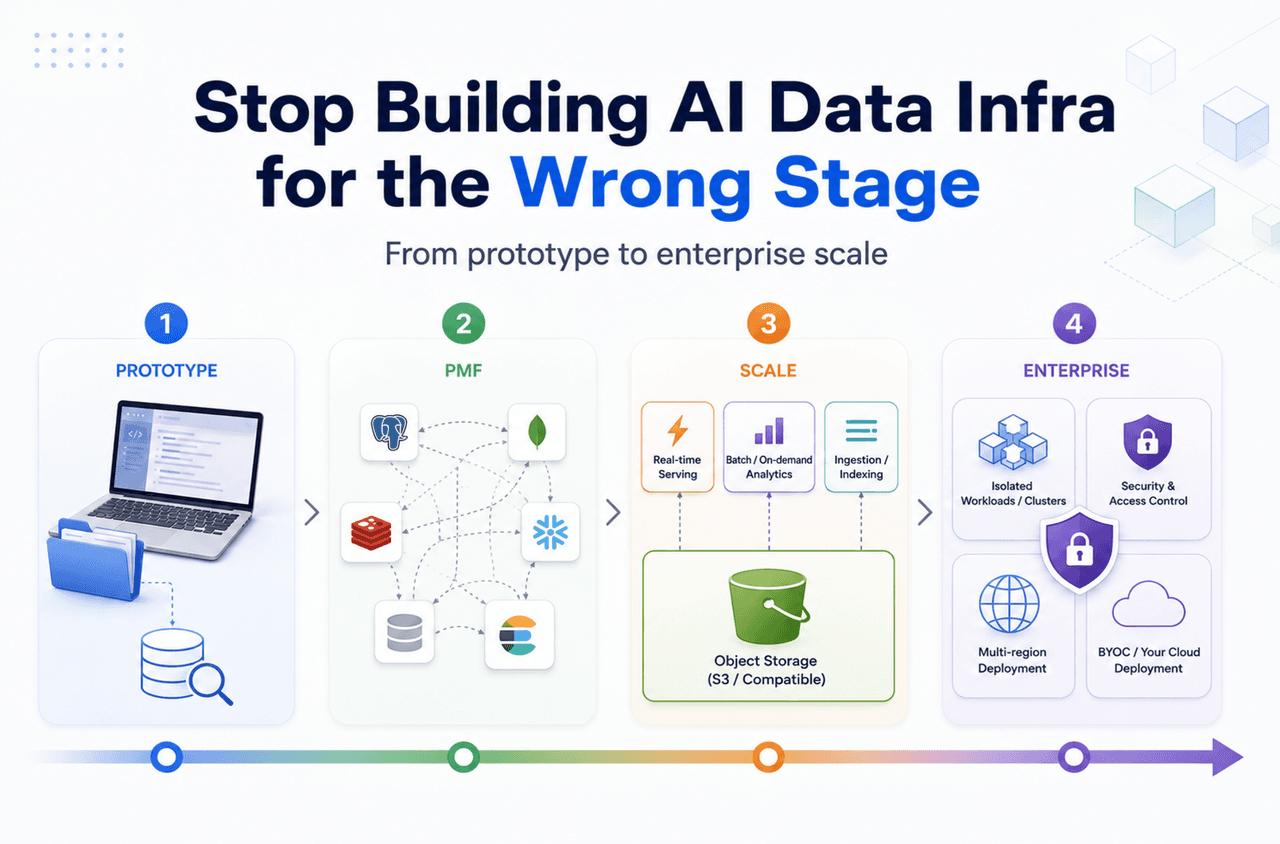
Stop Building AI Data Infra for the Wrong Stage
Learn how AI data infrastructure should evolve from prototype to enterprise scale, and when Vector Lakebase becomes the right architecture for AI apps.
Why AI Databases Don't Need SQL
Whether you like it or not, here's the truth: SQL is destined for decline in the era of AI.
Building RAG Pipelines for Real-Time Data with Cloudera and Milvus
explore how Cloudera can be integrated with Milvus to effectively implement some of the key functionalities of RAG pipelines.