




Desmistificando a Ferramenta de Dimensionamento do Milvus
Introdução
Selecionar a configuração ideal para sua implantação do Milvus é essencial para a otimização de desempenho, a utilização eficiente de recursos e o gerenciamento de custos. Seja criando um protótipo ou planejando uma implantação em produção, dimensionar corretamente sua instância do Milvus pode significar a diferença entre um banco de dados vetorial funcionando sem problemas e um que enfrenta dificuldades de desempenho ou gera custos desnecessários.
Para simplificar esse processo, reformulamos nossa Ferramenta de Dimensionamento do Milvus, uma calculadora fácil de usar que gera estimativas recomendadas de recursos com base em seus requisitos específicos. Neste guia, vamos mostrar como usar a ferramenta e fornecer insights mais aprofundados sobre os fatores que influenciam o desempenho do Milvus.
Como usar a Ferramenta de Dimensionamento do Milvus
É muito fácil usar esta ferramenta de dimensionamento. Basta seguir os passos abaixo.
Insira seus principais parâmetros:
Número de vetores e dimensões por vetor
Tipo de índice
Tamanho dos dados do campo escalar
Tamanho do segmento
Seu modo de implantação preferido
Analise as recomendações de recursos geradas
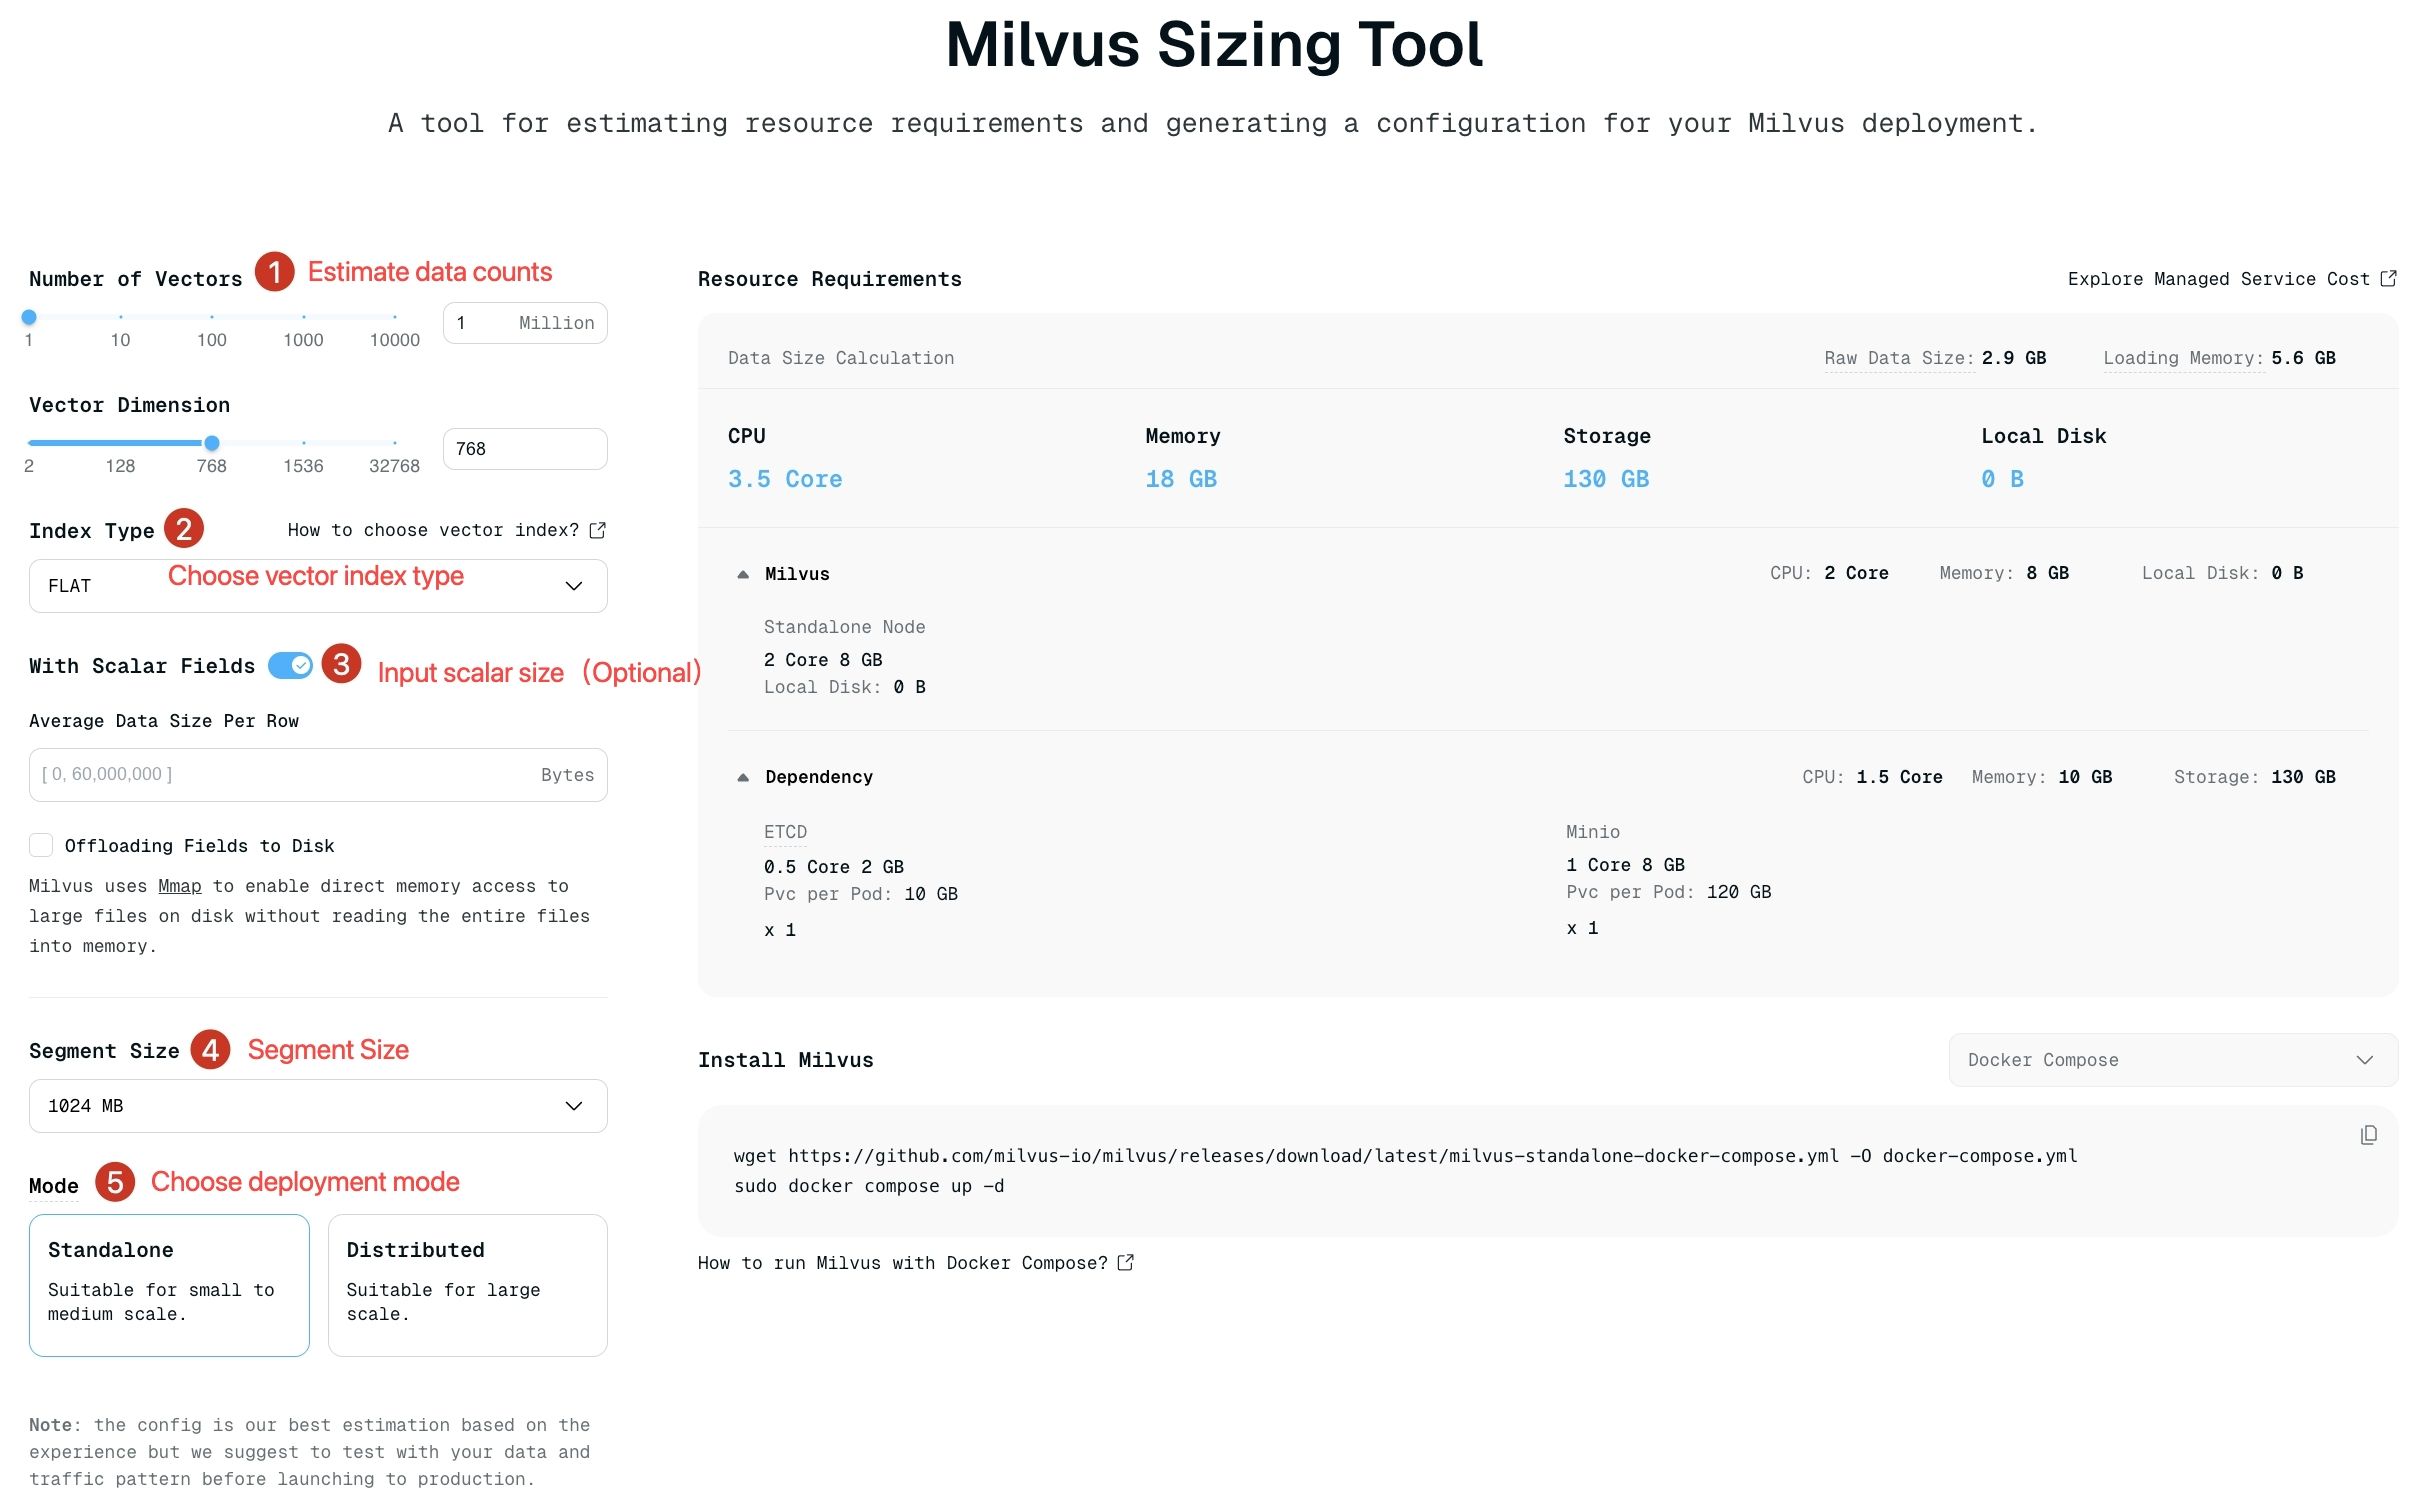 ferramenta de dimensionamento do milvus
Vamos explorar como cada um desses parâmetros impacta sua implantação do Milvus.
Seleção de Índice: Equilibrando Armazenamento, Custo, Precisão e Velocidade
O Milvus oferece vários algoritmos de índice, incluindo HNSW, FLAT, IVF_FLAT, IVF_SQ8, ScaNN, DiskANN e outros, cada um com diferentes compensações em uso de memória, requisitos de espaço em disco, velocidade de consulta e precisão de busca.
Aqui está o que você precisa saber sobre as opções mais comuns:
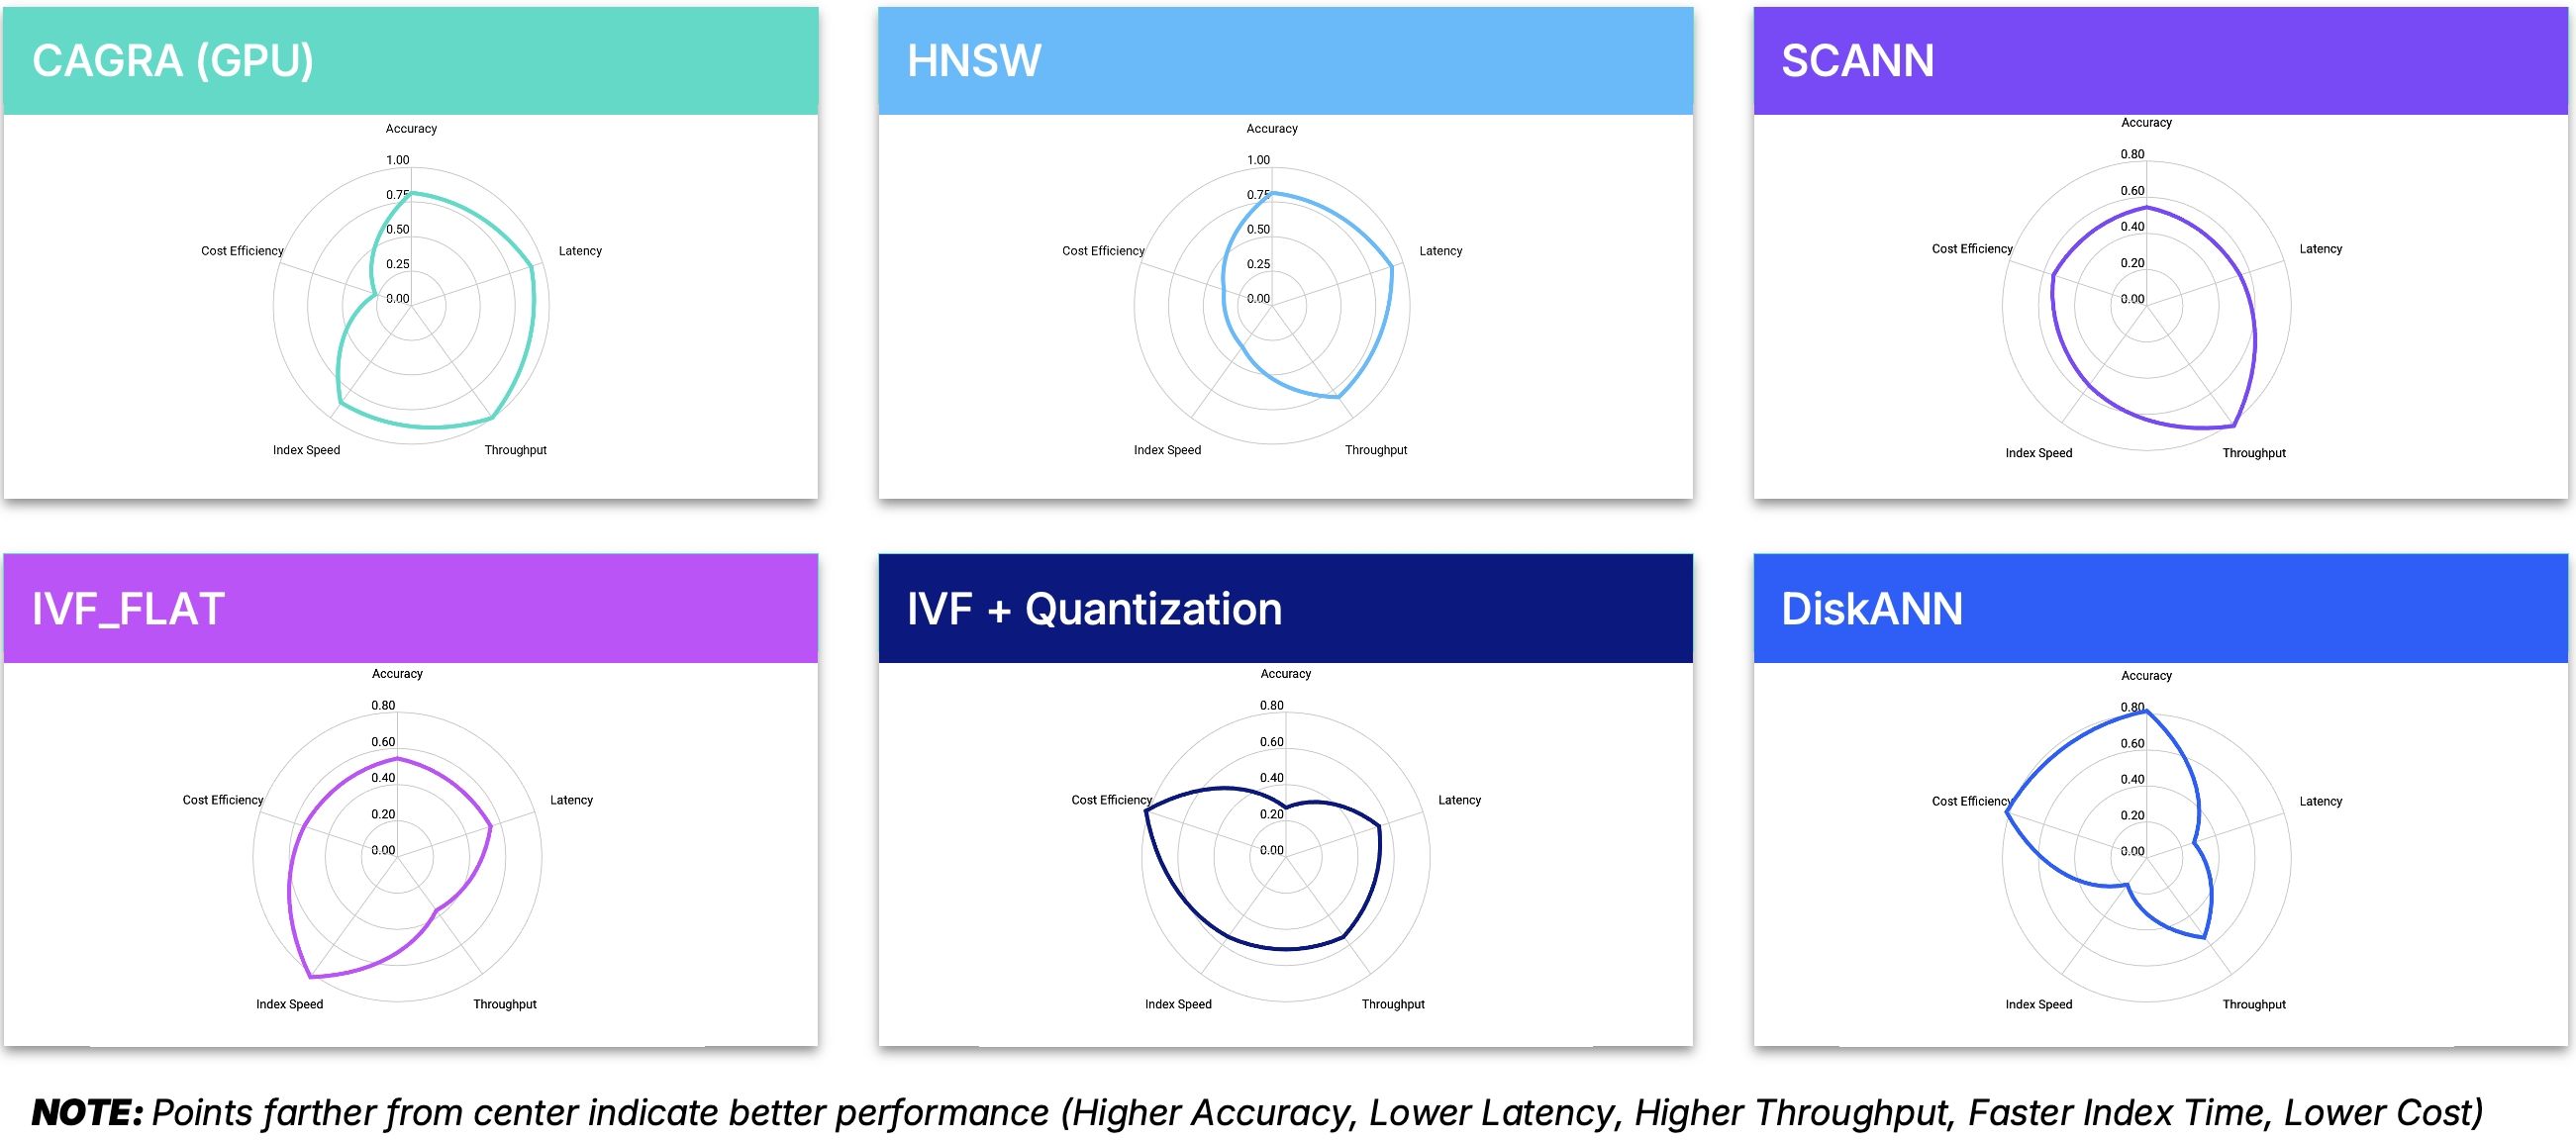 índice
HNSW (Hierarchical Navigable Small World)
Arquitetura: Combina listas de saltos com grafos Navigable Small Worlds (NSWs) em uma estrutura hierárquica
Desempenho: Consultas muito rápidas com excelentes taxas de recall
Uso de Recursos: Requer a maior quantidade de memória por vetor (custo mais alto)
Ideal Para: Aplicações em que velocidade e precisão são críticas e restrições de memória são uma preocupação menor
Nota Técnica: A busca começa na camada superior, com o menor número de nós, e percorre para baixo por camadas cada vez mais densas
FLAT
Arquitetura: Busca exaustiva simples sem aproximação
Desempenho: 100% de recall, mas tempos de consulta extremamente lentos (
O(n)para tamanho de dadosn)Uso de Recursos: O tamanho do índice é igual ao tamanho dos dados vetoriais brutos
Ideal Para: Pequenos conjuntos de dados ou aplicações que exigem recall perfeito
Nota Técnica: Realiza cálculos completos de distância entre o vetor de consulta e todos os vetores no banco de dados
IVF_FLAT
Arquitetura: Divide o espaço vetorial em clusters para uma busca mais eficiente
Desempenho: Recall médio-alto com velocidade de consulta moderada (mais lento que HNSW, mas mais rápido que FLAT)
Uso de Recursos: Requer menos memória que FLAT, mas mais que HNSW
Ideal Para: Aplicações equilibradas em que parte do recall pode ser trocada por melhor desempenho
Nota Técnica: Durante a busca, apenas
nlistclusters são examinados, reduzindo significativamente a computação
IVF_SQ8
Arquitetura: Aplica quantização escalar ao IVF_FLAT, comprimindo dados vetoriais
Desempenho: Recall médio com velocidade de consulta média-alta
Uso de Recursos: Reduz o consumo de disco, computação e memória em 70-75% em comparação com IVF_FLAT
Ideal Para: Ambientes com recursos limitados nos quais a precisão pode ser ligeiramente comprometida
Nota Técnica: Comprime valores de ponto flutuante de 32 bits para valores inteiros de 8 bits
Opções Avançadas de Índice: ScaNN, DiskANN, CAGRA e mais
Para desenvolvedores com requisitos especializados, o Milvus também oferece:
ScaNN: 20% mais rápido em CPU do que HNSW com taxas de recall semelhantes
DiskANN: Um índice híbrido de disco/memória que é ideal quando você precisa oferecer suporte a um grande número de vetores com alto recall e pode aceitar uma latência um pouco maior (~100ms). Ele equilibra o uso de memória com o desempenho mantendo apenas parte do índice na memória, enquanto o restante permanece em disco.
Índices baseados em GPU:
GPU_CAGRA: Este é o mais rápido dos índices de GPU, mas requer uma placa de inferência com memória GDDR em vez de uma com memória HBM
GPU_BRUTE_FORCE: Busca exaustiva implementada em GPU
GPU_IVF_FLAT: Versão acelerada por GPU do IVF_FLAT
GPU_IVF_PQ: Versão acelerada por GPU do IVF com Product Quantization
HNSW-PQ/SQ/PRQ:
HNSW_SQ: Consulta de velocidade muito alta, recursos de memória limitados; aceita pequeno comprometimento na taxa de recall.
HNSW_PQ: Consulta de velocidade média; recursos de memória muito limitados; aceita pequeno comprometimento na taxa de recall
HNSW_PRQ: Consulta de velocidade média; recursos de memória muito limitados; aceita pequeno comprometimento na taxa de recall
AUTOINDEX: Usa HNSW por padrão no Milvus open-source (ou usa índices proprietários de maior desempenho no Zilliz Cloud, o Milvus gerenciado).
Índices binários, esparsos e outros índices especializados: Para tipos de dados e casos de uso específicos. Consulte esta página de documentação de índices para mais detalhes.
Tamanho do segmento e configuração de implantação
Segmentos são os blocos fundamentais da organização interna de dados do Milvus. Eles funcionam como partes de dados que permitem busca distribuída e balanceamento de carga em sua implantação. Esta ferramenta de dimensionamento do Milvus oferece três opções de tamanho de segmento (512 MB, 1024 MB, 2048 MB), com 1024 MB como padrão.
Entender segmentos é crucial para a otimização de desempenho. Como diretriz geral:
Segmentos de 512 MB: Melhores para nós de consulta com 4-8 GB de memória
Segmentos de 1 GB: Ideais para nós de consulta com 8-16 GB de memória
Segmentos de 2 GB: Recomendados para nós de consulta com >16 GB de memória
Insight do desenvolvedor: Menos segmentos, porém maiores, normalmente oferecem desempenho de busca mais rápido. Para implantações em larga escala, segmentos de 2 GB geralmente fornecem o melhor equilíbrio entre eficiência de memória e velocidade de consulta.
Seleção do sistema de fila de mensagens
Ao escolher entre Pulsar e Kafka como seu sistema de mensagens:
Pulsar: Recomendado para novos projetos devido à menor sobrecarga por tópico e melhor escalabilidade
Kafka: Pode ser preferível se você já tiver expertise ou infraestrutura Kafka em sua organização
Otimizações empresariais no Zilliz Cloud
Para implantações de produção com requisitos rigorosos de desempenho, o Zilliz Cloud (a versão totalmente gerenciada e empresarial do Milvus na nuvem) oferece otimizações adicionais em indexação e quantização:
Prevenção de Out of Memory (OOM): Gerenciamento sofisticado de memória para evitar falhas por falta de memória
Otimização de compactação: Melhora o desempenho de busca e a utilização de recursos
Armazenamento em camadas: Gerencie dados quentes e frios de forma eficiente com unidades de computação apropriadas
Unidades de computação padrão (CUs) para dados acessados com frequência
CUs de armazenamento em camadas para armazenamento econômico de dados raramente acessados
Para opções detalhadas de dimensionamento empresarial, visite a documentação de planos de serviço do Zilliz Cloud.
Dicas avançadas de configuração para desenvolvedores
Múltiplos tipos de índice: A ferramenta de dimensionamento se concentra em um único índice. Para aplicações complexas que exigem algoritmos de índice diferentes para várias coleções, crie coleções separadas com configurações personalizadas.
Alocação de memória: Ao planejar sua implantação, considere os requisitos de memória tanto dos dados vetoriais quanto do índice. O HNSW normalmente requer 2-3x a memória dos dados vetoriais brutos.
Testes de desempenho: Antes de finalizar sua configuração, faça benchmarks dos seus padrões de consulta específicos em um conjunto de dados representativo.
Considerações de escala: Leve em conta o crescimento futuro. É mais fácil começar com um pouco mais de recursos do que reconfigurar mais tarde.
Conclusão
A Ferramenta de Dimensionamento do Milvus fornece um excelente ponto de partida para o planejamento de recursos, mas lembre-se de que cada aplicação tem requisitos únicos. Para obter desempenho ideal, você deve ajustar sua configuração com base nas características específicas da sua carga de trabalho, nos padrões de consulta e nas necessidades de escalabilidade.
Estamos melhorando continuamente nossas ferramentas e documentação com base no feedback dos usuários. Se você tiver dúvidas ou precisar de mais assistência para dimensionar sua implantação do Milvus, entre em contato com nossa comunidade no GitHub ou no Discord.
Referências
 Fendy Feng
 is the Technical Marketing Writer at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Ken Zhang
 is a Senior Product Manager at Zilliz, leading the development of the Milvus vector database by setting its strategic direction and key features. Prior to Zilliz, he served as a kernel engineer at SAP HANA and enhanced his product management skills at PingCAP. Ken holds a master's degree from Fudan University and has over eight years of experience specializing in database development and big data infrastructure management.
Continue lendo
Zilliz Cloud On-Demand Compute: Pay Only for What You Use
The customer case behind Zilliz Cloud On-Demand: how a $10K vector search bill came down to under $500, and the engineering changes that made it possible.
From Vector Database to Vector Lakebase
Zilliz offers a fully managed Vector Lakebase powered by Milvus, unifying real-time vector search, lake-scale discovery, and Al data operations.
Zilliz Skills Breakdown: How AI Agents Master Vector Databases
Zilliz's Milvus Skill (pymilvus, 7 files) and Zilliz Cloud Skill (zilliz-cli, 14 modules) bring vector-DB dev and ops into one Claude Code session.