Demistificare lo strumento di dimensionamento Milvus
Introduzione
Selezionare la configurazione ottimale per il tuo deployment Milvus è fondamentale per l’ottimizzazione delle prestazioni, l’utilizzo efficiente delle risorse e la gestione dei costi. Che tu stia costruendo un prototipo o pianificando un deployment in produzione, dimensionare correttamente la tua istanza Milvus può fare la differenza tra un database vettoriale che funziona senza intoppi e uno che ha problemi di prestazioni o comporta costi non necessari.
Per semplificare questo processo, abbiamo rinnovato il nostro Milvus Sizing Tool, un calcolatore intuitivo che genera stime delle risorse consigliate in base ai tuoi requisiti specifici. In questa guida, ti mostreremo come utilizzare lo strumento e forniremo approfondimenti sui fattori che influenzano le prestazioni di Milvus.
Come usare il Milvus Sizing Tool
È semplicissimo usare questo strumento di dimensionamento. Basta seguire i seguenti passaggi.
Visita la pagina Milvus Sizing Tool.
Inserisci i tuoi parametri chiave:
Numero di vettori e dimensioni per vettore
Tipo di indice
Dimensione dei dati dei campi scalari
Dimensione del segmento
La tua modalità di deployment preferita
Esamina le raccomandazioni sulle risorse generate
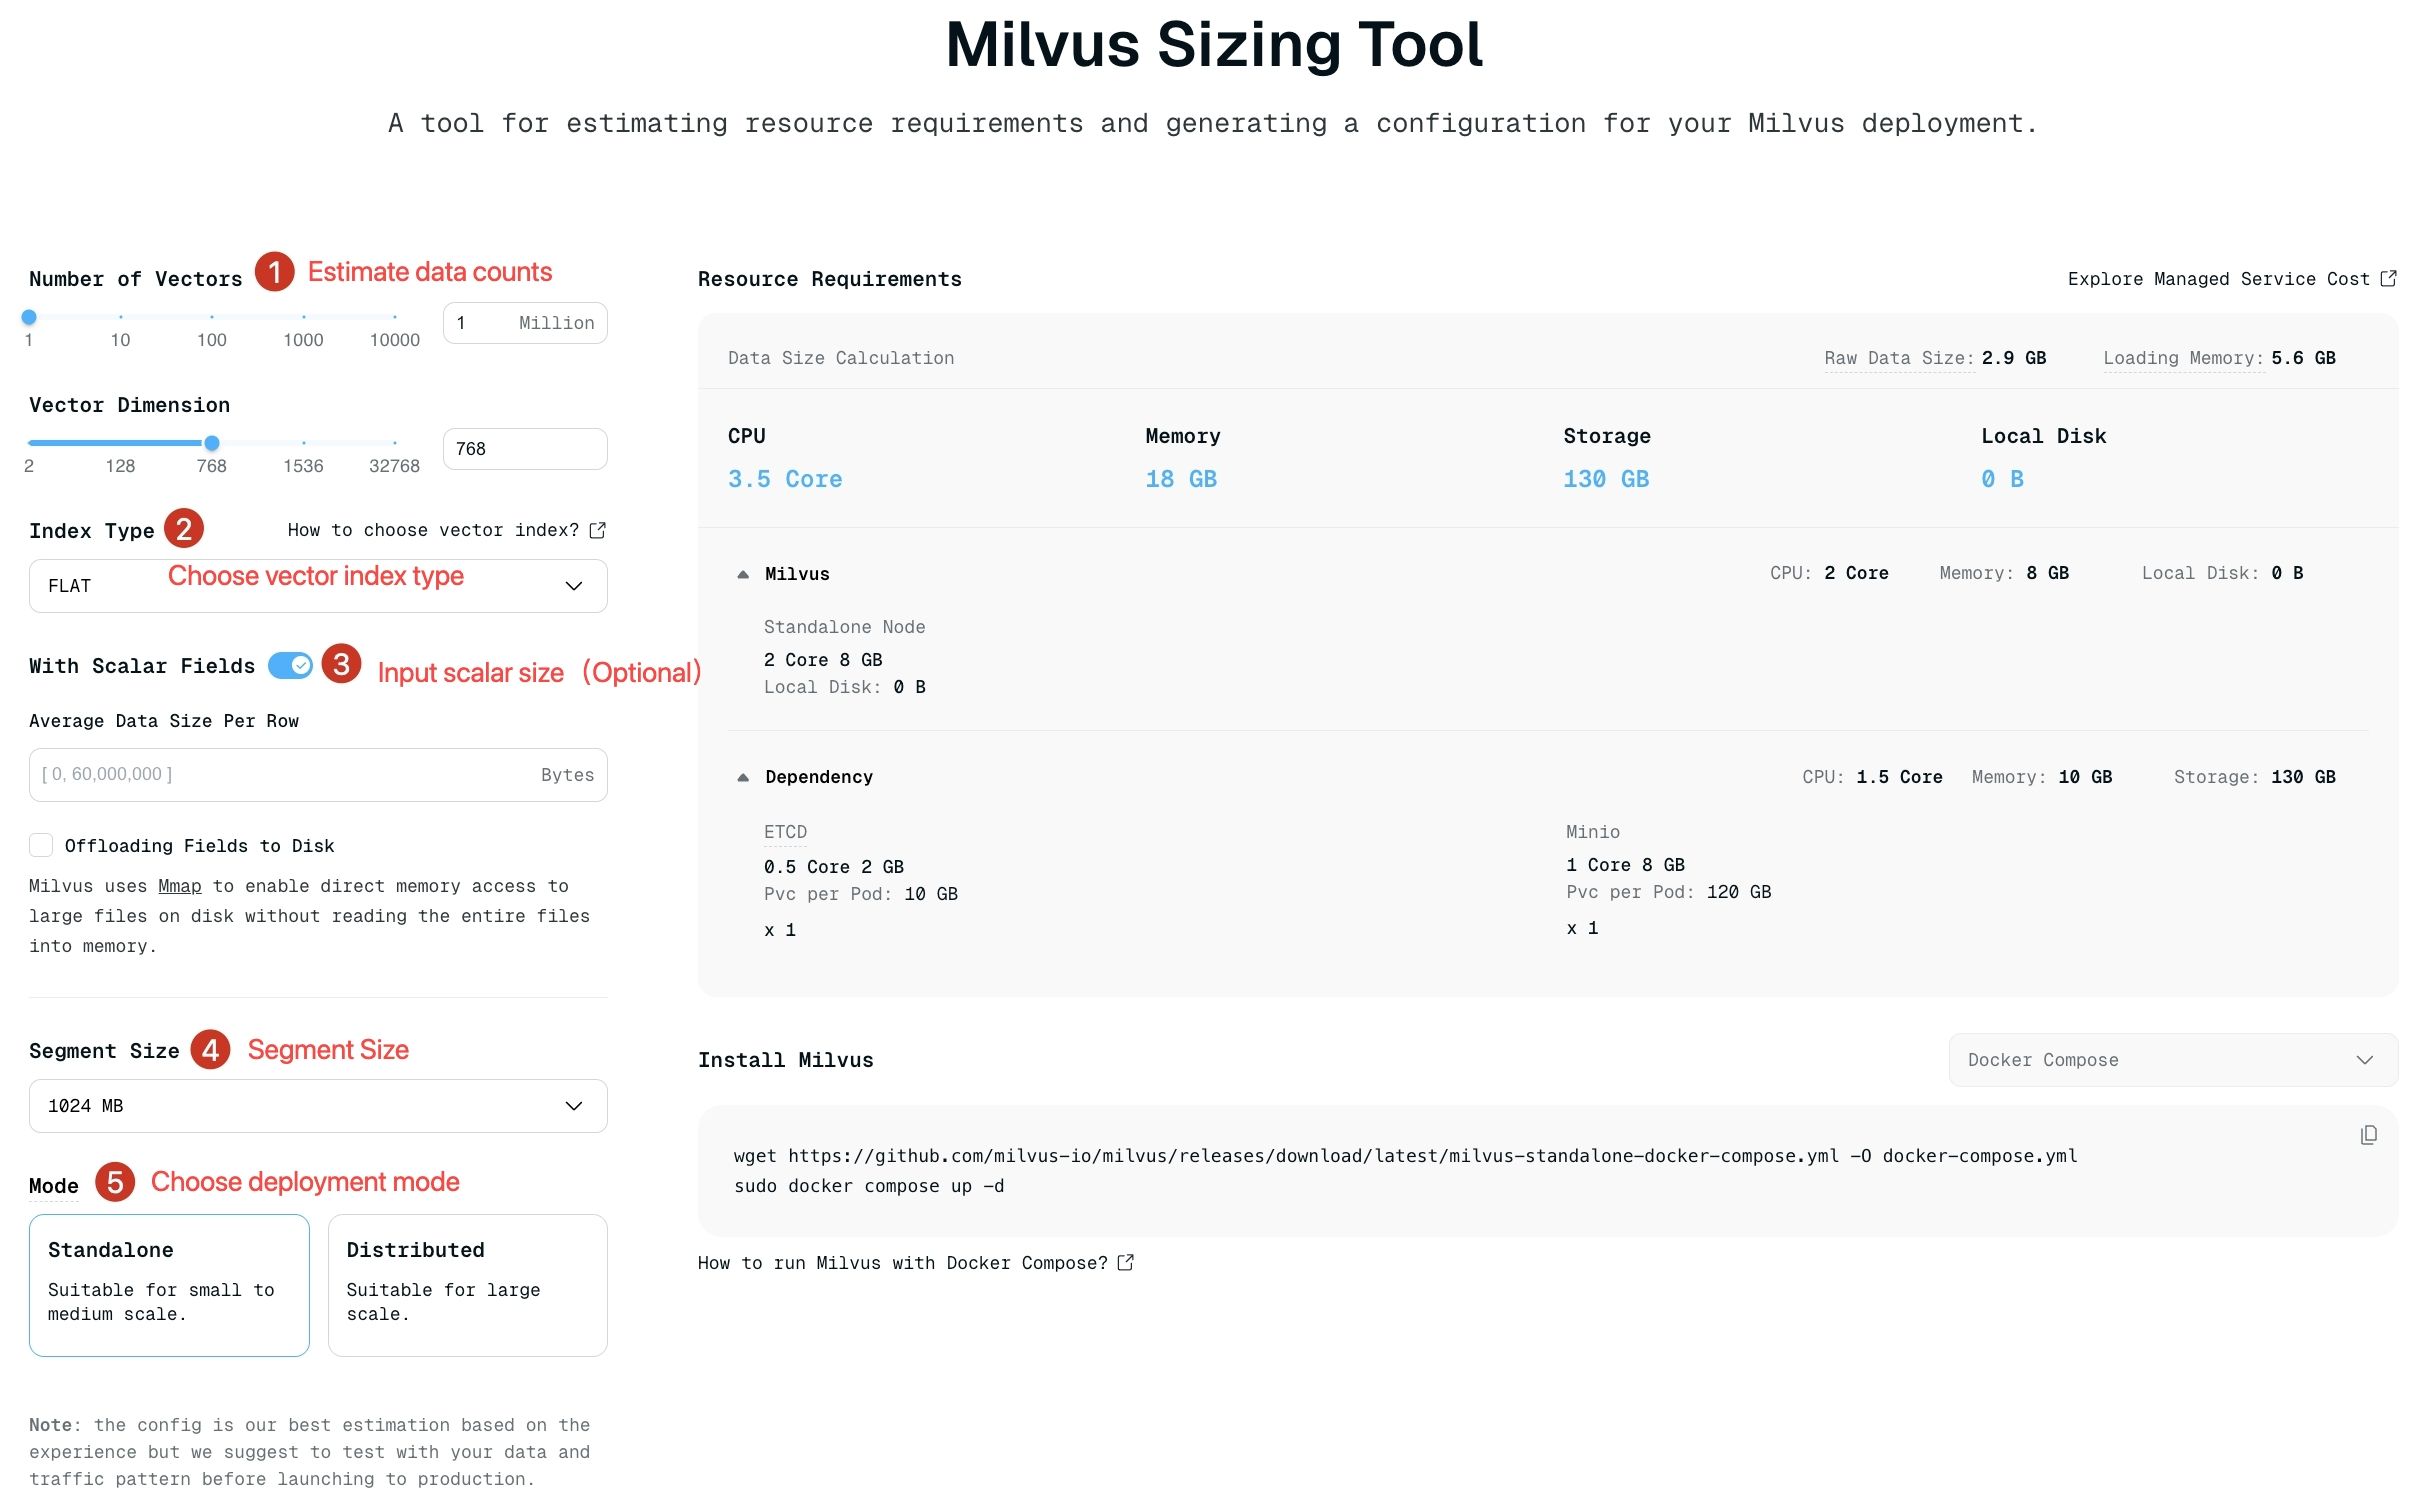 milvus sizing tool
Esploriamo come ciascuno di questi parametri influisce sul tuo deployment Milvus.
Selezione dell’indice: bilanciare storage, costo, accuratezza e velocità
Milvus offre vari algoritmi di indicizzazione, tra cui HNSW, FLAT, IVF_FLAT, IVF_SQ8, ScaNN, DiskANN e altri, ciascuno con compromessi distinti in termini di utilizzo della memoria, requisiti di spazio su disco, velocità delle query e accuratezza della ricerca.
Ecco cosa devi sapere sulle opzioni più comuni:
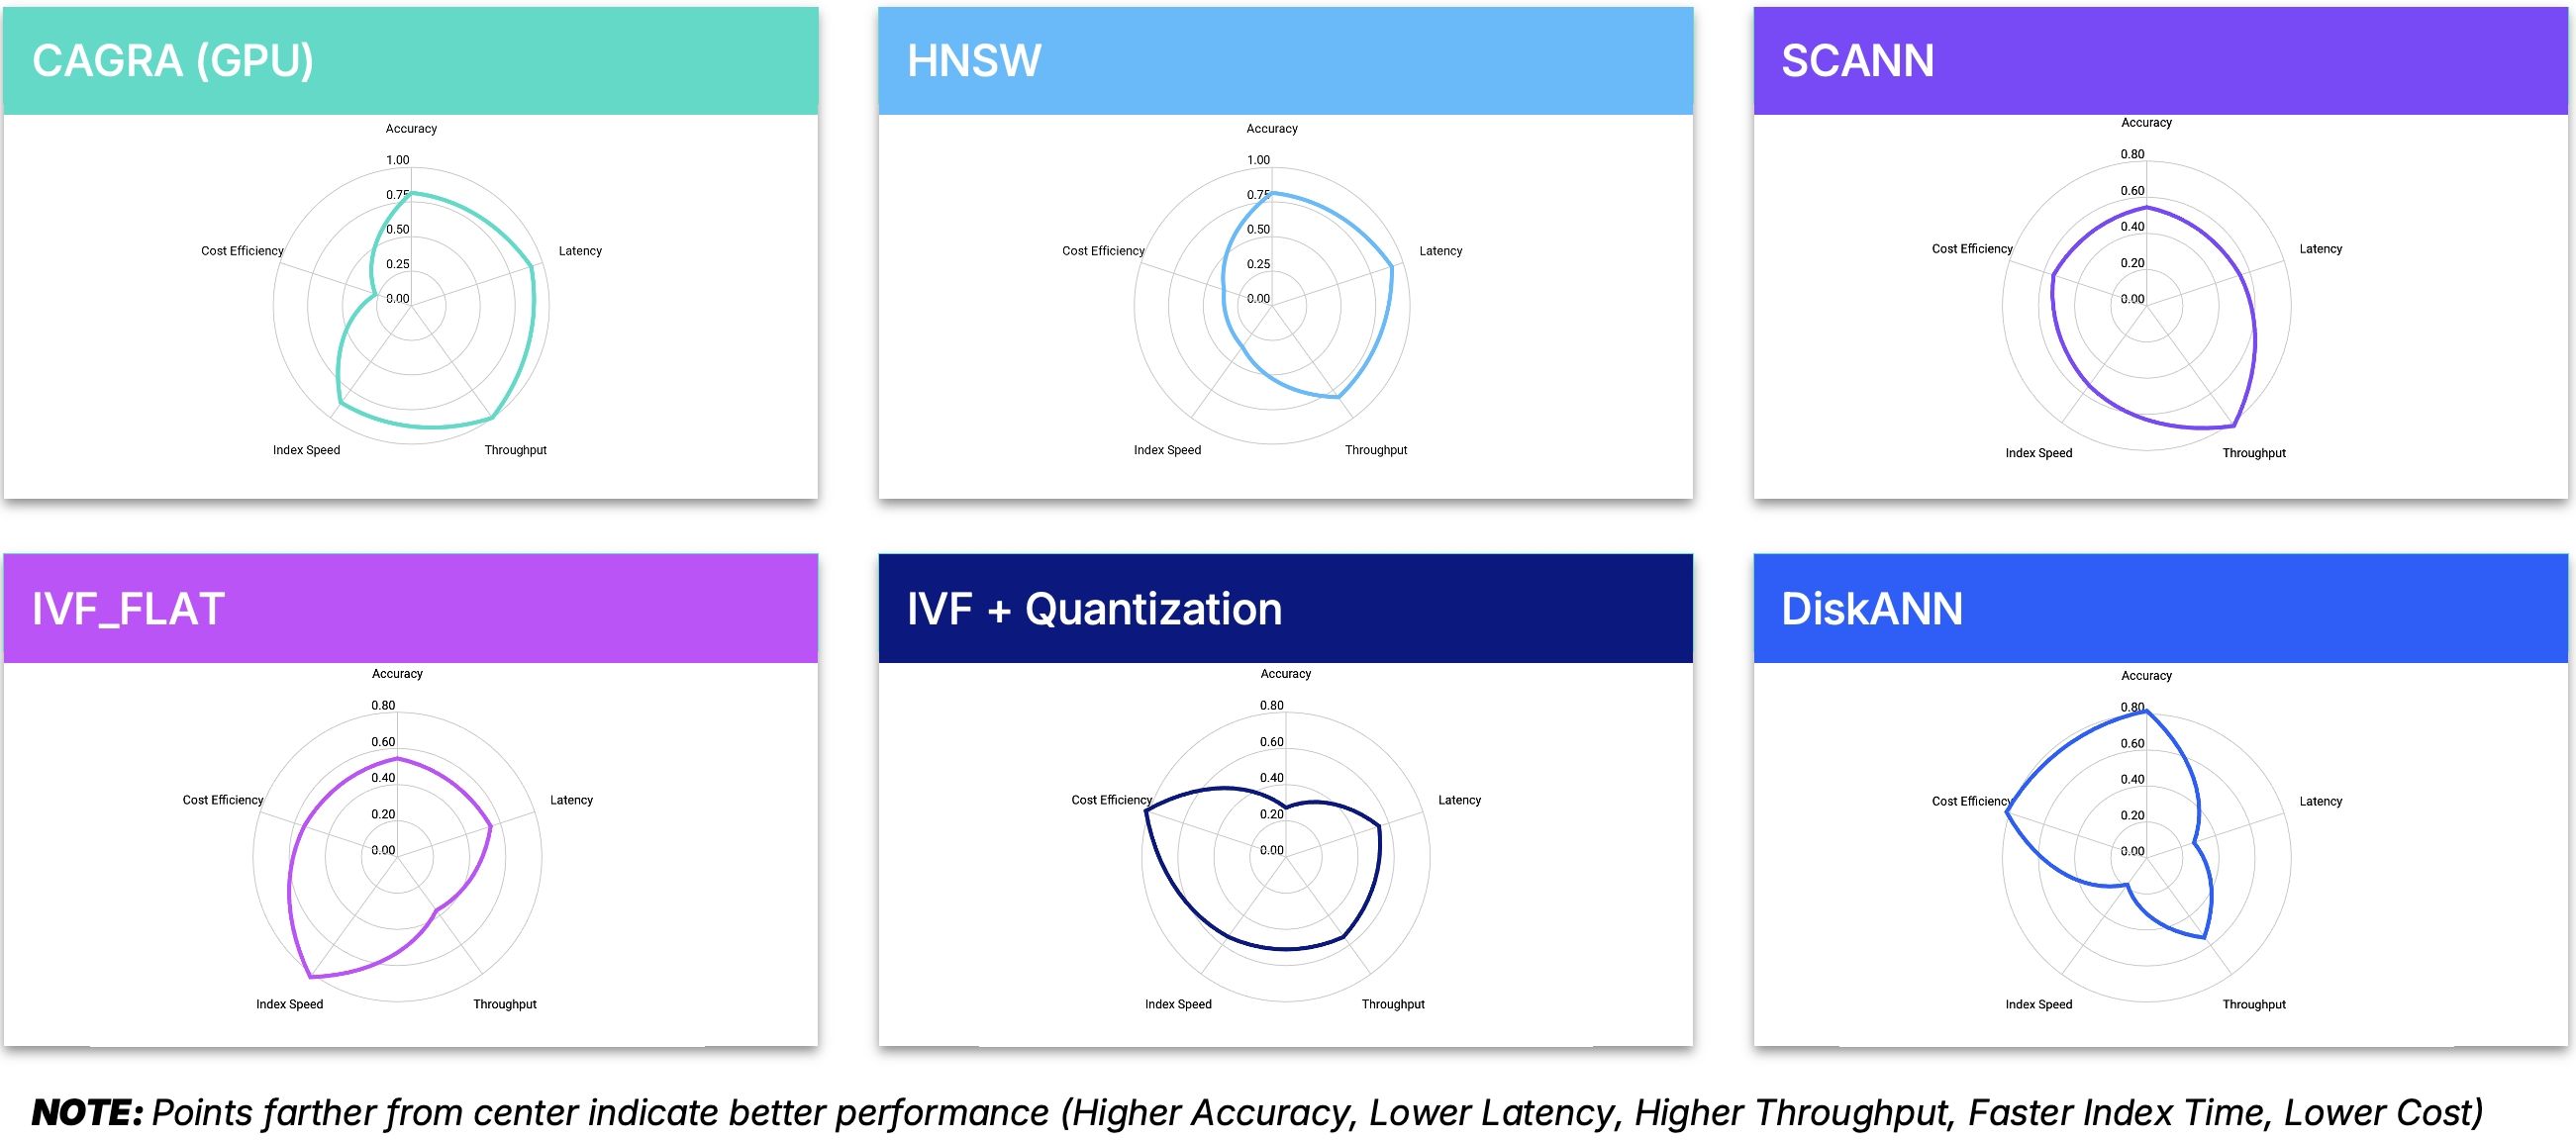 index
HNSW (Hierarchical Navigable Small World)
Architettura: Combina skip list con grafi Navigable Small Worlds (NSW) in una struttura gerarchica
Prestazioni: Query molto veloci con eccellenti tassi di recall
Utilizzo delle risorse: Richiede la maggiore quantità di memoria per vettore (costo più elevato)
Ideale per: Applicazioni in cui velocità e accuratezza sono fondamentali e i vincoli di memoria sono meno rilevanti
Nota tecnica: La ricerca inizia dal livello più alto con il minor numero di nodi e procede verso il basso attraverso livelli sempre più densi
FLAT
Architettura: Semplice ricerca esaustiva senza approssimazione
Prestazioni: Recall al 100% ma tempi di query estremamente lenti (
O(n)per dimensione dei datin)Utilizzo delle risorse: La dimensione dell’indice è uguale alla dimensione dei dati vettoriali grezzi
Ideale per: Dataset piccoli o applicazioni che richiedono un recall perfetto
Nota tecnica: Esegue calcoli completi della distanza tra il vettore di query e ogni vettore nel database
IVF_FLAT
Architettura: Divide lo spazio vettoriale in cluster per una ricerca più efficiente
Prestazioni: Recall medio-alto con velocità di query moderata (più lento di HNSW ma più veloce di FLAT)
Utilizzo delle risorse: Richiede meno memoria di FLAT ma più di HNSW
Ideale per: Applicazioni bilanciate in cui parte del recall può essere scambiata per prestazioni migliori
Nota tecnica: Durante la ricerca, vengono esaminati solo
nlistcluster, riducendo significativamente il calcolo
IVF_SQ8
Architettura: Applica la quantizzazione scalare a IVF_FLAT, comprimendo i dati vettoriali
Prestazioni: Recall medio con velocità di query medio-alta
Utilizzo delle risorse: Riduce il consumo di disco, calcolo e memoria del 70-75% rispetto a IVF_FLAT
Ideale per: Ambienti con risorse limitate in cui l’accuratezza può essere leggermente compromessa
Nota tecnica: Comprime valori in virgola mobile a 32 bit in valori interi a 8 bit
Opzioni di indicizzazione avanzate: ScaNN, DiskANN, CAGRA e altro
Per sviluppatori con requisiti specializzati, Milvus offre anche:
ScaNN: 20% più veloce su CPU rispetto a HNSW con tassi di recall simili
DiskANN: Un indice ibrido disco/memoria ideale quando devi supportare un gran numero di vettori con alto recall e puoi accettare una latenza leggermente più lunga (~100ms). Bilancia l’uso della memoria con le prestazioni mantenendo solo una parte dell’indice in memoria mentre il resto rimane su disco.
Indici basati su GPU:
GPU_CAGRA: Questo è il più veloce degli indici GPU, ma richiede una scheda di inferenza con memoria GDDR anziché una con memoria HBM
GPU_BRUTE_FORCE: Ricerca esaustiva implementata su GPU
GPU_IVF_FLAT: Versione accelerata da GPU di IVF_FLAT
GPU_IVF_PQ: Versione accelerata da GPU di IVF con Product Quantization
HNSW-PQ/SQ/PRQ:
HNSW_SQ: Query ad altissima velocità, risorse di memoria limitate; accetta un compromesso minore nel tasso di recall.
HNSW_PQ: Query a velocità media; risorse di memoria molto limitate; accetta un compromesso minore nel tasso di recall
HNSW_PRQ: Query a velocità media; risorse di memoria molto limitate; accetta un compromesso minore nel tasso di recall
AUTOINDEX: Usa HNSW come impostazione predefinita in Milvus open-source (oppure usa indici proprietari più performanti in Zilliz Cloud, il Milvus gestito).
Indici binari, sparsi e altri indici specializzati: Per tipi di dati e casi d’uso specifici. Consulta questa pagina della documentazione sugli indici per maggiori dettagli.
Dimensione dei segmenti e configurazione del deployment
I segmenti sono gli elementi fondamentali dell’organizzazione interna dei dati di Milvus. Funzionano come blocchi di dati che abilitano la ricerca distribuita e il bilanciamento del carico nel tuo deployment. Questo strumento di dimensionamento di Milvus offre tre opzioni di dimensione dei segmenti (512 MB, 1024 MB, 2048 MB), con 1024 MB come valore predefinito.
Comprendere i segmenti è fondamentale per l’ottimizzazione delle prestazioni. Come linea guida generale:
Segmenti da 512 MB: Ideali per nodi di query con 4-8 GB di memoria
Segmenti da 1 GB: Ottimali per nodi di query con 8-16 GB di memoria
Segmenti da 2 GB: Consigliati per nodi di query con >16 GB di memoria
Insight per sviluppatori: Meno segmenti, ma più grandi, in genere offrono prestazioni di ricerca più rapide. Per deployment su larga scala, i segmenti da 2 GB spesso offrono il miglior equilibrio tra efficienza della memoria e velocità delle query.
Selezione del sistema di message queue
Quando scegli tra Pulsar e Kafka come sistema di messaggistica:
Pulsar: Consigliato per nuovi progetti grazie al minore overhead per topic e alla migliore scalabilità
Kafka: Può essere preferibile se nella tua organizzazione hai già competenze o infrastruttura Kafka
Ottimizzazioni enterprise in Zilliz Cloud
Per deployment di produzione con requisiti di prestazioni rigorosi, Zilliz Cloud (la versione completamente gestita ed enterprise di Milvus sul cloud) offre ottimizzazioni aggiuntive nell’indicizzazione e nella quantizzazione:
Prevenzione Out of Memory (OOM): Gestione sofisticata della memoria per prevenire crash dovuti all’esaurimento della memoria
Ottimizzazione della compaction: Migliora le prestazioni di ricerca e l’utilizzo delle risorse
Tiered Storage: Gestisci in modo efficiente i dati hot e cold con unità di calcolo appropriate
Unità di calcolo standard (CU) per dati accessibili frequentemente
CU per tiered storage per l’archiviazione conveniente di dati raramente accessibili
Per opzioni dettagliate di dimensionamento enterprise, visita la documentazione sui piani di servizio Zilliz Cloud.
Suggerimenti di configurazione avanzata per sviluppatori
Tipi di indice multipli: Lo strumento di dimensionamento si concentra su un singolo indice. Per applicazioni complesse che richiedono algoritmi di indicizzazione diversi per varie collection, crea collection separate con configurazioni personalizzate.
Allocazione della memoria: Quando pianifichi il tuo deployment, considera sia i dati vettoriali sia i requisiti di memoria dell'indice. HNSW richiede in genere 2-3 volte la memoria dei dati vettoriali grezzi.
Test delle prestazioni: Prima di finalizzare la tua configurazione, esegui benchmark dei tuoi specifici pattern di query su un dataset rappresentativo.
Considerazioni sulla scalabilità: Tieni conto della crescita futura. È più facile iniziare con risorse leggermente maggiori che riconfigurare in seguito.
Conclusione
Il Milvus Sizing Tool fornisce un eccellente punto di partenza per la pianificazione delle risorse, ma ricorda che ogni applicazione ha requisiti unici. Per prestazioni ottimali, ti consigliamo di ottimizzare la tua configurazione in base alle caratteristiche specifiche del tuo carico di lavoro, ai pattern di query e alle esigenze di scalabilità.
Stiamo migliorando continuamente i nostri strumenti e la documentazione in base al feedback degli utenti. Se hai domande o hai bisogno di ulteriore assistenza per dimensionare il tuo deployment Milvus, contatta la nostra community su GitHub o Discord.
Riferimenti
 Fendy Feng
 is the Technical Marketing Writer at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Ken Zhang
 is a Senior Product Manager at Zilliz, leading the development of the Milvus vector database by setting its strategic direction and key features. Prior to Zilliz, he served as a kernel engineer at SAP HANA and enhanced his product management skills at PingCAP. Ken holds a master's degree from Fudan University and has over eight years of experience specializing in database development and big data infrastructure management.
Continua a leggere
My Wife Wanted Dior. I Spent $600 on Claude Code to Vibe-Code a 2M-Line Database Instead.
Write tests, not code reviews. How a test-first workflow with 6 parallel Claude Code sessions turns a 2M-line C++ codebase into a daily shipping pipeline.

How to Build an Enterprise-Ready RAG Pipeline on AWS with Bedrock, Zilliz Cloud, and LangChain
Build production-ready enterprise RAG with AWS Bedrock, Nova models, Zilliz Cloud, and LangChain. Complete tutorial with deployable code.

Introducing Zilliz MCP Server: Natural Language Access to Your Vector Database
Developers can easily manage and query vector databases with natural language via Zilliz MCP Server in AI-native environments.