Cómo migrar tus datos a Milvus sin problemas: una guía completa
Milvus es una base de datos vectorial robusta de código abierto para búsqueda por similitud que puede almacenar, procesar y recuperar miles de millones e incluso billones de datos vectoriales con una latencia mínima. También es altamente escalable, fiable, cloud-native y rica en funciones. La versión más reciente de Milvus introduce aún más funciones y mejoras interesantes, incluido soporte para GPU para un rendimiento más de 10 veces más rápido y MMap para una mayor capacidad de almacenamiento en una sola máquina.
A septiembre de 2023, Milvus ha obtenido casi 23.000 estrellas en GitHub y tiene decenas de miles de usuarios de diversas industrias con necesidades variadas. Se está volviendo aún más popular a medida que la tecnología de IA generativa como ChatGPT se vuelve más prevalente. Es un componente esencial de varios stacks de IA, especialmente el marco de generación aumentada por recuperación, que aborda el problema de las alucinaciones de los modelos de lenguaje grandes.
Para satisfacer la creciente demanda de nuevos usuarios que desean migrar a Milvus y de usuarios existentes que quieren actualizar a las últimas versiones de Milvus, desarrollamos Milvus Migration. En este blog, exploraremos las características de Milvus Migration y te guiaremos para que puedas realizar rápidamente la transición de tus datos a Milvus desde Milvus 1.x, FAISS y Elasticsearch 7.0 y versiones posteriores.
Milvus Migration, una potente herramienta de migración de datos
Milvus Migration es una herramienta de migración de datos escrita en Go. Permite a los usuarios trasladar sus datos sin problemas desde versiones anteriores de Milvus (1.x), FAISS y Elasticsearch 7.0 y versiones posteriores a versiones de Milvus 2.x.
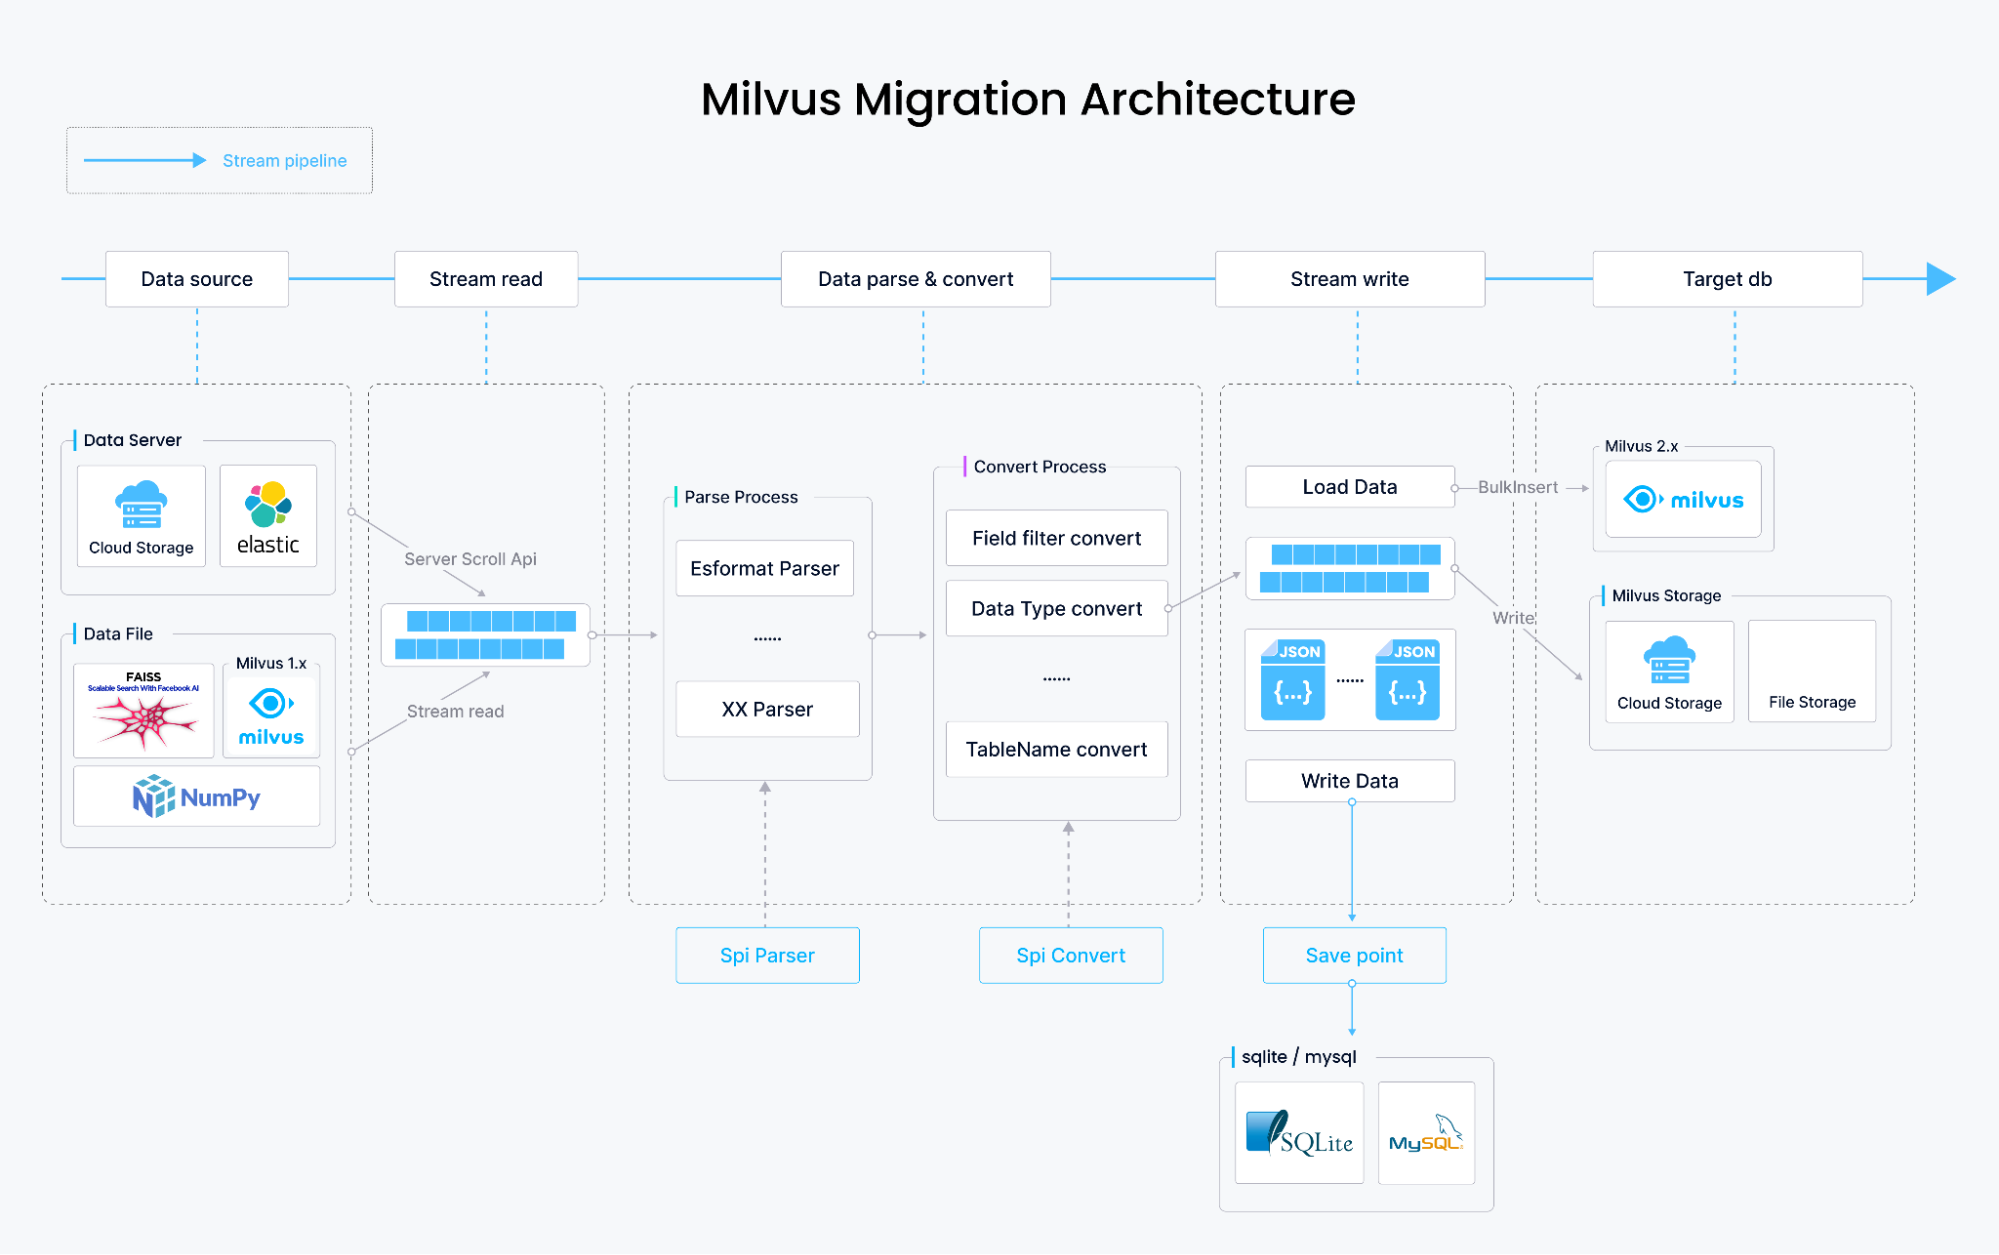
El diagrama a continuación muestra cómo creamos Milvus Migration y cómo funciona.
Cómo Milvus Migration migra datos
De Milvus 1.x y FAISS a Milvus 2.x
La migración de datos desde Milvus 1.x y FAISS implica analizar el contenido de los archivos de datos originales, transformarlos al formato de almacenamiento de datos de Milvus 2.x y escribir los datos usando bulkInsert del SDK de Milvus. Todo este proceso se basa en streams, teóricamente limitado solo por el espacio en disco, y almacena archivos de datos en tu disco local, S3, OSS, GCP o Minio.
De Elasticsearch a Milvus 2.x
En la migración de datos de Elasticsearch, la recuperación de datos es diferente. Los datos no se obtienen de archivos, sino que se recuperan secuencialmente usando la API scroll de Elasticsearch. Luego, los datos se analizan y se transforman al formato de almacenamiento de Milvus 2.x, seguido de su escritura usando bulkInsert. Además de migrar vectores de tipo dense_vector almacenados en Elasticsearch, Milvus Migration también admite la migración de otros tipos de campos, incluidos long, integer, short, boolean, keyword, text y double.
Conjunto de características de Milvus Migration
Milvus Migration simplifica el proceso de migración mediante su sólido conjunto de características:
Fuentes de datos compatibles:
Milvus 1.x a Milvus 2.x
Elasticsearch 7.0 y versiones posteriores a Milvus 2.x
FAISS a Milvus 2.x
Múltiples modos de interacción:
Interfaz de línea de comandos (CLI) usando el framework Cobra
API Restful con una interfaz de usuario Swagger integrada
Integración como módulo Go en otras herramientas
Soporte versátil de formatos de archivo:
Archivos locales
Amazon S3
Object Storage Service (OSS)
Google Cloud Platform (GCP)
Integración flexible con Elasticsearch:
Migración de vectores de tipo
dense_vectordesde ElasticsearchCompatibilidad para migrar otros tipos de campos como long, integer, short, boolean, keyword, text y double
Definiciones de interfaz
Milvus Migration proporciona las siguientes interfaces clave:
/start: Inicia un trabajo de migración (equivalente a una combinación de dump y load, actualmente solo admite migración de ES)./dump: Inicia un trabajo de dump (escribe los datos de origen en el medio de almacenamiento de destino)./load: Inicia un trabajo de load (escribe datos desde el medio de almacenamiento de destino en Milvus 2.x)./get_job: Permite a los usuarios ver los resultados de ejecución del trabajo. (Para obtener más detalles, consulta el server.go del proyecto)
A continuación, usemos algunos datos de ejemplo para explorar cómo usar Milvus Migration en esta sección. Puedes encontrar estos ejemplos aquí en GitHub.
Migración de Elasticsearch a Milvus 2.x
- Preparar datos de Elasticsearch
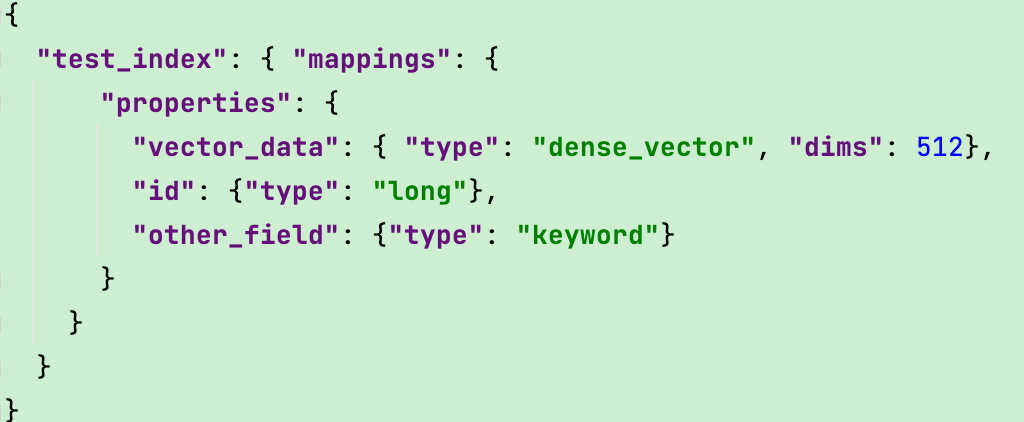
Para migrar datos de Elasticsearch, ya deberías haber configurado tu propio servidor de Elasticsearch. Debes almacenar los datos vectoriales en el campo dense_vector e indexarlos con otros campos. Las asignaciones de índice se muestran a continuación.
- Compilar y construir
Primero, descarga el código fuente de Milvus Migration desde GitHub. Luego, ejecuta los siguientes comandos para compilarlo.
go get
go build
Este paso generará un archivo ejecutable llamado milvus-migration.
- Configurar
migration.yaml
Antes de iniciar la migración, debes preparar un archivo de configuración llamado migration.yaml que incluya información sobre la fuente de datos, el destino y otras configuraciones relevantes. Aquí tienes un ejemplo de configuración:
# Configuration for Elasticsearch to Milvus 2.x migration

dumper:
  worker:
    workMode: Elasticsearch
    reader:
      bufferSize: 2500
meta:
  mode: config
  index: test_index
  fields:
    - name: id
      pk: true
      type: long
    - name: other_field
      maxLen: 60
      type: keyword
    - name: data
      type: dense_vector
      dims: 512
  milvus:
      collection: "rename_index_test"
      closeDynamicField: false
      consistencyLevel: Eventually
      shardNum: 1

source:
  es:
    urls:
      - http://localhost:9200
    username: xxx
    password: xxx

target:
  mode: remote
  remote:
    outputDir: outputPath/migration/test1
    cloud: aws
    region: us-west-2
    bucket: xxx
    useIAM: true
    checkBucket: false
  milvus2x:
    endpoint: {yourMilvusAddress}:{port}
    username: ******
    password: ******
Para una explicación más detallada del archivo de configuración, consulta esta página en GitHub.
- Ejecutar el trabajo de migración
Ahora que has configurado tu archivo migration.yaml, puedes iniciar la tarea de migración ejecutando el siguiente comando:
./milvus-migration start --config=/{YourConfigFilePath}/migration.yaml
Observa la salida del registro. Cuando veas registros similares a los siguientes, significa que la migración se realizó correctamente.
[task/load_base_task.go:94] ["[LoadTasker] Dec Task Processing-------------->"] [Count=0] [fileName=testfiles/output/zwh/migration/test_mul_field4/data_1_1.json] [taskId=442665677354739304][task/load_base_task.go:76] ["[LoadTasker] Progress Task --------------->"] [fileName=testfiles/output/zwh/migration/test_mul_field4/data_1_1.json] [taskId=442665677354739304][dbclient/cus_field_milvus2x.go:86] ["[Milvus2x] begin to ShowCollectionRows"][loader/cus_milvus2x_loader.go:66] ["[Loader] Static: "] [collection=test_mul_field4_rename1] [beforeCount=50000] [afterCount=100000] [increase=50000][loader/cus_milvus2x_loader.go:66] ["[Loader] Static Total"] ["Total Collections"=1] [beforeTotalCount=50000] [afterTotalCount=100000] [totalIncrease=50000][migration/es_starter.go:25] ["[Starter] migration ES to Milvus finish!!!"] [Cost=80.009174459][starter/starter.go:106] ["[Starter] Migration Success!"] [Cost=80.00928425][cleaner/remote_cleaner.go:27] ["[Remote Cleaner] Begin to clean files"] [bucket=a-bucket] [rootPath=testfiles/output/zwh/migration][cmd/start.go:32] ["[Cleaner] clean file success!"]
Además del enfoque de línea de comandos, Milvus Migration también admite la migración mediante la API Restful.
Para usar la API Restful, inicia el servidor de la API con el siguiente comando:
./milvus-migration server run -p 8080
Una vez que el servicio se esté ejecutando, puedes iniciar la migración llamando a la API.
curl -XPOST http://localhost:8080/api/v1/start
Cuando se complete la migración, puedes usar Attu, una herramienta integral de administración de bases de datos vectoriales, para ver el número total de filas migradas correctamente y realizar otras operaciones relacionadas con colecciones.
 La interfaz de Attu
Migración de Milvus 1.x a Milvus 2.x
- Prepara los datos de Milvus 1.x
Para ayudarte a experimentar rápidamente el proceso de migración, hemos incluido 10 000 registros de datos de prueba de Milvus 1.x en el código fuente de Milvus Migration. Sin embargo, en casos reales, debes exportar tu propio archivo meta.json desde tu instancia de Milvus 1.x antes de iniciar el proceso de migración.
- Puedes exportar los datos con el siguiente comando.
./milvus-migration export -m "user:password@tcp(adderss)/milvus?charset=utf8mb4&parseTime=True&loc=Local" -o outputDir
Asegúrate de:
Reemplazar los marcadores de posición con tus credenciales reales de MySQL.
Detener el servidor de Milvus 1.x o suspender las escrituras de datos antes de realizar esta exportación.
Copiar la carpeta
tablesde Milvus y el archivometa.jsonal mismo directorio.
Nota: Si usas Milvus 2.x en Zilliz Cloud (el servicio totalmente administrado de Milvus), puedes iniciar la migración mediante Cloud Console.
- Compila y construye
Primero, descarga el código fuente de GitHub de Milvus Migration. Luego, ejecuta los siguientes comandos para compilarlo.
go get
go build
Este paso generará un archivo ejecutable llamado milvus-migration.
- Configura
migration.yaml
Prepara un archivo de configuración migration.yaml, especificando detalles sobre el origen, el destino y otros ajustes relevantes. Aquí tienes un ejemplo de configuración:
# Configuration for Milvus 1.x to Milvus 2.x migration

dumper:
  worker:
    limit: 2
    workMode: milvus1x
    reader:
      bufferSize: 1024
    writer:
      bufferSize: 1024
loader:
  worker:
    limit: 16
meta:
  mode: local
  localFile: /outputDir/test/meta.json

source:
  mode: local
  local:
    tablesDir: /db/tables/

target:
  mode: remote
  remote:
    outputDir: "migration/test/xx"
    ak: xxxx
    sk: xxxx
    cloud: aws
    endpoint: 0.0.0.0:9000
    region: ap-southeast-1
    bucket: a-bucket
    useIAM: false
    useSSL: false
    checkBucket: true
  milvus2x:
    endpoint: localhost:19530
    username: xxxxx
    password: xxxxx
Para una explicación más detallada del archivo de configuración, consulta esta página en GitHub.
- Ejecutar el trabajo de migración
Debes ejecutar los comandos dump y load por separado para completar la migración. Estos comandos convierten los datos y los importan a Milvus 2.x.
Nota: Próximamente simplificaremos este paso y permitiremos que los usuarios completen la migración usando un solo comando. Mantente atento.
Comando Dump:
./milvus-migration dump --config=/{YourConfigFilePath}/migration.yaml
Comando Load:
./milvus-migration load --config=/{YourConfigFilePath}/migration.yaml
Después de la migración, la colección generada en Milvus 2.x contendrá dos campos: id y data. Puedes ver más detalles usando Attu, una herramienta todo en uno de administración de bases de datos vectoriales.
Migración de FAISS a Milvus 2.x
- Preparar los datos de FAISS
Para migrar datos de Elasticsearch, debes tener tus propios datos de FAISS listos. Para ayudarte a experimentar rápidamente el proceso de migración, hemos incluido algunos datos de prueba de FAISS en el código fuente de Milvus Migration.
- Compilar y construir
Primero, descarga el código fuente de Milvus Migration desde GitHub. Luego, ejecuta los siguientes comandos para compilarlo.
go get
go build
Este paso generará un archivo ejecutable llamado milvus-migration.
- Configurar
migration.yaml
Prepara un archivo de configuración migration.yaml para la migración de FAISS, especificando detalles sobre el origen, el destino y otros ajustes relevantes. Aquí tienes un ejemplo de configuración:
# Configuration for FAISS to Milvus 2.x migration

dumper:
  worker:
    limit: 2
    workMode: FAISS
    reader:
      bufferSize: 1024
    writer:
      bufferSize: 1024
loader:
  worker:
    limit: 2
source:
  mode: local
  local:
    FAISSFile: ./testfiles/FAISS/FAISS_ivf_flat.index

target:
  create:
    collection:
      name: test1w
      shardsNums: 2
      dim: 256
      metricType: L2
  mode: remote
  remote:
    outputDir: testfiles/output/
    cloud: aws
    endpoint: 0.0.0.0:9000
    region: ap-southeast-1
    bucket: a-bucket
    ak: minioadmin
    sk: minioadmin
    useIAM: false
    useSSL: false
    checkBucket: true
  milvus2x:
    endpoint: localhost:19530
    username: xxxxx
    password: xxxxx
Para una explicación más detallada del archivo de configuración, consulta esta página en GitHub.
- Ejecutar el trabajo de migración
Al igual que la migración de Milvus 1.x a Milvus 2.x, la migración de FAISS requiere ejecutar tanto el comando dump como el comando load. Estos comandos convierten los datos y los importan a Milvus 2.x.
Nota: Próximamente simplificaremos este paso y permitiremos que los usuarios completen la migración usando un solo comando. Mantente atento.
Comando Dump:
./milvus-migration dump --config=/{YourConfigFilePath}/migration.yaml
Comando Load:
./milvus-migration load --config=/{YourConfigFilePath}/migration.yaml
Puedes ver más detalles usando Attu, una herramienta todo en uno de administración de bases de datos vectoriales.
Mantente atento a futuros planes de migración
En el futuro, admitiremos la migración desde más fuentes de datos y añadiremos más funciones de migración, entre ellas:
Soporte para migración de Redis a Milvus.
Soporte para migración de MongoDB a Milvus.
Soporte para migración reanudable.
Simplificar los comandos de migración fusionando los procesos de dump y load en uno solo.
Soporte para migración desde otras fuentes de datos convencionales a Milvus.
Conclusión
Milvus 2.3, la versión más reciente de Milvus, trae nuevas y emocionantes funciones y mejoras de rendimiento que satisfacen las crecientes necesidades de la gestión de datos. Migrar tus datos a Milvus 2.x puede desbloquear estos beneficios, y el proyecto Milvus Migration hace que el proceso de migración sea ágil y sencillo. Pruébalo y no te decepcionará.
Nota: La información de este blog se basa en el estado de los proyectos Milvus y Milvus Migration a septiembre de 2023. Consulta la documentación oficial de Milvus para obtener la información y las instrucciones más actualizadas.
Sigue leyendo

The Real Bottlenecks in Autonomous Driving — And How AI Infrastructure Can Solve Them
Autonomous driving faces a data bottleneck. Learn how AI-native vector databases like Zilliz solve scale, cost, and insight challenges across AV pipelines.
Democratizing AI: Making Vector Search Powerful and Affordable
Zilliz democratizes AI vector search with Milvus 2.6 and Zilliz Cloud for powerful, affordable scalability, cutting costs in infrastructure, operations, and development.
Balancing Precision and Performance: How Zilliz Cloud's New Parameters Help You Optimize Vector Search
Optimize vector search with Zilliz Cloud’s level and recall features to tune accuracy, balance performance, and power AI applications.