Ausführen von Llama 3, Mixtral und GPT-4o
Es gibt so viele verschiedene Möglichkeiten, den G-Generation-Teil von RAG auszuführen! Heute zeige ich ein paar Möglichkeiten, einige der heißesten Anwärter in diesem Bereich auszuführen: Llama 3 von Meta, Mixtral von Mistral und das kürzlich angekündigte GPT-4o von OpenAI.
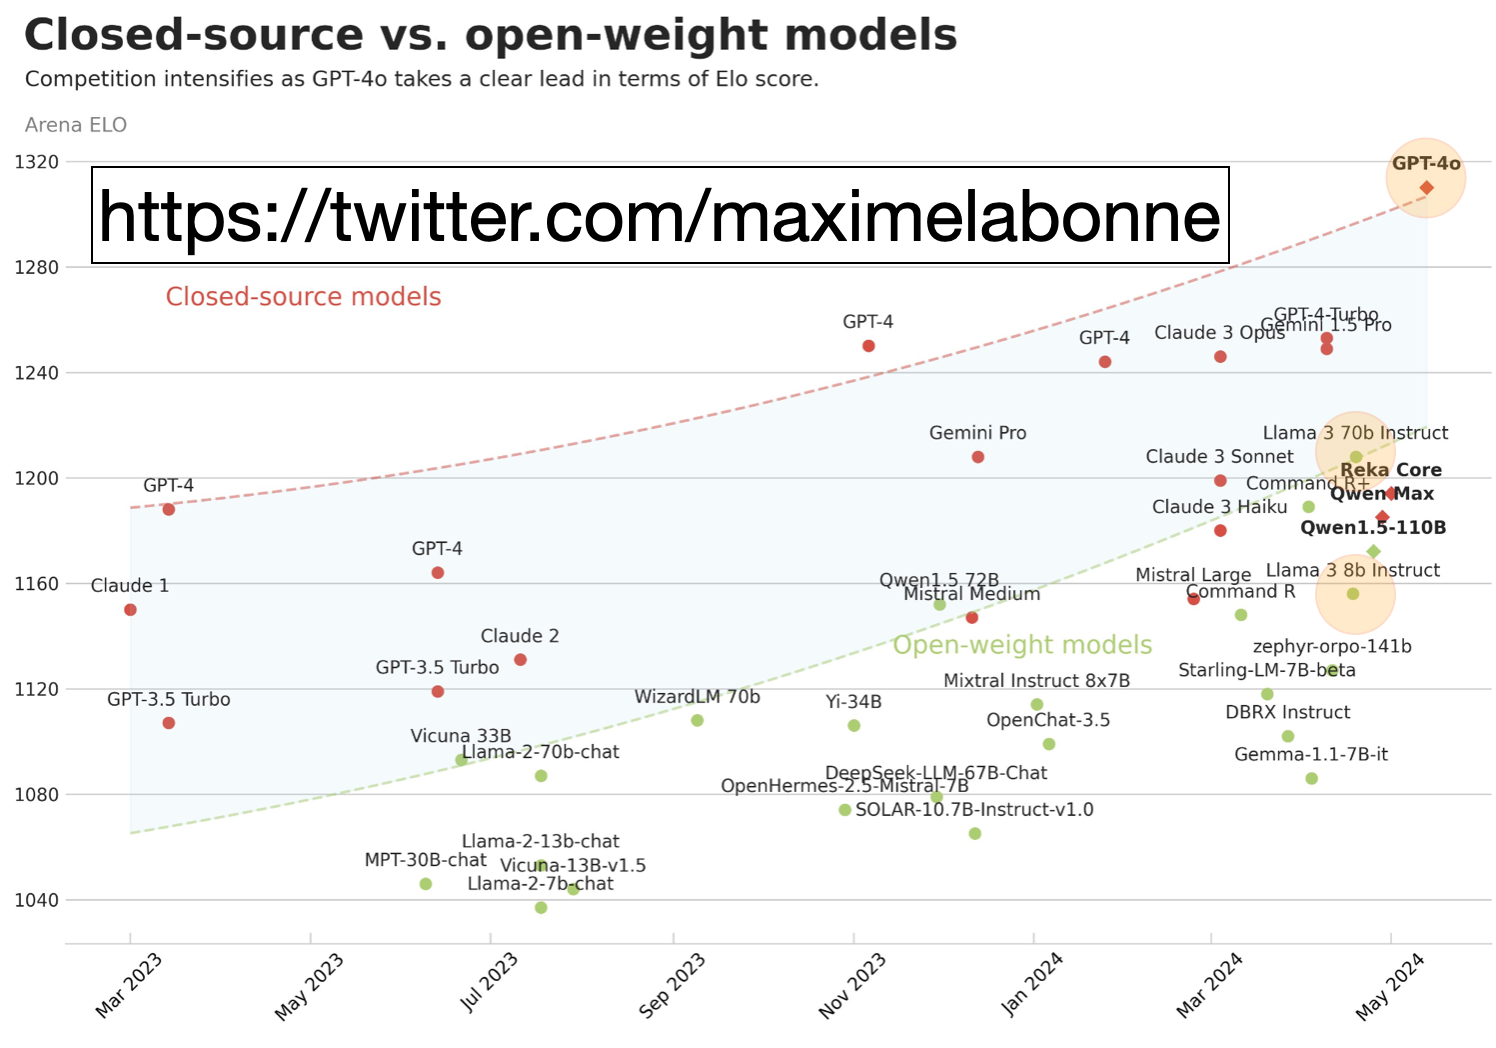
Wie wir unten im LMSYS Leaderboard sehen können, hat sich die Lücke (hellblau) zwischen Closed-Source-Modellen und Open-Source-Modellen diese Woche durch die neue Ankündigung von OpenAI deutlich vergrößert.
 Closed-Source vs. Open
Bildquelle: https://twitter.com/maximelabonne basierend auf https://chat.lmsys.org/?leaderboard.
Gliederung für diesen Blog:
Die schnellsten Möglichkeiten, Open-Source Llama 3 oder Mixtral auszuführen
Lokal mit Ollama
Anyscale-Endpunkte
OctoAI-Endpunkt
Groq-Endpunkt
Das neueste gpt-4o von OpenAI ausführen
Antworten evaluieren: GPT-4o, Llama 3, Mixtral
Legen wir los!
Llama 3 lokal mit Ollama ausführen
Führen Sie RAG zunächst auf die übliche Weise aus, bis zum letzten Schritt, in dem Sie die Antwort generieren, den G-Teil von RAG. Wir haben viele Tutorials für den Einstieg in RAG, einschließlich dieses hier in Python.
Um Llama 3 lokal mit Ollama auszuführen.
Folgen Sie den Anweisungen, um ollama zu installieren und ein Modell herunterzuladen.
Auf dieser Seite steht, dass
ollama run llama3standardmäßig das neueste „instruct“-Modell herunterlädt, das für Chat-/Dialog-Anwendungsfälle feinabgestimmt ist UND auf Ihren Computer passt. Führen Sie diesen Befehl aus.Für Python:
pip install ollama.Definieren Sie in Ihrem RAG-Python-Code einen Prompt und eine Frage und rufen Sie den API-Aufruf an Ihr lokal installiertes Llama-3-Modell auf.
In meinem Fall habe ich einen M2-Laptop mit 16 GB, daher ist das heruntergeladene Ollama-Modell die am höchsten quantisierte gguf-kompilierte Version von Llama3-8B. Das heißt, eine sehr kleine Version von Llama 3 ist jetzt auf meinem Laptop installiert!
# Separate all the context together by space, reverse order.
# See “Lost in the middle” arxiv.org paper.
contexts_combined = ' '.join(reversed(contexts))
source_combined = ' '.join(reversed(sources))

# Define a Prompt.
SYSTEM_PROMPT = f"""Given the provided Context, your task is to
understand the content and accurately answer the question based
on the information available in the context.
Provide a complete, clear, concise, relevant response in fewer
than 4 sentences and cite the unique Sources.
Answer: The answer to the question.
Sources: {source_combined}
Context: {contexts_combined}
"""

# Send the Question and Prompt to local! llama 3 chat.
import ollama
start_time = time.time()
response = ollama.chat(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model='llama3',
   stream=False,
   options={"temperature": TEMPERATURE, "seed": RANDOM_SEED,
            "top_p": TOP_P,
           #  "max_tokens": MAX_TOKENS, # not recognized
            "frequency_penalty": FREQUENCY_PENALTY}
)

ollama_llama3_time = time.time() - start_time
pprint.pprint(response['message']['content'].replace('\n', ' '))
print(f"ollama_llama3_time: {format(ollama_llama3_time, '.2f')} seconds")
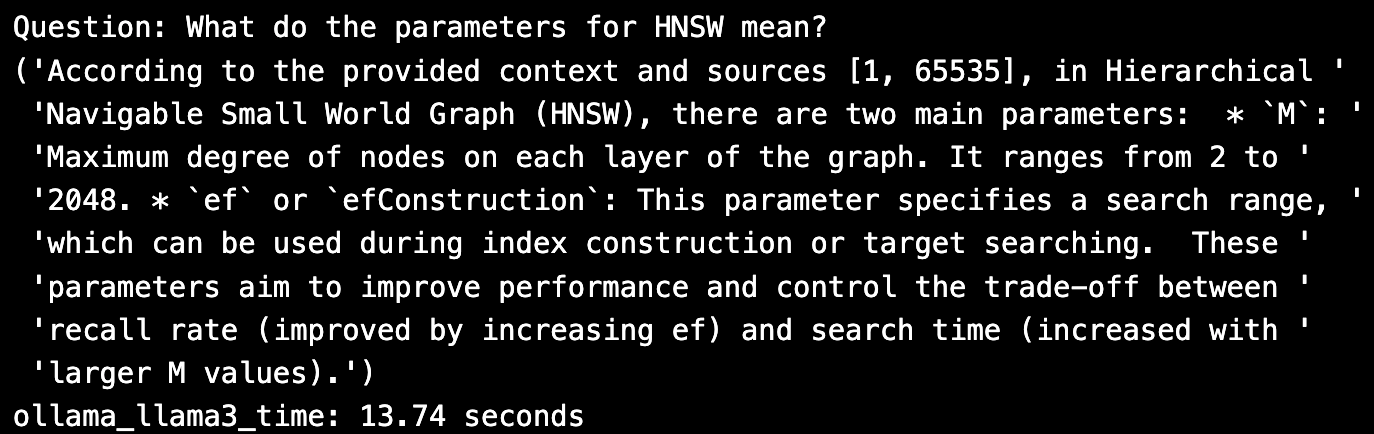
Die Antwort sieht ziemlich gut aus; ich sehe drei Parameter, aber nur die Zitierung wirkt verstümmelt. Das lokale Modell brauchte 13 Sekunden, um die Inferenz auf meinem Laptop auszuführen, aber die Kosten lagen bei null.
Llama 3 über Anyscale-Endpunkte ausführen
Um Llama-3-Inferenz über Anyscale-Endpunkte auszuführen:
Folgen Sie den Anweisungen auf der Github-Seite der Anyscale-Endpunkte, um die Befehlszeile zu installieren und anschließend das Plugin zu installieren.
Holen Sie sich Ihr Anysclae-Endpunkt-API-Token und aktualisieren Sie Ihre Umgebungsvariablen.
Für Python:
pip install openai.Lesen Sie mehr über das von HuggingFace heruntergeladene Llama-3-Modell und rufen Sie es mithilfe der OpenAI API auf. Ich habe das standardmäßige Llama 3 im Anyscale Playground verwendet, ein 70B-Instruct-Modell.
import openai

LLM_NAME = "meta-llama/Llama-3-70b-chat-hf"

anyscale_client = openai.OpenAI(
   base_url = "https://api.endpoints.anyscale.com/v1",
   api_key=os.environ.get("ANYSCALE_ENPOINT_KEY"),
)

start_time = time.time()
response = anyscale_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_anyscale_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_anyscale_endpoints_time: {format(llama3_anyscale_endpoints_time, '.2f')} seconds")
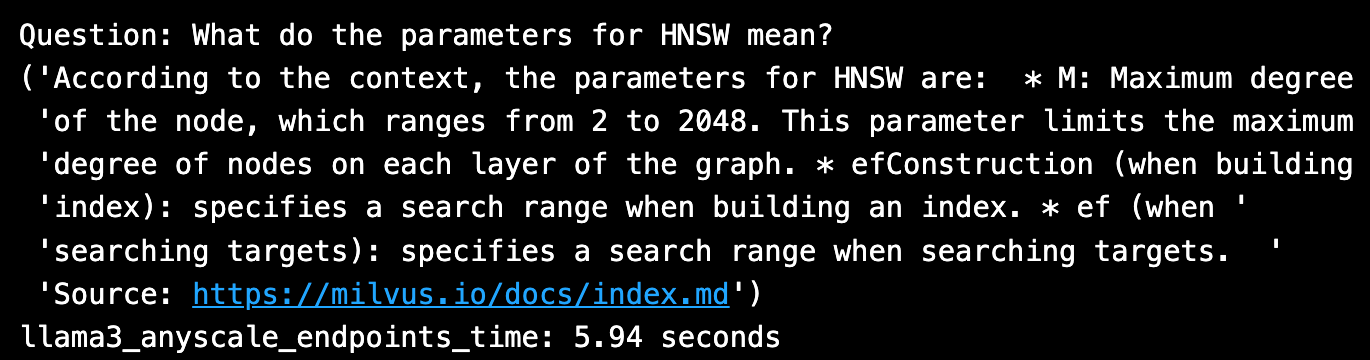
Die Antwort sieht gut aus, einschließlich eines perfekten Zitats. Das HuggingFace Llama 3 70B brauchte ~6 Sekunden, um von Anyscale Endpoints aufgerufen zu werden.
Llama 3 über OctoAI Endpoints ausführen
So führen Sie Llama-3-Inferenz über OctoAI Endpoints aus:
Gehen Sie zu https://octoai.cloud/text, wählen Sie das Llama 3 8B model, klicken Sie auf den Modell-Link und Sie sehen Beispielcode.
Holen Sie sich Ihr OctoAI-Endpoint-API-Token und aktualisieren Sie Ihre Umgebungsvariablen.
Für Python:
pip install octoai.Lesen Sie mehr über das von Meta heruntergeladene Llama 3 8B model und rufen Sie es auf.
from octoai.text_gen import ChatMessage
from octoai.client import OctoAI

LLM_NAME = "meta-llama-3-70b-instruct"

octoai_client = OctoAI(
   api_key=os.environ.get("OCTOAI_TOKEN"),
)

start_time = time.time()
response = octoai_client.text_gen.create_chat_completion(
   messages=[
       ChatMessage(
           content=SYSTEM_PROMPT,
           role="system"
       ),
       ChatMessage(
           content=SAMPLE_QUESTION,
           role="user"
       )
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   # seed=RANDOM_SEED, # not recognized
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_octai_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_octai_endpoints_time: {format(llama3_octai_endpoints_time, '.2f')} seconds")
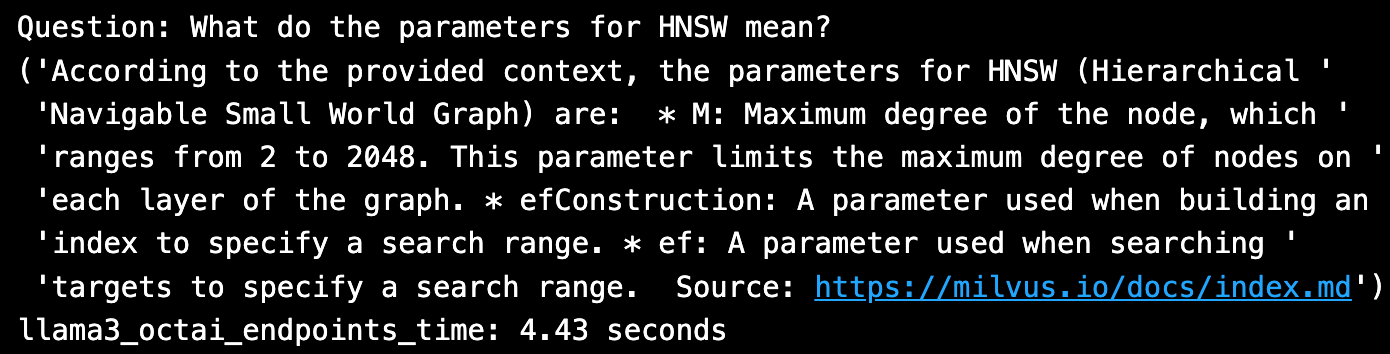
Die Antwort sieht gut aus und das Zitat ist perfekt. Das Llama 3 70B brauchte weniger als ~4 Sekunden, um von OctoAI Endpoints aufgerufen zu werden.
Llama 3 über Groq LPU Endpoints ausführen
So führen Sie Llama-3-Inferenz über Groq Endpoints aus:
Gehen Sie zu console.groq.com und folgen Sie den Anweisungen.
Holen Sie sich Ihr Groq-Endpoint-API-Token und aktualisieren Sie Ihre Umgebungsvariablen.
Für Python:
pip install groq.Lesen Sie mehr über das von HuggingFace heruntergeladene Llama 3 8B model und rufen Sie es auf.
from groq import Groq

LLM_NAME = "llama3-70b-8192"

groq_client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

start_time = time.time()
response = groq_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_groq_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_groq_endpoints_time: {format(llama3_groq_endpoints_time, '.2f')} seconds")
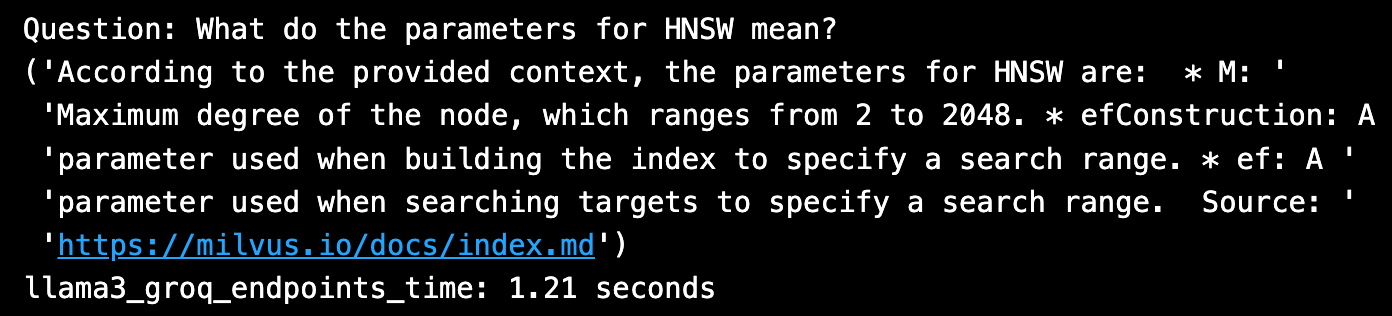
Die Antwort wirkt etwas prägnanter, und die Zitierung ist perfekt. Der Llama 3 20B benötigte ~1 Sekunde für den Aufruf über Groq LPU-Endpunkte, was die bisher schnellste Inferenz ist!
Hinweis: Um Mixtral auszuführen, befolge dieselben Schritte und ändere lediglich LLM_NAME in den Namen, den die jeweilige Endpoint-Plattform für das Mixtral-Modell verwendet.
GPT-4o von OpenAI ausführen
So führst du die neueste GPT-4o-Inferenz von OpenAI aus:
Hole dir deinen OpenAI-API-Token und aktualisiere deine Umgebungsvariablen.
Befolge die Anweisungen, um zu erfahren, wie das neue Modell aufgerufen wird.
Für Python:
pip install --upgrade openai --quiet.Lies mehr über das neue GPT-4o-Modell und rufe es auf.
import openai, pprint
from openai import OpenAI

LLM_NAME = "gpt-4o" # "gpt-3.5-turbo"

openai_client = OpenAI(
   # This is the default and can be omitted
   api_key=os.environ.get("OPENAI_API_KEY"),
)

start_time = time.time()
response = openai_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
chatgpt_4o_turbo_time = time.time() - start_time

# Print the question and answer along with grounding sources and citations.
print(f"Question: {SAMPLE_QUESTION}")
for i, choice in enumerate(response.choices, 1):
   message = choice.message.content.replace('\n', '')
   pprint.pprint(f"Answer: {message}")
print(f"chatgpt_4o_turbo_time: {format(chatgpt_4o_turbo_time, '.5f')}")
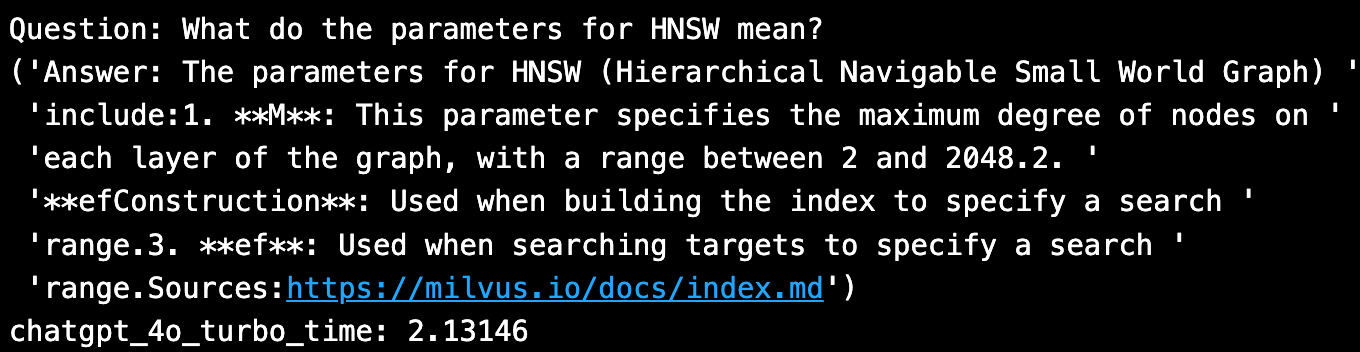
Das neue GPT-4o-Modell sieht gut aus und enthält eine Quellenzitierung zur Fundierung. Die Inferenz dauerte 2 Sekunden.
Schnelle Antwortbewertung mit Ragas
In diesem Blog erkläre ich, wie man Open-Source-Ragas zur Bewertung von RAG-Systemen verwendet. Unten verwende ich nur eine einzelne Frage-Antwort. Eine realistischere Bewertung würde ~20 Fragen verwenden.
import os, sys
import pandas as pd
import numpy as np
import ragas, datasets
from langchain_community.embeddings import HuggingFaceEmbeddings
from ragas.embeddings import LangchainEmbeddingsWrapper

from ragas.metrics import (
   # context_recall,
   # context_precision,
   # faithfulness,
   answer_relevancy,
   answer_similarity,
   answer_correctness
   )

# Read ground truth answers from file.
eval_df = pd.read_csv(file_path, header=0, skip_blank_lines=True)

# Possible LLM model choices to evaluate:
# openai gpt-4o = 'Custom_RAG_answer'
LLM_TO_EVALUATE = 'Custom_RAG_answer'
# LLM_TO_EVALUATE = 'llama3_ollama_answer'
# LLM_TO_EVALUATE = 'llama3_anyscale_answer'
# LLM_TO_EVALUATE = 'llama3_octoai_answer'
# LLM_TO_EVALUATE = 'llama3_groq_answer'
# LLM_TO_EVALUATE = 'mixtral_8x7b_anyscale_answer'

CONTEXT_TO_EVALUATE='Custom_RAG_context'
eval_metrics=[
    answer_relevancy,
    answer_similarity,
    answer_correctness,]
metrics = ['answer_relevancy', 'answer_similarity', 'answer_correctness']

# Change the default llm-as-critic, to save $.
LLM_NAME = "gpt-3.5-turbo"
ragas_llm = ragas.llms.llm_factory(model=LLM_NAME)

# Change the default embeddings to HuggingFace models.
EMB_NAME = "BAAI/bge-large-en-v1.5"
lc_embeddings = HuggingFaceEmbeddings(model_name=EMB_NAME)
ragas_emb = LangchainEmbeddingsWrapper(embeddings=lc_embeddings)

# Jede Metrik ändern.
for metric in metrics:
   globals()[metric].llm = ragas_llm
   globals()[metric].embeddings = ragas_emb

# Die Auswertung ausführen.
ragas_result, score = _eval_ragas.evaluate_ragas_model(
   eval_df, eval_metrics, LLM_TO_EVALUATE,
   CONTEXT_TO_EVALUATE, EVALUATE_WHAT)

# Die Ergebnisse anzeigen.
print(f"Using {eval_df.shape[0]} eval questions, Mean Score = {score}")
display(ragas_result.head())
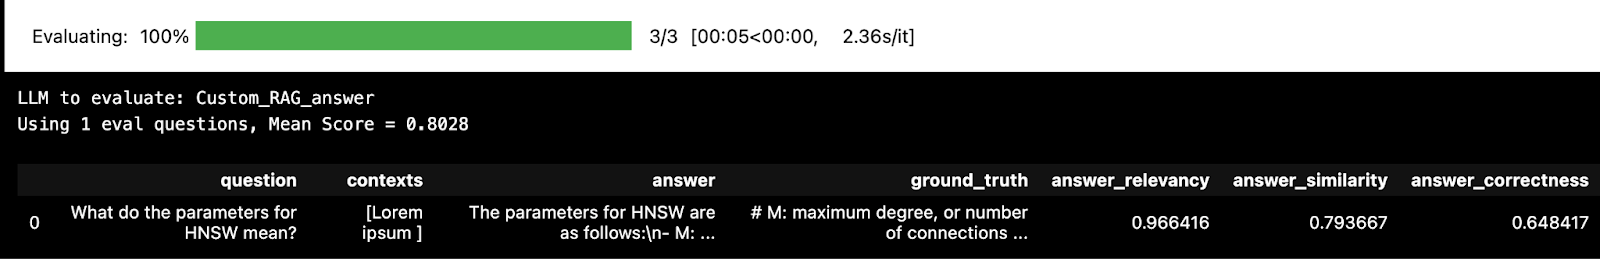
Unten finden Sie eine Tabelle, die die Ergebnisse zusammenfasst.
| Modell-Endpunkt | Antwort | Latenz (Sekunden) | Kosten | Ragas-Antwortscore |
Ollama Llama 3 | Gemäß dem bereitgestellten Kontext und den Quellen [1, 65535] gibt es im Hierarchical Navigable Small World Graph (HNSW) zwei Hauptparameter: * `M`: Maximaler Grad der Knoten auf jeder Ebene des Graphen. Er reicht von 2 bis 2048. * `ef` oder `efConstruction`: Dieser Parameter gibt einen Suchbereich an, der während der Indexerstellung oder der Zielsuche verwendet werden kann. Diese Parameter zielen darauf ab, die Leistung zu verbessern und den Kompromiss zwischen Recall-Rate (verbessert durch Erhöhung von ef) und Suchzeit (erhöht bei größeren M-Werten) zu steuern. | 13.74 | Kostenlos | 0.76 |
Anyscale endpoints Llama 3 | `Gemäß dem Kontext sind die Parameter für HNSW: * M: Maximaler Grad des Knotens, der von 2 bis 2048 reicht. Dieser Parameter begrenzt den maximalen Grad der Knoten auf jeder Ebene des Graphen. * efConstruction (beim Erstellen des Index): gibt einen Suchbereich beim Erstellen eines Index an. * ef (bei der Suche nach Zielen): gibt einen Suchbereich bei der Suche nach Zielen an. | |||
Quelle:[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md)'` | 5.94 | Kostenloser Playground | 0.80 | |
Anyscale Mixtral | `Der Parameter M für HNSW bezieht sich auf den maximalen Grad des Knotens, also die maximale Anzahl von Verbindungen, die ein Knoten in der Graphstruktur haben kann. Er reicht von 2 bis 2048. Zusätzlich sind efConstruction und ef Parameter, die verwendet werden, um den Suchbereich während der Indexerstellung bzw. der Zielsuche anzugeben. | |||
Quellen: 1.[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md) 2. [https://milvus.io/docs/index.md](https://milvus.io/docs/index.md)'` | 3.57 | Kostenloser Playground | 0.79 | |
OctoAI Llama 3 | `Gemäß dem bereitgestellten Kontext sind die Parameter für HNSW (Hierarchical Navigable Small World Graph): * M: Maximaler Grad des Knotens, der von 2 bis 2048 reicht. Dieser Parameter begrenzt den maximalen Grad der Knoten auf jeder Ebene des Graphen. * efConstruction: Ein Parameter, der beim Erstellen eines Index verwendet wird, um einen Suchbereich anzugeben. * ef: Ein Parameter, der bei der Suche nach Zielen verwendet wird, um einen Suchbereich anzugeben. | |||
Quelle:[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md) ` | 4.43 | $0.15 pro Million Tokens | 0.73 | |
Groq Llama 3 | `Gemäß dem bereitgestellten Kontext sind die Parameter für HNSW: * M: Maximaler Grad des Knotens, der von 2 bis 2048 reicht. * efConstruction: Ein Parameter, der beim Erstellen des Index verwendet wird, um einen Suchbereich anzugeben. * ef: Ein Parameter, der bei der Suche nach Zielen verwendet wird, um einen Suchbereich anzugeben. | |||
Quelle: [https://milvus.io/docs/index.md`](https://milvus.io/docs/index.md) | 1.21 | `Kostenlos | ||
| Beta` | 0.79 | |||
Openai gpt-4o | Die Parameter für HNSW sind wie folgt:``- M: Maximaler Grad des Knotens, der die Verbindungen begrenzt, die jeder Knoten im Graphen haben kann. Bereich ist [2, 2048].``- efConstruction: Parameter, der während der Indexerstellung verwendet wird, um einen Suchbereich anzugeben.``- ef: Parameter, der bei der Suche nach Zielen verwendet wird, um einen Suchbereich anzugeben.``Quellen:https://milvus.io/docs/index.md | 2.13 | `$5/M Eingabe | |
| $15/M Ausgabe` | 0.803 |
Quelle: Code des Autors und https://console.anyscale.com/v2/playground, https://console.groq.com/playground?model=llama3-70b-8192, https://octoai.cloud/text?selectedTags=Chat, https://openai.com/api/pricing/.
Fazit
Heute haben wir viele Optionen für Modelle und Inferenz-Endpunkte zur Auswahl für den G-Generation-Teil von RAG! Alle in diesem Blog ausprobierten Endpunkte weisen eine unterschiedliche Antwortqualität (wie von einem GPT-Kritiker bewertet), Latenzen und Kosten auf, die es zu berücksichtigen gilt.
Weiterlesen
How Zilliz Saw the Future of Vector Databases—and Built for Production
An inside look at how Zilliz built vector databases for real-world use, focusing on scalability, stability, and running them reliably at scale.
Zilliz Cloud Enterprise Vector Search Powers High-Performance AI on AWS
Zilliz Cloud on AWS powers secure, scalable, ultra-fast vector search for enterprise AI apps, with BYOC, sub-10ms latency, and zero-DevOps simplicity.
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.