Consensus создаёт агентный академический поиск по 400M+ научным источникам с помощью Zilliz Cloud
400 млн+
Научные источники доступны для поиска
~45 ms
P99 задержка плотного поиска в продакшене
на 14% выше
точность результатов поиска после добавления семантического поиска
в 4 раза больше
векторы всего за 2,5× размера кластера, без штрафа за задержку
1 день → 1 час
Полная переиндексация всей коллекции из более чем 400M векторов с помощью ежедневного пакетного импорта
Наша задача — делать лучшие исследования находимыми для всех, кто использует Consensus. Zilliz Cloud обеспечивает нашему исследовательскому агенту быстрый и качественный семантический поиск, напрямую расширяя охват доказательств, к которым он может обратиться.
Christian Salem
О Consensus
Consensus создает операционную систему для научных исследований: агентную платформу, которой пользуются более 10 миллионов исследователей, студентов и клиницистов из 12 500+ университетов, чтобы отбирать статьи, обобщать доказательства и автоматизировать утомительные части исследования, позволяя им вернуться к настоящей науке. На сегодняшний день Consensus обработал более 150 миллионов исследовательских вопросов и привлек 45 миллионов долларов, чтобы ускорить работу следующих 100 миллионов исследователей по всему миру.
 Consensus插图1.png
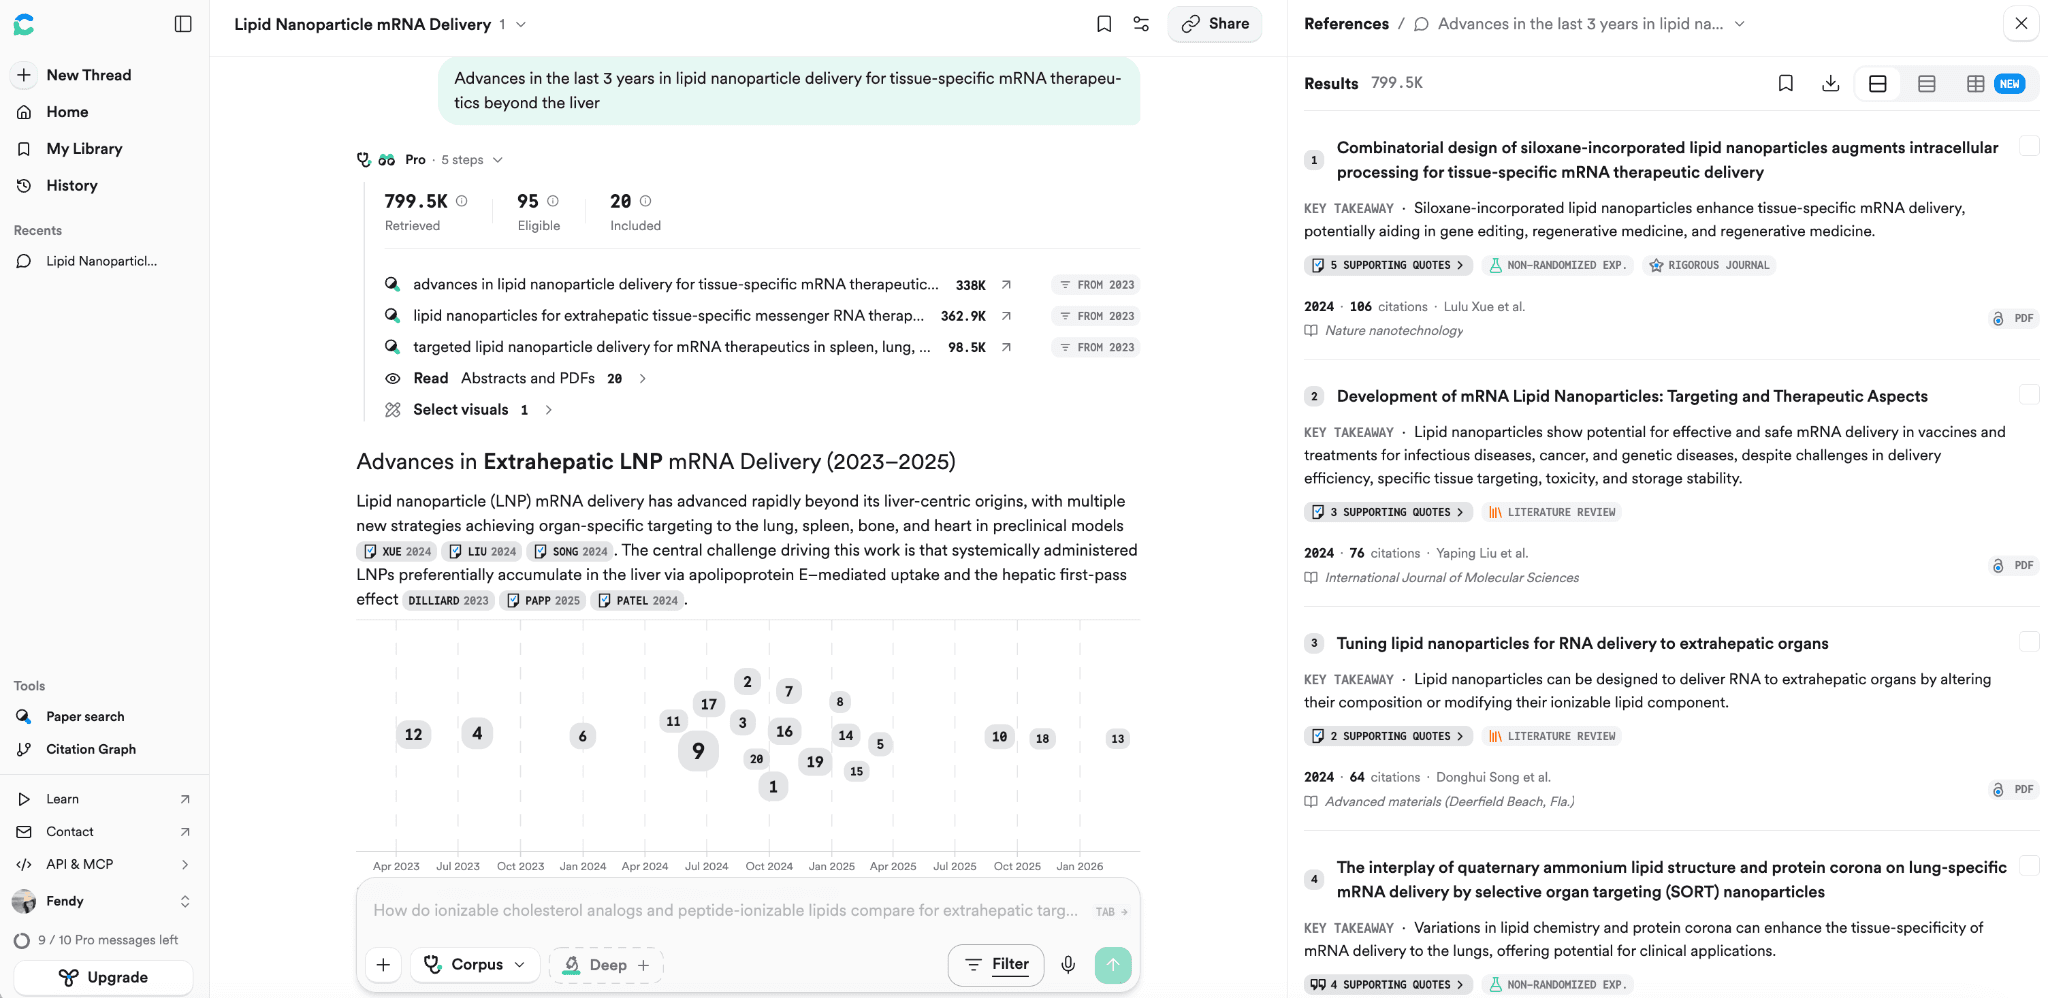
Фундамент платформы — это первоклассный агентный поиск по более чем 400 миллионам научных источников. Consensus никогда не отвечает на основе собственных знаний ИИ-модели; вместо этого каждое утверждение должно прослеживаться до реальной, найденной статьи, и исследовательский агент может вызывать поиск много раз, чтобы ответить на один вопрос. Продукт настолько хорош, насколько хороши статьи, которые он находит, что делает поиск сердцем Consensus. Zilliz Cloud обеспечивает работу одного из самых важных его компонентов: семантического поиска, который понимает, о чем на самом деле спрашивает исследователь, и находит исследования, отвечающие на этот вопрос.
Проблема
Поисковый движок Consensus ранее использовал два метода поиска: разреженный поиск и поиск по ключевым словам BM25. Они хорошо справлялись с большинством запросов. Но планка росла: Consensus переводил свой обзор литературы на агентную архитектуру, где один вопрос может превратиться во множество поисковых вызовов, поэтому поиск должен был находить нужные статьи и возвращать их быстро при каждом вызове. Ключевой и разреженный поиск пропускают статьи, в которых говорится то же самое, но с другой терминологией. Исследователи постоянно сталкиваются с этим, потому что статья, отвечающая на вопрос, часто относится к смежной области, использующей собственные термины для той же идеи. Поиск по плотным векторам — ключ к устранению этого разрыва, поэтому команда сначала протестировала его в Elasticsearch и столкнулась еще с тремя проблемами.
- Качество поиска падало при сотнях миллионов векторов. Чтобы разместить такое количество плотных векторов, команде пришлось сжимать их с помощью бинарного квантования, и сжатие приводило к измеримой потере качества ранжирования. Для исследовательского продукта это неправильный компромисс.
- Переиндексация всей коллекции занимала более 24 часов. Новым исследованиям приходилось ждать день или больше, прежде чем они становились доступными для поиска, а оценка каждой кандидатной модели эмбеддингов в продакшене стоила целого дня, что замедляло внедрение командой более качественных моделей.
- Увеличение векторов означало значительный рост счетов за хранение. При сотнях миллионов векторов любое увеличение размера векторов или охвата оплачивается для всей коллекции, поэтому команда держала векторы меньшего размера, чем хотела.
Команда отправилась на поиски специализированного движка для семантического поиска: высокое качество ранжирования, быстрое обновление коллекций, приемлемая экономика при масштабировании и управляемый продакшн-опыт, который не требовалось бы обслуживать собственными силами.
Почему Zilliz Cloud
Consensus провел реальное сравнение четырех вариантов: поиск по плотным векторам в Elasticsearch, который уже использовался; FAISS — самостоятельно развертываемая библиотека векторов с открытым исходным кодом, прототип которой команда создала; Pinecone; и Zilliz Cloud. Zilliz Cloud победил по четырем пунктам.
- Лучшие результаты без сжатия векторов. В собственных тестах команды Zilliz Cloud обеспечил более точные результаты поиска в масштабе сотен миллионов объектов, сохраняя высокую полноту, без сжатия, из-за которого раньше терялось качество.
- Полная перестройка коллекции примерно за час вместо более чем суток. Ежедневный пакетный импорт всей коллекции превращает полную перестройку из специального проекта в ночную задачу. Это также открывает возможность гораздо более быстрой итерации при тестировании новых моделей эмбеддингов.
- Снижение стоимости хранения при том же трафике и количестве векторов. Экономия позволила использовать векторы в 4 раза большего размера и с затратами до 4 раз ниже, что привело к заметно более высокой релевантности.
- Управляемый сервис с опытом разработчика, который понравился команде. Consensus прототипировал решение на FAISS и обнаружил, что он технически способен, но эксплуатация в продакшене означала бы принятие на себя оркестрации и операционных издержек, которые команда не хотела нести. Команда также сочла SDK Zilliz Cloud хорошо документированным и приятным для разработки, с простой консолью для повседневных операций с коллекциями.
Решение
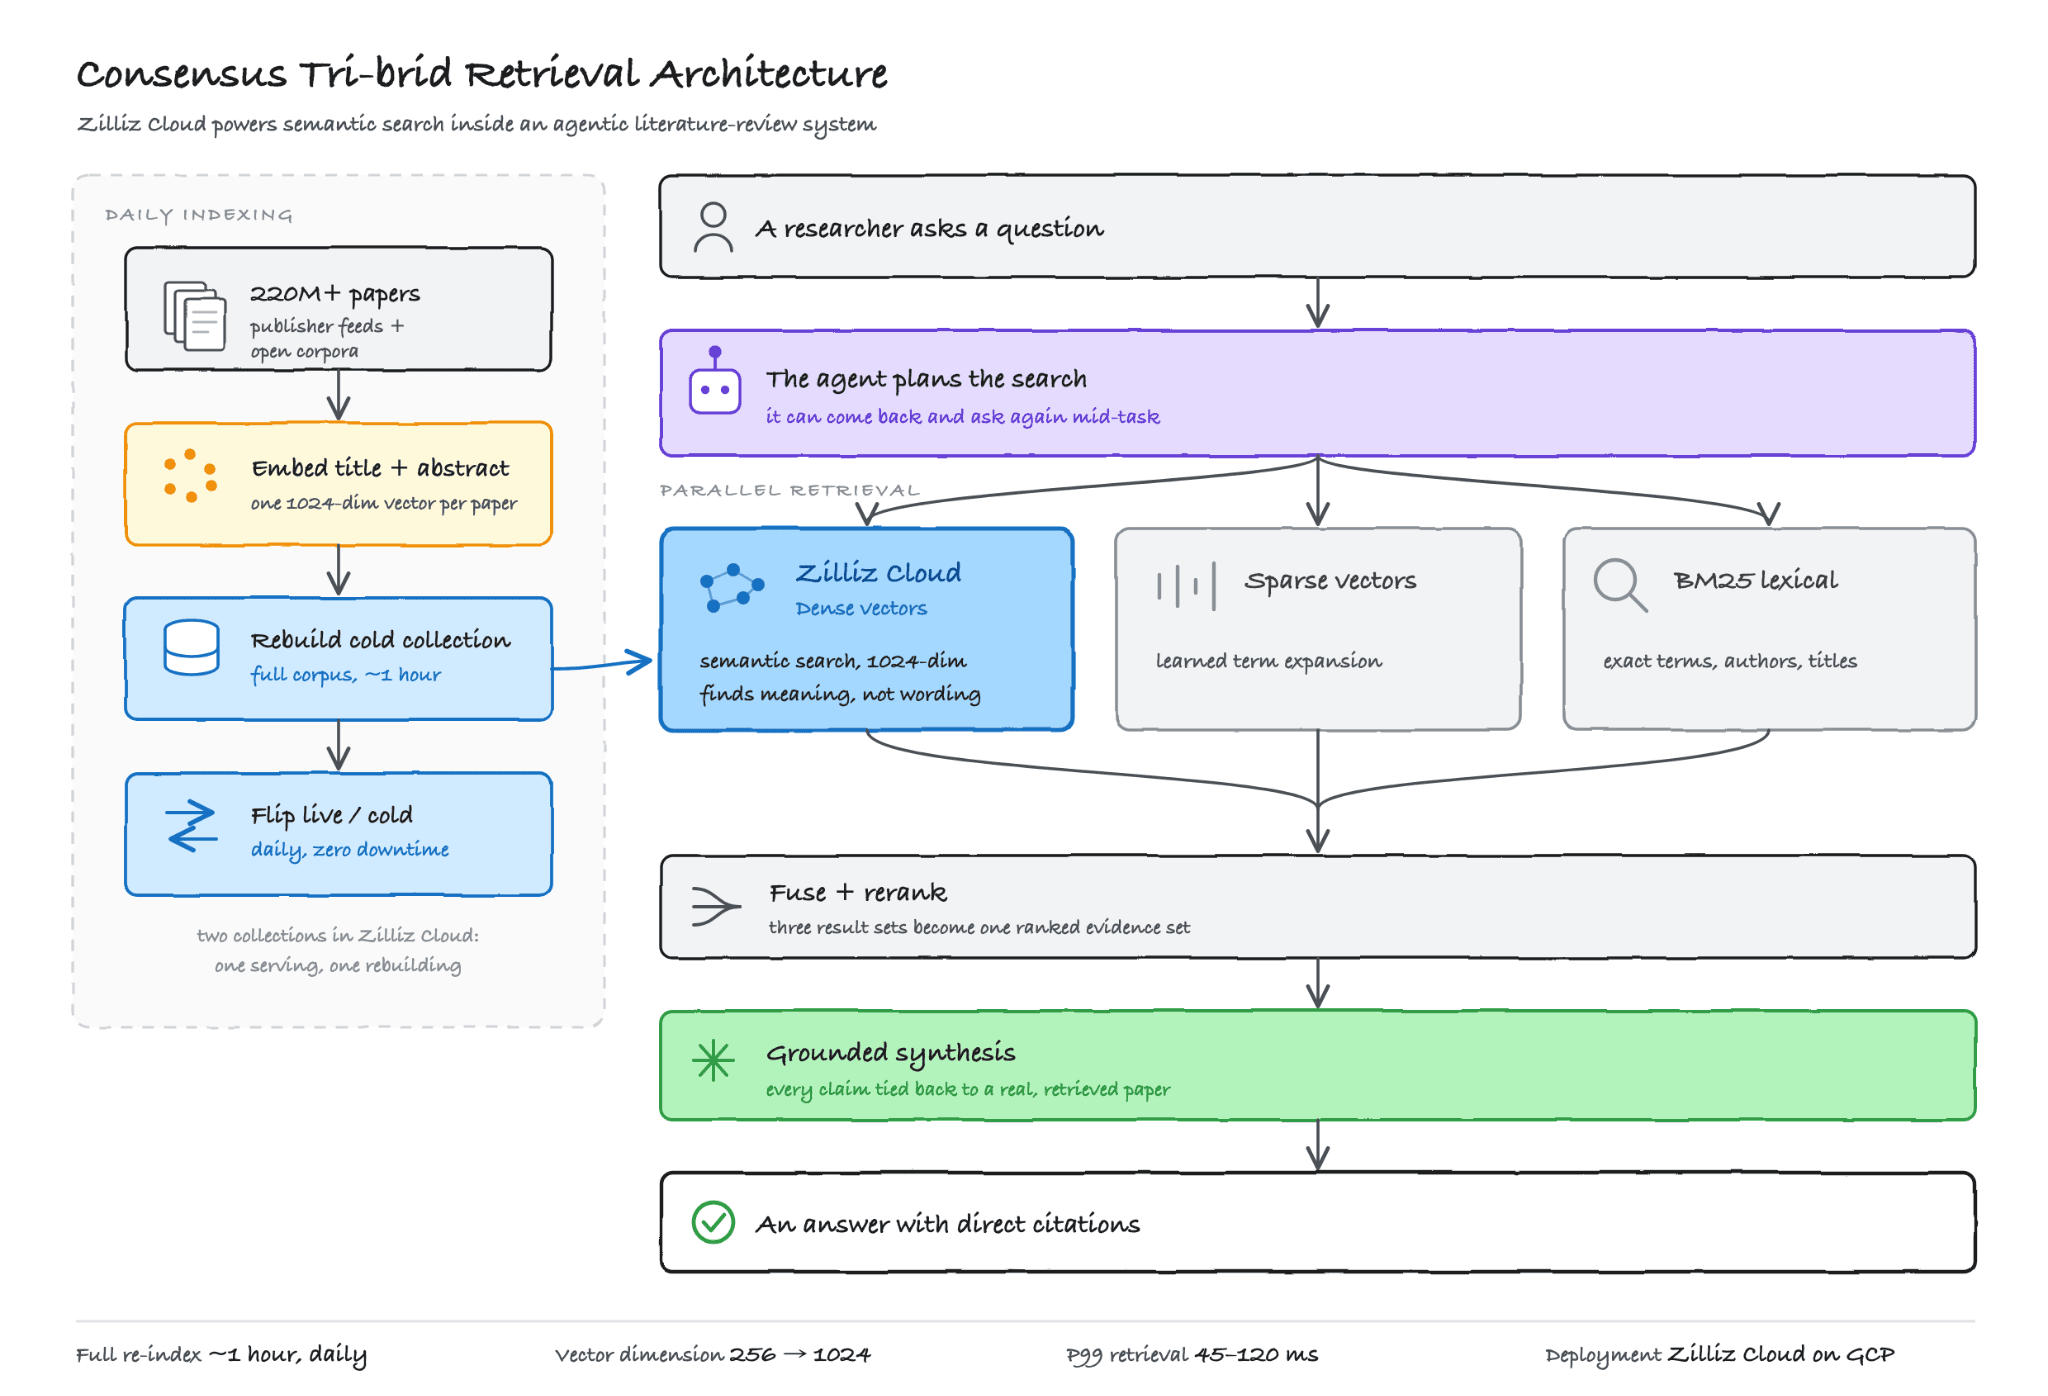
Consensus отвечает на исследовательский вопрос, извлекая нужные статьи или их фрагменты и синтезируя ответ из них, при этом каждое утверждение ссылается на реальную публикацию. Для поиска этих статей параллельно работают три пути извлечения — архитектура, которую команда называет tri-brid search, и Zilliz Cloud обеспечивает семантический слой поиска: сопоставление вопроса со статьей по смыслу, а не по используемым словам, и нахождение статей, которые пропускают другие пути. Он работает на Google Cloud вместе с остальным стеком.
 Concensus插图2.png
Во время запроса агент планирует поиск и вызывает извлечение как инструмент. Пути выполняются параллельно, их результаты объединяются и ранжируются в единый набор доказательств, а модель пишет ответ, привязывая каждое утверждение к извлеченной статье. Это механизм, лежащий в основе агента литературного обзора и Consensus Meter, который взвешивает опубликованные доказательства за и против утверждения.
Три дизайнерских решения обеспечивают эту работу.
Пара коллекций live/cold в Zilliz Cloud, перестраиваемая с нуля каждый день.
Обычный способ поддерживать индекс такого размера в актуальном состоянии — обновлять его на месте: обнаруживать изменения, записывать новые векторы, удалять старые и вести учет. Consensus пропускает все это. Он хранит две копии коллекции в Zilliz Cloud, в общей сложности более 400 млн векторов: одна обслуживает запросы, другая простаивает, и каждый день он перестраивает простаивающую копию с нуля с помощью пакетного импорта и переключает ее на live.
Это разумный дизайн только в том случае, если полная перестройка достаточно быстра для ежедневного выполнения, а хранилище достаточно дешево для второй копии. В предыдущей системе не выполнялось ни то, ни другое. В Zilliz Cloud выполняются оба условия: вся коллекция импортируется, индексируется и готова к работе примерно за час, при меньшей стоимости хранения. Поэтому более простой дизайн побеждает: в обслуживающую коллекцию никогда ничего не записывается, нет отставания для сверки, а новая модель эмбеддингов — это просто та же перестройка с другими векторами. Корпус всегда актуален, что гарантирует исследователям доступ к самым свежим публикациям.
«Что команда обнаружила в Zilliz, так это то, что мы можем фактически перезагружать всю коллекцию с нуля, поскольку это так быстро. У нас есть две копии индекса; мы загружаем весь объем за один час, а затем переключаем. Мы можем делать это практически ежедневно на данный момент. Это также значительно расширило возможности экспериментов, поскольку нет колебаний пробовать новые идеи». — Хит Хохвальд, технический лидер и менеджер по поиску, Consensus
Каждый источник встраивается из его названия и аннотации в единый вектор. Команда начала с размерности 256, предполагая, что стоимость и задержка будут расти пропорционально размеру вектора. В Zilliz Cloud увеличение размерности в четыре раза — с 256 до 1 024 — потребовало примерно 2,5× размера кластера, а не 4×, как ожидала команда, с очень небольшой дополнительной задержкой. На внутреннем бенчмарке команды эмбеддинги размерностью 1 024 обеспечили повышение качества найденных статей на 27% по сравнению с моделью меньшего размера, поэтому Consensus остановился на размерности 1 024.
Семантический поиск как инструмент, который агент вызывает напрямую.
Zilliz Cloud предоставляется агенту литературного обзора как вызываемый инструмент, а не скрыт за одним этапом поиска. Агент может переформулировать вопрос, искать с разных сторон и возвращаться за дополнительными результатами после прочтения найденного, поэтому одна задача может означать множество вызовов. Такой вызов инструментов работает только в том случае, если каждый вызов быстрый и точный, потому что медленный или неточный поиск умножается на каждый дополнительный вызов агента. При P99 ~45 мс на более чем 400 млн векторов семантический поиск достаточно быстр и точен, чтобы передать его агенту в качестве инструмента, позволяя ему добираться до последних труднодоступных статей, которые один запрос мог бы упустить.
Результаты и преимущества
- Снижение стоимости хранения до 4×, и сэкономленные средства пошли на улучшение поиска. Хранение стоит дешевле при том же трафике и количестве векторов, создавая пространство для манёвра, которое команда затем направила на качество.
- Точность результатов поиска на 14% выше после добавления семантического поиска, по данным собственного внутреннего бенчмарка Consensus. Выигрыш наиболее силён для статей, которые отвечают на вопрос словами, которые исследователь никогда не использовал, — прежний стек такие статьи упустил бы.
- Поиск с P99 ~45 мс на более чем 400 млн векторов — треть от целевого показателя P90 в 150 мс, установленного командой для Zilliz Cloud. Достаточно быстро, чтобы исследовательский агент мог искать, обдумывать и совершать несколько итераций в рамках одного запроса, а не получать одну попытку и иногда упускать критические результаты.
- В 4 раза большая размерность векторов (256 → 1 024) обошлась всего в 2,5× размера кластера на Zilliz Cloud, что примерно на 40% меньше, чем при линейном масштабировании, и без увеличения задержки. На внутреннем бенчмарке Consensus более крупные эмбеддинги обеспечили повышение качества найденных статей на 27%.
- Полная пересборка всей коллекции: 24+ часа → около 1 часа при ежедневном пакетном импорте. Consensus теперь пересобирает и заменяет всю коллекцию ежедневно, без перерыва в обслуживании. Новые исследования становятся доступными для поиска в день их появления.
- Цикл итераций ускоряется. Более крупные эмбеддинги, новые модели и новые стратегии поиска больше не нужно соизмерять с пересборкой, занимающей целый день, прежде чем можно будет увидеть, помогают ли они.
Что дальше
Каждое направление, в котором движется Consensus, усиливает нагрузку на Zilliz Cloud. Предоставление более широкого доступа к семантическому поиску через агентный фреймворк означает больше вызовов поиска на задачу и больше трафика к плотной коллекции. Новые модели эмбеддингов продолжат выходить в ежедневном ритме, который обеспечивает часовая пересборка. Фильтрация по метаданным, которая сейчас обрабатывается на уровне приложения, является кандидатом на перенос в Zilliz Cloud.
Самая большая возможность — это более активное использование полнотекстового контента. Consensus владеет лицензированным полнотекстовым контентом благодаря партнёрству с издателями, и добавление этой глубины в плотную коллекцию Zilliz — естественный следующий шаг: индексация тела каждой статьи, а не её названия и аннотации, увеличила бы коллекцию в несколько раз и позволила бы исследователям получать гораздо более точные совпадения.
«Consensus делает нечто по-настоящему сложное: делает мировую научную литературу доступной для поиска по смыслу — для агента, который может задавать одному и тому же корпусу вопросы дюжиной разных способов в рамках одной задачи. Мы гордимся тем, что Zilliz Cloud является поисковой основой этого проекта, и мы рады продолжать строить это вместе по мере масштабирования агентных исследований». — Джеймс Луан, технический директор Zilliz
Создавайте агентный ИИ с Zilliz Cloud
Агентные системы создают новую нагрузку на поиск: один запрос пользователя может превратиться в несколько семантических поисков, переформулировок и циклов сбора доказательств. Масштабируете ли вы RAG или создаёте агентный поиск, Zilliz Cloud предоставляет ту же поисковую основу, которая обеспечивает работу Consensus. Начните бесплатно с Zilliz Cloud или свяжитесь с нашей командой напрямую.
"Одно из самых значительных улучшений, которые мы наблюдаем, — это более качественная обработка запросов, релевантных по смыслу, но не по тексту. Более длинные и разговорные запросы также стали обрабатываться значительно лучше."
Heath Hohwald