




Как создать ИИ-чатбота с помощью Milvus и Towhee
Milvus, векторная база данных с открытым исходным кодом, — идеальная основа для любого AI-приложения, которому требуются эффективные и масштабируемые возможности векторного поиска, что делает ее выдающимся выбором для управления данными вашего чат-бота. Towhee — это развивающийся фреймворк для рабочих процессов машинного обучения, который упрощает процесс реализации и оркестрации сложных ML-моделей. Он также делает разработку вашего приложения управляемой и простой для понимания.
В этом руководстве вы узнаете, как создать простой AI-чат-бот на Python с использованием Milvus и Towhee. Вы сосредоточитесь на том, как загружать неструктурированные данные, анализировать их, хранить их с эмбеддингами и обрабатывать запросы.
Настройка вашей среды
Сначала создайте виртуальную среду Python для запуска вашего чат-бота.
Вот сеанс shell из Linux. Он создает среду, активирует ее и обновляет pip до последней версии.
[egoebelbecker@ares milvus_chatbot]$ python -m venv ./chatbot_venv
[egoebelbecker@ares milvus_chatbot]$ source chatbot_venv/bin/activate
(chatbot_venv) [egoebelbecker@ares milvus_chatbot]$ pip install --upgrade pip
Requirement already satisfied: pip in ./chatbot_venv/lib64/python3.11/site-packages (22.2.2)
Collecting pip
  Using cached pip-23.1.2-py3-none-any.whl (2.1 MB)
Installing collected packages: pip
  Attempting uninstall: pip
    Found existing installation: pip 22.2.2
    Uninstalling pip-22.2.2:
      Successfully uninstalled pip-22.2.2
Successfully installed pip-23.1.2
Затем установите пакеты, необходимые для запуска кода: pandas, jupyter, langchain, towhee, unstructured, milvus, pymilvus, sentence_transformers и gradio.
(chatbot_venv) [egoebelbecker@ares milvus_chatbot]$ pip install pandas jupyter langchain towhee unstructured milvus pymilvus sentence_transformers gradio
Сбор pandas
  Получение информации о зависимостях для pandas из https://files.pythonhosted.org/packages/d0/28/88b81881c056376254618fad622a5e94b5126db8c61157ea1910cd1c040a/pandas-2.0.3-cp311-cp311-manylinux_2_17_x86_64.manylinux2014_x86_64.whl.metadata
  Используется кэшированный pandas-2.0.3-cp311-cp311-manylinux_2_17_x86_64.manylinux2014_x86_64.whl.metadata (18 kB)
Сбор jupyter
  Используется кэшированный jupyter-1.0.0-py2.py3-none-any.whl (2.7 kB)
(фрагмент пропущен)
Установка собранных пакетов: webencodings, wcwidth, pytz, pure-eval, ptyprocess, pickleshare, json5, ipython-genutils, filetype, fastjsonschema, executing, backcall, zipp, XlsxWriter, xlrd, widgetsnbextension, websocket-client, webcolors, urllib3, uri-template, tzdata, typing-extensions, traitlets, tqdm, tornado, tinycss2, tenacity, tabulate, soupsieve, sniffio, six, send2trash, rpds-py, rfc3986-validator, rfc3986, regex, pyzmq, PyYAML, python-magic, python-json-logger, pypandoc, pygments, pycparser, psutil, prompt-toolkit, prometheus-client, platformdirs, pkginfo, pillow, pexpect, parso, pandocfilters, packaging, overrides, olefile, numpy, nest-asyncio, mypy-extensions, multidict, more-itertools, mistune, mdurl, markupsafe, markdown, lxml, jupyterlab-widgets, jupyterlab-pygments, jsonpointer, joblib, jeepney, idna, greenlet, frozenlist, fqdn, et-xmlfile, docutils, defusedxml, decorator, debugpy, click, charset-normalizer, chardet, certifi, babel, attrs, async-timeout, async-lru, yarl, typing-inspect, terminado, SQLAlchemy, rfc3339-validator, requests, referencing, qtpy, python-pptx, python-docx, python-dateutil, pydantic, pdf2image, openpyxl, numexpr, nltk, msg-parser, matplotlib-inline, marshmallow, markdown-it-py, jupyter-core, jinja2, jedi, jaraco.classes, importlib-metadata, comm, cffi, bleach, beautifulsoup4, asttokens, anyio, aiosignal, stack-data, rich, requests-toolbelt, readme-renderer, pandas, openapi-schema-pydantic, langsmith, jupyter-server-terminals, jupyter-client, jsonschema-specifications, dataclasses-json, cryptography, arrow, argon2-cffi-bindings, aiohttp, SecretStorage, pdfminer.six, langchain, jsonschema, isoduration, ipython, argon2-cffi, unstructured, nbformat, keyring, ipykernel, twine, qtconsole, nbclient, jupyter-events, jupyter-console, ipywidgets, towhee, nbconvert, jupyter-server, notebook-shim, jupyterlab-server, jupyter-lsp, jupyterlab, notebook, jupyter
Успешно установлены PyYAML-6.0.1 SQLAlchemy-2.0.19 SecretStorage-3.3.3 XlsxWriter-3.1.2 aiohttp-3.8.5 aiosignal-1.3.1 anyio-3.7.1 argon2-cffi-21.3.0 argon2-cffi-bindings-21.2.0 arrow-1.2.3 asttokens-2.2.1 async-lru-2.0.4 async-timeout-4.0.2 attrs-23.1.0 babel-2.12.1 backcall-0.2.0 beautifulsoup4-4.12.2 bleach-6.0.0 certifi-2023.7.22 cffi-1.15.1 chardet-5.1.0 charset-normalizer-3.2.0 click-8.1.6 comm-0.1.3 cryptography-41.0.2 dataclasses-json-0.5.14 debugpy-1.6.7 decorator-5.1.1 defusedxml-0.7.1 docutils-0.20.1 et-xmlfile-1.1.0 executing-1.2.0 fastjsonschema-2.18.0 filetype-1.2.0 fqdn-1.5.1 frozenlist-1.4.0 greenlet-2.0.2 idna-3.4 importlib-metadata-6.8.0 ipykernel-6.25.0 ipython-8.14.0 ipython-genutils-0.2.0 ipywidgets-8.0.7 isoduration-20.11.0 jaraco.classes-3.3.0 jedi-0.19.0 jeepney-0.8.0 jinja2-3.1.2 joblib-1.3.1 json5-0.9.14 jsonpointer-2.4 jsonschema-4.18.4 jsonschema-specifications-2023.7.1 jupyter-1.0.0 jupyter-client-8.3.0 jupyter-console-6.6.3 jupyter-core-5.3.1 jupyter-events-0.7.0 jupyter-lsp-2.2.0 jupyter-server-2.7.0 jupyter-server-terminals-0.4.4 jupyterlab-4.0.3 jupyterlab-pygments-0.2.2 jupyterlab-server-2.24.0 jupyterlab-widgets-3.0.8 keyring-24.2.0 langchain-0.0.248 langsmith-0.0.15 lxml-4.9.3 markdown-3.4.4 markdown-it-py-3.0.0 markupsafe-2.1.3 marshmallow-3.20.1 matplotlib-inline-0.1.6 mdurl-0.1.2 mistune-3.0.1 more-itertools-10.0.0 msg-parser-1.2.0 multidict-6.0.4 mypy-extensions-1.0.0 nbclient-0.8.0 nbconvert-7.7.3 nbformat-5.9.2 nest-asyncio-1.5.7 nltk-3.8.1 notebook-7.0.1 notebook-shim-0.2.3 numexpr-2.8.4 numpy-1.25.2 olefile-0.46 openapi-schema-pydantic-1.2.4 openpyxl-3.1.2 overrides-7.3.1 packaging-23.1 pandas-2.0.3 pandocfilters-1.5.0 parso-0.8.3 pdf2image-1.16.3 pdfminer.six-20221105 pexpect-4.8.0 pickleshare-0.7.5 pillow-10.0.0 pkginfo-1.9.6 platformdirs-3.10.0 prometheus-client-0.17.1 prompt-toolkit-3.0.39 psutil-5.9.5 ptyprocess-0.7.0 pure-eval-0.2.2 pycparser-2.21 pydantic-1.10.12 pygments-2.15.1 pypandoc-1.11 python-dateutil-2.8.2 python-docx-0.8.11 python-json-logger-2.0.7 python-magic-0.4.27 python-pptx-0.6.21 pytz-2023.3 pyzmq-25.1.0 qtconsole-5.4.3 qtpy-2.3.1 readme-renderer-40.0 referencing-0.30.0 regex-2023.6.3 requests-2.31.0 requests-toolbelt-1.0.0 rfc3339-validator-0.1.4 rfc3986-2.0.0 rfc3986-validator-0.1.1 rich-13.5.1 rpds-py-0.9.2 send2trash-1.8.2 six-1.16.0 sniffio-1.3.0 soupsieve-2.4.1 stack-data-0.6.2 tabulate-0.9.0 tenacity-8.2.2 terminado-0.17.1 tinycss2-1.2.1 tornado-6.3.2 towhee-1.1.1 tqdm-4.65.0 traitlets-5.9.0 twine-4.0.2 typing-extensions-4.7.1 typing-inspect-0.9.0 tzdata-2023.3 unstructured-0.8.7 uri-template-1.3.0 urllib3-2.0.4 wcwidth-0.2.6 webcolors-1.13 webencodings-0.5.1 websocket-client-1.6.1 widgetsnbextension-4.0.8 xlrd-2.0.1 yarl-1.9.2 zipp-3.16.2
(chatbot_venv) [egoebelbecker@ares milvus_chatbot]$
Вы можете найти Jupyter notebook с кодом для этого руководства здесь. Скачайте его, запустите Jupyter и загрузите notebook:
chatbot_venv) [egoebelbecker@ares milvus_chatbot]$ jupyter notebook milvus_chatbot.ipynb
[I 2023-07-31 11:29:01.748 ServerApp] Package notebook took 0.0000s to import
[I 2023-07-31 11:29:01.759 ServerApp] Package jupyter_lsp took 0.0108s to import
[W 2023-07-31 11:29:01.759 ServerApp] A `_jupyter_server_extension_points` function was not found in jupyter_lsp. Instead, a `_jupyter_server_extension_paths` function was found and will be used for now. This function name will be deprecated in future releases of Jupyter Server.
[I 2023-07-31 11:29:01.764 ServerApp] Package jupyter_server_terminals took 0.0045s to import
[I 2023-07-31 11:29:01.765 ServerApp] Package jupyterlab took 0.0000s to import
[I 2023-07-31 11:29:02.124 ServerApp] Package notebook_shim took 0.0000s to import
Создание чат-бота
Теперь давайте приступим к работе над чат-ботом.
Хранилище документов
Боту нужно хранить фрагменты документов и embeddings, которые Towhee извлекает из них. Именно для этого вы будете использовать Milvus. Вы уже установили Milvus Lite, легковесную версию Milvus, выше вместе с библиотекой milvus.
Вы можете запустить сервер из командной строки:
(chatbot_venv) [egoebelbecker@ares milvus_chatbot]$ milvus-server

    __  _________ _   ____  ______
   /  |/  /  _/ /| | / / / / / __/
  / /|_/ // // /_| |/ / /_/ /\ \
 /_/  /_/___/____/___/\____/___/ {Lite}

 Welcome to use Milvus!

 Version:   v2.2.12-lite
 Process:   139309
 Started:   2023-07-31 12:43:43
 Config:    /home/egoebelbecker/.milvus.io/milvus-server/2.2.12/configs/milvus.yaml
 Logs:      /home/egoebelbecker/.milvus.io/milvus-server/2.2.12/logs

 Ctrl+C to exit …
Или как часть кода вашего приложения, как показано в notebook:
from milvus import default_server

# Start Milvus service
default_server.start()

# # Stop Milvus service
# default_server.stop()
Установите переменные приложения и получите OpenAI API Key
Далее задайте несколько переменных и очистите все оставшиеся файлы SQLite. Ниже мы будем использовать SQLite для истории чата.
- MILVUS_URI - информация о подключении для серверов Milvus. Разбирается на host и port.
- MILVUS_HOST - host, на котором работает Milvus.
- MILVUS_PORT - port, который прослушивает сервер.
- DROP_EXIST - удалять существующие коллекции Milvus при запуске.
- EMBED_MODEL - модель sentence_transformers, которую код будет использовать для создания embeddings
- COLLECTION_NAME - имя коллекции Milvus для данных и embeddings
- DIM - размерность embeddings, которые модель создает для каждого фрагмента текста
- OPENAI_API_KEY - ключ для LLM API
import getpass
import os

MILVUS_URI = 'http://localhost:19530'
[MILVUS_HOST, MILVUS_PORT] = MILVUS_URI.split('://')[1].split(':')
DROP_EXIST = True
EMBED_MODEL = 'all-mpnet-base-v2'
COLLECTION_NAME = 'chatbot_demo'
DIM = 768

OPENAI_API_KEY = getpass.getpass('Enter your OpenAI API key: ')

if os.path.exists('./sqlite.db'):
    os.remove('./sqlite.db')
Запустите этот код, чтобы определить переменные и ответить на запрос API key.
Пример pipeline
Далее пора скачать некоторые данные и сохранить их в Milvus. Но прежде чем вы это сделаете, давайте рассмотрим пример pipeline для скачивания и обработки неструктурированных данных.
Для этого примера вы будете использовать страницы документации Towhee. Вы можете попробовать разные сайты, чтобы увидеть, как код обрабатывает разные наборы данных.
Этот код использует pipelines Towhee:
- input - начинает новый pipeline с переданным в него источником
- map - использует ops.text_loader() для получения URL и сопоставления его с 'doc'
- flat_map - использует ops.text_splitter() для обработки документа в "chunks" для хранения
- output - закрывает и подготавливает pipeline к использованию
Передайте этот pipeline в DataCollection, чтобы увидеть, как он работает.
from towhee import pipe, ops, DataCollection

pipe_load = (
    pipe.input('source')
        .map('source', 'doc', ops.text_loader())
        .flat_map('doc', 'doc_chunks', ops.text_splitter(chunk_size=300))
        .output('source', 'doc_chunks')
)
DataCollection(pipe_load('https://towhee.io')).show()
Вот вывод из show():
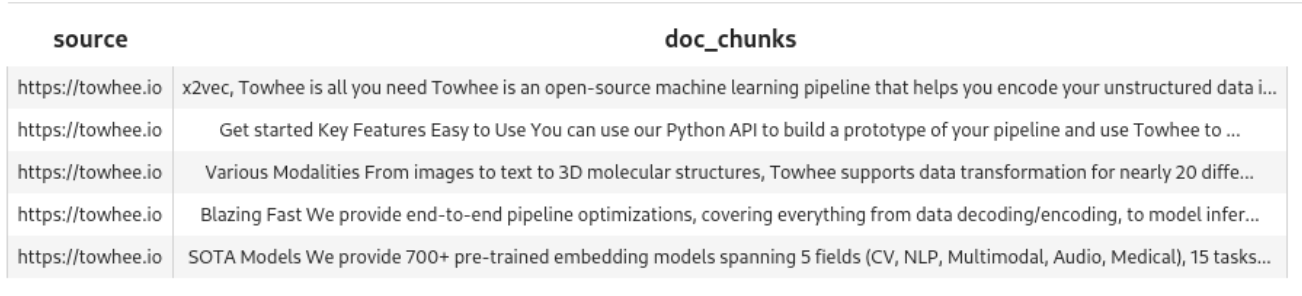
Конвейер создал пять фрагментов из документа.
Пример конвейера embedding
Конвейер извлек данные и создал фрагменты. Вам также нужно создать embeddings. Давайте посмотрим на еще один пример конвейера.
В этом используется map() для запуска ops.sentence_embedding.sbert() для каждого фрагмента. В этом примере мы передаем один блок текста.
pipe_embed = (
    pipe.input('doc_chunk')
        .map('doc_chunk', 'vec', ops.sentence_embedding.sbert(model_name=EMBED_MODEL))
        .map('vec', 'vec', ops.np_normalize())
        .output('doc_chunk', 'vec')
)

text = '''SOTA Models

We provide 700+ pre-trained embedding models spanning 5 fields (CV, NLP, Multimodal, Audio, Medical), 15 tasks, and 140+ model architectures.
These include BERT, CLIP, ViT, SwinTransformer, data2vec, etc.
'''

DataCollection(pipe_embed(text)).show()
Запустите этот код, чтобы увидеть, как конвейер обрабатывает один текстовый блок.
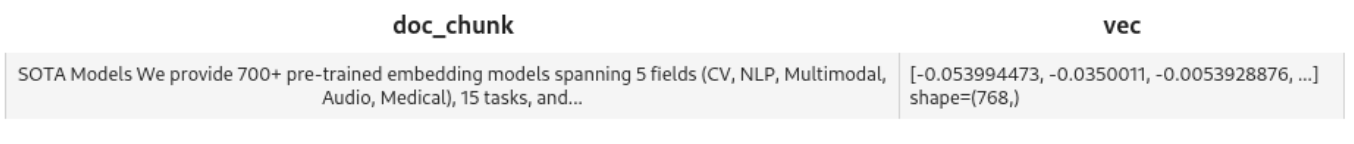
Подготовка Milvus
Теперь вам нужна коллекция для хранения данных. Этот блок определяет create_collection(), которая использует MILVUS_HOST и MILVUS_PORT для подключения к Milvus, удаления любых существующих коллекций с указанным именем и создания новой с такой схемой:
- id - целочисленный идентификатор
- embedding - вектор чисел с плавающей точкой для embeddings
- text - соответствующий текст для embeddings
from pymilvus import (
    connections, utility, Collection,
    CollectionSchema, FieldSchema, DataType
)

def create_collection(collection_name):
    connections.connect(host=MILVUS_HOST, port=MILVUS_PORT)

    has_collection = utility.has_collection(collection_name)

    if has_collection:
        collection = Collection(collection_name)
        if DROP_EXIST:
            collection.drop()
        else:
            return collection

    # Create collection
    fields = [
        FieldSchema(name='id', dtype=DataType.INT64, is_primary=True, auto_id=True),
        FieldSchema(name='embedding', dtype=DataType.FLOAT_VECTOR, dim=DIM),
        FieldSchema(name='text', dtype=DataType.VARCHAR, max_length=500)
    ]
    schema = CollectionSchema(
        fields=fields,
        description="Towhee demo",
        enable_dynamic_field=True
        )
    collection = Collection(name=collection_name, schema=schema)

    index_params = {
        'metric_type': 'IP',
        'index_type': 'IVF_FLAT',
        'params': {'nlist': 1024}
        }
    collection.create_index(
        field_name='embedding',
        index_params=index_params
    )
    return collection
Конвейер вставки
Пришло время обработать ваш входной текст и вставить его в Milvus. Начнем с конвейера, который объединяет то, что вы изучили выше.
Эта функция:
- Создает новую коллекцию
- Извлекает данные
- Разбивает их на фрагменты
- Создает embeddings с использованием EMBED_MODEL
- Вставляет текст и embeddings в Milvus
load_data = (
    pipe.input('collection_name', 'source')
        .map('collection_name', 'collection', create_collection)
        .map('source', 'doc', ops.text_loader())
        .flat_map('doc', 'doc_chunk', ops.text_splitter(chunk_size=300))
        .map('doc_chunk', 'vec', ops.sentence_embedding.sbert(model_name=EMBED_MODEL))
        .map('vec', 'vec', ops.np_normalize())
        .map(('collection_name', 'vec', 'doc_chunk'), 'mr',
             ops.ann_insert.osschat_milvus(host=MILVUS_HOST, port=MILVUS_PORT))
        .output('mr')
)
Вот это в действии. Запустите его для страницы Wikipedia о Frodo Baggins.
project_name = 'towhee_demo'
data_source = 'https://en.wikipedia.org/wiki/Frodo_Baggins'
mr = load_data(COLLECTION_NAME, data_source)

print('Doc chunks inserted:', len(mr.to_list()))
Это вставляет 408 фрагментов с эмбеддингами:
2023-07-31 16:50:53,369 - 139993906521792 - node.py-node:167 - INFO: Begin to run Node-_input
2023-07-31 16:50:53,371 - 139993906521792 - node.py-node:167 - INFO: Begin to run Node-create_collection-0
2023-07-31 16:50:53,373 - 139993881343680 - node.py-node:167 - INFO: Begin to run Node-text-loader-1
2023-07-31 16:50:53,374 - 139993898129088 - node.py-node:167 - INFO: Begin to run Node-text-splitter-2
2023-07-31 16:50:53,376 - 139993872950976 - node.py-node:167 - INFO: Begin to run Node-sentence-embedding/sbert-3
2023-07-31 16:50:53,377 - 139993385268928 - node.py-node:167 - INFO: Begin to run Node-np-normalize-4
2023-07-31 16:50:53,378 - 139993376876224 - node.py-node:167 - INFO: Begin to run Node-ann-insert/osschat-milvus-5
2023-07-31 16:50:53,379 - 139993368483520 - node.py-node:167 - INFO: Begin to run Node-_output

(snip)

Categories:
2023-07-31 18:07:53,530 - 140552729257664 - logger.py-logger:14 - DETAIL: Skipping sentence because does not exceed 5 word tokens
Categories
2023-07-31 18:07:53,532 - 140552729257664 - logger.py-logger:14 - DETAIL: Skipping sentence because does not exceed 3 word tokens
Hidden categories
2023-07-31 18:07:53,533 - 140552729257664 - logger.py-logger:14 - DETAIL: Skipping sentence because does not exceed 3 word tokens
Hidden categories
2023-07-31 18:07:53,533 - 140552729257664 - logger.py-logger:14 - DETAIL: Not narrative. Text does not contain a verb:

Hidden categories:
2023-07-31 18:07:53,534 - 140552729257664 - logger.py-logger:14 - DETAIL: Skipping sentence because does not exceed 5 word tokens
Hidden categories

Doc chunks inserted: 408
Поиск в базе знаний
Теперь, когда эмбеддинги и текст сохранены в Milvus, вы можете выполнять поиск по ним.
Эта функция создает конвейер запросов. Самый важный шаг — вот этот:
ops.ann_search.osschat_milvus(host=MILVUS_HOST, port=MILVUS_PORT,
                              **{'metric_type': 'IP', 'limit': 3, 'output_fields': ['text']}))
osschat_milvus ищет среди эмбеддингов совпадения с отправленным текстом.
Вот весь конвейер:
pipe_search = (
    pipe.input('collection_name', 'query')
        .map('query', 'query_vec', ops.sentence_embedding.sbert(model_name=EMBED_MODEL))
        .map('query_vec', 'query_vec', ops.np_normalize())
        .map(('collection_name', 'query_vec'), 'search_res',
             ops.ann_search.osschat_milvus(host=MILVUS_HOST, port=MILVUS_PORT,
                                           **{'metric_type': 'IP', 'limit': 3, 'output_fields': ['text']}))
        .flat_map('search_res', ('id', 'score', 'text'), lambda x: (x[0], x[1], x[2]))
        .output('query', 'text', 'score')
)
Попробуйте:
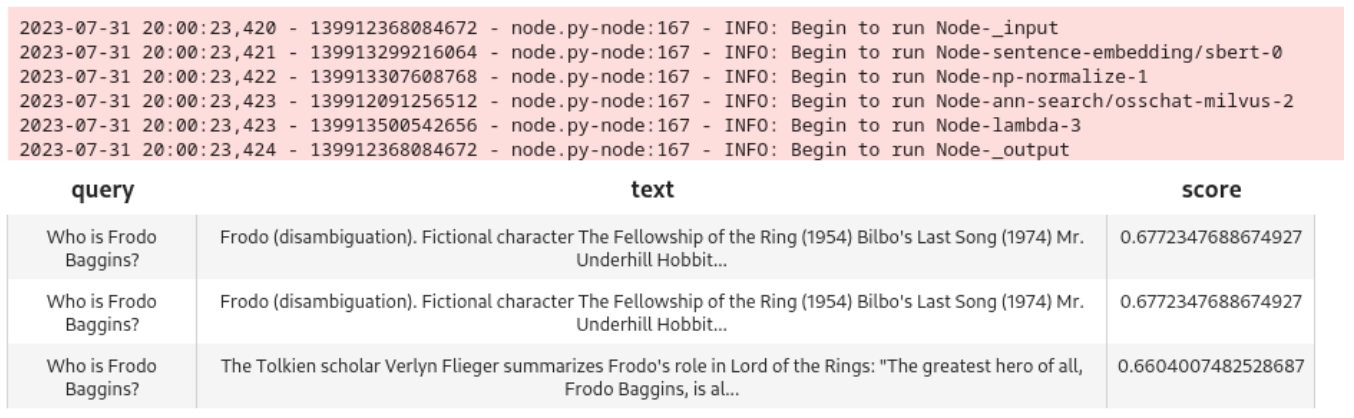
query = 'Who is Frodo Baggins?'
DataCollection(pipe_search(project_name, query)).show()
Модель хорошо справляется с извлечением трех наиболее близких совпадающих узлов:
Добавление LLM
Теперь пришло время добавить большую языковую модель (LLM), чтобы пользователи могли вести беседу с чат-ботом. В этом примере мы будем использовать ChatGPT и OpenAI API.
История чата
Чтобы получить лучшие результаты от LLM, нужно сохранять историю чата и передавать ее вместе с запросами. Для этого шага вы будете использовать SQLite.
Вот функция для получения истории:
pipe_get_history = (
    pipe.input('collection_name', 'session')
        .map(('collection_name', 'session'), 'history', ops.chat_message_histories.sql(method='get'))
        .output('collection_name', 'session', 'history')
)
А вот функция для ее сохранения:
pipe_add_history = (
    pipe.input('collection_name', 'session', 'question', 'answer')
        .map(('collection_name', 'session', 'question', 'answer'), 'history', ops.chat_message_histories.sql(method='add'))
        .output('history')
)
Конвейер запросов LLM
Теперь нам нужен конвейер для отправки запросов в ChatGPT.
Этот конвейер:
- выполняет поиск в Milvus с использованием запроса пользователя
- собирает текущую историю чата
- отправляет запрос, результаты поиска Milvus и историю чата в ChatGPT
- Добавляет результат ChatGPT в историю чата
- Возвращает результат вызывающей стороне
chat = (
    pipe.input('collection_name', 'query', 'session')
        .map('query', 'query_vec', ops.sentence_embedding.sbert(model_name=EMBED_MODEL))
        .map('query_vec', 'query_vec', ops.np_normalize())
        .map(('collection_name', 'query_vec'), 'search_res',
            ops.ann_search.osschat_milvus(host=MILVUS_HOST,
                                        port=MILVUS_PORT,
                                        **{'metric_type': 'IP', 'limit': 3, 'output_fields': ['text']}))
        .map('search_res', 'knowledge', lambda y: [x[2] for x in y])
        .map(('collection_name', 'session'), 'history', ops.chat_message_histories.sql(method='get'))
        .map(('query', 'knowledge', 'history'), 'messages', ops.prompt.question_answer())
        .map('messages', 'answer', ops.LLM.OpenAI(api_key=OPENAI_API_KEY,
                                                model_name='gpt-3.5-turbo',
                                                temperature=0.8))
        .map(('collection_name', 'session', 'query', 'answer'), 'new_history', ops.chat_message_histories.sql(method='add'))
        .output('query', 'history', 'answer', )
)
Давайте протестируем этот конвейер перед подключением его к GUI:
new_query = 'Where did Frodo take the ring?'
DataCollection(chat(COLLECTION_NAME, new_query, session_id)).show()
Вот вывод и результаты в notebook:
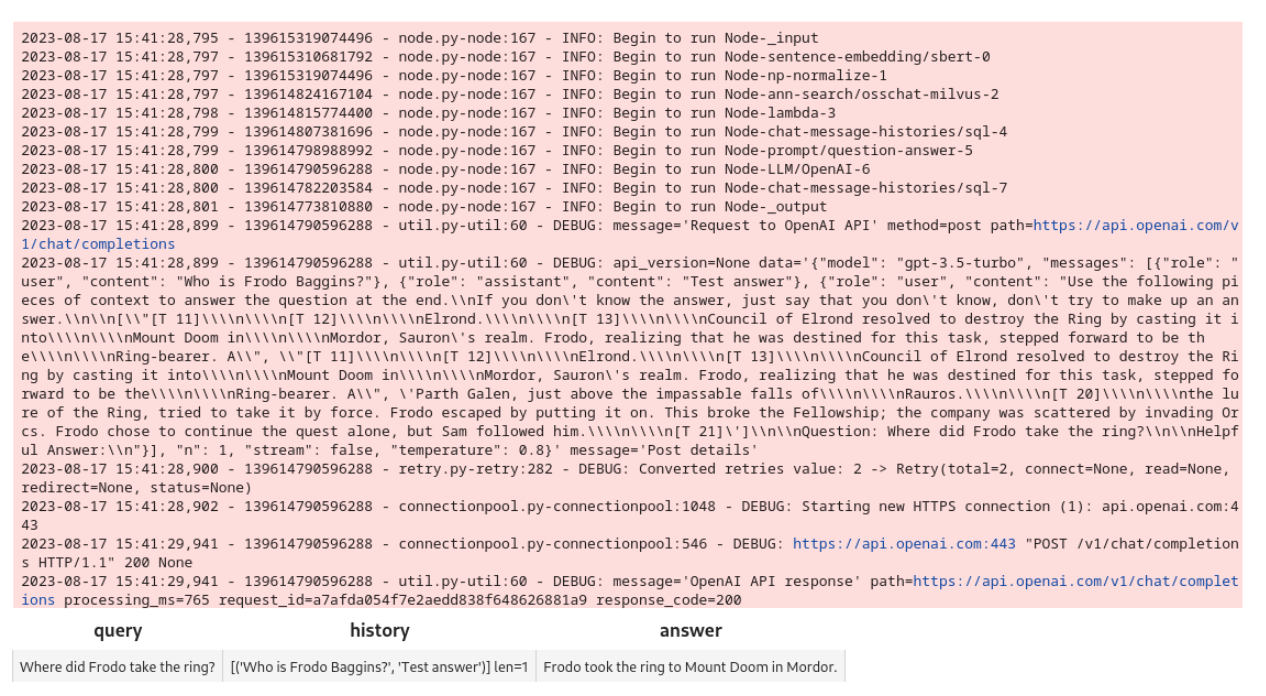
Конвейер работает. Давайте соберем интерфейс Gradio.
GUI Gradio
Сначала вам нужны функции для создания идентификатора сессии и ответа на запросы из интерфейса.
Эти функции создают ID сессии с использованием UUID и принимают сессию и запрос для конвейера запросов.
import uuid
import io

def create_session_id():
    uid = str(uuid.uuid4())
    suid = ''.join(uid.split('-'))
    return 'sess_' + suid

def respond(session, query):
    res = chat(COLLECTION_NAME, query, session).get_dict()
    answer = res['answer']
    response = res['history']
    response.append((query, answer))
    return response
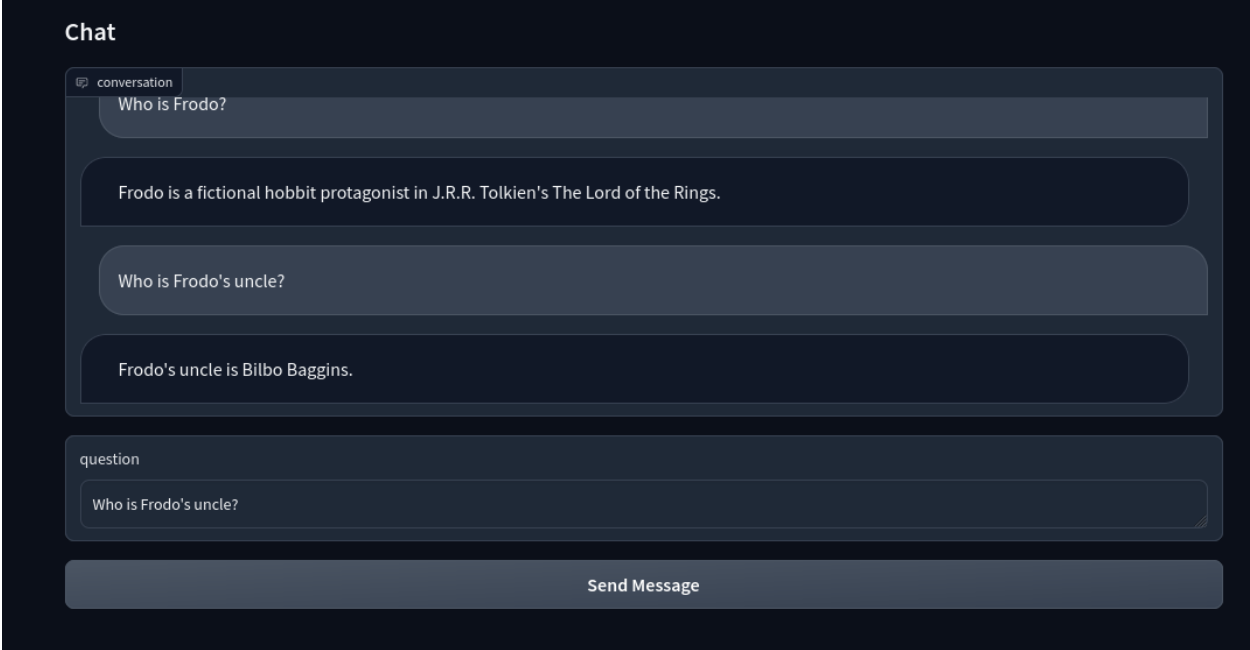
Далее интерфейс Gradio использует эти функции для создания чатбота.
Он использует Blocks API для создания интерфейса ChatBot. Кнопка Send Message использует функцию respond для отправки запросов в ChatGPT.
import gradio as gr

with gr.Blocks() as demo:
    session_id = gr.State(create_session_id)

    with gr.Row():
        with gr.Column(scale=2):
            gr.Markdown('''## Chat''')
            conversation = gr.Chatbot(label='conversation').style(height=300)
            question = gr.Textbox(label='question', value=None)

            send_btn = gr.Button('Send Message')
            send_btn.click(
                fn=respond,
                inputs=[
                    session_id,
                    question
                ],
                outputs=conversation,
            )

demo.launch(server_name='127.0.0.1', server_port=8902)
Вот как это выглядит:
Теперь у вас есть интеллектуальный чатбот на базе LLM с Milvus!
Резюме
В этом посте мы создали конвейеры Towhee для загрузки неструктурированных данных, их обработки для получения embeddings и хранения этих embeddings в Milvus. Затем мы создали конвейер запросов для функции чата и подключили чатбот к LLM. В итоге мы получили интеллектуального чатбота.
В этом руководстве показано, насколько легко создавать приложения с Milvus. Milvus предоставляет множество преимуществ при интеграции в приложения, особенно в те, которые полагаются на машинное обучение и искусственный интеллект. Он предлагает высокоэффективные, масштабируемые и надежные возможности поиска по сходству векторов и аналитики, критически важные для таких приложений, как чат-боты, рекомендательные системы, а также распознавание изображений или текста.
Этот пост был написан Eric Goebelbecker. Eric работал на финансовых рынках Нью-Йорка в течение 25 лет, разрабатывая инфраструктуру для рыночных данных и сетей протокола обмена финансовой информацией (FIX). Он любит говорить о том, что делает команды эффективными (или не такими эффективными!).
Читать далее

Data Deduplication at Trillion Scale: How to Solve the Biggest Bottleneck of LLM Training
Explore how MinHash LSH and Milvus handle data deduplication at the trillion-scale level, solving key bottlenecks in LLM training for improved AI model performance.
The Great AI Agent Protocol Race: Function Calling vs. MCP vs. A2A
Compare Function Calling, MCP, and A2A protocols for AI agents. Learn which standard best fits your development needs and future-proof your applications.
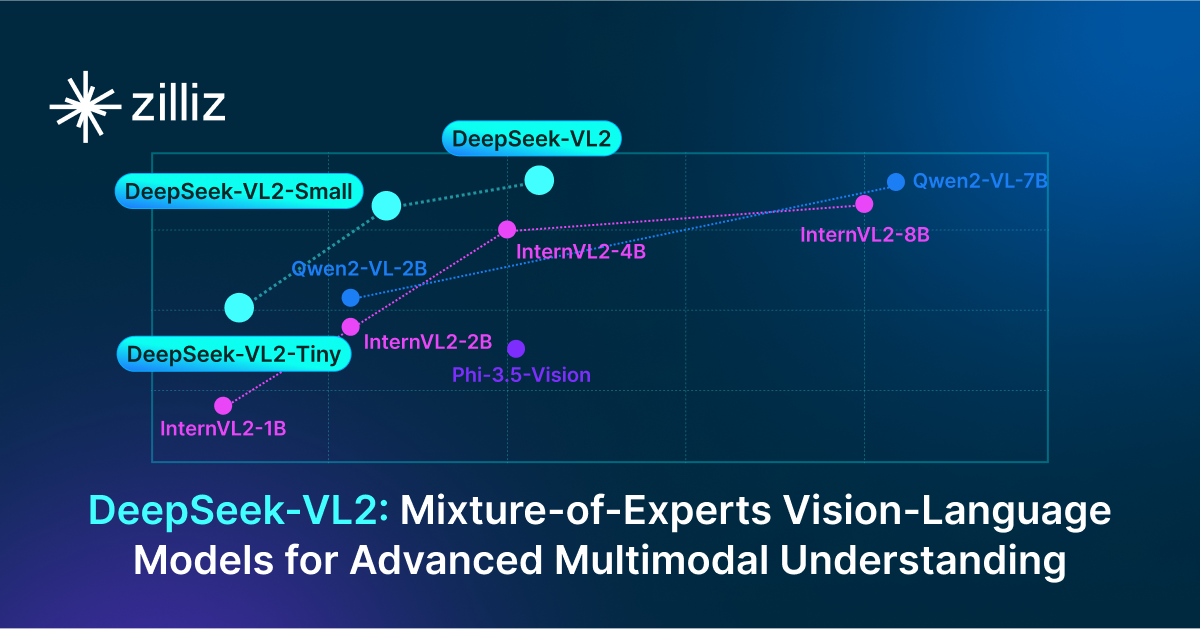
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.