OpenArt unterstützt multimodale Suche für 8M+ KI-Videoersteller mit Zilliz Cloud
25 s → 300 ms
P99-Suchlatenz, ES → Zilliz
~85% niedriger
Kosten nach der Migration berechnen
Native Multi-Vektor-Suche
Bild- und Textvektoren gemeinsam abgefragt
456 Mio.
Vektoren migriert ohne erneutes Einbetten
Kreative erstellen nicht ein einzelnes Bild und gehen dann. Sie bauen eine Figur, eine Welt, eine Geschichte auf, und alles, was sie je generiert haben, wird zum Material für die nächste Szene. Zilliz Cloud ermöglicht es uns, diese gesamte Bibliothek wie ein einziges kreatives Gedächtnis zu behandeln.
John Qiao
Über OpenArt
OpenArt ist eine der weltweit am häufigsten genutzten KI-Plattformen für Bild- und Videogenerierung mit über 8 Millionen Kreativen – Hobbyisten, Marketingfachleuten und professionellen Unterhaltungsschaffenden. Sie bringt über 100 Modelle von Google, OpenAI, Seedance und anderen auf einer einzigen Leinwand zusammen, aber die Modelle sind das austauschbare Element. Was OpenArt darüber hinaus baut, ist Kontinuität: ein Character Builder, der eine Figur über Szenen hinweg beibehält, One-Click Story für Multi-Szenen-Erzählungen und eine Storyboard-Suite, die Kreative für die Erstellung von Trailern, Anzeigen und Social-Videos nutzen. Die dahinterstehende Ambition ist es, KI-native IP für jeden Kreativen erreichbar zu machen – Figuren und Welten, die bestehen bleiben und wachsen, statt Bilder, die das nicht tun.
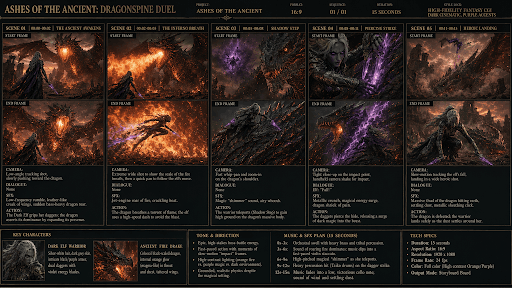
Kontinuität ist der schwierige Teil, und nicht nur zum Zeitpunkt der Generierung. Die Herausforderung bei KI-Videos besteht nicht darin, fünfzehn gute Sekunden zu erzeugen – sondern die nächsten fünfzehn zu erzeugen und sicherzustellen, dass sie zur gleichen Geschichte gehören. Das hat auch eine nachgelagerte Konsequenz: Kreative kehren über Monate zu einer Welt zurück, und alles, was sie je generiert haben, wird Referenzmaterial für die nächste Szene. Der eigene Back-Katalog eines Kreativen muss über die Bedeutung auffindbar sein und nicht über Dateiname oder Datum – und genau hier setzt OpenArt auf Zilliz Cloud.
Die Herausforderung
Die Suchfunktion für Kreative bei OpenArt lief auf dem Vektor-Suchdienst von Elasticsearch. Das funktionierte gut, solange die Bibliothek klein war. Bis zu dem Zeitpunkt, als die Generierungshistorie ein paar hundert Millionen Vektoren überschritt, waren vier Dinge kaputtgegangen.
- Die P99-Suchlatenz erreichte 25 Sekunden. Das Index-Lifecycle-Management von Elasticsearch ist für Logdaten ausgelegt, daher wurden OpenArts Indizes etwa alle 90 Tage von Hot zu Warm zu Cold zu Frozen rotiert, und der Großteil des Korpus landete im Frozen-Tier – aber Vektorsuche hat ein gegensätzliches Zugriffsmuster, denn das Ranking eines Top-K bedeutet, alles zu bewerten. Jede Suche griff auf den Frozen-Tier zu und zog Daten zur Beantwortung über das Netzwerk zurück.
- Die Anzahl der Indizes wuchs exponentiell. Elasticsearch erstellte mindestens einen neuen Index alle 90 Tage und führte sie nie zusammen, sodass die Anzahl der Indizes, über die eine Abfrage verteilt werden musste, sich ständig vervielfachte. Bei einer Bibliothek, die nur immer größer wird, prognostizierte das Team, dass die Suche innerhalb von etwa zwei Jahren drastisch nachlassen würde.
- OpenArt zahlte für eine ganze Suchplattform, um nur eine einzige eng begrenzte Funktion davon zu nutzen. Darüber hinaus war der Cluster überdimensioniert, weil das Team die Größe festgelegt hatte, bevor es die tatsächlichen Anforderungen der Arbeitslast gemessen hatte.
- Multi-Vektor-Abruf musste von Hand implementiert werden. Elasticsearch hatte keine native Möglichkeit, einen Bildvektor und einen Textvektor zusammen abzufragen, daher musste OpenArt einen eigenen Dual-kNN-Algorithmus schreiben und Komponenten von Drittanbietern einbinden, um beide Suchen auszuführen, die Ergebnisse zu fusionieren und zu filtern – ein permanenter Wartungspunkt für eine Fähigkeit, die nicht das Unterscheidungsmerkmal von OpenArt ist.
Warum Zilliz Cloud
Das Engineering-Team von OpenArt evaluierte Pinecone und Qdrant, aber keiner der beiden passte. Das Team hatte außerdem in den frühen Tagen des Unternehmens selbst Milvus betrieben und mochte es; was damals dagegen sprach, war der operative Aufwand des Self-Hostings. Zilliz Cloud räumte diesen Einwand aus dem Weg: Sie wird von demselben Team entwickelt, das hinter Open-Source-Milvus steht, und ist zu 100 % mit den Milvus-APIs kompatibel, sodass das vorhandene Wissen und der Client-Code des Teams übernommen werden konnten.
Benchmarks mit OpenArts eigenen Daten bestätigten die Leistungsfähigkeit, und die Evaluierung endete an diesem Punkt. Vier Dinge zeichnen Zilliz Cloud aus:
Eine Architektur, die darauf ausgelegt ist, wie Vektorsuche Daten liest. Zilliz Cloud verwaltet die Speicherebenen selbst auf Basis der Datentemperatur: Es verschiebt Daten in den Cache, wenn sie häufig abgerufen werden, oder in den Cold Storage, wenn sie nicht benötigt werden — ohne eine Lifecycle-Policy, um die sich die Anwendung kümmern müsste. Eine segmentweise automatische Kompaktierung führt Daten im Hintergrund zusammen, während sie wachsen. Diese beiden Fähigkeiten adressieren genau die Fehlerbilder, mit denen OpenArt zu kämpfen hatte — das Durchlaufen eingefrorener Speicherebenen und die unbegrenzte Vermehrung von Indizes — sodass OpenArts Suche nicht langsamer wird, wenn die Bibliothek wächst.
Native Multi-Vektor-Suche. Eine einzelne Zilliz-Cloud-Collection enthält mehrere Vektorfelder und fragt sie gemeinsam in einer Anfrage ab, wobei die Ergebnisse über eine konfigurierbare Gewichtung fusioniert werden. Genau das hatte OpenArt zuvor manuell auf Basis von Elasticsearch aufgebaut, und die native Verfügbarkeit dieser Funktion ermöglichte es dem Team, den eigenen Code zu löschen.
Preisgestaltung an bedarfsgerechte Rechenleistung gekoppelt, nicht an gespeicherte Daten. Eine der Alternativen rechnete nach Datenvolumen ab — die falsche Achse für ein kreatives Archiv, in dem der Bestand endlos wächst, aber nur ein Bruchteil zu jedem Zeitpunkt abgefragt wird. Das bedarfsbasierte Computemodell von Zilliz Cloud ermöglicht es OpenArt, die Größe an die benötigte Leistung anzupassen und sie bei sich ändernder Arbeitslast neu zu dimensionieren, statt eine Steuer auf die eigene Historie zu zahlen.
Betreibbar ohne Infrastrukturspezialisten. Ein verwalteter Dienst muss auch im Alltag von den Menschen nutzbar sein, die ihn betreiben. OpenArt fand die Konsole klar genug, um sie intuitiv zu bedienen, ohne Dokumentation zu lesen — ein deutlicher Kontrast zu einer Allzweck-Suchplattform mit einem Jahrzehnt angesammelter Funktionen, die man nie nutzen würde.
"Wir bedienen Millionen von Kreativen, daher muss jedes Infrastrukturteil schnell, vorhersagbar und ohne Überwachung auskommen. Zilliz Cloud ist eine der wenigen, die diese Hürde beim ersten Versuch genommen hat." — Danny Xiong, Software Engineer, OpenArt
Die Lösung: Wie Zilliz Cloud OpenArt unterstützt
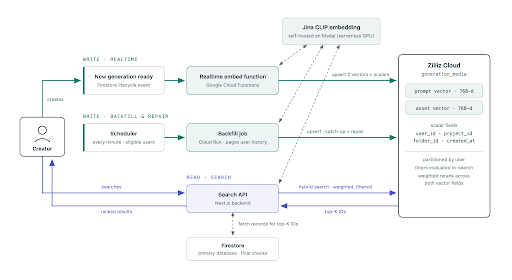
OpenArt nutzt Zilliz Cloud, um hinter dem Suchfeld die Vektorsuche über die eigene Generierungshistorie eines Kreativen auszuführen, verfügbar für Abonnenten in berechtigten Tarifen. Ein Kreativer, der im Laufe von Monaten Tausende von Bildern und Clips erstellt hat, tippt einen Begriff ein — einen Charakternamen, eine Stimmung, eine Szene — und erhält seine eigenen früheren Arbeiten zurück, sortiert nach Bedeutung statt nach Dateiname oder Datum.
Diese Aufgabe ist schwerer, als sie klingt, denn eine Generierung kommt ohne Metadaten an. Es gibt keinen Titel, kein Tag, keinen Ordner. Nur zwei Artefakte beschreiben sie: das Asset selbst und der Prompt, der sie erzeugt hat. OpenArt indexiert beide, denn jedes trägt etwas in sich, das das andere nicht hat — der Prompt enthält, worum der Kreative gebeten hat, in Namen, Absicht und Stilwörtern, und das Asset enthält, was das Modell tatsächlich produziert hat, was häufig nicht dasselbe ist. Die Suche in nur einem von beiden verliert die Hälfte der Bibliothek.
OpenArt verteilt die Arbeit auf drei Dienste.
- Die Anwendung und die primäre Datenbank von OpenArt laufen auf Google Cloud.
- Der Embedding-Dienst läuft auf Modal — einem Jina-CLIP-Modell, das das Team selbst auf einer serverlosen GPU-Funktion hostet.
- Vektorspeicher und -abruf übernimmt Zilliz Cloud. Das Team behält die Modellebene unter eigener Kontrolle und gibt die Ebene ab, die skalieren muss.
KI-Bild- und Videogenerierung entsteht kontinuierlich und wird erst viel später durchsucht. Deshalb hat OpenArt das System als zwei unabhängige Hälften aufgebaut, die zu völlig unterschiedlichen Zeiten und in unterschiedlichem Tempo laufen.
- Der Schreibpfad wandelt jede neue Generierung in Vektoren um und legt sie in Zilliz Cloud ab. Er läuft ständig im Hintergrund, ausgelöst durch Erstellungsereignisse, und niemand wartet darauf.
- Der Lesepfad läuft nur, wenn ein Kreativer etwas in das Suchfeld tippt. Er muss in wenigen hundert Millisekunden eine Antwort liefern, denn jemand schaut auf einen Ladeindikator.
Die Schreibseite liegt nie im Abfragepfad — der einzige Ort, an dem sie sich treffen, ist die Collection selbst. Genau diese Trennung sorgt dafür, dass sich kontinuierliche Aufnahme nie als Abfragelatenz bemerkbar macht.
Der Schreibpfad: Wie OpenArt eine Generierung in zwei Vektoren verwandelt
- Ein Creator mit einem berechtigten Plan generiert ein Bild oder einen Clip, und OpenArt schreibt einen Snapshot davon in seine primäre Datenbank auf Google Cloud.
- Eine Google Cloud Function wird durch dieses Ereignis ausgelöst und ruft OpenArts Embedding-Dienst auf Modal auf. Da Jina CLIP Bilder und Text in denselben Vektorraum abbildet, liefert ein einziges Modell dem Team beide benötigten Vektoren.
- OpenArt schreibt diese beiden Vektoren in die Zilliz Cloud – einen für das generierte Asset, einen für den zugrunde liegenden Prompt – zusammen mit der Generierungs-ID und den Skalar-Feldern, nach denen der Lesepfad filtert: Benutzer-ID und Projekt-ID.
OpenArt behandelt Videos über denselben Weg, indem es ein Standbild aus jedem generierten Clip erfasst und als Bild einbettet, sodass Clips zusammen mit Standbildern abrufbar sind, ohne eine zweite Pipeline.
Außerdem ist die Suche eine kostenpflichtige Funktion, daher muss der gesamte bisherige Katalog eines berechtigten Creators durchsuchbar werden, nicht nur das, was er von diesem Tag an erstellt. Ein geplanter Backfill-Job läuft kontinuierlich im Hintergrund, erfasst Creator mit berechtigten Plänen und ruft die Historie jedes Einzelnen seitenweise über denselben Embed-und-Write-Weg ab. Er dient zugleich als Sicherheitsnetz der Pipeline: Was der Echtzeitpfad nicht schreibt, holt der Backfill bei einem späteren Durchlauf nach.
Der Lesepfad: Wie OpenArt eine Suche beantwortet
- Ein Creator gibt eine Suchanfrage ein, und OpenArt sendet sie an dasselbe bei Modal gehostete Modell, um sie in einen Query-Vektor umzuwandeln.
- OpenArt führt eine einzige Multi-Vektor-Suche in der Zilliz Cloud über beide Vektorfelder aus, mit konfigurierten Gewichten zwischen ihnen, und fügt die Benutzer- und Projektfilter hinzu.
- Die Zilliz Cloud führt die beiden Ergebnismengen zusammen, wertet die Filter innerhalb der Suche aus und nicht erst danach, und gibt die top K zurück. OpenArt führt vor der Darstellung einen finalen Abgleich und Filter gegen seine eigene Datenbank auf Google Cloud durch.
OpenArt fordert mehr als tausend Ergebnisse pro Suchanfrage an – ein ungewöhnlich großes top K für semantische Suche, das eher durch die Arbeitslast als durch die Oberfläche bedingt ist: Bei einem intensiv nutzenden Creator übersteigt das Datenmaterial eines einzelnen Projekts bereits tausend Elemente, und eine breite Suchanfrage wie „Mann“ liefert zu Recht ein Vielfaches davon.
Dieselbe Suchanfrage sah auf dem alten Stack völlig anders aus. Sie verteilte sich auf jeden Index, den die Lifecycle-Richtlinie je erstellt hatte, die meisten davon eingefroren, und zog Daten über das Netzwerk zurück, bis sie ein top K einordnen konnte. Auf der Zilliz Cloud macht OpenArt einen einzigen Aufruf an eine einzige Collection und hat in etwa 300 Millisekunden eine Antwort.
Wie OpenArt zwei Suchen in eine zusammengeführt hat
Die Kombination der Bild- und Promptergebnisse ist genau das, wofür OpenArt die Dual-kNN-Fusionsschicht auf Elasticsearch handgebaut hatte. Da die Zilliz Cloud mehrere Vektorfelder nativ abfragt, entfernte das Team diesen Code und bildete den Abruf als einzelne Anforderung ab – und kapselte die Gewichtung zwischen den beiden Feldern in einem Feature-Flag. Relevanz wurde zu etwas, das OpenArt in der Produktion justiert, statt es neu zu implementieren.
Wie OpenArt migriert ist
OpenArt migrierte einen Altbestand von etwa 456 Millionen Vektoren und nutzte den Umstieg für eine Datenbereinigung: Es wurden Datensätze entfernt, die das Produkt nicht mehr benötigte, und Fehler behoben, die der alte Erfassungspfad stillschweigend eingeführt hatte. Eine Abgrenzungsentscheidung hielt das Projekt im Rahmen: Das Team behielt sein bestehendes Embedding-Modell. Hunderte Millionen Assets neu einzubetten hätte aus einer Migration einen Neuaufbau gemacht. Da die Zilliz Cloud Vektoren von beliebigen Modellen speichert, die ein Kunde wählt, verlagerte OpenArt Speicherung und Abruf, ohne die Modellebene zu berühren.
Ergebnisse & Vorteile
- Die Suchlatenz sank von 25 Sekunden mit Elasticsearch auf etwa 300 Millisekunden beim P99 — etwa 80× schneller, und der Unterschied zwischen einem Suchfeld, das Creator meiden, und einem, das sie nutzen.
- Die Rechenkosten wurden um etwa 85 % gesenkt — dieselbe Arbeitslast, auf einer Engine, die dafür gebaut wurde.
- OpenArt hat den selbstgebauten Fusionsalgorithmus aus der Produktionspipeline entfernt. Mit nativem Multi-Vektor-Search in Zilliz Cloud sind der Dual-kNN-Code und sein Drittanbieter-Klebcode weg, und die Relevanzoptimierung ist eine Konfigurationsänderung und kein Engineering-Projekt.
- 456 Millionen Vektoren wurden zu Zilliz Cloud verschoben, ohne auch nur ein einziges Embedding neu zu berechnen, weil Zilliz Cloud modellagnostisch ist — so bleibt die Migration eine Migration und kein Neuaufbau.
Der strategische Nutzen ist der, den OpenArt am deutlichsten spürt: Die Suche ist kein Infrastrukturprojekt mehr. Die Entwicklerressourcen, die in die Aufrechterhaltung des Retrievals geflossen waren, flossen in das Produkt zurück — insbesondere in die Agenten-Ebene, um die OpenArt jetzt sein gesamtes Erlebnis herum aufbaut.
OpenArts Ratschläge für Teams, die eine Vektordatenbank wählen
Nachdem es dies zweimal durchgemacht hat — zunächst weg vom selbst gehosteten Milvus, dann weg von Elasticsearch —, destilliert das Team von OpenArt die Entscheidung zu einer kurzen Liste.
- Prüfen Sie, ob das Preismodell zur Form Ihrer Workload passt. Fragen Sie, wofür Sie abgerechnet werden, und dann, welche Ihrer Kennzahlen am schnellsten wächst. Wenn das dieselbe Zahl ist, haben Sie ein Problem, das mit Ihrem Erfolg skaliert.
- Prüfen Sie, ob die Architektur zu Ihrem Zugriffsmuster passt. Lesen Sie das Speicherdesign, nicht die Feature-Liste. Eine Richtlinie, die Daten mit der Zeit aus dem Zugriff entfernt, ist für Logs in Ordnung und für die Vektorsuche falsch.
- Kennen Sie Ihre eigenen Leistungsanforderungen, bevor Sie Ressourcen bereitstellen. OpenArts größter Kostenfehler war die Überdimensionierung von Hardware für eine Workload, die es nicht profiliert hatte. Messen Sie zuerst.
- Behandeln Sie eine Migration als Chance, Dinge zu verwerfen. Alles, was Sie übertragen, bezahlen und durchsuchen Sie für immer.
Was kommt als Nächstes
OpenArt nutzt Zilliz Cloud heute für die Suche im eigenen Generierungsverlauf eines Creators und plant, sie in drei Richtungen zu erweitern:
- Die gemeinsame Asset- und Vorlagenbibliothek, in der sowohl die Beschriftungsarbeit des Teams als auch die Empfehlungsvorlagen semantische Suche benötigen.
- Skalare Filterung, die während der Migration verschoben wurde und nun auf der Liste wieder nach oben rückt.
- Agenten-Gedächtnis, das das Team am meisten interessiert. Während OpenArt von eigenständigen Tools zu einem Agenten übergeht, der sie orchestriert — eine 15-sekündige Generierung zu einem ein- oder dreiminütigen Film ausdehnt —, muss der Agent sich über Sitzungen hinweg merken, in welchem Projekt sich ein Creator befindet und für welche Marke er Werbung macht. Das ist ein Problem der Vektorsuche, und hier erwartet OpenArt, dass die Nutzung von Zilliz Cloud als Nächstes wächst.
OpenArt definiert, wie KI-native Kreativität aussieht: Millionen von Creators, die Figuren und Geschichten aufbauen, die über Szenen hinweg zusammenhängen. Wir sind stolz darauf, dass Zilliz Cloud das Retrieval-Fundament dahinter ist, und freuen uns darauf, weiter mit ihnen zu bauen, wenn ihre Agenten beginnen, sich zu erinnern. — James Luan, CTO, Zilliz
Zilliz Cloud kostenlos testen
Zilliz Cloud ist eine vollständig verwaltete Vektordatenbank und Vector Lakebase für Enterprise-KI, kompatibel mit Milvus-APIs. Sie bietet hochleistungsfähige Vektorsuche in massivem Maßstab mit Sicherheit auf Enterprise-Niveau und wartungsfreiem Betrieb, erweitert um die Offenheit, Skalierbarkeit und Wirtschaftlichkeit multimodaler Data Lakes — eine einzige Plattform zum Suchen, Analysieren und Verwalten unstrukturierter Daten für KI in der Produktion.
Ob Sie multimodale Suche, RAG oder Agenten-Gedächtnis aufbauen: Zilliz Cloud bietet dieselbe Retrieval-Grundlage, die auch OpenArt antreibt. Jetzt kostenlos mit Zilliz Cloud starten, oder sprechen Sie mit unserem Team.
„Unsere alte Suche benötigte bei P99 25 Sekunden. Das war inakzeptabel. Zilliz Cloud hat sie auf unter eine Drittelsekunde gebracht und uns ermöglicht, den Retrieval-Code zu löschen, den wir bisher selbst gewartet hatten."
Danny Xiong