So migrieren Sie von Chroma zu Zilliz Cloud
Laut Chromas Wind-Down-Zeitplan stellt Chroma Cloud am 22. November 2026 das Annehmen von Schreibvorgängen ein und am 22. Dezember 2026 das Bedienen von Lesevorgängen. Wenn Ihre Anwendung in Chroma Cloud schreibt, braucht sie vor dem ersten Datum ein neues Zuhause, und Ihre Daten müssen vor dem zweiten Datum exportiert sein.
Open-Source-Chroma ist nicht betroffen. Aber wenn Sie es selbst betreiben und in Produktion nehmen möchten, mit mehr Daten, als eine Maschine bequem speichert, einem Verfügbarkeitsziel und niemandem, der gern Bereitschaft dafür übernehmen würde, ist der Umzug derselbe, nur ohne die Frist.
Diese Anleitung führt beide Varianten zu Zilliz Cloud, der vollständig verwalteten Vektordatenbank auf Basis von Open-Source-Milvus. Ihre Embeddings werden unverändert übernommen, sodass nichts neu eingebettet wird, und Ihre IDs, Dokumente, URIs und Metadaten kommen mit. Wenn Sie lieber Open-Source-Milvus selbst betreiben möchten, gelten dieselben Schritte; siehe Umzug von Chroma zu Open-Source-Milvus in Schritt 1.
Bevor Sie beginnen
Sie benötigen:
- Einen Zilliz-Cloud-Cluster mit öffentlichem Endpoint und einem API-Schlüssel. Registrieren Sie sich, falls Sie keinen haben. Der kostenlose Plan umfasst bis zu 5 Collections; für mehr nutzen Sie einen Serverless- oder Dedicated-Cluster.
- Ihre Chroma-Verbindungsdetails. In Chroma Cloud zeigt das Bedienfeld Connect im Dashboard Ihren API-Schlüssel, die Tenant-ID und den Datenbanknamen. Für selbst gehostetes Chroma benötigen Sie die Serveradresse sowie ein Token oder einen Benutzernamen und ein Passwort, falls Sie die Authentifizierung aktiviert haben.
- Python 3.10 oder höher mit beiden Clients, um die Kopie zu prüfen und Ihre Anwendung zu aktualisieren:
pip install chromadb==1.5.9 pymilvus==3.0.2
- Docker, falls Sie den Open-Source-Vector-Transport-Service verwenden (Option B in Schritt 1).
Wie Ihre Daten abgebildet werden
Jede Chroma-Collection wird zu einer Zilliz-Cloud-Collection mit vier Feldern. Metadaten werden in das dynamische Feld der Collection aufgenommen, sodass jeder Metadaten-Schlüssel filterbar bleibt, genau wie in Chroma. Die Zilliz-Cloud-Dokumentationsseite Migrate from Chroma to Zilliz Cloud enthält die vollständige Abbildung, einschließlich der Konvertierung von Metadaten-Typen in typisierte Felder.
| Chroma | Zilliz Cloud |
|---|---|
| Collection | Collection mit demselben Namen, wobei - in _ umgewandelt wird: support-docs wird zu support_docs. Zilliz-Cloud-Namen akzeptieren nur Buchstaben, Ziffern und Unterstriche und dürfen nicht mit einer Ziffer beginnen. Ein Name wie kb.v2 oder 2024-notes benötigt daher einen neuen Namen, wenn Sie die Kopie einrichten. Das gilt auch für eines von zwei Namen, die nach der Umwandlung identisch sind, wie support-docs und support_docs. |
id | id, der VARCHAR-Primärschlüssel. IDs ändern sich nicht. |
embedding | embedding, ein FLOAT_VECTOR-Feld mit derselben Dimension. |
document | document, ein nullable VARCHAR-Feld mit bis zu 65.535 Bytes. |
uri | uri, ein nullable VARCHAR-Feld. Die URI-Zeichenfolge wird kopiert; die Datei, auf die sie verweist, nicht. |
| Metadaten | Schlüssel im dynamischen Feld. Sie können beim Einrichten der Kopie auch ausgewählte Schlüssel in typisierte Felder umwandeln. |
Distanzraum: cosine, l2 oder ip | Index-Metrik: COSINE, L2 oder IP. Die Metrik wird nicht übernommen; Sie legen sie fest, wenn der Index erstellt wird. |
| Embedding-Funktion | Nicht in der Datenbank gespeichert. Ihre Anwendung bettet Abfragen ein (Schritt 3). |
Eine Collection pro Benutzer? Jede Chroma-Collection wird zu einer eigenen Zilliz-Cloud-Collection, und ein Cluster bietet nur eine begrenzte Anzahl davon: 5 im Free-Tarif, 100 bei Serverless und bei Dedicated-Clustern 1.024 pro Compute-Unit, bis zu 16.384. Wenn Sie mehr Pro-Benutzer-Collections haben oder erwarten, sprechen Sie vor der Migration mit uns: Das bessere Design ist eine Collection mit einem Partitionsschlüssel, die Millionen von Mandanten unterstützt.
Schritt 1: Verschieben Sie Ihre Daten
Sie können die Daten auf zwei Arten kopieren. Welche Art sich eignet, hängt davon ab, wo Ihr Chroma läuft:
| Ihr Chroma | Verwendung |
|---|---|
| Chroma Cloud | Option A: Integrierter Migration Service |
| Ihr eigener, aus dem Internet erreichbarer Chroma-Server | Option A: Integrierter Migration Service |
| Ihr eigenes Chroma in einem privaten Netzwerk oder auf Ihrem Laptop oder eingebettet in Ihre Anwendung | Option B: Vector Transport Service (Open-Source) |
Der Unterschied besteht darin, wer sich mit wem verbindet. Der Migration Service läuft in Zilliz Cloud und liest aus Ihrem Chroma, benötigt also eine Adresse, die er erreichen kann. Der Vector Transport Service läuft auf einer Maschine Ihrer Wahl und schreibt nach Zilliz Cloud; er funktioniert daher von überall, solange er beide erreichen kann.
Notieren Sie zuerst die Anzahl der Datensätze und den Distanzraum jeder Collection. Sie benötigen den Distanzraum, um die Index-Metrik festzulegen – unabhängig davon, welche Option Sie verwenden –, und die Anzahl, um die Kopie zu überprüfen:
import chromadb

client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud: chromadb.CloudClient(api_key=..., tenant=..., database=...)

for collection in client.list_collections():
    config = collection.configuration_json
    space = (config.get("hnsw") or config.get("spann") or {}).get("space") or "l2"
    print(f"{collection.name}: {collection.count()} records, space {space}")
Chroma verwendet für Collections, die ohne Distanzraum erstellt wurden, l2. Nehmen Sie leere Collections nicht in die Kopie auf: Chroma zeichnet keine Dimension auf, bis das erste Embedding eintrifft, es gibt also nichts, woraus das Ziel erstellt werden könnte.
Option A: Zilliz Cloud Migration Service
Der Migration Service ist in die Zilliz-Cloud-Konsole integriert und kostenlos nutzbar. Sie benötigen die Rolle „Organization Owner“ oder „Project Admin“. Ein selbst gehosteter Chroma-Server muss die REST-API v2 von Chroma bereitstellen und aus Zilliz Cloud erreichbar sein. Falls er sich hinter einer Firewall befindet, fügen Sie die IP-Adressen von Zilliz Cloud zur Allowlist hinzu.
- Verbinden. Öffnen Sie in der Konsole Migrations und wählen Sie Chroma als Quelle. Geben Sie den Chroma-Endpunkt, Tenant, Datenbank und Anmeldedaten ein. Für Chroma Cloud kopieren Sie diese aus dem Bereich Connect: Der Endpunkt ist
https://api.trychroma.comoder der Endpunkt Ihrer Region, falls Ihre Datenbank außerhalb von AWS us-east-1 liegt, und die Anmeldedaten sind Ihr API-Schlüssel. Selbst gehostetes Chroma kann ohne Authentifizierung, mit einem Token oder mit Benutzername und Passwort verwendet werden; Standard-Tenant und Standard-Datenbank sinddefault_tenantunddefault_database. Wählen Sie dann Zielcluster und Zieldatenbank aus.
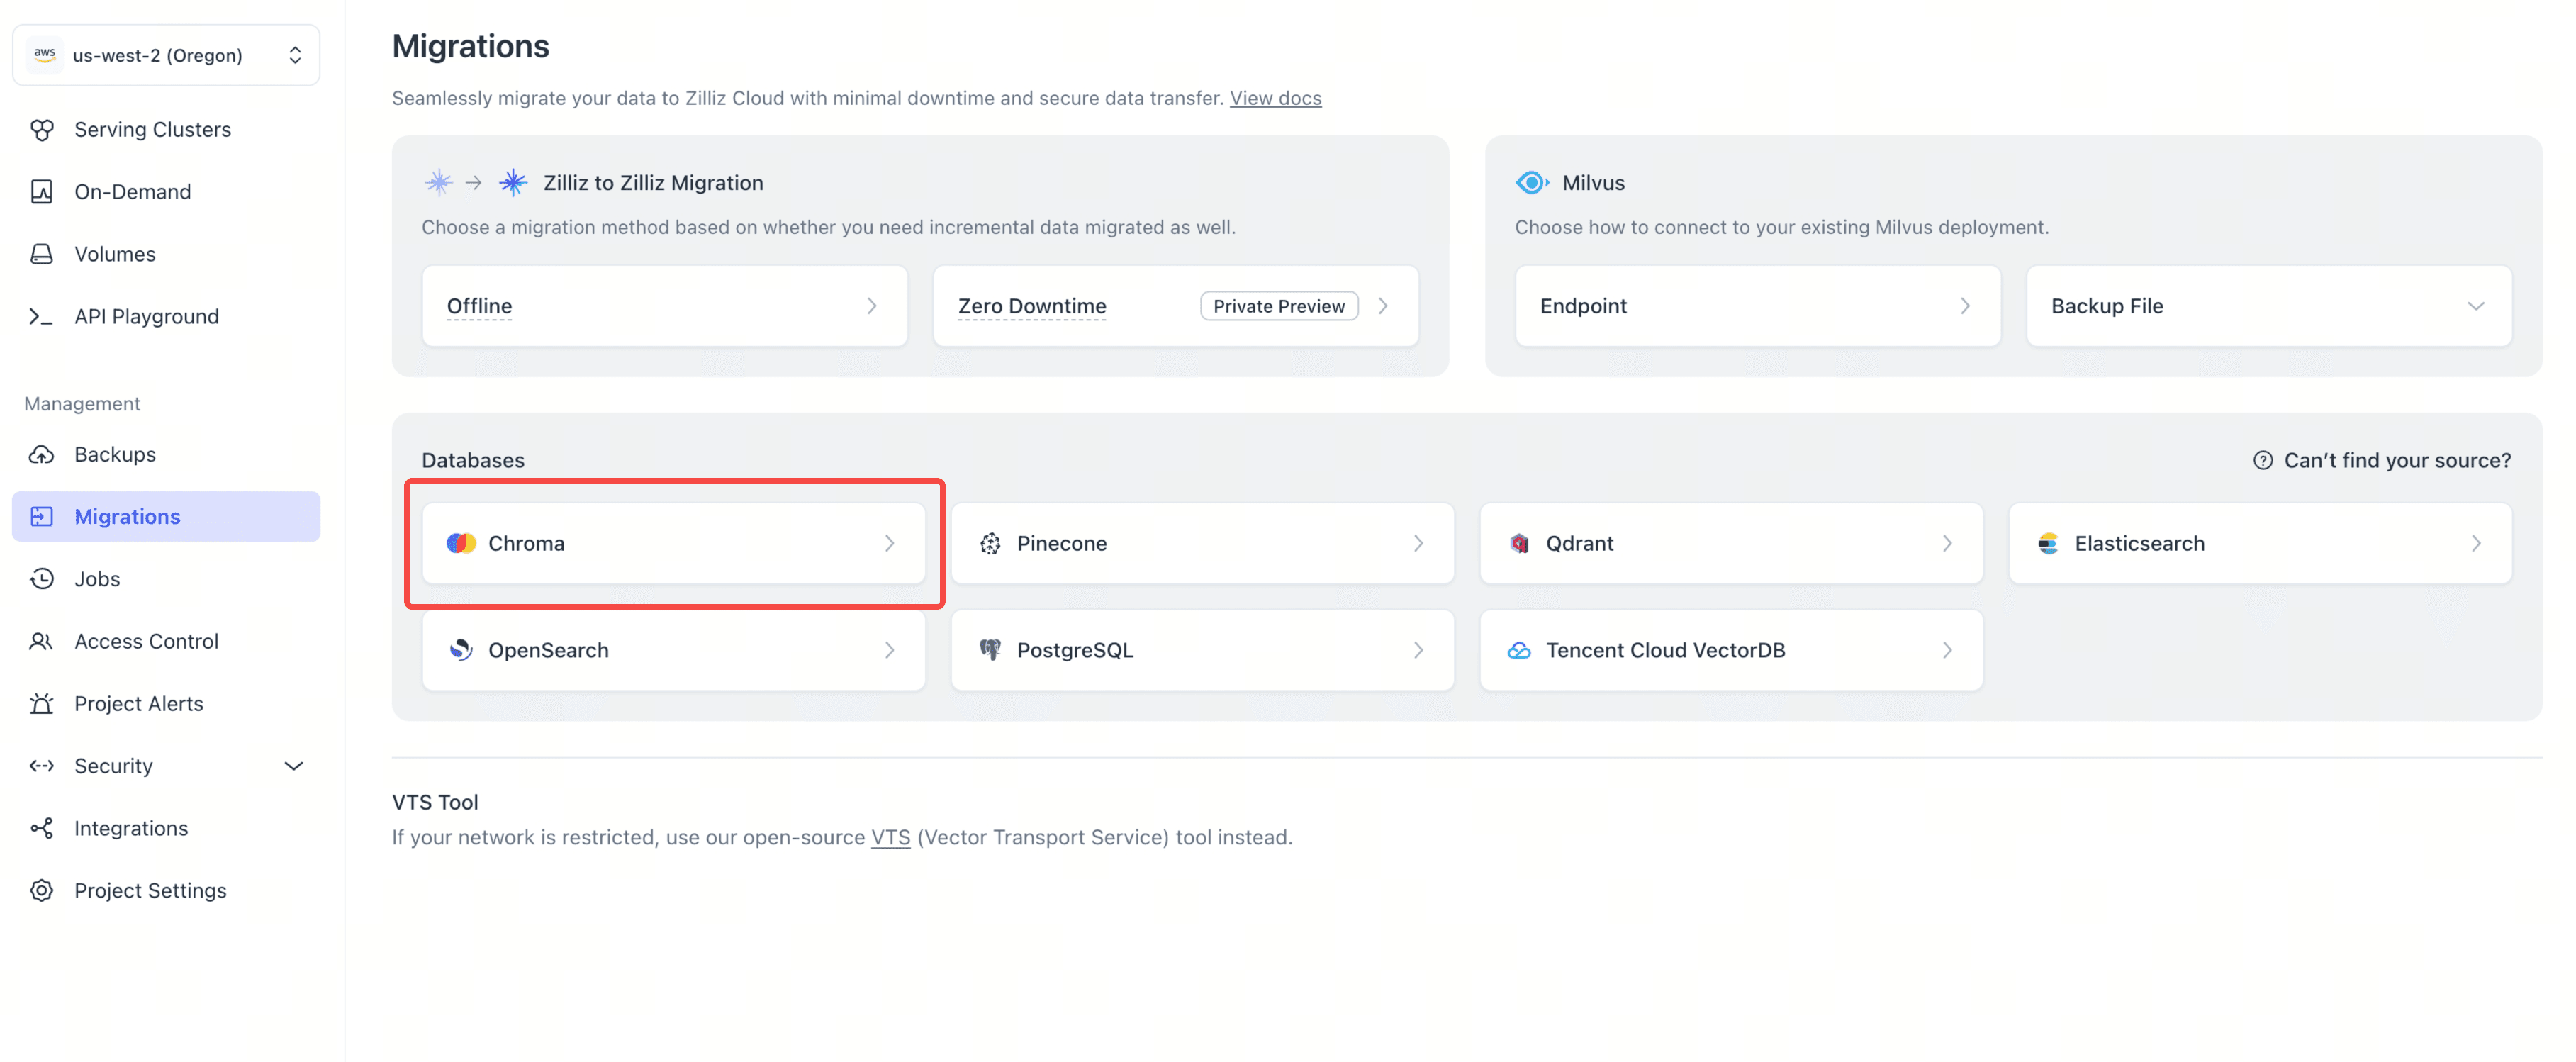
Auswählen und überprüfen. Wählen Sie die zu verschiebenden Collections aus. Prüfen Sie jeden Zielnamen und benennen Sie alle um, die Zilliz Cloud nicht verwenden kann oder die bereits vergeben sind. Überprüfen Sie das Feld-Mapping: Metadaten werden standardmäßig dem dynamischen Feld zugeordnet, und Sie können hier ausgewählte Schlüssel in typisierte Felder umwandeln.
Index festlegen. Lassen Sie Create indexes after migration aktiviert, damit die Collections sofort nach Abschluss des Auftrags durchsuchbar sind. Setzen Sie die Metrik jeder Collection so, dass sie dem Distanzraum von Chroma entspricht:
cosinezuCOSINE,l2zuL2undipzuIP. Die Metrik wird nicht aus Chroma übernommen. Siehe Indexeinstellungen.Ausführen. Starten Sie den Auftrag und verfolgen Sie ihn auf der Seite Jobs. Wenn er abgeschlossen ist, meldet der Auftrag die Anzahl der verifizierten Zeilen.
Jedes Feld und jede Option wird in Migrate from Chroma to Zilliz Cloud in der Zilliz-Cloud-Dokumentation beschrieben. Fahren Sie dann mit Schritt 2 fort.
Option B: Vector Transport Service
Vector Transport Service (VTS) ist das Open-Source-Migrationswerkzeug von Zilliz und die Engine, auf der der Migration Service läuft. Sie führen es selbst in Docker aus, anhand einer Konfigurationsdatei. Es liest Chroma über dessen v2-REST-API, die jeder Chroma-Server ab Version 0.6 bereitstellt.
Wenn Ihr Chroma in Ihre Anwendung eingebettet ist und seine Daten über chromadb.PersistentClient in einem lokalen Verzeichnis liegen, gibt es noch keinen Server, von dem VTS lesen kann. Starten Sie einen für dieses Verzeichnis:
chroma run --path ./chroma_data --port 8000
Schreiben Sie dann die Job-Konfiguration. Speichern Sie diese als migration.conf und ersetzen Sie jeden $-Platzhalter durch einen echten Wert; es handelt sich nicht um Umgebungsvariablen und sie werden nicht für Sie expandiert.
hocon
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  ChromaDB {
    url = "$CHROMA_URL"                  # e.g. http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # e.g. ["support-docs"]

    # If your Chroma requires auth, see the table below
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"

    id_split_size = 300
    batch_size = 300
  }
}

sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"                 # must already exist
    batch_size = 50
    enable_dynamic_field = true          # required, this is where metadata goes
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
Die Konfiguration enthält Anmeldeinformationen. Schränken Sie sie daher mit chmod 600 migration.conf ein.
| Parameter | Was hier eingetragen werden muss |
|---|---|
url (source) | Die Basis-URL des Chroma-Servers ohne /api/v2, das von VTS angehängt wird. VTS läuft in einem Container, wobei localhost den Container selbst bedeutet. Wenn Chroma auf demselben Rechner läuft, verwenden Sie auf macOS und Windows http://host.docker.internal:8000; unter Linux fügen Sie --network host zu docker run hinzu und behalten localhost bei. Für Chroma Cloud verwenden Sie https://api.trychroma.com oder den Endpunkt Ihrer Region |
tenant und database | default_tenant und default_database, sofern Sie keine anderen erstellt haben. Bei Chroma Cloud Ihre Mandanten-ID und Ihr Datenbankname |
auth_type und token | Lassen Sie beide weg, wenn Ihr Server ohne Authentifizierung läuft. Verwenden Sie andernfalls X_CHROMA_TOKEN oder BEARER mit einem token oder BASIC mit username und password. Chroma Cloud verwendet X_CHROMA_TOKEN mit Ihrem API-Schlüssel |
id_split_size und batch_size | 300 für beide funktioniert überall, und bei Chroma Cloud müssen beide bei 300 oder darunter bleiben. Bei einer großen selbst gehosteten Collection scannen 10000000 und 1000 IDs in großen Mengen und rufen dann Datensätze anhand der ID ab, wodurch langsames tiefes Paging vermieden wird |
collection_rename (sink) | Optional, { "source" = "target" }. Erforderlich für jeden Quellnamen, der kein gültiger Zilliz-Cloud-Name ist, sobald - zu _ wird |
Um ausgewählte Metadaten-Schlüssel in typisierte Felder umzuwandeln, fügen Sie dem Sink einen field_schema-Block hinzu. Der Milvus-Sink-Leitfaden behandelt field_schema und collection_rename, und der ChromaDB-Source-Leitfaden behandelt Batch-Größen, Authentifizierung und die weiteren Quelloptionen.
Führen Sie den Job aus:
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
Der Job ist erfolgreich, wenn das Protokoll mit end with state FINISHED endet, Total Read Count gleich Total Write Count ist und Total Failed Count 0 beträgt.
Der Job hängt Daten an, führen Sie ihn daher nicht erneut in dieselbe Collection aus. Ein zweiter Lauf schreibt jeden Datensatz erneut. Wenn ein Job teilweise fehlschlägt oder Sie eine frische Kopie benötigen, löschen Sie zuerst die Ziel-Collection oder senden Sie den Job mit collection_rename an eine neue.
Erstellen Sie den Index. Verwenden Sie den Distanzraum, den Sie für diese Collection notiert haben:
from pymilvus import MilvusClient
client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE",  # cosine -> COSINE, l2 -> L2, ip -> IP
)
client.create_index(collection_name="support_docs", index_params=index_params)
client.load_collection("support_docs")
Umzug von Chroma zu Open-Source-Milvus
Alles in diesem Leitfaden funktioniert mit Open-Source-Milvus 2.5 oder später. Verwenden Sie Option B, die in jedes erreichbare Milvus schreibt: Setzen Sie die url der Senke auf Ihre Milvus-Adresse, z. B. http://host.docker.internal:19530, wenn Milvus auf derselben Maschine läuft, und token auf username:password, oder entfernen Sie die token-Zeile, wenn die Authentifizierung deaktiviert ist. Die Schritte 2 bis 4 sind dieselben, und in Ihrer Anwendung ändern sich nur uri und token. Da Milvus und Zilliz Cloud dieselbe API verwenden, können Sie später zwischen ihnen wechseln, ohne Ihren Code ändern zu müssen.
Schritt 2: Überprüfen Sie Ihre Daten
Vergleichen Sie zuerst die Datensatzanzahlen. Der Migrationsdienst meldet die Zeilenanzahl, die er verifiziert hat; bei VTS ist es Total Write Count im Protokoll. Beides sollte mit der Anzahl in Chroma übereinstimmen.
Die Anzahlen sagen Ihnen, dass jeder Datensatz angekommen ist. Sie sagen Ihnen jedoch nicht, ob der Index Suchanfragen so beantwortet wie zuvor Chroma: Ein Index, der mit der falschen Metrik erstellt wurde, besteht die Anzahlprüfung und liefert dennoch die falschen Nachbarn. Führen Sie also auf beiden Seiten ein paar Suchen durch und vergleichen Sie:
import chromadb
from pymilvus import MilvusClient

chroma = chromadb.CloudClient(api_key="YOUR_CHROMA_API_KEY", tenant="YOUR_TENANT_ID", database="YOUR_DATABASE_NAME")
# Self-hosted Chroma: chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY")

source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(query_embeddings=[vector], n_results=10, include=[])["ids"][0]
    hits = milvus.search("support_docs", data=[vector.tolist()], limit=10)[0]
    overlaps.append(len(set(expected) & {hit["id"] for hit in hits}) / len(expected))
print(f"top-10 overlap: {sum(overlaps) / len(overlaps):.0%}")
Dabei werden 20 Datensätze als Suchanfragen verwendet und gezählt, wie viele der Top-10-Ergebnisse übereinstimmen. Beide Systeme verwenden approximative Indizes, daher ist ein Wert knapp unter 100 % normal. Ein deutlich niedrigerer Wert bedeutet fast immer, dass die Indexmetrik nicht zum Distanzraum der Sammlung passt.
Keine der beiden Prüfungen blickt in die Datensätze selbst. Bevor die endgültige Kopie live geht, vergleichen Sie auch diese: Prüfen Sie, dass jede ID übertragen wurde, und vergleichen Sie dann Vektoren, Dokumente, URIs und Metadaten. Bei einer kleinen Sammlung vergleichen Sie jeden Datensatz, bei einer großen eine Zufallsstichprobe.
Wenn Ihre Anwendung während des Kopiervorgangs weiterhin in Chroma geschrieben hat, können die Anzahlen abweichen. Das ist für den ersten Durchlauf in Ordnung; für die endgültige Kopie beim Umstieg müssen sie übereinstimmen.
Schritt 3: Aktualisieren Sie Ihre Anwendung
Die meisten Aufrufe lassen sich eins zu eins übertragen. Zwei Dinge erfordern Aufmerksamkeit: Ihre Anwendung erstellt jetzt selbst Query-Embeddings, und die Scores für cosine- und ip-Collections laufen in die andere Richtung.
Verbindung zu Zilliz Cloud herstellen:
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
Für Open-Source-Milvus setzen Sie uri auf Ihre Milvus-Adresse und token auf username:password, oder lassen Sie token weg, wenn die Authentifizierung deaktiviert ist. Alles unten ist dasselbe.
Betten Sie Suchanfragen mit demselben Modell wie zuvor ein. Wenn Sie query_texts an Chroma übergeben haben, hat Chroma die Embedding-Funktion der Collection für Sie ausgeführt. Die migrierten Collections enthalten diese Funktion nicht, also rufen Sie dasselbe Modell in Ihrem Code auf. Wenn Sie Chroma Ihre Texte einbetten ließen und nie eine Embedding-Funktion festgelegt haben, wurde das Standardmodell all-MiniLM-L6-v2 verwendet. Das Paket chromadb kann es weiterhin lokal ausführen:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction() query_vector = embed(["How do I get a refund?"])[0].tolist()
Wenn Sie OpenAI oder einen anderen Anbieter verwendet haben, rufen Sie dasselbe Modell mit denselben Einstellungen auf.

**Mit Filtern suchen.** Vorher in Chroma:

```python
results = collection.query(
    query_embeddings=[query_vector],
    n_results=5,
    where={"category": "billing"},
    where_document={"$contains": "refund"},
)
Nachher in Zilliz Cloud:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
Jeder Treffer ist ein Dict mit id, distance und den Feldern, die Sie unter entity angefordert haben. Chromas where- und where_document-Filter werden zu einem Filterausdruck:
| Chroma | Zilliz Cloud |
|---|---|
{"category": "billing"} | category == "billing" |
{"category": {"$ne": "billing"}} | category != "billing" |
{"year": {"$gte": 2023}} (auch $gt, $lt, $lte) | year >= 2023 (auch >, <, <=) |
{"category": {"$in": ["billing", "account"]}} | category in ["billing", "account"] |
{"category": {"$nin": ["billing", "account"]}} | category not in ["billing", "account"] |
{"$and": [...]} und {"$or": [...]} | ... and ... und ... or ... |
{"is_public": True} | is_public == true |
{"tags": {"$contains": "faq"}} (Array-Metadaten) | array_contains(tags, "faq") |
where_document={"$contains": "refund"} | document like "%refund%" |
where_document={"$not_contains": "refund"} | not (document like "%refund%") |
Scores umgekehrt lesen. Chroma gibt Distanzen zurück, wobei niedriger eine höhere Ähnlichkeit bedeutet. Für COSINE und IP gibt Zilliz Cloud Ähnlichkeitswerte zurück, wobei höher eine höhere Ähnlichkeit bedeutet. Die Rangfolge ändert sich nicht, aber jeder Schwellenwert in Ihrem Code schon. In unserem Test hatte der beste Treffer für die obige Suche eine Chroma-Distanz von 0,0545 und einen Zilliz-Cloud-Score von 0,9455.
| Chroma-Raum | Chroma gibt zurück | Zilliz Cloud gibt zurück | Ein Schwellenwert wie distance < 0.3 wird zu |
|---|---|---|---|
cosine | 1 − Kosinus-Ähnlichkeit | Kosinus-Ähnlichkeit | score > 0.7 |
ip | 1 − Skalarprodukt | Skalarprodukt | score > 0.7 |
l2 | Quadrierte L2-Distanz | Quadrierte L2-Distanz | Keine Änderung |
Datensätze schreiben und löschen. Metadaten-Schlüssel stehen in jeder Zeile neben den anderen Feldern, es gibt also kein separates Argument metadatas. add und upsert bilden beide auf upsert ab (oder insert für neue IDs), und delete funktioniert per ID oder per Filter:
client.upsert(
    collection_name="support_docs",
    data=[{"id": "doc-1001", "embedding": vector, "document": "How to change your billing address", "category": "billing"}],
)
client.delete(collection_name="support_docs", ids=["doc-1001"])
client.delete(collection_name="support_docs", filter='category == "archived"')
Hier ist vector ein Embedding aus demselben Modell wie der Rest der Collection. Sie können uri weglassen; es ist nullable.
LangChain verwenden? Tauschen Sie die Vector-Store-Klasse aus und richten Sie sie auf die migrierten Feldnamen aus. Vorher:
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, filter={"category": "billing"})
Nachher, mit pip install langchain-milvus:
from langchain_milvus import Milvus
vector_store = Milvus( embedding_function=embeddings, collection_name="support_docs", connection_args={"uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT", "token": "YOUR_ZILLIZ_CLOUD_API_KEY"}, primary_field="id", text_field="document", vector_field="embedding", enable_dynamic_field=True, ) docs = vector_store.similarity_search("How do I get a refund?", k=5, expr='category == "billing"')
`embeddings` ist dasselbe LangChain-Embeddings-Objekt, das du mit Chroma verwendet hast, und Filter wechseln von `filter={...}` zu `expr="..."`. LlamaIndex-Nutzer können auf die gleiche Weise zum [Milvus-Vektor-Store](https://developers.llamaindex.ai/python/examples/vector_stores/milvusindexdemo/) umsteigen.

## Schritt 4: Umstellung

1.  Kopiere deine Daten, überprüfe sie und richte einen Staging-Build deiner Anwendung auf Zilliz Cloud aus.
2.  Pausiere Schreibvorgänge auf Chroma. Nach dem 22. November blockiert Chroma Cloud sie ohnehin.
3.  Kopiere erneut, damit du jeden Schreibvorgang bis zur Pause erhältst, und prüfe, dass die Anzahlen jetzt genau übereinstimmen. Lösche die erste Kopie, bevor du beginnst, oder sende diese an eine andere Datenbank.
4.  Stelle deine Anwendung auf Zilliz Cloud bereit.
5.  Entferne oder rotiere auf Chroma Cloud deine Anmeldedaten vor dem 22. Dezember, wie es in Chromas Mitteilung zur Einstellung verlangt wird.

**Liest du das nach dem 22. November? Deine Chroma-Cloud-Daten sind bereits schreibgeschützt, überspringe also Schritt 2 und kopiere einmal. Du kannst sie bis zum 22. Dezember weiterhin kopieren.**

Bei selbst gehostetem Chroma gibt es keine Frist, aber halte die Reihenfolge ein: kopieren, Schreibvorgänge pausieren, erneut kopieren, umstellen. Behalte deinen Chroma-Server danach noch eine Weile. Bis deine Anwendung etwas Neues auf Zilliz Cloud schreibt, ist ein Rollback nur eine Konfigurationsänderung.

## Nächste Schritte

-   **Verschiebst du eine große oder produktive Workload?** Sprich mit [unserem Support-Team](https://zilliz.com/contact-sales) über die Planung der Umstellung.
-   **Erst die Optionen vergleichen?** [Chroma vs. Zilliz Cloud](https://zilliz.com/comparison/chroma-vs-zilliz-cloud) behandelt Funktionen, Skalierung und was von Chroma Cloud übernommen werden kann.
-   **Hybridsuche in Chroma Cloud bereits verwendet?** Die [Hybridsuche](https://docs.zilliz.com/docs/hybrid-search) von Zilliz Cloud kombiniert dichte Vektoren mit BM25 oder anderen sparse Vektoren in einer Anfrage.
- **Verschiebst du auch andere Datenbanken?** Der gleiche [Migrationsdienst](https://docs.zilliz.com/docs/external-migration-basics) unterstützt Pinecone, Qdrant, Elasticsearch, OpenSearch und PostgreSQL. Fendy Feng
 is the Product Marketing Manager at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Sebastian Huang
Staff Software Engineer at Zilliz
 Shawn He
Senior Software Engineer at Zilliz
Weiterlesen
How Zilliz Saw the Future of Vector Databases—and Built for Production
An inside look at how Zilliz built vector databases for real-world use, focusing on scalability, stability, and running them reliably at scale.
Balancing Precision and Performance: How Zilliz Cloud's New Parameters Help You Optimize Vector Search
Optimize vector search with Zilliz Cloud’s level and recall features to tune accuracy, balance performance, and power AI applications.
Similarity Metrics for Vector Search
Exploring five similarity metrics for vector search: L2 or Euclidean distance, cosine distance, inner product, and hamming distance.