Erstellen Sie eine Filmempfehlungs-Engine mit Milvus und Python
Dieser Artikel wurde ursprünglich in The New Stack veröffentlicht und wird hier mit Genehmigung erneut veröffentlicht.
Verwenden Sie Open-Source-Tools, um Menschen dabei zu helfen, Filme zu finden, die sie möglicherweise ansehen möchten.
Recommender-Systeme oder Empfehlungsmaschinen sind Informationsfiltersysteme, die darauf abzielen, vorherzusagen und vorzuschlagen, wofür sich Nutzer interessieren könnten. Zu diesen Elementen gehören Produkte, Dienstleistungen und Inhalte wie Filme, Bücher, Musik oder Nachrichtenartikel.
Es gibt verschiedene Arten von Recommender-Systemen, wie Collaborative Filtering, content-based Filtering, hybride Empfehlungssysteme und vektorbasierte Empfehlungssysteme. Vektorbasierte Systeme verwenden den Vektorraum, um die nächstgelegenen Elemente in der Datenbank zu finden (zu empfehlen). Es gibt verschiedene Möglichkeiten, diese Vektoren zu speichern; eine der effizientesten ist die Verwendung der Milvus Open-Source-Vektordatenbank. Diese Datenbank ist äußerst flexibel, schnell und zuverlässig und ermöglicht das Hinzufügen, Löschen, Aktualisieren und die Suche nach Vektoren nahezu in Echtzeit im Billionen-Byte-Maßstab.
Dieser Artikel erklärt, wie man mit Milvus und Python einen Film-Recommender erstellt. Dieses System verwendet SentenceTransformers, um die Textinformationen in Vektoren umzuwandeln und diese Vektoren in Milvus zu speichern. Milvus ermöglicht es Nutzern, in der Datenbank nach einem Film zu suchen, basierend auf den Textinformationen, die sie bereitstellen.
 Beitragsbild von Tima Miroshnichenko auf Pexels
Einrichten der Umgebung
Für diesen Artikel müssen die folgenden Voraussetzungen installiert sein:
Python Package Manager (PIP) zur Installation von Paketen
Jupyter Notebook zum Schreiben von Code
Ein System mit mindestens 32 GB RAM oder ein Zilliz Cloud-Konto
Python-Anforderungen
Sie müssen außerdem eine Reihe von Bibliotheken installieren, die in diesem Tutorial benötigt werden. Installieren Sie die Bibliotheken mit PIP:
$ python -m pip install pymilvus pandas sentence_transformers kaggle
Vektor-Datenspeicher (Milvus)
Sie verwenden die Milvus-Vektordatenbank, um die Embeddings zu speichern, die Sie mithilfe von Filmbeschreibungen generieren. Der Datensatz ist relativ groß, zumindest für einen Server, der auf einem privaten Computer läuft. Daher sollten Sie eventuell eine Zilliz Cloud-Instanz verwenden, um diese Vektoren zu speichern.
Wenn Sie lieber bei einer lokalen Instanz bleiben möchten, können Sie eine docker-compose-Konfiguration herunterladen und sie ausführen mit:
$ wget https://github.com/milvus-io/milvus/releases/download/v2.3.0/milvus-standalone-docker-compose.yml -O docker-compose.yml
$ docker-compose up -d
Sie haben nun alle Voraussetzungen, um Ihr eigenes Film-Recommender-System mit Milvus zu erstellen.
Datenerfassung und Vorverarbeitung
Für dieses Projekt verwenden Sie das Movies Dataset von Kaggle, das Metadaten für 45.000 Filme enthält. Sie können diesen Datensatz herunterladen oder die Kaggle API verwenden, um den Datensatz mit Python herunterzuladen. Um dies mit Python zu tun, müssen Sie die Datei kaggle.json aus dem Profilbereich von Kaggle.com herunterladen und an einem Ort ablegen, an dem die API sie findet.
Richten Sie als Nächstes einige Umgebungsvariablen für die Kaggle-Authentifizierung ein. Dazu können Sie das Jupyter Notebook öffnen und die folgenden Codezeilen schreiben:
%env KAGGLE_USERNAME=username
%env KAGGLE_KEY=XXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX
%env TOKENIZERS_PARALLELISM=true
Sobald dies erledigt ist, können Sie die Python-Abhängigkeit von Kaggle verwenden, um den Datensatz von Kaggle herunterzuladen:
# import kaggle dependency
import kaggle

kaggle.api.authenticate()
kaggle.api.dataset_download_files('rounakbanik/the-movies-dataset', path='dataset', unzip=True)
Sobald der Datensatz heruntergeladen ist, können Sie die Methode read_csv() von pandas verwenden, um den Datensatz einzulesen:
# import pandas
import pandas as pd

# read csv data
movies=pd.read_csv('dataset/movies_metadata.csv',low_memory=False)
# check shape of data
movies.shape
 Dataset Shape
Das Bild zeigt, dass Sie 45.466 Datensätze mit 24 Metadatenspalten haben. Überprüfen Sie alle diese Metadatenspalten mit:
# check column names
movies.columns
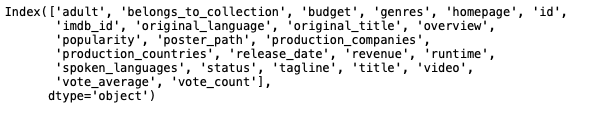 Dataset Columns
Es gibt viele Spalten, die Sie nicht benötigen, um das Empfehlungssystem zu erstellen. Sie können die erforderlichen Spalten herausfiltern mit:
# filter required columns
trimmed_movies = movies[["id", "title", "overview", "release_date", "genres"]]
trimmed_movies.head(5)
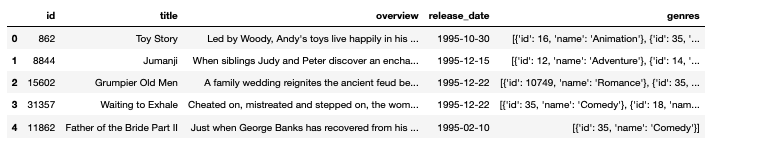 Required Columns
Außerdem fehlen einige der Felder in den Daten, entfernen Sie daher diese Zeilen, um einen sauberen Datensatz zu erzeugen:
unclean_movies_dict = trimmed_movies.to_dict('records')
print('{} movies'.format(len(unclean_movies_dict)))
movies_dict = []

for movie in unclean_movies_dict:
    if  movie["overview"] == movie["overview"] and movie["release_date"] == movie["release_date"] and movie["genres"] == movie["genres"] and movie["title"] == movie["title"]:
        movies_dict.append(movie)
Mit Milvus verbinden
Da Sie nun alle erforderlichen Spalten haben, verbinden Sie sich mit Milvus, um mit dem Hochladen der Daten zu beginnen. Um eine Verbindung zur Milvus-Cloud-Instanz herzustellen, benötigen Sie den Uniform Resource Identifier (URI) und das Token, die Sie von Ihrem Zilliz Cloud-Dashboard herunterladen können.
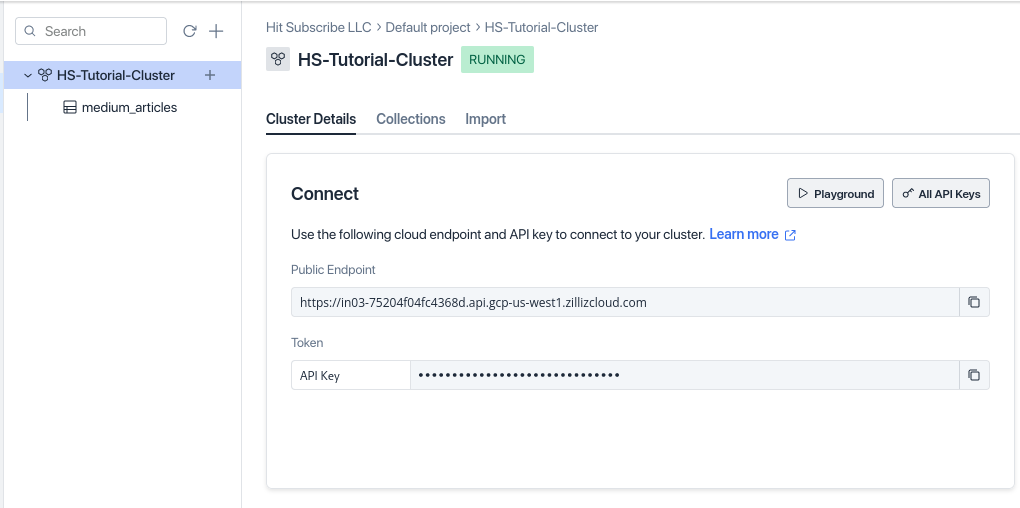 Zilliz Dashboard
Sobald Sie Ihre URI und Ihren API-Schlüssel haben, können Sie die Methode connect() von PyMilvus verwenden, um eine Verbindung zum Milvus-Server herzustellen:
# import milvus dependency
from pymilvus import *

# connect to milvus
milvus_uri="YOUR_URI"
token="YOUR_API_TOKEN"
connections.connect("default", uri=milvus_uri, token=token)
print("Connected!")
Embeddings für Filme generieren
Jetzt ist es an der Zeit, die Embeddings für die Textdaten im Filmdatensatz zu berechnen. Erstellen Sie zunächst ein collection-Objekt, das die Film-ID und die Embeddings für die Textdaten speichert. Erstellen Sie außerdem ein index-Feld, um Suchvorgänge effizienter zu machen:
COLLECTION_NAME = 'film_vectors'
PARTITION_NAME = 'Movie'

# Here's our record schema
"""
"title": Film title,
"overview": description,
"release_date": film release date,
"genres": film generes,
"embedding": embedding
"""

id = FieldSchema(name='title', dtype=DataType.VARCHAR, max_length=500, is_primary=True)
field = FieldSchema(name='embedding', dtype=DataType.FLOAT_VECTOR, dim=384)
schema = CollectionSchema(fields=[id, field], description="movie recommender: film vectors", enable_dynamic_field=True)
if utility.has_collection(COLLECTION_NAME): # drop the same collection created before collection = Collection(COLLECTION_NAME) collection.drop()
collection = Collection(name=COLLECTION_NAME, schema=schema) print("Collection created.")
index_params = { "index_type": "IVF_FLAT", "metric_type": "L2", "params": {"nlist": 128}, }
collection.create_index(field_name="embedding", index_params=index_params) collection.load()
print("Collection indexed!")
Nachdem du nun eine indizierte Collection hast, erstelle eine Funktion zum Generieren der Embeddings für den Text. Obwohl **overview** die primäre Spalte ist, die zum Generieren der Embeddings verwendet wird, nutzt du außerdem die Informationen aus **genre** und **release data** zusammen mit einer **overview**, um die Daten logischer zu gestalten.


Verwende zum Generieren der Embeddings den **SentenceTransformer**:
from sentence_transformers import SentenceTransformer import ast
function to extract the text from genre column
def build_genres(data): genres = data['genres'] genre_list = "" entries= ast.literal_eval(genres) genres = "" for entry in entries: genre_list = genre_list + entry["name"] + ", " genres += genre_list genres = "".join(genres.rsplit(",", 1)) return genres
create an object of SentenceTransformer
transformer = SentenceTransformer('all-MiniLM-L6-v2')
function to generate embeddings
def embed_movie(data):
embed = "{} Released on {}. Genres are {}.".format(data["overview"], data["release_date"], build_genres(data))
embeddings = transformer.encode(embed)
return embeddings
Diese Funktion verwendet die Methode **build_genres()**, um die Genre-Spalte zu bereinigen und den Text daraus zu extrahieren. Dann erstellt sie ein **SentenceTransformer**-Objekt, um die Embeddings aus dem Text zu generieren. Schließlich verwendet sie die Methode **encode()**, um die Embeddings mithilfe der Features **overview**, **release_date** und **genre** zu generieren.

## Embeddings an Milvus senden

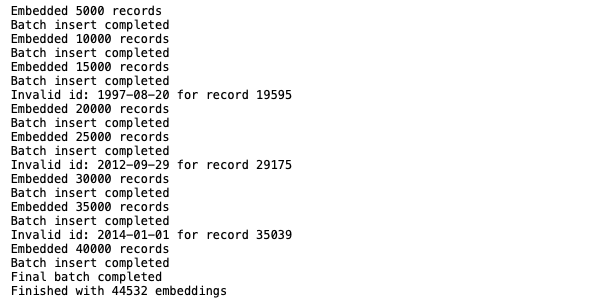
Jetzt kannst du die Embeddings mit der Methode **embed_movie()** erstellen. Dieser Datensatz ist zu groß, um ihn in einer einzigen **insert**-Anweisung an Milvus zu senden, aber das Senden einzelner Datenzeilen würde unnötigen Netzwerkverkehr erzeugen und zu viel Zeit in Anspruch nehmen. Erstelle daher stattdessen Batches (z. B. 5.000 Zeilen) von Daten, die an Milvus gesendet werden:
Loop counter for batching and showing progress
j = 0 batch = []
for movie_dict in movies_dict: try: movie_dict["embedding"] = embed_movie(movie_dict) batch.append(movie_dict) j += 1 if j % 5 == 0: print("Embedded {} records".format(j)) collection.insert(batch) print("Batch insert completed") batch=[] except Exception as e: print("Error inserting record {}".format(e)) pprint(batch) break
collection.insert(movie_dict) print("Final batch completed") print("Finished with {} embeddings".format(j))
***Hinweis:*** *Du kannst mit der Batch-Größe experimentieren, um sie an deine individuellen Bedürfnisse und Vorlieben anzupassen. Außerdem schlagen einige Filme bei IDs fehl, die nicht in Integer umgewandelt werden können. Du könntest dies durch eine Schemaänderung oder durch Überprüfung ihres Formats beheben.*
## Neue Filme mit Milvus empfehlen
Jetzt kannst du die nahezu echtzeitfähige Vektorsuchfunktionalität von Milvus nutzen, um eine nahe Übereinstimmung von Filmen zu erhalten, die den Kriterien des Zuschauers entsprechen. Erstelle dafür zwei verschiedene Funktionen:
1. **embed_search():** Du benötigst einen Transformer, um den Suchstring des Benutzers in ein Embedding umzuwandeln. Diese Funktion nimmt die Kriterien des Zuschauers entgegen und übergibt sie an denselben Transformer, den du zum Befüllen von Milvus verwendet hast.
2. **search_for_movies():** Diese Funktion führt die eigentliche Vektorsuche aus und nutzt dabei die andere Funktion zur Unterstützung.
load collection memory before search
collection.load()
Set search parameters
topK = 5 SEARCH_PARAM = { "metric_type":"L2", "params":{"nprobe": 20}, }
convert search string to embeddings
def embed_search(search_string): search_embeddings = transformer.encode(search_string) return search_embeddings
search similar embeddings for user's query
def search_for_movies(search_string): user_vector = embed_search(search_string) return collection.search([user_vector],"embedding",param=SEARCH_PARAM, limit=topK, expr=None, output_fields=['title', 'overview'])
Der obige Code definiert die Parameter **topK**, um die fünf ähnlichsten Vektoren zu erhalten, **metric_type** als [L2 (quadrierte euklidische Distanz)](https://iq.opengenus.org/euclidean-distance/), die den Abstand zwischen zwei Vektoren berechnet, und **nprobe**, das die Anzahl der zu durchsuchenden Cluster-Einheiten angibt. Außerdem implementiert er verschiedene Funktionen, um ähnliche Vektoren aus der Abfrage des Benutzers (Empfehlung) zu erhalten.


Verwenden Sie schließlich die Funktion **search_for_movies()**, um Filme basierend auf dem Suchstring des Benutzers zu empfehlen:
from pprint import pprint
search_string = "A comedy from the 1990s set in a hospital. The main characters are in their 20s and are trying to stop a vampire." results = search_for_movies(search_string)
check results
for hits in iter(results): for hit in hits: print(hit.entity.get('title')) print(hit.entity.get('overview')) print("-------------------------------")
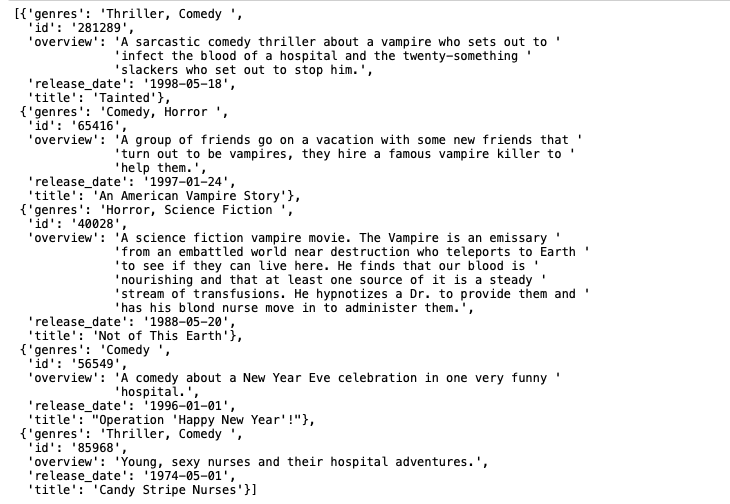
Durch die Verwendung der Vektorsuchfunktion von Milvus empfiehlt der Code die fünf ähnlichsten Filme basierend auf der Abfrage des Benutzers. Das war’s: Sie haben nun Ihr eigenes Filmempfehlungssystem mit Milvus erstellt.
## Fazit
Nachdem Sie diesen Artikel gelesen haben, wissen Sie, was ein vektorbasiertes Empfehlungssystem ist und wie Sie mit Milvus ein Filmempfehlungssystem erstellen. Milvus hilft beim Aufbau eines effizienten und skalierbaren Filmempfehlungssystems. Durch die Nutzung von Vektorspeicherung und Ähnlichkeitssuche hat Milvus großes Potenzial, personalisierte Empfehlungen zu ermöglichen, die Nutzerbindung zu verbessern und die Rolle fortschrittlicher vektorbasierter Modelle in modernen Empfehlungssystemen aufzuzeigen. Mehr darüber erfahren Sie auf der [Milvus-Website](https://milvus.io/).
Weiterlesen
A Developer's Guide to Exploring Milvus 2.6 Features on Zilliz Cloud
Milvus 2.6 marks a shift from “vector search + glue code” to a more advanced retrieval engine, and it is now Generally Available (GA) on Zilliz Cloud (a managed Milvus service).
Why Teams Are Migrating from Weaviate to Zilliz Cloud — and How to Do It Seamlessly
Explore how Milvus scales for large datasets and complex queries with advanced features, and discover how to migrate from Weaviate to Zilliz Cloud.
Zilliz Cloud Introduces Advanced BYOC-I Solution for Ultimate Enterprise Data Sovereignty
Explore Zilliz Cloud BYOC-I, the solution that balances AI innovation with data control, enabling secure deployments in finance, healthcare, and education sectors.