
Nomic / nomic-embed-vision-v1
Ein Vision-Embedding-Modell mit 92 Mio. Parametern, unterstützt sowohl unimodale als auch multimodale Suche in Kombination mit nomic-embed-text-v1
Milvus Integrated
Aufgabe: Einbettung
Modalität: Bild
Ähnlichkeitsmetrik: Kosinus
Lizenz: Apache 2.0
Dimensionen: 768
Maximale Eingabe-Tokens:
Preis: Kostenlos
Einführung in nomic-embed-vision-v1
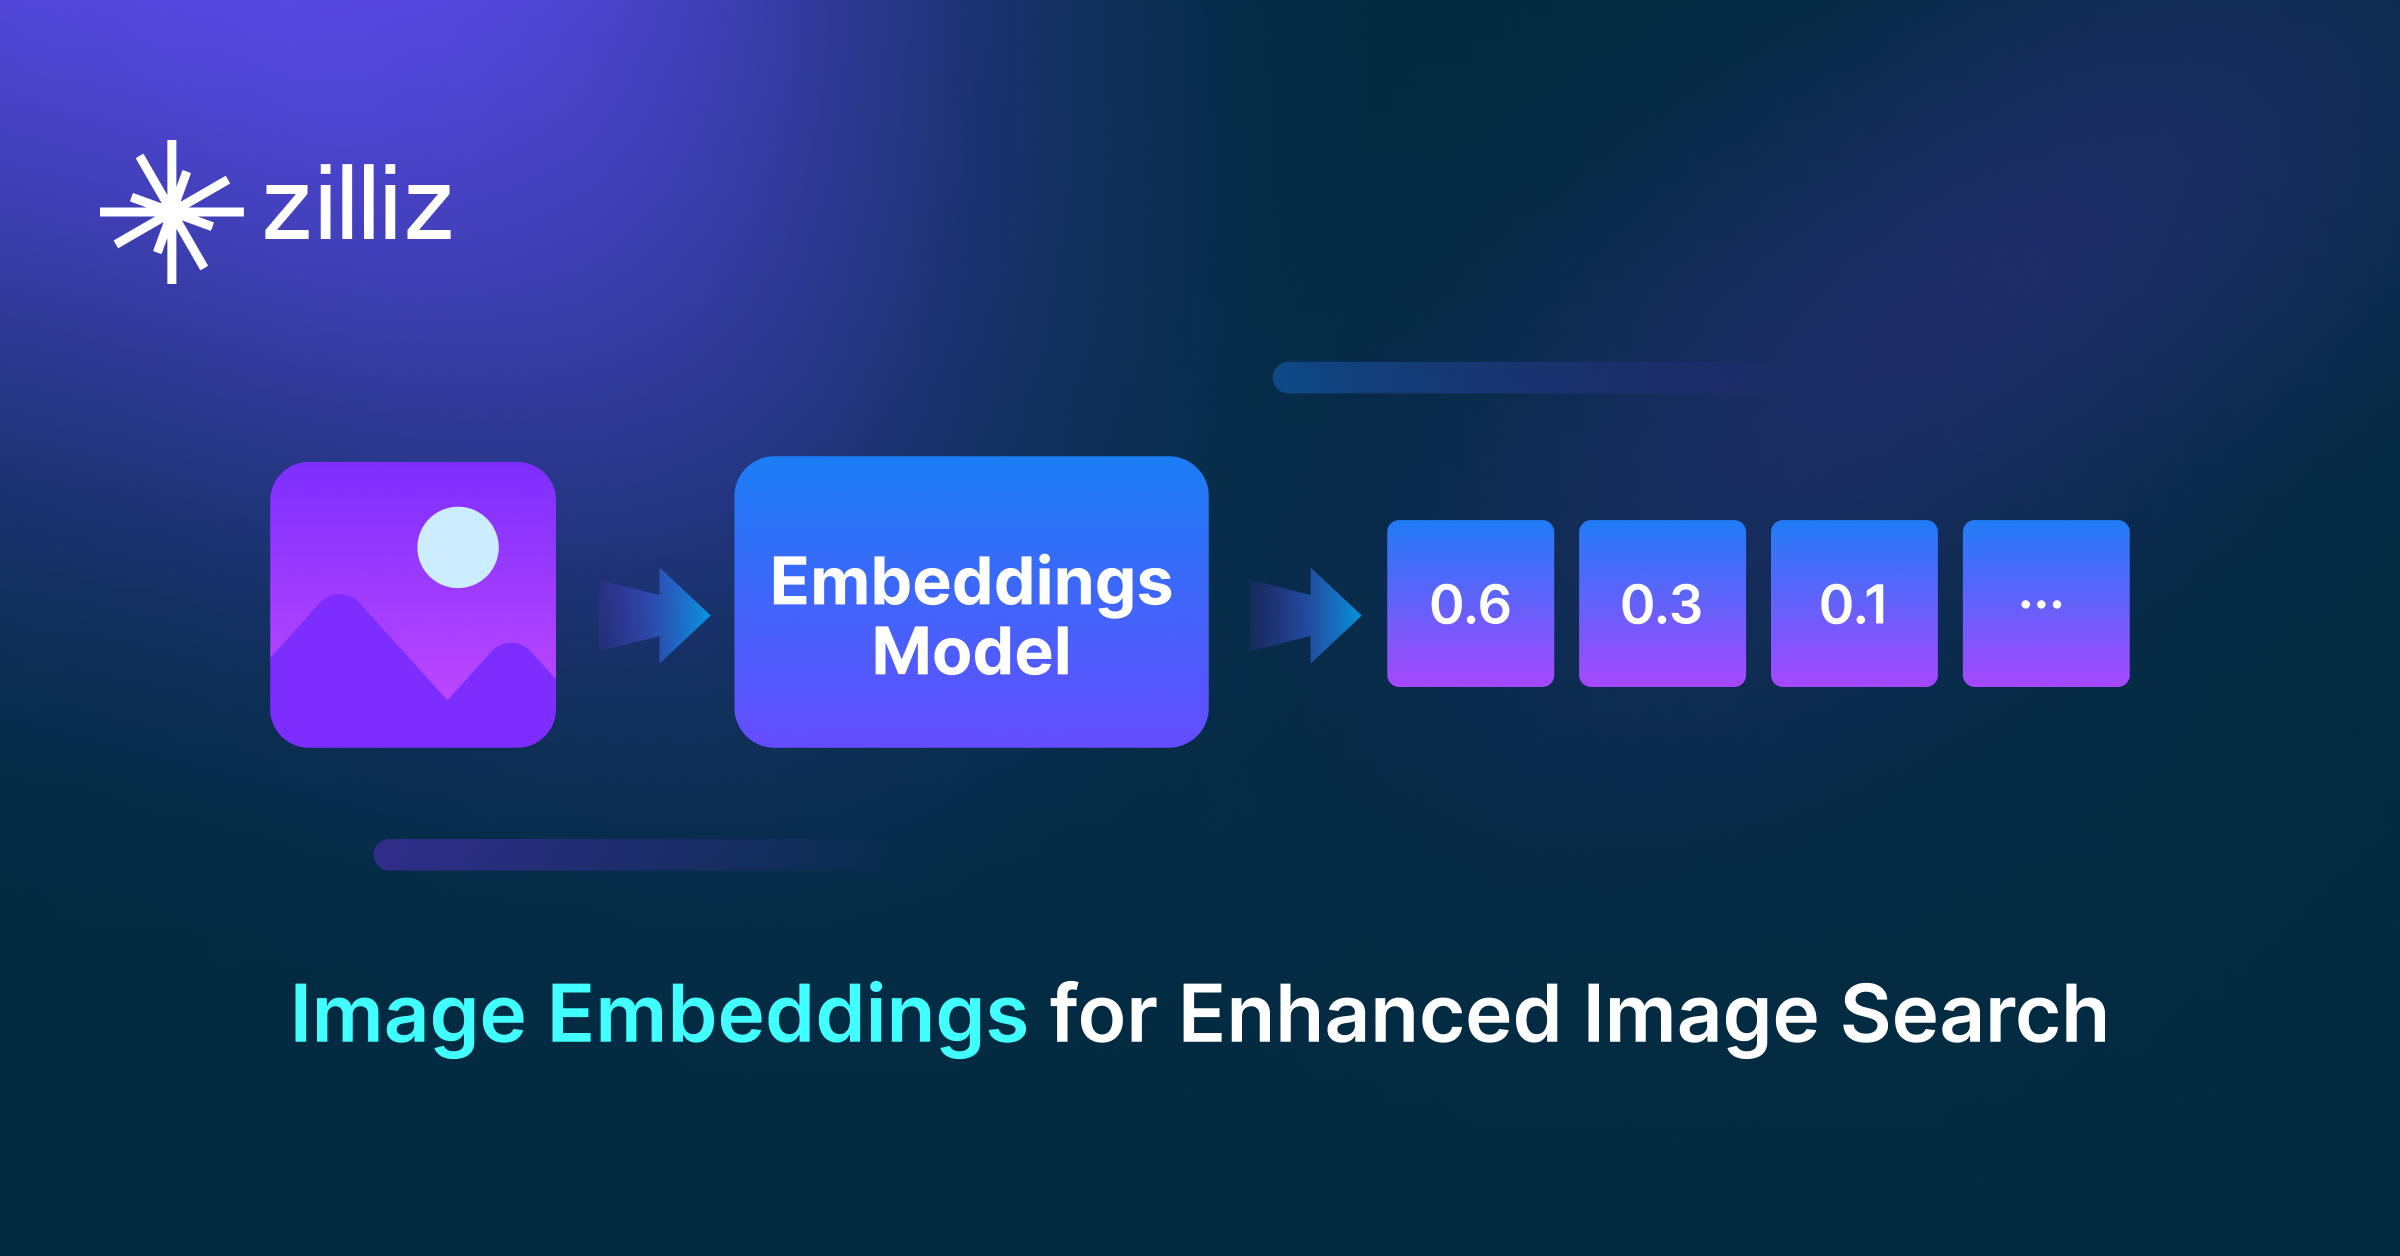
Das Modell nomic-embed-vision-v1 ist ein vollständig replizierbares Vision-Embedding-Modell, das denselben latenten Raum wie nomic-embed-text-v1 nutzt und dadurch eine multimodale Verwendung ermöglicht, bei der Text- und Bild-Embeddings einander direkt abfragen können. Mit einem Vision-Encoder mit 92 Mio. Parametern unterstützt es Bild- und Text-Embedding, unimodale Suche innerhalb jeder Modalität sowie multimodale Suche über beide hinweg.
So erstellen Sie Embeddings mit nomic-embed-vision-v1
Es gibt zwei primäre Möglichkeiten, Vektor-Embeddings zu generieren:
- PyMilvus: das Python-SDK für Milvus, das das Modell
nomic-embed-vision-v1nahtlos integriert. - Das Modul
embedim Nomic Python SDK bietet Embedding-Funktionalität unter Verwendung der Nomic Embedding API.
Sobald die Vektor-Embeddings generiert wurden, können sie in Zilliz Cloud (einem vollständig verwalteten Vektordatenbankdienst auf Basis von Milvus) gespeichert und für die semantische Ähnlichkeitssuche verwendet werden. Hier sind vier wichtige Schritte:
- Registrieren Sie sich kostenlos für ein Zilliz Cloud-Konto.
- Richten Sie einen serverlosen Cluster ein und erhalten Sie den Public Endpoint und API Key.
- Erstellen Sie eine Vektorsammlung und fügen Sie Ihre Vektor-Embeddings ein.
- Führen Sie eine semantische Suche auf den gespeicherten Embeddings aus.
Embeddings über PyMilvus erstellen und sie für die semantische Suche in Zilliz Cloud einfügen
from pymilvus import MilvusClient
from nomic import embed

# Prepare images (can be local paths or URLs)
images = ["path/to/image1.jpg", "path/to/image2.jpg", "path/to/image3.jpg"]

# Generate embeddings for images using nomic-embed-vision-v1
image_embeddings = embed.image(images=images, model="nomic-embed-vision-v1")[
    "embeddings"
]

# Prepare query image
query_images = ["path/to/query_image.jpg"]

# Generate embeddings for query
query_embeddings = embed.image(images=query_images, model="nomic-embed-vision-v1")[
    "embeddings"
]

# Connect to Zilliz Cloud with Public Endpoint and API Key
client = MilvusClient(uri=ZILLIZ_PUBLIC_ENDPOINT, token=ZILLIZ_API_KEY)

COLLECTION = "nomic_vision_v1_images"

# Drop collection if it exists
if client.has_collection(collection_name=COLLECTION):
    client.drop_collection(collection_name=COLLECTION)

# Create collection with dimension 768 (nomic-embed-vision-v1 output dimension)
client.create_collection(collection_name=COLLECTION, dimension=768, auto_id=True)

# Insert images with embeddings
for image, embedding in zip(images, image_embeddings):
    client.insert(COLLECTION, {"image_path": image, "vector": embedding})

# Search for similar images
results = client.search(
    collection_name=COLLECTION,
    data=query_embeddings,
    # consistency_level="Strong",  # Strong consistency ensures accurate results but may increase latency
    output_fields=["image_path"],
    limit=3,
)

# Print search results
print("Similar images found:")
for result in results[0]:
    print(f"  - {result['entity']['image_path']} (distance: {result['distance']:.4f})")
Weitere Informationen finden Sie in unserer Dokumentation zum PyMilvus Embedding Model.