Entendendo o Cenário dos Bancos de Dados Vetoriais
Até 2025, incríveis 90% dos novos dados serão não estruturados—texto, imagens, áudio e vídeos que não se encaixam perfeitamente em linhas, colunas ou modelos predefinidos. Essa mudança representa um dos maiores desafios na gestão moderna de dados, mas também cria oportunidades empolgantes para inovar em IA, sistemas de recomendação e busca semântica.
Entram em cena os bancos de dados vetoriais: sistemas de ponta criados especificamente para armazenar e consultar embeddings vetoriais de alta dimensionalidade. Esses embeddings transformam dados não estruturados em insights acionáveis ao capturar seu significado em forma numérica para permitir cálculos complexos e comparações semânticas que viabilizam recomendadores de produtos, busca reversa de imagens, detecção de anomalias e muito mais.
No entanto, à medida que o cenário dos bancos de dados vetoriais evolui rapidamente, as organizações enfrentam um mercado saturado, repleto de afirmações conflitantes e opções confusas. Como escolher a solução certa para o seu caso de uso?
Nosso novo recurso abrangente, O Guia Definitivo para Escolher um Banco de Dados Vetorial, responde a essa pergunta. Nele, você descobrirá:
Por que bancos de dados vetoriais criados para esse fim superam sistemas tradicionais como PostgreSQL e Elasticsearch ao lidar com dados não estruturados em grande escala.
Como os algoritmos de Vizinhos Mais Próximos Aproximados (ANN) permitem buscas rápidas e escaláveis, mesmo com bilhões de vetores de alta dimensionalidade.
Os recursos mais importantes para aplicações impulsionadas por IA, desde capacidades de busca híbrida e otimização por GPU até flexibilidade de esquema e multilocação.
Comparações dos principais players do mercado de bancos de dados vetoriais, incluindo Milvus, Zilliz, Pinecone e Weaviate, para ajudar você a entender seus pontos fortes e compromissos.
Como executar benchmarks em seus próprios dados entre fornecedores usando ferramentas de código aberto para avaliar desempenho, escalabilidade e custo-benefício para suas cargas de trabalho específicas.
Seja você criando pipelines de Geração Aumentada por Recuperação (RAG) para reduzir alucinações de IA, implementando sistemas de recomendação ou aprimorando a busca semântica, este guia fornece o conhecimento necessário para fazer uma escolha informada.
Não deixe a complexidade do mercado de bancos de dados vetoriais atrasar você. Baixe O Guia Definitivo para Escolher um Banco de Dados Vetorial hoje e dê o primeiro passo para aproveitar ao máximo seus dados não estruturados.
Continue lendo
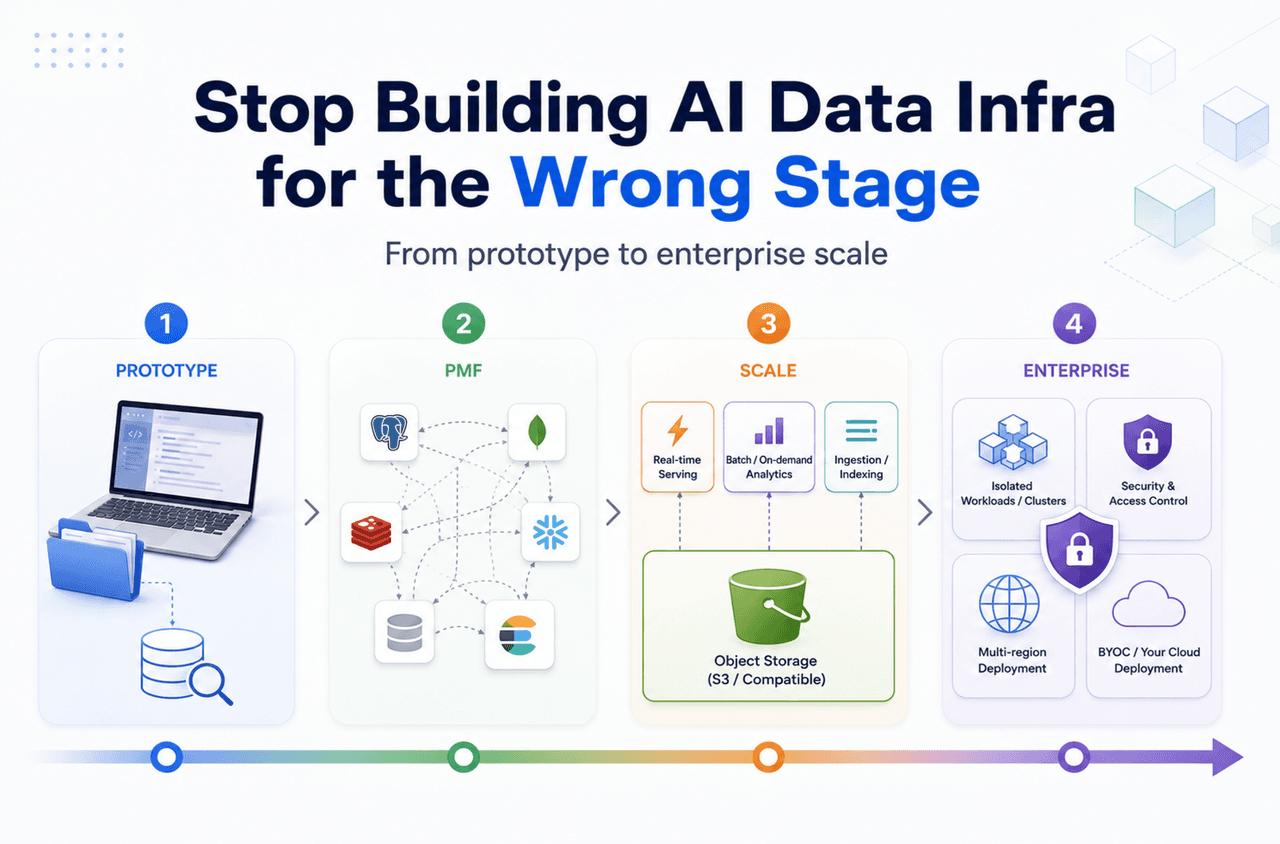
Stop Building AI Data Infra for the Wrong Stage
Learn how AI data infrastructure should evolve from prototype to enterprise scale, and when Vector Lakebase becomes the right architecture for AI apps.
Top 10 Context Engineering Techniques You Should Know for Production RAG
A practical guide to context engineering for production LLM systems, covering RAG, context processing, memory, agents, and multimodal context.
Legal Document Analysis: Harnessing Zilliz Cloud's Semantic Search and RAG for Legal Insights
Enhance legal document analysis with Zilliz Cloud’s Semantic Search and RAG. Improve accuracy, efficiency, and scalability for contracts, case law, and compliance.