Como Melhorar a Qualidade da Recuperação para Texto em Japonês com Sudachi, Milvus/Zilliz e AWS Bedrock
Esta publicação foi originalmente publicada no Qiita e é traduzida e publicada aqui com permissão.
Introdução
Quando comecei a criar sistemas de Retrieval-Augmented Generation (RAG) para usuários japoneses, deparei-me com um problema que provavelmente soa familiar para qualquer pessoa que já trabalhou com texto em japonês: a precisão da busca simplesmente não é tão direta quanto em inglês. O idioma tem peculiaridades—variações ortográficas, vogais longas, escrita mista, diferenças de forma superficial—que frequentemente quebram tanto métodos de recuperação densos quanto esparsos quando usados isoladamente.
A busca vetorial densa é ótima para compreender contexto e similaridade semântica, mas rapidamente deixa a desejar quando você precisa de correspondências exatas—números de modelo, identificadores de artigos legais, códigos internos ou entidades muito específicas como “金商法第37条 (Artigo 37 da Lei de Instrumentos Financeiros e Câmbio).” Métodos baseados em palavras-chave como BM25 lidam bem com esses casos, mas não conseguem acompanhar quando a entrada inclui pequenas variações de grafia (“サーバー” vs. “サーバ”) ou quando a mesma ideia pode ser expressa de várias formas.
Para contornar isso, criei um pipeline de busca híbrida que combina os pontos fortes de ambas as abordagens. A solução usa:
Sudachi: um tokenizador de japonês que fornece normalização e tokenização estável em textos inconsistentes.
Zilliz Cloud (o serviço Milvus totalmente gerenciado): um banco de dados vetorial de alto desempenho que oferece suporte a vetores densos, vetores esparsos e até geração automática de vetores BM25, o que torna a implementação de busca híbrida muito mais fácil.
AWS Bedrock: usado para gerar embeddings densos de alta qualidade (Titan Embeddings v2), que formam o lado semântico do pipeline de recuperação.
Nesta publicação, vou mostrar como combinei essas peças para criar um sistema de busca híbrida em japonês de alta precisão. Também incluirei um exemplo prático para que você possa experimentar o mesmo fluxo de trabalho e adaptá-lo aos seus próprios projetos de RAG.
Visão geral da arquitetura
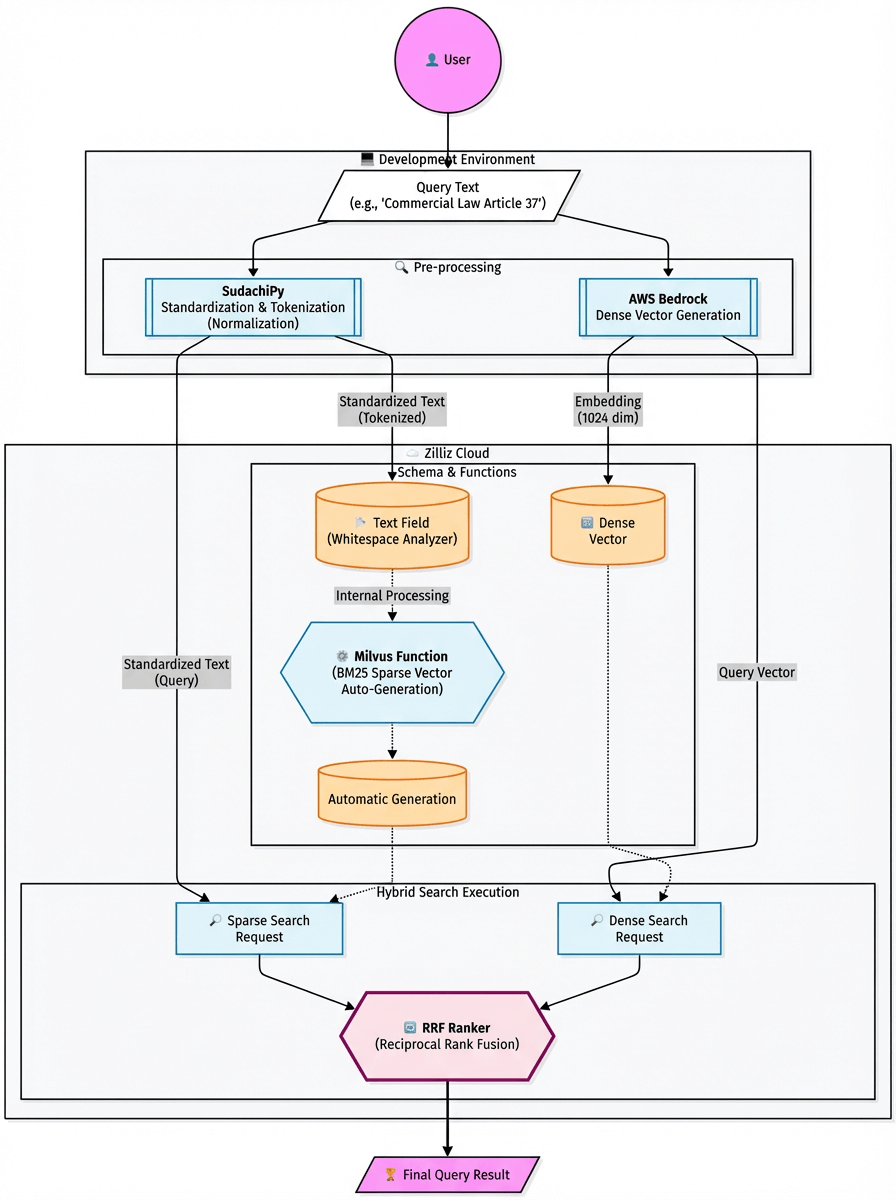
O sistema de busca híbrida deste artigo é construído sobre uma pilha simples, mas eficaz. Cada componente resolve um problema específico que surge ao lidar com texto em japonês e, juntos, eles formam um pipeline de recuperação que equilibra compreensão semântica com precisão de correspondência exata. Aqui está a análise de como é a pilha e por que cada parte importa.
SudachiPy — Tokenizador / Análise morfológica
Textos em japonês frequentemente contêm grafias inconsistentes, irregularidades de espaçamento e variações na notação. Em vez de depender de uma tokenização ingênua, uso SudachiPy e sua API normalized_form() para limpar tudo isso. Isso garante que “サーバー” e “サーバ” sejam mapeados para o mesmo token normalizado, e documentos que de outra forma seriam perdidos ainda apareçam nos resultados de busca. Esse único passo melhora drasticamente o recall em todos os aspectos.
Zilliz Cloud (Milvus gerenciado): Um banco de dados vetorial de alto desempenho
Milvus é o banco de dados vetorial open-source mais amplamente adotado, com mais de 43 mil estrelas no GitHub e um grande ecossistema de colaboradores. Zilliz Cloud usa o mesmo núcleo do Milvus, mas elimina todo o trabalho operacional—configuração de cluster, autoscaling, ajuste de desempenho, backups, upgrades de versão—ao mesmo tempo em que expõe a mesma API do Milvus. Na prática, isso significa que posso desenvolver localmente com o Milvus open-source e implantar exatamente o mesmo código no Zilliz Cloud quando preciso de um ambiente de nível de produção.
Isso importa porque muitos projetos de busca vetorial chegam ao mesmo obstáculo: o protótipo funciona, mas escalá-lo se torna caro demais ou imprevisível demais. Serviços de busca PaaS totalmente gerenciados, como Azure AI Search, ou bancos vetoriais proprietários, muitas vezes se tornam gargalos de custo muito antes de os requisitos de desempenho serem atendidos. O Zilliz Cloud oferece um caminho mais eficiente: maior throughput, menor latência e mais controle sobre o layout dos dados—sem o aumento gradual de custos que normalmente aparece em escala.
Nesta arquitetura, o Zilliz Cloud lida com todo o armazenamento e recuperação de embeddings. Ele oferece suporte a:
Busca vetorial densa para similaridade semântica
Busca vetorial esparsa para recuperação baseada em palavras-chave
A partir do Milvus v2.4, o banco de dados também inclui um recurso de Function que gera automaticamente vetores esparsos BM25 a partir de texto bruto. Isso é uma grande vitória operacional. Eu não preciso calcular BM25 no lado do cliente, manter pipelines extras de indexação nem sincronizar metadados entre vários sistemas. Tudo—de embeddings densos a BM25 e ranking híbrido—fica em um único banco de dados, mantendo todo o fluxo de recuperação simples, rápido e fácil de manter.
AWS Bedrock (Titan Embeddings v2): O modelo de embeddings
Para embeddings vetoriais densos, uso Titan Embeddings v2 da AWS Bedrock. Ele tem bom desempenho em vários idiomas e lida com texto em japonês de forma confiável, o que é importante quando você está criando embeddings de conteúdo misto, como consultas curtas, documentos longos de políticas, descrições de produtos e textos no estilo FAQ.
Reciprocal Rank Fusion (RRF): O método de reranking
A busca híbrida só funciona se você conseguir combinar de forma significativa os resultados da busca densa e da busca esparsa, e os dois espaços de pontuação são fundamentalmente diferentes. RRF (Reciprocal Rank Fusion) resolve isso de forma limpa ao mesclar resultados com base no rank em vez de pontuações brutas. Ele produz resultados híbridos estáveis e fáceis de entender, sem nenhum ajuste manual de pesos ou truques de normalização.
Tutorial de busca híbrida amigável para iniciantes
Com a arquitetura explicada, vamos para algo que você pode realmente executar. Eu preparei um repositório no GitHub com todo o código e os dados de exemplo de que você precisa, então a configuração é intencionalmente leve. Depois que você criar um cluster gratuito no Zilliz Cloud e adicionar sua chave de API da AWS Bedrock, poderá testar três modos de recuperação lado a lado:
Busca vetorial densa
Busca full-text esparsa (BM25)
Busca híbrida (fusão RRF)
Todo o fluxo de trabalho roda a baixo custo—apenas as chamadas de embedding do Bedrock geram cobranças.
Etapa 1: Clone o repositório do GitHub
Primeiro, clone o repositório:
git clone [https://github.com/Beginnersguide138/rag-with-sudachi.git](https://github.com/Beginnersguide138/rag-with-sudachi.git)
Entre no diretório do projeto e configure o ambiente Python:
cd rag-with-sudachi

uv sync               # Install Python dependencies using uv

cp .env.example .env  # Create an environment file based on the template
Etapa 2: Configure o Zilliz Cloud (camada gratuita)
O Zilliz Cloud roda em todos os principais provedores de nuvem—AWS, GCP e Azure. Você pode se cadastrar diretamente no site da Zilliz ou assinar por meio dos respectivos marketplaces de nuvem. Neste tutorial, vou usar o caminho do AWS Marketplace, pois é uma forma rápida de criar um cluster Milvus totalmente gerenciado sem mexer em nenhuma infraestrutura.
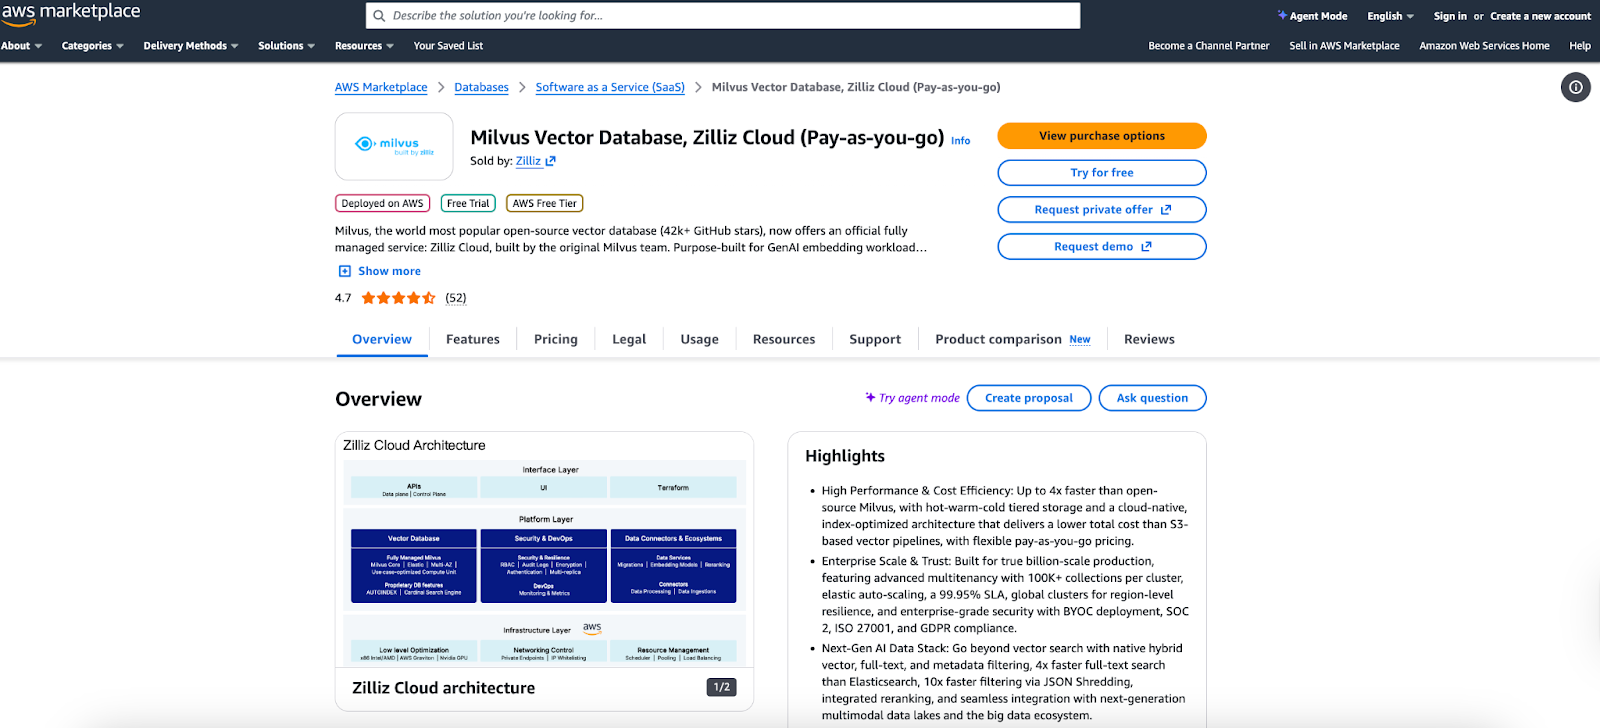
- Acesse a listagem do Zilliz Cloud no AWS Marketplace e clique em “Experimente grátis.” Isso cria um cluster Milvus serverless sem custo:
Ele nunca será convertido automaticamente para um plano pago
Tem algumas limitações (por exemplo, recursos de monitoramento restritos)
O cluster é mais do que suficiente para este tutorial de pesquisa híbrida
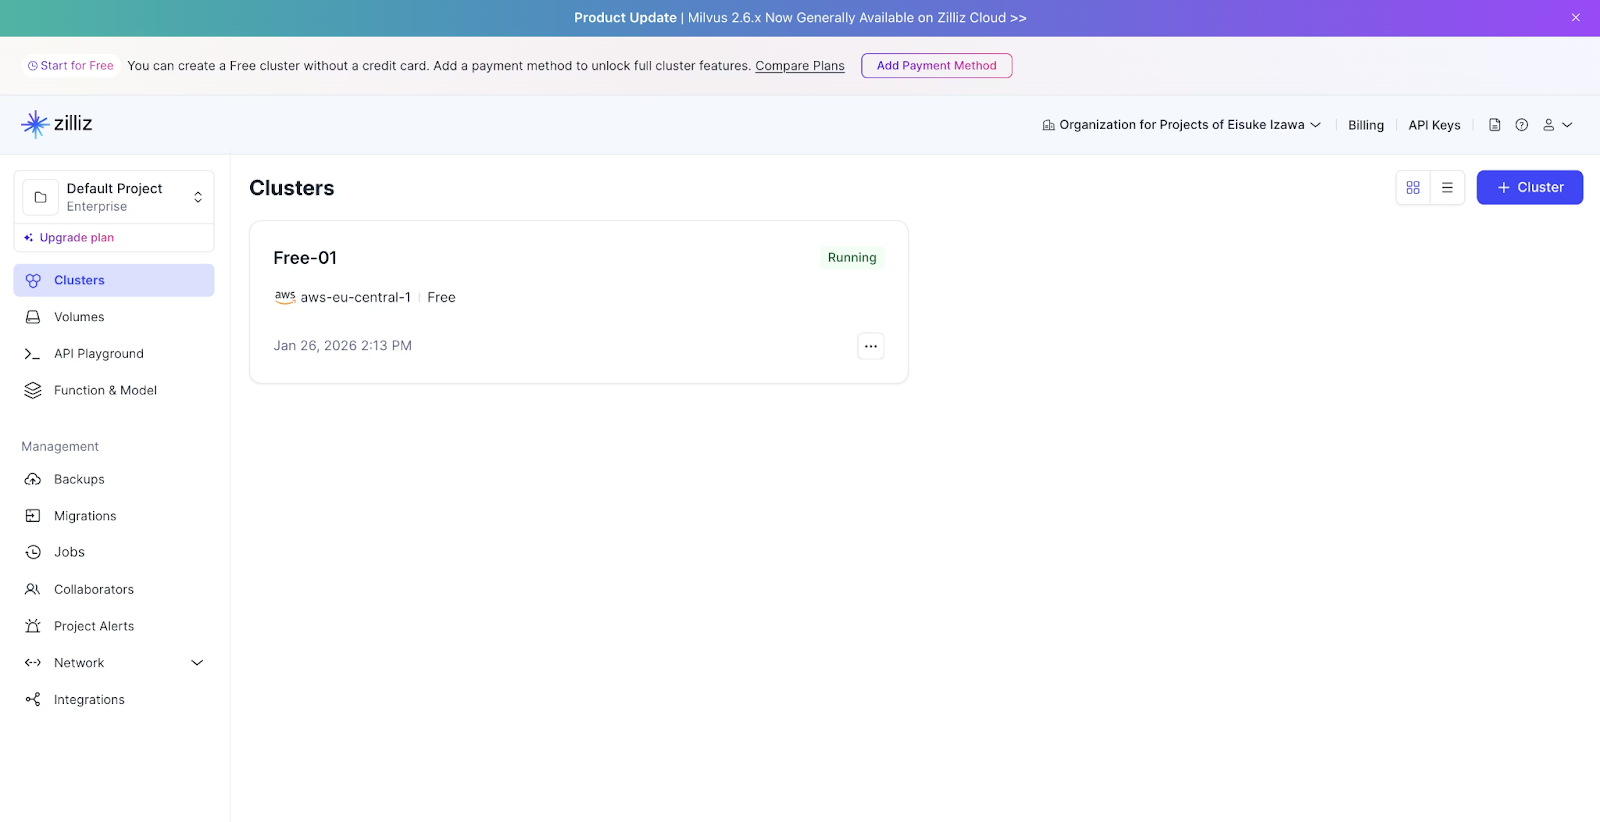
2. Abra o console do Zilliz Cloud depois que a assinatura for concluída:
Crie uma nova Organization (apenas um contêiner lógico para seus projetos).
Você verá um cluster serverless gratuito já provisionado.
Copie o Cluster Endpoint e a API Key — você precisará deles ao se conectar a partir do seu código.
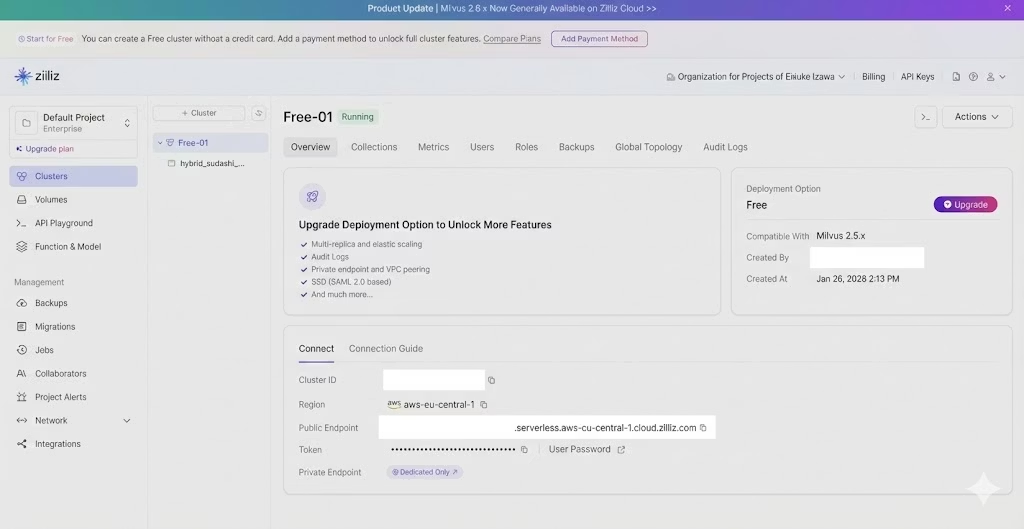
Etapa 3: Configurar variáveis de ambiente
Cole suas credenciais do Zilliz e do Bedrock no arquivo .env:
# Zilliz Cloud connection

ZILLIZ_CLOUD_URI=https://your-cluster-id.serverless.region.cloud.zilliz.com

ZILLIZ_CLOUD_API_KEY=your-api-key-here


# AWS Bedrock short-term API key

AWS_BEARER_TOKEN_BEDROCK=bedrock-api-key-your-token-here
Observação sobre o código: os tokens de curto prazo do Bedrock expiram a cada 12 horas. Isso é intencional — eles reduzem o raio de impacto da exposição de credenciais e são ideais para o desenvolvimento local.
Etapa 4: Iniciar o Notebook ou executar o script
Abra o repositório no VS Code. O tutorial principal está localizado em:
notebooks/hybrid_search_with_bm25.ipynb
Se você preferir um fluxo de trabalho em Python puro em vez do Jupyter Notebook, pode executar:
python run_hybrid_search.py
Ambas as versões:
Criam o schema do Milvus
Aplicam a normalização do Sudachi
Inserem vetores densos e esparsos
Comparam os resultados da pesquisa semântica, por palavra-chave e híbrida
Detalhes técnicos
1. A chave para o processamento de japonês: normalização de texto com Sudachi
Em sistemas de recuperação para conteúdo em japonês, uma grande parte da precisão depende de como o texto é pré-processado durante a indexação. O texto extraído de PDFs frequentemente contém espaçamento inconsistente, variações ortográficas ou ruído, o que muitas vezes leva a correspondências perdidas e menor recall.
Para resolver esse problema, esta implementação usa a função de normalização do Sudachi. Esse processo padroniza os tokens antes da indexação para que o sistema de pesquisa possa tratar diferentes grafias e representações como equivalentes.
Código: wrapper de normalização do Sudachi
class SudachiAnalyzer:

    def __init__(self):

        self.tokenizer = dictionary.Dictionary(dict="core").create()

        self.mode = tokenizer.Tokenizer.SplitMode.C


    def analyze(self, text: str) -> str:

        if not text:

            return ""

        tokens = self.tokenizer.tokenize(text, self.mode)

        # Return as a space-separated string

        return " ".join(\[t.normalized_form() for t in tokens if t.surface().strip()\])


analyzer = SudachiAnalyzer()
Por que a normalização é importante
Usar normalized_form() unifica variações como:
Katakana: 「サーバー」 ⇔ 「サーバ」
Notação numérica: 「第1条」 ⇔ 「第一条」
Ruído de espaçamento em PDF: 「第 一 条」(不自然なスペース) ⇔ 「第一条」
Sem normalização, essas variações levam a:
Correspondências BM25 perdidas
Tokenização incorreta de vetores esparsos
Menor recall para consultas com estrutura jurídica
Ao normalizar tanto documentos quanto consultas, o sistema híbrido aumenta drasticamente a probabilidade de correspondência.
2. Design do schema no Zilliz Cloud (Milvus gerenciado)
Milvus, o núcleo do Zilliz Cloud, fornece um recurso Function (disponível na v2.4 e posteriores) que gera automaticamente vetores esparsos baseados em BM25 no banco de dados. Isso elimina a necessidade de pré-computar vetores BM25 no lado do cliente.
Definição do schema
# Create schema (auto ID disabled for explicit ID assignment)

schema = MilvusClient.create_schema(auto_id=False, enable_dynamic_field=True)


# Field definitions

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)

schema.add_field(

    field_name="text",

    datatype=DataType.VARCHAR,

    max_length=65535,

    enable_analyzer=True,

    analyzer_params={

        "tokenizer": "whitespace"

    },  # Sudachi already provides whitespace-separated input

)

schema.add_field(

    field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=1024

)  # Titan Embeddings v2 outputs 1024 dimensions

schema.add_field(field_name="sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR)


# Define the BM25 function

bm25_function = Function(

    name="text_bm25_emb",

    input_field_names=\["text"\],

    output_field_names=\["sparse_vector"\],

    function_type=FunctionType.BM25,

)

schema.add_function(bm25_function)
Este design elimina a necessidade de passar explicitamente vetores esparsos durante a inserção de dados, reduzindo significativamente a complexidade operacional.
Ao transferir a geração de vetores BM25 para o próprio Milvus:
O pipeline de ingestão se torna mais simples
Nenhum cálculo explícito de vetor esparso é necessário
Você evita manter código adicional de pré-processamento
O escalonamento se torna muito mais fácil
Isso reduz significativamente a carga operacional.
Design de Índice e Estratégia de Otimização
# Index definitions

index_params = client.prepare_index_params()

index_params.add_index(

    field_name="dense_vector", index_type="HNSW", metric_type="COSINE"

)

index_params.add_index(

    field_name="sparse_vector",

    index_type="SPARSE_INVERTED_INDEX",

    metric_type="BM25",

    params={"inverted_index_algo": "DAAT_MAXSCORE"},

)
Índice de Vetor Denso: HNSW
HNSW (Hierarchical Navigable Small World) é um algoritmo ANN baseado em grafos amplamente usado em bancos de dados vetoriais. Ele oferece:
Recuperação em alta velocidade
Alta revocação
Forte desempenho em escala
COSINE é usado como métrica de similaridade porque os Titan Embeddings operam em espaço de cosseno normalizado.
Índice de Vetor Esparso: Índice Invertido com Otimização MaxScore
Vetores esparsos usam uma estrutura tradicional de índice invertido. A otimização adicional DAAT_MAXSCORE fornece:
Processamento documento por vez para travessia eficiente
Poda antecipada de documentos que não conseguem atingir pontuações top-k
Computação reduzida sem comprometer a precisão
Isso leva a uma busca BM25 significativamente mais rápida.
3. Implementação de Busca Híbrida Usando RRF
Para mesclar de forma justa os resultados de buscas densas (semânticas) e esparsas (por palavra-chave), o sistema usa Reciprocal Rank Fusion (RRF). RRF é robusto, fácil de aplicar e não requer ajuste ou normalização entre tipos de pontuação.
Código de Busca Híbrida
from pymilvus import AnnSearchRequest, RRFRanker


def search_hybrid(client, collection_name, query_text, query_vector, top_k=5):

    # Normalize and tokenize the query using Sudachi

    query_processed = analyzer.analyze(query_text)


    # Dense semantic search request

    req_dense = AnnSearchRequest(

        data=\[query_vector\],

        anns_field="dense_vector",

        param={"metric_type": "COSINE"},

        limit=top_k * 2,

    )


    # Sparse BM25 keyword search request

    req_sparse = AnnSearchRequest(

        data=\[query_processed\],

        anns_field="sparse_vector",

        param={"metric_type": "BM25"},

        limit=top_k * 2,

    )


    # Perform hybrid search using RRF

    res = client.hybrid_search(

        collection_name=collection_name,

        reqs=\[req_dense, req_sparse\],

        ranker=RRFRanker(),  # Fuse rankings using RRF

        limit=top_k,

        output_fields=\["text", "original_text"\],

    )

    return res\[0\]
Comparação dos Resultados Reais da Busca
O tutorial avalia os resultados usando documentos publicamente disponíveis da Agência de Serviços Financeiros do Japão. O notebook permite uma comparação lado a lado de:
Busca semântica (vetor denso)
Busca de texto completo (vetor esparso)
Busca híbrida (denso + esparso via RRF)
Estudo de Caso: Consulta com Forte Presença de Palavras-chave
Consulta: “指定ADR機関が存在しない場合の苦情処理措置”
Observação: a consulta significa “Um procedimento para tratamento de reclamações quando não existe uma organização ADR designada.”
Resultados:
Busca vetorial densa: Frequentemente retorna trechos conceitualmente relacionados, mas tem dificuldade para destacar cláusulas regulatórias exatas.
Busca esparsa BM25: Identifica corretamente documentos que contêm termos como “organização ADR designada” e “medidas de tratamento de reclamações”, classificando-os nas primeiras posições.
Busca híbrida: Combina a capacidade de correspondência precisa do BM25 com contexto relevante adicional recuperado pela busca densa.
Isso mostra que a busca apenas densa corre o risco de perder resultados críticos quando os usuários consultam com terminologia especializada. A busca híbrida é essencial para a recuperação de documentos empresariais.
Resumo e Aplicações
Neste artigo, percorremos uma configuração prática de busca híbrida que combina normalização baseada em Sudachi com Zilliz Cloud (Milvus gerenciado). O objetivo era simples: criar um pipeline de recuperação que tenha bom desempenho em textos em japonês, nos quais tanto a similaridade semântica quanto a correspondência exata são importantes. Ao combinar vetores densos, vetores esparsos BM25 e fusão baseada em RRF, o sistema permanece preciso, fácil de executar e adaptável a cargas de trabalho reais de produção.
Principais Benefícios
Robusto a variações ortográficas: A normalização do Sudachi suaviza diferenças ortográficas, problemas de espaçamento e ruído de extração de PDFs, evitando falhas comuns de recall em buscas em textos em japonês.
Baixa sobrecarga operacional: As Functions do Milvus lidam com a geração de vetores esparsos BM25 dentro do banco de dados. Sem trabalhos extras de pré-processamento, sem serviço de busca externo e sem lógica de indexação duplicada.
Alta precisão geral: O RRF combina recuperação densa e esparsa sem ajuste complexo de pesos. Você obtém resultados híbridos estáveis que lidam bem tanto com consultas conceituais quanto com identificadores exatos.
Possíveis Casos de Uso
Essa abordagem híbrida se destaca em cenários nos quais os usuários podem alternar entre consultas precisas e estruturadas e linguagem aberta:
Busca em políticas e manuais internos: Oferece suporte a referências exatas (por exemplo, números de artigos) e, ao mesmo tempo, lida com consultas vagas ou exploratórias.
Busca de produtos em e-commerce: Permite a consulta precisa por número de peça e, ao mesmo tempo, oferece recomendações baseadas em similaridade.
Bases de conhecimento de suporte ao cliente: Corresponde termos estruturados, como códigos de erro, e ainda interpreta entradas naturais do usuário (“画面が真っ黒です”, “ログインできない”).
O código-fonte completo e o Jupyter Notebook usados neste artigo estão disponíveis no seguinte repositório: GitHub: rag-with-sudachi
O custo para experimentar tudo é mínimo — apenas as chamadas de embedding do AWS Bedrock são cobradas. A camada serverless gratuita do Zilliz Cloud é suficiente para executar todo o fluxo de trabalho.
Se você está explorando busca híbrida para sistemas de produção ou protótipos internos, este exemplo é um excelente ponto de partida.
Continue lendo
Top 10 Context Engineering Techniques You Should Know for Production RAG
A practical guide to context engineering for production LLM systems, covering RAG, context processing, memory, agents, and multimodal context.

Data Deduplication at Trillion Scale: How to Solve the Biggest Bottleneck of LLM Training
Explore how MinHash LSH and Milvus handle data deduplication at the trillion-scale level, solving key bottlenecks in LLM training for improved AI model performance.
How to Use Anthropic MCP Server with Milvus
MCP + Milvus: Streamline AI agent development with standardized data access, eliminating integration hassles while enhancing context and flexibility.