




Inferência de Embeddings em Escala para Aplicações RAG com Ray Data e Milvus
Geração Aumentada por Recuperação (RAG) é um dos casos de uso mais populares para IA Generativa empresarial. A maioria dos tutoriais de RAG mostra como usar a API da OpenAI tanto para o modelo de embedding quanto para a inferência do modelo de linguagem grande (LLM). Por que você deveria pagar para acessar seus próprios dados, especialmente durante o processo de desenvolvimento? Você pode acessar seus próprios dados e iterar tão rapidamente quanto quiser usando código aberto.
Uma das descobertas mais intrigantes foi o notável aumento de desempenho alcançado com Ray Data durante a etapa de embedding, em que os dados são transformados em vetores.
Executar embeddings de código aberto usando solicitações de inferência em lote agrupadas com ferramentas como Ray Data economizou recursos e tempo em comparação com Pandas. Usando apenas quatro workers em um laptop Mac M2 com 16GB de RAM, Ray Data foi 60 vezes mais rápido; mais detalhes adiante neste blog.
Nossa Stack RAG de Código Aberto:
Novo modelo de embedding BGM-M3 (gerando 3 tipos de vetores em uma rodada: esparsos, densos e multi-vetores)
Ray Data para inferência de embedding rápida e distribuída
AWS S3 para armazenar temporariamente o resultado da inferência
Banco de dados vetorial Milvus ou Zilliz Cloud
Dados de exemplo baixados de Kaggle IMDB poster
Nossa Stack RAG de Código Aberto
Modelo de Embedding BGM-M3
Embeddings Esparsos, Densos e Multi-vetoriais Poderosos. O modelo de embedding BGE-M3 é apelidado por suas capacidades “multi”: Multilinguismo, Multifuncionalidade e Multigranularidade. Ele pode trabalhar com mais de 100 idiomas, calcular simultaneamente embeddings para os três métodos comuns de recuperação: embeddings densos, esparsos e multi-vetoriais. Ele também funciona com vários comprimentos de texto, de frases curtas a documentos longos (até 8.192 tokens). Você pode saber mais neste Paper, ou nesta página da HuggingFace sobre o model.
Desde a versão 2.4, o Milvus tem suporte integrado para BGE M3.
Ray Data
Tarefas de transformação de dados de longa duração?
O processamento de dados escalável do Ray Data torna mais fácil e rápido processar enormes quantidades de dados em paralelo em várias máquinas (CPUs, GPUs etc.). Ray Data é especialmente útil quando os dados podem ser divididos em processos paralelos, como muitas transformações simultâneas de fragmentação e embedding! Por baixo dos panos, Ray Data tem um poderoso mecanismo de execução em streaming, para maximizar a utilização de GPU no cluster. Em comparação com a execução de embedding com um serviço online (como a API de embedding da OpenAI), executar um job de embedding offline com Ray Data pode economizar a maior parte do custo.
Anyscale é uma plataforma gerenciada para Ray. Você pode facilmente escalar horizontalmente os jobs de embedding no Anyscale para aproveitar centenas de máquinas com GPU.
Milvus e Zilliz
O ingrediente secreto por trás de um app RAG ultrarrápido é um banco de dados vetorial poderoso!_ Milvus foi criado para lidar com enormes quantidades de dados para uso em larga escala por empresas. Ao contrário de alguns bancos de dados vetoriais, o Milvus pode crescer de forma flexível conforme suas necessidades de dados aumentam – suas camadas arquiteturais de Armazenamento, Indexação e Consulta são projetadas para escalar verticalmente de forma independente e/ou horizontalmente. Isso torna seu app RAG rápido, pois o Milvus realiza inteligentemente computações offline antes e enquanto as consultas chegam em tempo real. Além disso, o Milvus vem com outros recursos importantes para empresas, como manter seus dados seguros e organizados (multi-tenancy e controle de acesso baseado em funções) e garantir que estejam sempre disponíveis (alta disponibilidade).
Zilliz é um produto de nuvem gerenciado e usa o Milvus de código aberto.
Configure Suas Ferramentas RAG
Usaremos o SDK do Python para Milvus, Ray Data, Amazon S3 e Zilliz.
Para Amazon S3, você precisará se cadastrar para obter uma conta da AWS.
No seu navegador, acesse console.aws.amazon.com > IAM > My security credentials > Create access key. Copie e salve localmente, de forma segura, sua chave e chave secreta.
Instale as bibliotecas e execute aws config. Isso colocará as variáveis da AWS em um arquivo de credenciais.
pip install boto3
pip install awscli –force-reinstall –upgrade
aws config #fill in your key and secret key
more ~/.aws/credentials #make sure this looks correct
Instale o Ray Data:
pip install -U "ray[data]"
Instale o Pymilvus:
pip install -U pymilvus "pymilvus[model]" langchain
O modelo de embeddings BGE-M3 já vem empacotado com o Pymilvus desde a v2.4.
import ray, os, pprint, time, boto3
from langchain.text_splitter import RecursiveCharacterTextSplitter
import numpy as np
import pymilvus
print(pymilvus.__version__) # must be >= 2.4.0
from pymilvus.model.hybrid import BGEM3EmbeddingFunction
Para usar o nível gratuito da Zilliz (até 2 coleções, 1 milhão de vetores cada), cadastre-se para obter uma conta e crie um cluster Starter.
Preparar os dados
O código neste blog usa os conhecidos dados públicos de pôsteres do IMDB no Kaggle. Ele contém cerca de 48.000 filmes, avaliações, links de pôsteres e mais metadados.
Copiei todos os campos de texto (nome do filme, descrição, texto da avaliação) para uma nova coluna chamada ‘text’ e salvei em formato Parquet, pois ele é mais eficiente do que CSV.
Gerar embeddings
As etapas para criar embeddings são:
- Dividir os dados em chunks: Dividir o texto de entrada em chunks, para manter juntas as partes de texto semanticamente relacionadas.
- Chamar um modelo de embedding em modo de inferência para gerar representações vetoriais dos chunks.
O Ray Data consegue paralelizar essas operações de dados usando:
- flat_map() para dividir os dados em chunks, já que a saída terá mais linhas do que a entrada.
- map_batches() para chamar o modelo de embedding de dentro de um método Class chamável.
chunk_size = 512
chunk_overlap = np.round(chunk_size * 0.10, 0)

# Define a LangChain text splitter.
text_splitter = RecursiveCharacterTextSplitter(
   chunk_size=chunk_size,
   chunk_overlap=chunk_overlap,
   length_function=len)  #len is a built-in Python function

# 1. Define a regular python function for chunking.
def chunk_row(row, splitter=text_splitter):

   # Copy the row columns into metadata.
   metadata = row.copy()
   del metadata['text'] # Remove text from metadata

   # Split the text into chunks.
   chunks = splitter.create_documents(
       texts=[row["text"]],
       metadatas=[metadata])
   chunk_list = [{
       "text": chunk.page_content,
       **chunk.metadata} for chunk in chunks]

   return chunk_list

# 2. Define a class with a callable method to compute embeddings.
class ComputeEmbeddings:
     def __init__(self):
           # Initialize a Milvus built-in sparse-dense-late-interaction-reranking encoder.
           # https://huggingface.co/BAAI/bge-m3
           self.model = BGEM3EmbeddingFunction(use_fp16=False, device="cpu")
           print(f"dense_dim: {self.model.dim['dense']}")
           print(f"sparse_dim: {self.model.dim['sparse']}")

     def __call__(self, batch):

           # Ray data batch is a dictionary where values are array values.
           # BGEM3EmbeddingFunction input is docs as a list of strings.
           docs = list(batch['text'])

           # Encode the documents. bge-m3 dense embeddings are already normalized.
           embeddings = self.model(docs)
           batch['vector_dense'] = embeddings['dense']
           return batch

if __name__ == "__main__":

   FILE_PATH = "s3://zilliz/kaggle_imdb.parquet"

   # Load and transform data.

   ds = ray.data.read_parquet(FILE_PATH)

   # Chunk the input text
   chunked_ds = ds.flat_map(chunk_row)

   # Compute embeddings with a class that calls the embeddings model.
   embeddings_ds = chunked_ds.map_batches(ComputeEmbeddings, concurrency=4)

   # Save the embeddings to S3 in a folder of parquet part files.
   embeddings_ds.write_parquet('s3://zilliz/kaggle_imdb_embeddings')
Para executar isso, você o enviará como um job do Ray:
Salve o código em um arquivo de script Python. Eu o chamei de ray_data_demo.py
Para executar localmente a partir do seu laptop, crie um diretório limpo, apenas com o arquivo de script .py e o arquivo de dados .parquet. Coloque apenas o mínimo indispensável nesse diretório limpo. Eu chamei o meu de ‘ray_cluster’.
Execute o script Python. Isso iniciará um cluster Ray e enviará um job automaticamente.
**Navegue até
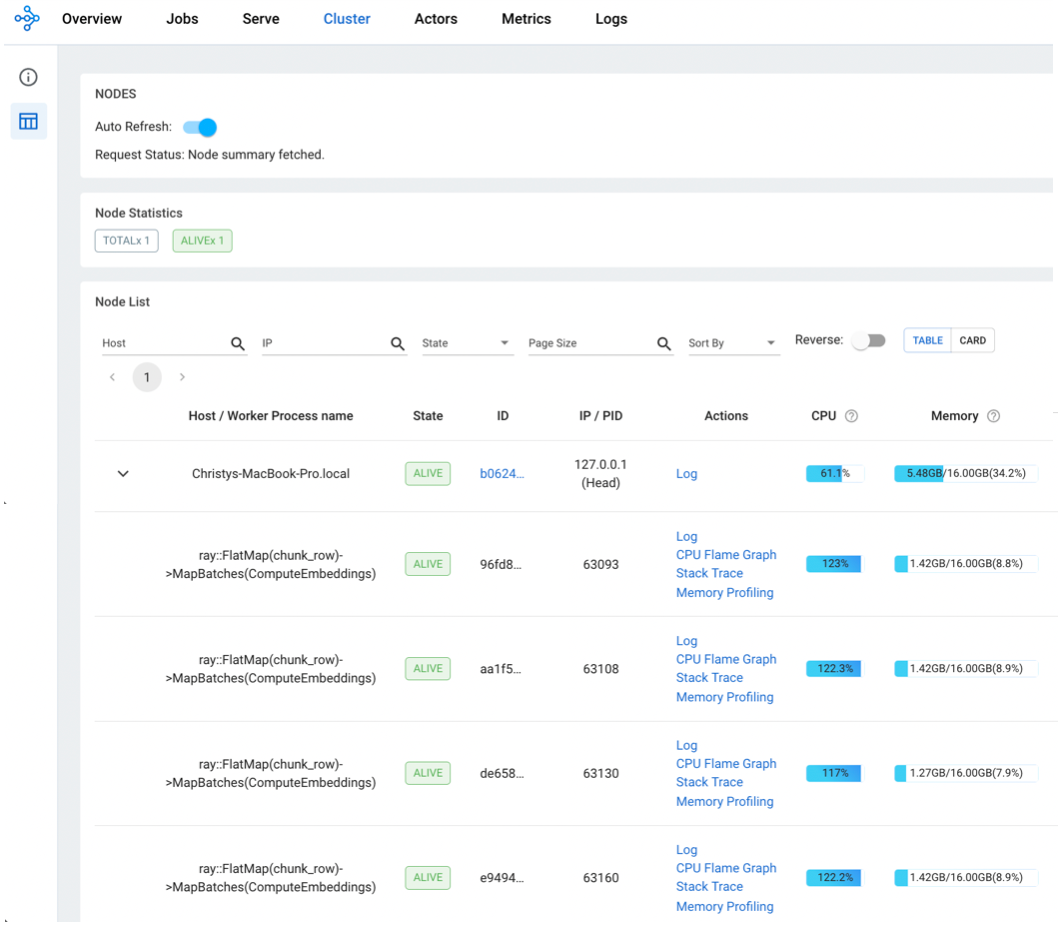
http://127.0.0.1:8265. Veja os tempos de Cluster e Jobs.
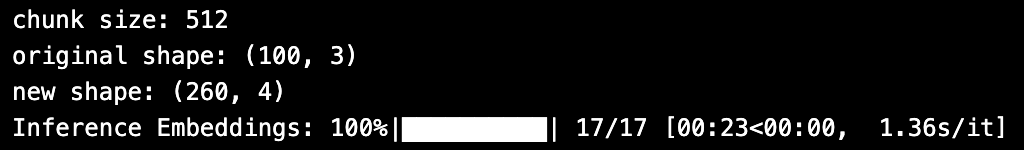
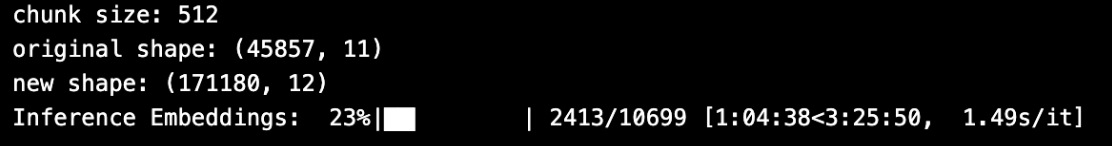
Latência de Embedding - 60x mais rápido em um laptop
| Abordagem | Tamanho dos dados de entrada | Tempo total | Captura de tela |
| Pandas | 100 linhas | 23 s |
|
| Ray Data | 100 linhas | 50 s |

|
| Pandas | 45K linhas | >4 horas |
|
| Ray Data | 45K linhas | 4 min |

|
Tabela: Tempos para gerar embeddings de dados em um laptop M2 com 16 GB. O processamento em lote do Ray Data ocorreu em um cluster Ray de nó único, concurrency= 4 workers. O Pandas foi lento porque tinha apenas um processador, enquanto o Ray Data tinha 4 processadores. Ambos seriam executados mais rapidamente em um cluster maior.
Inserção em massa dos dados embutidos do S3 diretamente no Milvus ou Zilliz
Tanto o Milvus quanto a Zilliz oferecem inserção em massa para importar dados já embutidos diretamente da AWS, GCP ou Azure. Além do console web (mostrado abaixo), a Zilliz também oferece uma API restful e SDK.
Para um grande corpus de embeddings gerados em lote, usar importação em massa pode economizar significativamente recursos de máquina e reduzir o tempo de inserção em comparação com a inserção incremental. Mais importante ainda, o índice de busca vetorial criado pela importação em massa é muito mais eficiente do que aquele criado pela inserção incremental (pense em otimização global vs. otimização local).
Vamos ver como realizar convenientemente a importação em massa com alguns cliques simples no console web do Zilliz Cloud. A partir do Cluster onde você deseja criar a nova coleção, crie uma nova coleção com AutoID, apenas a coluna “vector” com o EMBEDDING_DIMENSION correto, use a conveniente opção “Dynamic Field” e clique em “Create Collection”.
Em seguida, clique em “Importar dados” e siga as instruções na tela para copiar o caminho para os arquivos parquet gravados pelo job do Ray Data. (Observe que você também precisa especificar a Chave de acesso e a Chave secreta se o seu bucket S3 for privado, para que o Zilliz Cloud consiga ler os dados nele). Qualquer uma das fontes em nuvem Amazon S3, Google Cloud Storage ou Azure Blob Storage é compatível. Clique em “Importar” para começar a importar todos os dados para a coleção do banco de dados vetorial.
Depois de importado, você pode, opcionalmente, clicar em criar índice na coleção para tornar a busca vetorial mais eficiente na etapa Consultar seus dados.

Imagem: Captura de tela das telas de inserção em massa do Zilliz.
Consulte Seus Dados
Para testar a coleção recém-importada, vamos fazer uma pergunta e recuperar respostas dos nossos dados de filmes.
def mc_run_search(question, output_fields, top_k=2, filter_expression=""):

   # Embed the question using the same encoder.
   embeddings = model_bgem3([question])
   query_embeddings = embeddings['dense']

   # Run semantic vector search using your query and the vector database.
   results = mc.search(
       COLLECTION_NAME,
       data=query_embeddings,
       search_params=SEARCH_PARAMS,
       output_fields=output_fields,
       # Milvus can utilize metadata in boolean expressions to filter search.
       filter=filter_expression,
       limit=top_k,
       consistency_level="Eventually"
   )

   # Assemble retrieved context and context metadata.
   # The search result is in the variable `results[0]`, which is type
   # 'pymilvus.orm.search.SearchResult'.
   METADATA_FIELDS = [f for f in output_fields if f != 'chunk']
   formatted_results, context, context_metadata = _utils.client_assemble_retrieved_context(
       results, metadata_fields=METADATA_FIELDS, num_shot_answers=top_k)
   return formatted_results, context, context_metadata

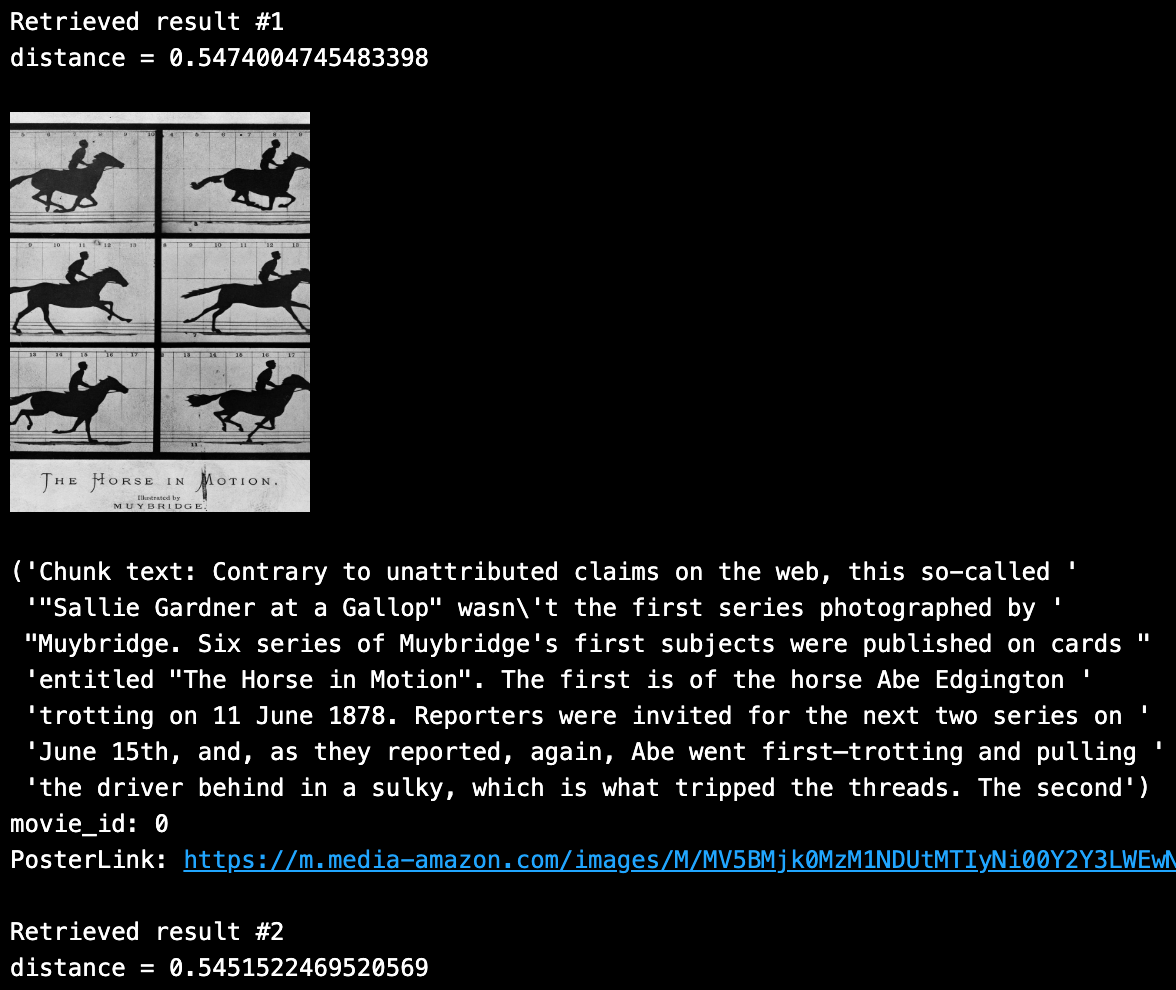
SAMPLE_QUESTION = "muybridge horse movie"

# Return top k unique results with HNSW index.
TOP_K = 2

# Define output fields to return.
OUTPUT_FIELDS = ["movie_id", "chunk", "PosterLink"]

formatted_results, context, context_metadata = \
   mc_run_search(SAMPLE_QUESTION, OUTPUT_FIELDS, TOP_K)
Percorrendo os 2 principais resultados exclusivos, podemos ver o seguinte conteúdo retornado de forma próxima pela consulta de busca acima:
O script completo do Ray Data está disponível no GitHub.
Conclusão
Este blog mostrou como usar os recursos Ray Data e Importação em massa do Milvus para acelerar significativamente a geração de vetores e carregá-los em lote de forma eficiente em um banco de dados vetorial. Por exemplo, gerar embeddings para 102 mil linhas de dados usando Ray Data levou 4 minutos, em comparação com 4 horas usando uma abordagem ingênua com Pandas! ****Além disso, usar a Importação em massa no Milvus pode criar um índice vetorial altamente eficiente e economizar recursos e tempo em comparação com a inserção incremental regular. Confira os recursos do Ray Data e de Importação em massa no Milvus e no Zilliz Cloud para mais detalhes!
 Christy Bergman
 is a passionate Developer Advocate at Zilliz. She previously worked in distributed computing at Anyscale and as a Specialist AI/ML Solutions Architect at AWS. Christy studied applied math, is a self-taught coder, and has published papers, including one with ACM Recsys. She enjoys hiking and bird watching.
 Cheng Su
 is the manager of the Data team at Anyscale, a committer of the Ray open source project (https://github.com/ray-project/ray), and the code owner of the Ray Data module. Previously, Cheng Su worked in the Data Infrastructure teams at Meta, Spark, and Hadoop.
Continue lendo
My Wife Wanted Dior. I Spent $600 on Claude Code to Vibe-Code a 2M-Line Database Instead.
Write tests, not code reviews. How a test-first workflow with 6 parallel Claude Code sessions turns a 2M-line C++ codebase into a daily shipping pipeline.

Zilliz Cloud Delivers Better Performance and Lower Costs with Arm Neoverse-based AWS Graviton
Zilliz Cloud adopts Arm-based AWS Graviton3 CPUs to cut costs, speed up AI vector search, and power billion-scale RAG and semantic search workloads.
DeepSeek Always Busy? Deploy It Locally with Milvus in Just 10 Minutes—No More Waiting!
Learn how to set up DeepSeek-R1 on your local machine using Ollama, AnythingLLM, and Milvus in just 10 minutes. Bypass busy servers and enhance AI responses with custom data.