Chroma에서 Zilliz Cloud로 마이그레이션하는 방법
Chroma Cloud는 Chroma의 종료 일정에 따라 2026년 11월 22일에 쓰기 수락을 중단하고, 2026년 12월 22일에 읽기 제공을 중단합니다. 애플리케이션이 Chroma Cloud에 데이터를 쓴다면 첫 번째 날짜 이전에 새 저장소를 마련해야 하며, 두 번째 날짜 이전에 데이터를 모두 옮겨야 합니다.
오픈소스 Chroma는 영향을 받지 않습니다. 하지만 직접 운영하면서 프로덕션에 적용하려 하고, 한 대의 머신이 감당하기 어려운 데이터 규모, 가동 시간 목표, 그리고 이를 위해 온콜을 기꺼이 하려는 사람이 없는 상황이라면, 마이그레이션 방법은 마감 기한만 없다는 점을 제외하고 동일합니다.
이 가이드는 두 경우 모두 Zilliz Cloud로 옮깁니다. Zilliz Cloud는 오픈소스 Milvus 기반의 완전 관리형 벡터 데이터베이스입니다. 임베딩은 그대로 이전되므로 다시 임베딩할 필요가 없으며, ID, 문서, URI, 메타데이터도 함께 이동합니다. 직접 오픈소스 Milvus를 운영하려는 경우에도 동일한 단계가 적용됩니다. 1단계의 Chroma를 오픈소스 Milvus로 이동을 참조하세요.
마이그레이션은 네 단계로 구성됩니다: 데이터 이동, 데이터 확인, 애플리케이션 업데이트, 전환.
시작하기 전에
다음이 필요합니다:
- Zilliz Cloud 클러스터 — 공용 엔드포인트와 API 키가 있어야 합니다. 없으면 가입하세요. 무료 플랜은 최대 5개 컬렉션을 지원합니다. 더 필요하면 Serverless 또는 Dedicated 클러스터를 사용하세요.
- Chroma 연결 정보. Chroma Cloud에서 대시보드의 Connect 패널에 API 키, 테넌트 ID, 데이터베이스 이름이 표시됩니다. 자체 호스팅 Chroma의 경우 서버 주소가 필요하며, 인증을 활성화했다면 토큰 또는 사용자 이름과 비밀번호도 필요합니다.
- Python 3.10 이상 — 복사된 데이터를 확인하고 애플리케이션을 업데이트하려면 두 클라이언트가 모두 필요합니다:
pip install chromadb==1.5.9 pymilvus==3.0.2
- Docker — 1단계의 옵션 B인 오픈소스 Vector Transport Service를 사용하는 경우 필요합니다.
데이터 매핑 방법
각 Chroma 컬렉션은 네 개의 필드를 가진 Zilliz Cloud 컬렉션이 됩니다. 메타데이터는 컬렉션의 동적 필드에 저장되므로, 모든 메타데이터 키는 Chroma에서와 마찬가지로 필터링 가능한 상태로 유지됩니다. Zilliz Cloud 문서 페이지 Chroma에서 Zilliz Cloud로 마이그레이션에는 메타데이터 유형이 타입 필드로 변환되는 방식 등 전체 매핑이 나와 있습니다.
| Chroma | Zilliz Cloud |
|---|---|
| 컬렉션 | 동일한 이름의 컬렉션으로, -는 _로 변환됩니다: support-docs는 support_docs가 됩니다. Zilliz Cloud 이름은 영문자, 숫자, 밑줄만 사용할 수 있으며 숫자로 시작할 수 없습니다. 따라서 kb.v2나 2024-notes 같은 이름은 복사본 설정 시 새 이름이 필요합니다. 변환 결과가 같은 두 이름(예: support-docs와 support_docs) 중 하나도 마찬가지입니다. |
id | id, VARCHAR 기본 키입니다. ID는 변경되지 않습니다. |
embedding | embedding, 동일한 차원의 FLOAT_VECTOR 필드입니다. |
document | document, 최대 65,535바이트의 nullable VARCHAR 필드입니다. |
uri | uri, nullable VARCHAR 필드입니다. URI 문자열은 복사되지만, URI가 가리키는 파일은 복사되지 않습니다. |
| 메타데이터 | 동적 필드의 키. 복사본을 설정할 때 선택한 키를 타입 필드로 전환할 수도 있습니다. |
거리 공간: cosine, l2, ip | 인덱스 메트릭: COSINE, L2, IP. 메트릭은 복사되지 않으며 인덱스를 생성할 때 설정합니다. |
| 임베딩 함수 | 데이터베이스에 저장되지 않습니다. 애플리케이션이 쿼리를 임베딩합니다(3단계). |
사용자당 컬렉션 하나? 각 Chroma 컬렉션은 고유한 Zilliz Cloud 컬렉션이 되며, 클러스터는 제한된 수의 컬렉션을 보유할 수 있습니다: Free는 5개, Serverless는 100개, Dedicated 클러스터는 컴퓨팅 유닛당 1,024개(최대 16,384개)입니다. 사용자별 컬렉션이 이보다 많거나 많아질 것으로 예상된다면, 마이그레이션 전에 문의하세요: 파티션 키가 있는 단일 컬렉션이 수백만 테넌트를 지원하는 더 나은 설계입니다.
1단계: 데이터 이동
데이터는 두 가지 방법으로 복사할 수 있습니다. 어느 쪽이 맞는지는 Chroma가 어디에서 실행되는지에 따라 달라집니다:
| Chroma 실행 위치 | 사용 방법 |
|---|---|
| Chroma Cloud | 옵션 A: 기본 제공 마이그레이션 서비스 |
| 인터넷에서 접근 가능한 자체 Chroma 서버 | 옵션 A: 기본 제공 마이그레이션 서비스 |
| 사설 네트워크 또는 노트북에서 실행하는 자체 Chroma, 또는 애플리케이션에 내장된 Chroma | 옵션 B: 벡터 전송 서비스(오픈소스) |
차이는 누가 누구에게 연결하느냐입니다. 마이그레이션 서비스는 Zilliz Cloud에서 실행되며 사용자의 Chroma에서 읽어 들이므로, 서비스가 도달할 수 있는 주소가 필요합니다. 벡터 전송 서비스는 사용자가 선택한 머신에서 실행되며 Zilliz Cloud로 데이터를 내보내므로, 두 곳 모두에 연결할 수 있는 어디에서든 작동합니다.
먼저 각 컬렉션의 레코드 수와 거리 공간(distance space)을 기록하세요. 어떤 옵션을 사용하든 인덱스 메트릭을 설정하려면 거리 공간이 필요하고, 복사 결과를 확인하려면 레코드 수가 필요합니다:
import chromadb

client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud: chromadb.CloudClient(api_key=..., tenant=..., database=...)

for collection in client.list_collections():
    config = collection.configuration_json
    space = (config.get("hnsw") or config.get("spann") or {}).get("space") or "l2"
    print(f"{collection.name}: {collection.count()} records, space {space}")
Chroma는 거리 공간 없이 생성된 컬렉션에 l2를 사용합니다. 빈 컬렉션은 복사에서 제외하세요. Chroma는 첫 번째 임베딩이 도착할 때까지 차원을 기록하지 않으므로, 대상을 생성할 근거가 없습니다.
옵션 A: Zilliz Cloud 마이그레이션 서비스
마이그레이션 서비스는 Zilliz Cloud 콘솔에 내장되어 있으며 무료로 사용할 수 있습니다. Organization Owner 또는 Project Admin 역할이 필요합니다. 자체 호스팅 Chroma 서버는 Chroma의 REST API v2를 제공해야 하며 Zilliz Cloud에서 접근할 수 있어야 합니다. 방화벽 뒤에 있다면 Zilliz Cloud의 IP 주소를 허용 목록에 추가하세요.
- 연결. 콘솔에서 Migrations을 열고 소스로 Chroma를 선택하세요. Chroma 엔드포인트, tenant, database, 자격 증명을 입력하세요. Chroma Cloud의 경우 Connect 패널에서 복사하세요. 엔드포인트는
https://api.trychroma.com이며, 데이터베이스가 AWS us-east-1 외부에 있다면 해당 지역의 엔드포인트를 사용하고, 자격 증명은 API 키입니다. 자체 호스팅 Chroma는 인증 없음, 토큰, 또는 사용자 이름과 비밀번호를 사용할 수 있으며, 기본 tenant와 database는 각각default_tenant와default_database입니다. 그런 다음 대상 클러스터와 데이터베이스를 선택하세요.
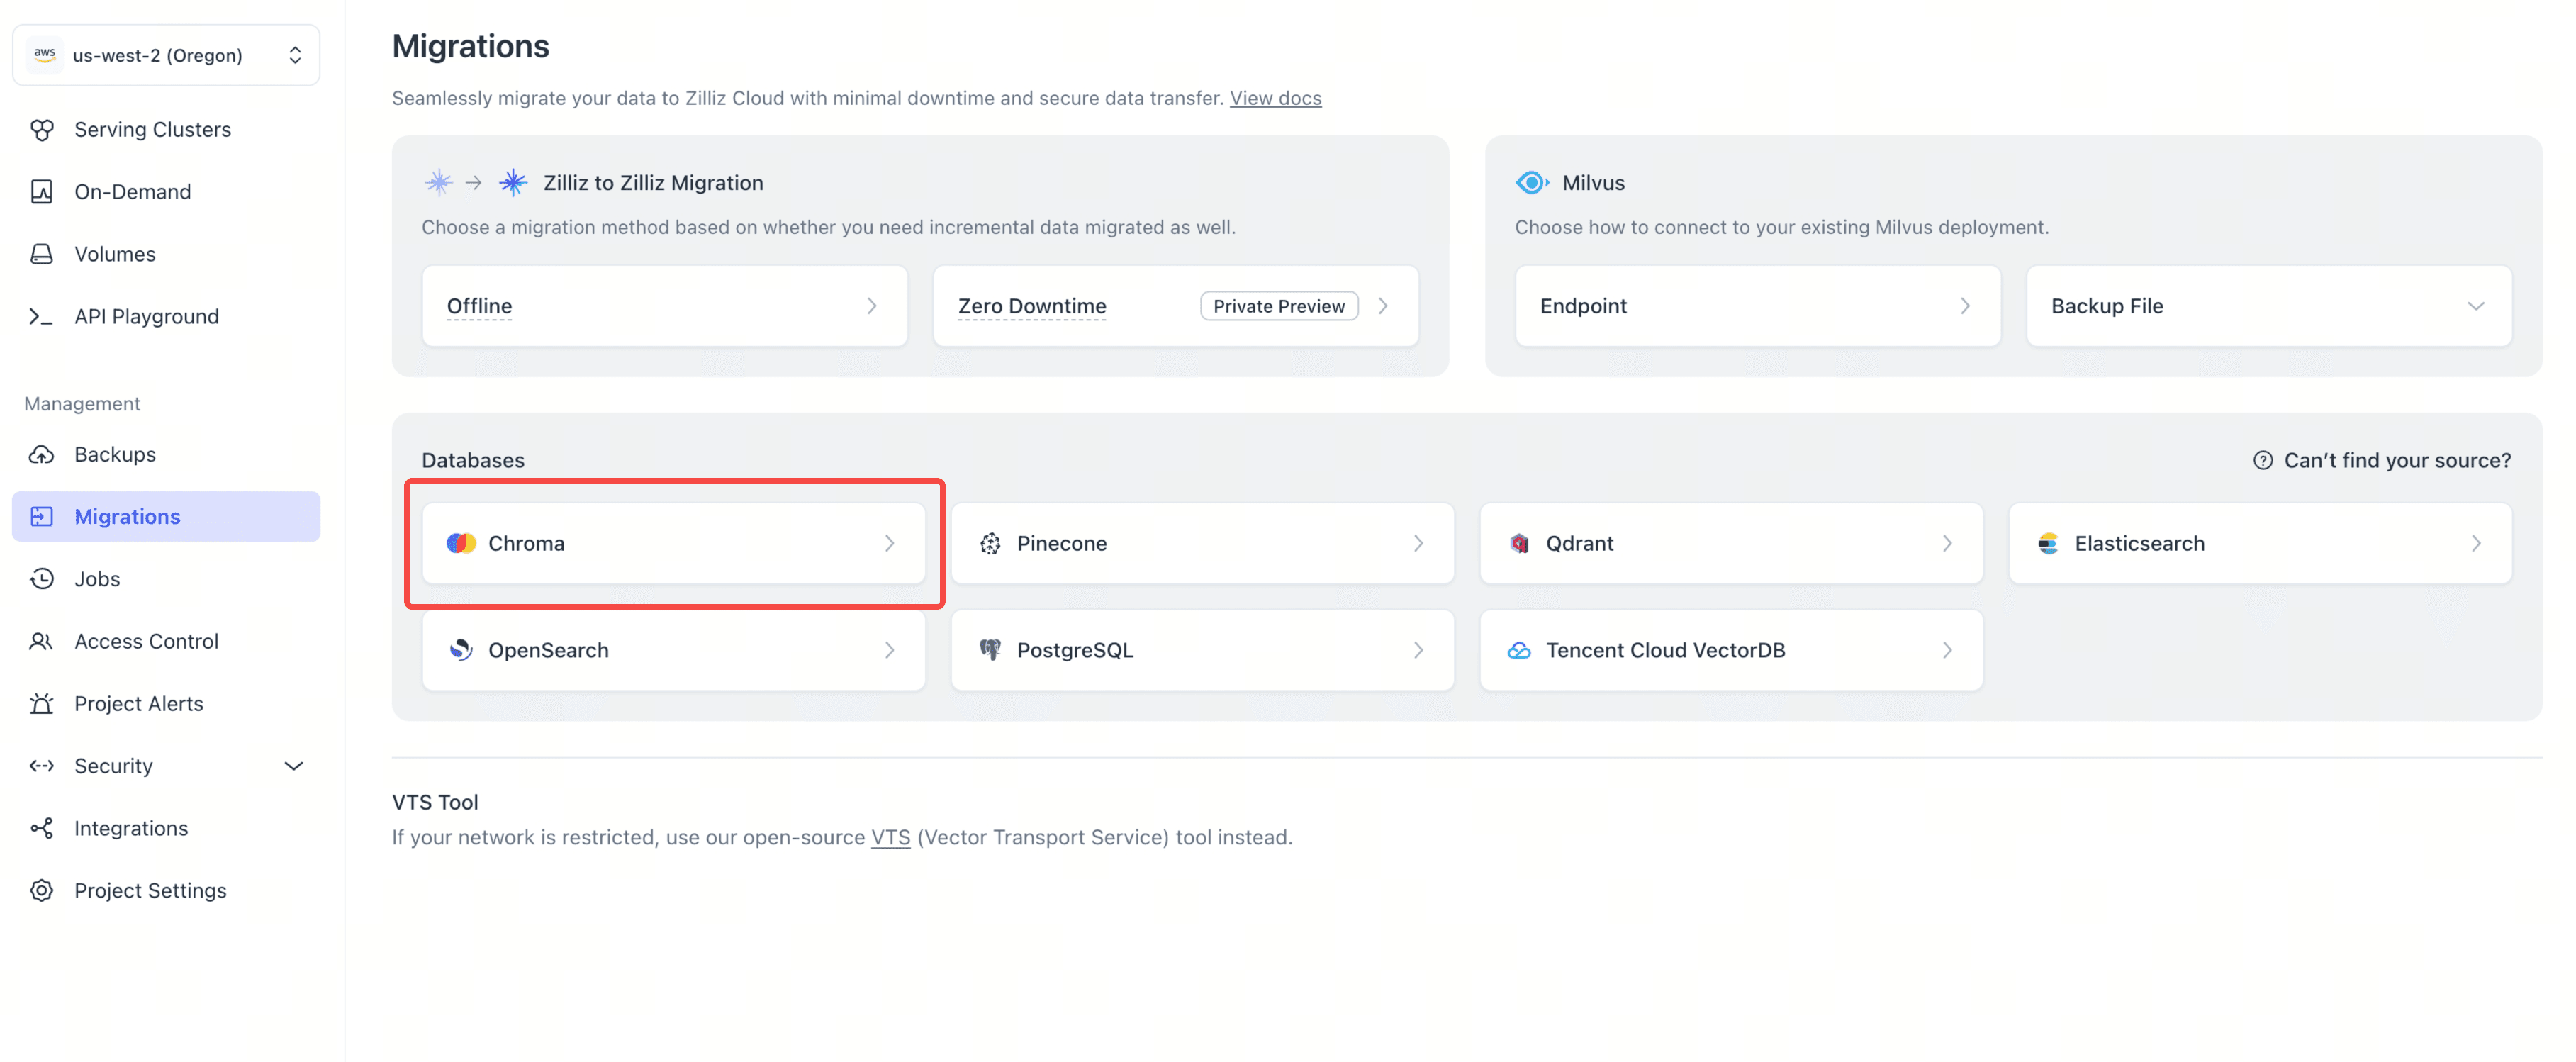
- 선택 및 검토. 이동할 컬렉션을 선택하세요. 각 대상 이름을 확인하고, Zilliz Cloud에서 사용할 수 없거나 이미 사용 중인 이름은 바꾸세요. 필드 매핑을 검토하세요. 메타데이터는 기본적으로 동적 필드로 이동하며, 선택한 키를 여기서 형식화된 필드로 전환할 수 있습니다.
- 인덱스 설정. 마이그레이션 후 인덱스 생성(Create indexes after migration) 을 켜두면 작업이 끝나는 즉시 컬렉션을 검색할 수 있습니다. 각 컬렉션의 메트릭이 Chroma 거리 공간과 일치하도록 설정하세요:
cosine은COSINE,l2는L2,ip는IP. 메트릭은 Chroma에서 복사되지 않습니다. 인덱스 설정을 참조하세요. - 실행. 작업을 시작하고 Jobs 페이지에서 진행 상황을 확인하세요. 완료되면 작업에서 검증된 행 수가 보고됩니다.
모든 필드와 옵션은 Zilliz Cloud 문서의 Chroma에서 Zilliz Cloud로 마이그레이션에 설명되어 있습니다. 그런 다음 2단계로 진행하세요.
옵션 B: 벡터 전송 서비스
벡터 전송 서비스(VTS)는 Zilliz의 오픈소스 마이그레이션 도구이자 마이그레이션 서비스가 실행되는 엔진입니다. Docker에서 구성 파일을 사용하여 직접 실행합니다. 이 서비스는 Chroma의 v2 REST API를 통해 데이터를 읽으며, 버전 0.6 이상의 모든 Chroma 서버가 이 API를 제공합니다.
애플리케이션에 Chroma가 내장되어 있고 chromadb.PersistentClient를 통해 데이터가 로컬 디렉터리에 있다면, VTS가 읽을 서버가 아직 없는 상태입니다. 해당 디렉터리에서 서버를 시작하세요:
chroma run --path ./chroma_data --port 8000
그런 다음 작업 구성을 작성하세요. 이 내용을 migration.conf로 저장하고 각 $ 플레이스홀더를 실제 값으로 바꾸세요. 이들은 환경 변수가 아니며 자동으로 확장되지 않습니다.
hocon
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  ChromaDB {
    url = "$CHROMA_URL"                  # e.g. http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # e.g. ["support-docs"]

    # If your Chroma requires auth, see the table below
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"

    id_split_size = 300
    batch_size = 300
  }
}

sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"                 # must already exist
    batch_size = 50
    enable_dynamic_field = true          # required, this is where metadata goes
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
이 구성에는 자격 증명이 포함되어 있으므로 chmod 600 migration.conf로 권한을 제한하세요.
| 파라미터 | 입력 내용 |
|---|---|
url (소스) | VTS가 덧붙이는 /api/v2를 포함하지 않는 Chroma 서버 루트입니다. VTS는 컨테이너에서 실행되며, 여기서 localhost는 컨테이너 자체를 의미합니다. Chroma가 같은 머신에서 실행 중인 경우 macOS와 Windows에서는 http://host.docker.internal:8000을 사용하고, Linux에서는 docker run에 --network host를 추가한 뒤 localhost를 유지하세요. Chroma Cloud의 경우 https://api.trychroma.com 또는 해당 리전의 엔드포인트를 사용하세요. |
tenant 및 database | 직접 생성하지 않았다면 default_tenant와 default_database입니다. Chroma Cloud에서는 테넌트 ID와 데이터베이스 이름입니다. |
auth_type 및 token | 서버가 인증 없이 실행된다면 둘 다 생략하세요. 그렇지 않으면 token과 함께 X_CHROMA_TOKEN 또는 BEARER를 사용하거나, username과 password와 함께 BASIC을 사용하세요. Chroma Cloud는 API 키와 함께 X_CHROMA_TOKEN을 사용합니다. |
id_split_size 및 batch_size | 둘 다 300이면 어디서나 작동하며, Chroma Cloud에서는 둘 다 300 이하로 유지해야 합니다. 대규모 자체 호스팅 컬렉션의 경우 10000000과 1000을 사용하면 ID를 대량으로 스캔한 다음 ID로 레코드를 가져와 느린 딥 페이징을 피할 수 있습니다. |
collection_rename (싱크) | 선택 사항이며 { "source" = "target" } 형식입니다. -가 _로 바뀐 후에도 유효한 Zilliz Cloud 이름이 되지 않는 모든 소스 이름에 필요합니다. |
선택한 메타데이터 키를 타입이 있는 필드로 변환하려면 싱크에 field_schema 블록을 추가하세요. Milvus 싱크 가이드에서 field_schema와 collection_rename을 다루고, ChromaDB 소스 가이드에서 배치 크기, 인증 및 기타 소스 옵션을 다룹니다.
작업 실행:
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
로그가 end with state FINISHED로 끝나고, Total Read Count가 Total Write Count와 같으며 Total Failed Count가 0이면 작업이 성공한 것입니다.
작업은 추가(append) 방식이므로 같은 컬렉션에 다시 실행하지 마세요. 두 번째 실행은 모든 레코드를 다시 작성합니다. 작업이 중간에 실패하거나 새 복사본이 필요한 경우 먼저 대상 컬렉션을 삭제하거나 collection_rename을 사용하여 새 컬렉션으로 작업을 보내세요.
인덱스를 구축하세요. 해당 컬렉션에 대해 기록해 둔 거리 공간을 사용하세요:
from pymilvus import MilvusClient
client = MilvusClient( uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY", )
index_params = client.prepare_index_params() index_params.add_index( field_name="embedding", index_type="AUTOINDEX", metric_type="COSINE", # cosine -> COSINE, l2 -> L2, ip -> IP ) client.create_index(collection_name="support_docs", index_params=index_params) client.load_collection("support_docs")
### 오픈소스 Milvus로 Chroma 마이그레이션

이 가이드의 모든 내용은 오픈소스 Milvus 2.5 이상에서 작동합니다. 도달 가능한 모든 Milvus에 쓰는 옵션 B를 사용하세요. 싱크의 `url`을 Milvus 주소로 설정합니다(예: Milvus가 같은 머신에서 실행 중일 때 `http://host.docker.internal:19530`). `token`은 `username:password`로 설정하고, 인증이 꺼져 있으면 `token` 줄을 삭제하세요. 2~4단계는 동일하며, 애플리케이션에서 `uri`와 `token`만 변경하면 됩니다. Milvus와 Zilliz Cloud는 하나의 API를 공유하므로 나중에 코드를 수정하지 않고도 둘 사이를 이동할 수 있습니다.

## 2단계: 데이터 확인

먼저 레코드 수를 비교하세요. 마이그레이션 서비스는 검증된 행 수를 보고합니다. VTS의 경우 로그의 `Total Write Count`입니다. 둘 다 Chroma의 카운트와 일치해야 합니다.

카운트는 모든 레코드가 도착했음을 알려줍니다. 그러나 인덱스가 Chroma처럼 쿼리에 응답하는지 여부는 알려주지 않습니다. 잘못된 메트릭으로 구축된 인덱스는 카운트 검사를 통과하면서도 잘못된 이웃을 반환합니다. 따라서 양쪽에서 몇 가지 검색을 실행하고 비교하십시오.

```python
import chromadb
from pymilvus import MilvusClient

chroma = chromadb.CloudClient(api_key="YOUR_CHROMA_API_KEY", tenant="YOUR_TENANT_ID", database="YOUR_DATABASE_NAME")
# Self-hosted Chroma: chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY")

source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(query_embeddings=[vector], n_results=10, include=[])["ids"][0]
    hits = milvus.search("support_docs", data=[vector.tolist()], limit=10)[0]
    overlaps.append(len(set(expected) & {hit["id"] for hit in hits}) / len(expected))
print(f"top-10 overlap: {sum(overlaps) / len(overlaps):.0%}")
이 검색은 20개의 레코드를 쿼리로 사용하고 상위 10개 결과 중 몇 개가 일치하는지 계산합니다. 두 시스템 모두 근사 인덱스를 사용하므로 100%보다 약간 낮은 수치가 정상입니다. 훨씬 낮은 수치는 거의 항상 인덱스 메트릭이 컬렉션의 거리 공간과 일치하지 않는다는 의미입니다.
어느 검사도 레코드 내부를 살펴보지 않습니다. 최종 복사본이 라이브로 전환되기 전에 그것들도 비교하세요. 모든 ID가 건너갔는지 확인한 다음 벡터, 문서, URI, 메타데이터를 비교하세요. 작은 컬렉션에서는 모든 레코드를 비교하고, 큰 컬렉션에서는 무작위 샘플을 비교하세요.
복사하는 동안 애플리케이션이 Chroma에 계속 쓰고 있었다면 카운트가 다를 수 있습니다. 첫 번째 패스에서는 괜찮지만, 전환 시 최종 복사본에서는 일치해야 합니다.
3단계: 애플리케이션 업데이트
대부분의 호출은 일대일로 변환됩니다. 두 가지에 주의해야 합니다. 애플리케이션이 이제 쿼리 임베딩을 직접 생성하며, cosine 및 ip 컬렉션의 점수는 반대로 동작합니다.
Zilliz Cloud에 연결:
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
오픈소스 Milvus의 경우 uri를 Milvus 주소로, token을 username:password로 설정하거나 인증이 꺼져 있으면 token을 생략하세요. 아래의 모든 내용은 동일합니다.
이전과 동일한 모델로 쿼리를 임베딩하세요. Chroma에 query_texts를 전달하면 Chroma가 컬렉션의 임베딩 함수를 실행해 주었습니다. 마이그레이션된 컬렉션에는 해당 함수가 없으므로 코드에서 동일한 모델을 호출하세요. Chroma가 텍스트를 임베딩하도록 두고 임베딩 함수를 설정하지 않았다면 기본 모델인 all-MiniLM-L6-v2를 사용한 것입니다. chromadb 패키지는 여전히 이를 로컬에서 실행할 수 있습니다:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction()
query_vector = embed(["How do I get a refund?"])[0].tolist()
OpenAI 또는 다른 제공업체를 사용했다면 동일한 모델을 동일한 설정으로 호출하세요.
필터로 검색하기. 이전에는 Chroma에서:
results = collection.query(
    query_embeddings=[query_vector],
    n_results=5,
    where={"category": "billing"},
    where_document={"$contains": "refund"},
)
이후에는 Zilliz Cloud에서:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
각 검색 결과는 id, distance, 그리고 entity 아래에 요청한 필드들을 담은 dict입니다. Chroma의 where 및 where_document 필터는 하나의 필터 표현식이 됩니다:
| Chroma | Zilliz Cloud |
|---|---|
{"category": "billing"} | category == "billing" |
{"category": {"$ne": "billing"}} | category != "billing" |
{"year": {"$gte": 2023}} ($gt, $lt, $lte도 포함) | year >= 2023 (>, <, <=도 포함) |
{"category": {"$in": ["billing", "account"]}} | category in ["billing", "account"] |
{"category": {"$nin": ["billing", "account"]}} | category not in ["billing", "account"] |
{"$and": [...]} 및 {"$or": [...]} | ... and ... 및 ... or ... |
{"is_public": True} | is_public == true |
{"tags": {"$contains": "faq"}} (배열 메타데이터) | array_contains(tags, "faq") |
where_document={"$contains": "refund"} | document like "%refund%" |
where_document={"$not_contains": "refund"} | not (document like "%refund%") |
점수는 반대로 읽습니다. Chroma는 거리를 반환하며, 값이 낮을수록 더 유사함을 의미합니다. COSINE과 IP의 경우 Zilliz Cloud는 유사도 점수를 반환하며, 값이 높을수록 더 유사함을 의미합니다. 순위는 바뀌지 않지만, 코드의 임계값은 달라집니다. 테스트에서 위 검색의 최상위 결과는 Chroma 거리 0.0545, Zilliz Cloud 점수 0.9455였습니다.
| Chroma 공간 | Chroma 반환값 | Zilliz Cloud 반환값 | distance < 0.3 같은 임계값은 이렇게 바뀝니다 |
|---|---|---|---|
cosine | 1 − 코사인 유사도 | 코사인 유사도 | score > 0.7 |
ip | 1 − 내적 | 내적 | score > 0.7 |
l2 | 제곱 L2 거리 | 제곱 L2 거리 | 변경 없음 |
레코드 쓰기 및 삭제. 메타데이터 키는 각 행에서 다른 필드 옆에 위치하므로 별도의 metadatas 인수가 없습니다. add와 upsert는 모두 upsert(새 ID의 경우 insert)에 매핑되며, delete는 ID 또는 필터를 기준으로 작동합니다:
client.upsert(
    collection_name="support_docs",
    data=[{"id": "doc-1001", "embedding": vector, "document": "How to change your billing address", "category": "billing"}],
)
client.delete(collection_name="support_docs", ids=["doc-1001"])
client.delete(collection_name="support_docs", filter='category == "archived"')
여기서 vector는 컬렉션의 나머지 부분과 동일한 모델에서 얻은 임베딩입니다. uri는 생략해도 됩니다. null 허용 값입니다.
LangChain을 사용하나요? 벡터 스토어 클래스를 교체하고 마이그레이션된 필드 이름을 가리키세요. 이전:
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, filter={"category": "billing"})
이후, pip install langchain-milvus 사용:
from langchain_milvus import Milvus
vector_store = Milvus(
    embedding_function=embeddings,
    collection_name="support_docs",
    connection_args={"uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT", "token": "YOUR_ZILLIZ_CLOUD_API_KEY"},
    primary_field="id",
    text_field="document",
    vector_field="embedding",
    enable_dynamic_field=True,
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, expr='category == "billing"')
embeddings는 Chroma에서 사용한 것과 동일한 LangChain 임베딩 객체이며, 필터는 filter={...}에서 expr="..."로 바뀝니다. LlamaIndex 사용자도 동일한 방법으로 Milvus 벡터 스토어로 전환할 수 있습니다.
4단계: 전환
- 데이터를 복사하고 확인한 후, 애플리케이션의 스테이징 빌드를 Zilliz Cloud에 연결하세요.
- Chroma에 대한 쓰기를 일시 중지하세요. 11월 22일 이후에는 Chroma Cloud가 어차피 쓰기를 차단합니다.
- 다시 복사하여 일시 중지 시점까지의 모든 쓰기를 확보하고, 이제 개수가 정확히 일치하는지 확인하세요. 시작하기 전에 첫 번째 복사본을 삭제하거나, 새 복사본을 다른 데이터베이스로 보내세요.
- 애플리케이션을 Zilliz Cloud에 배포하세요.
- Chroma Cloud에서 12월 22일 이전에 자격 증명을 제거하거나 교체하세요. Chroma의 서비스 종료 공지가 요청하는 대로입니다.
11월 22일 이후에 이 글을 읽고 있나요? Chroma Cloud 데이터는 이미 읽기 전용이므로 2단계를 건너뛰고 한 번만 복사하세요. 12월 22일까지 여전히 복사할 수 있습니다.
자체 호스팅 Chroma에는 기한이 없지만, 복사 → 쓰기 일시 중지 → 다시 복사 → 전환 순서를 지키세요. 이후에도 Chroma 서버를 한동안 유지하세요. 애플리케이션이 Zilliz Cloud에 새로운 데이터를 쓰기 전까지는 롤백이 구성 변경에 불과합니다.
다음 단계
- 대규모 또는 프로덕션 워크로드를 옮기시나요? 전환 계획에 대해 지원팀에 문의하세요.
- 먼저 옵션을 비교하고 싶으신가요? Chroma vs. Zilliz Cloud에서 기능, 규모, Chroma Cloud에서 매핑되는 항목을 확인할 수 있습니다.
- Chroma Cloud에서 하이브리드 검색을 사용하셨나요? Zilliz Cloud의 하이브리드 검색은 하나의 요청에서 밀집 벡터와 BM25 또는 기타 희소 벡터를 결합합니다.
- 다른 데이터베이스도 옮기시나요? 동일한 마이그레이션 서비스가 Pinecone, Qdrant, Elasticsearch, OpenSearch, PostgreSQL을 처리합니다.
 Fendy Feng
 is the Product Marketing Manager at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Sebastian Huang
Staff Software Engineer at Zilliz
 Shawn He
Senior Software Engineer at Zilliz
계속 읽기
A Developer's Guide to Exploring Milvus 2.6 Features on Zilliz Cloud
Milvus 2.6 marks a shift from “vector search + glue code” to a more advanced retrieval engine, and it is now Generally Available (GA) on Zilliz Cloud (a managed Milvus service).
Smarter Autoscaling in Zilliz Cloud: Always Optimized for Every Workload
With the latest upgrade, Zilliz Cloud introduces smarter autoscaling—a fully automated, more streamlined, elastic resource management system.
Milvus WebUI: A Visual Management Tool for Your Vector Database
Explore Milvus WebUI to monitor, manage, and optimize your vector database with real-time insights, performance tracking, and system health monitoring.