Iniziare con una connessione Milvus
Milvus è un database vettoriale open-source per creare applicazioni di IA con embeddings di dati non strutturati. Include già integrato tutto ciò di cui hai bisogno per iniziare e viene eseguito sulla tua macchina locale o ospitato in Zilliz Cloud (vedi notebook connect to Zilliz Free Tier).
Milvus ha quattro SDK: Java, Python, React, e Ruby. Di seguito, mostreremo i passaggi per Python.
Installa e avvia un server Milvus
pip install milvus pymilvus #pymilvus is the python sdk

from milvus import default_server
default_server.start()
Nota: se ti connetti a Zilliz, puoi saltare l’installazione di Milvus e avviare invece il cluster dalla console.
Ottieni il client Milvus (connessione)
from pymilvus import connections

connections.connect(
   host=’127.0.0.1’,
   port=default_server.listen_port)
Nota: per connetterti a Milvus serverless in esecuzione su Zilliz Cloud invece che su localhost, devi ottenere l’uri dell’endpoint e il token dalla console.
from pymilvus import connections

ENDPOINT=”https://endpoint.api.region.zillizcloud.com:443”
connections.connect(
   uri=ENDPOINT,
   token=TOKEN)
Crea una collection
Puoi pensare a una collection come a una tabella di database. È dove memorizzerai i tuoi embeddings, documenti e qualsiasi metadata aggiuntivo.
Associati a una collection ci sono uno schema e un indice.
L’indice è costruito usando un algoritmo di ricerca vettoriale e una metrica di similarità vettoriale. Puoi usare le impostazioni predefinite di Milvus. Tuttavia, per prestazioni ottimali, dovresti configurare i parametri. La scelta dell’indice di ricerca e dei parametri dipende dai tuoi dati. Consulta questa guida alle best practice per scegliere un indice di ricerca. Questo notebook mostra come modificare i parametri.
from pymilvus import (
   FieldSchema, DataType,
   CollectionSchema, Collection)

## 1. Define a minimum expandable schema.
fields = [
   FieldSchema(“pk”, DataType.INT64, is_primary=True, auto_id=True),
   FieldSchema(“vector”, DataType.FLOAT_VECTOR, dim=768),
]
schema = CollectionSchema(
   fields,
   enable_dynamic_field=True,
)

## 2. Create a collection.
mc = Collection(“my_collection_name”, schema)

## 3. Index the collection.
mc.create_index(
   field_name=”vector”,
   index_params={
       “Index_type”: “AUTOINDEX”,
       “Metric_type”: “COSINE”,
       }
Inserisci dati in Milvus
Se hai già generato embeddings dai tuoi dati non strutturati, puoi caricarli.
I dati di input possono essere sotto forma di dataframe pandas o di un elenco di dizionari. Devono contenere un embedding vettoriale. I campi rimanenti sono opzionali: frammento di testo originale e campi di metadata.
from pymilvus import connections

## 1. Input data can be pandas dataframe or list of dicts.
data_rows = []
data_rows.extend([
   {“vector”: np.random.randn(768).tolist(),
    “text”: “This is a document”,
    “source”: “source_url_1”},
   {“vector”: np.random.randn(768).tolist(),
    “text”: “This is another document”,
    “source”: “source_url_2”},
])

## 2. Insert data into milvus.
mc.insert(data_rows)
mc.flush()
Esegui query sulla collection
Le domande devono essere trasformate in embedding usando lo stesso modello utilizzato per creare gli embedding dei dati non strutturati caricati nel database. Puoi interrogare la collection usando gli embedding delle domande con i parametri di ricerca predefiniti di Milvus. Le stesse best practice si applicano alla scelta dell’indice di ricerca giusto per prestazioni ottimali.
Di seguito, Milvus restituirà i top_k = 3 risultati più simili. Inoltre, nota che vengono restituiti il frammento di testo originale e i metadati, il che può aiutare con il grounding (basare il testo generato su informazioni fattuali per ridurre le allucinazioni).
## 1. Search for answers to your embedded questions.
mc.load()
results = mc.search(
   data=encoder([“my_question_1”]),
   anns_field=”vector”,
   output_fields-[“text”, “source”], #optional return fields
   limit=3,
   param={}, #no params if using milvus defaults
)

## 2. View the answers.
for n, hits in enumerate(results):
   print(f”{n}th result:”)
   for hit in hits:
      print(hit)
Nel mio prossimo blog, tratterò come creare un chatbot usando LangChain e Milvus. Restate sintonizzati.
Altre risorse per iniziare con Milvus e Zilliz
Continua a leggere
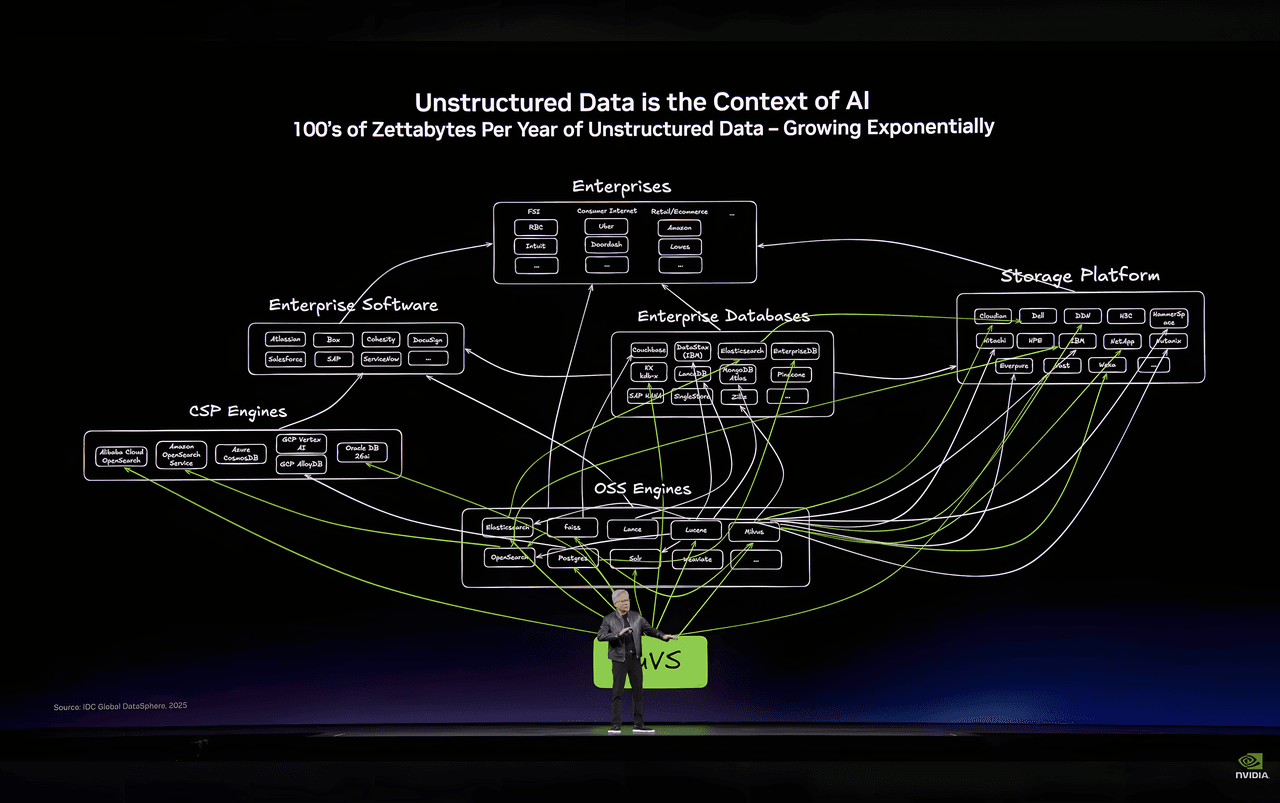
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.
Top 10 Context Engineering Techniques You Should Know for Production RAG
A practical guide to context engineering for production LLM systems, covering RAG, context processing, memory, agents, and multimodal context.
The Great AI Agent Protocol Race: Function Calling vs. MCP vs. A2A
Compare Function Calling, MCP, and A2A protocols for AI agents. Learn which standard best fits your development needs and future-proof your applications.