Comprendiendo el panorama de las bases de datos vectoriales
Para 2025, un increíble 90% de los nuevos datos serán no estructurados: texto, imágenes, audio y videos que no encajan ordenadamente en filas, columnas o modelos predefinidos. Este cambio representa uno de los mayores desafíos en la gestión moderna de datos, pero también crea oportunidades emocionantes para innovar en IA, sistemas de recomendación y búsqueda semántica.
Entran en escena las bases de datos vectoriales: sistemas de vanguardia creados específicamente para almacenar y consultar embeddings vectoriales de alta dimensionalidad. Estos embeddings transforman los datos no estructurados en conocimientos accionables al capturar su significado en forma numérica para permitir cálculos complejos y comparaciones semánticas que hacen posibles los recomendadores de productos, la búsqueda inversa de imágenes, la detección de anomalías y más.
Sin embargo, a medida que el panorama de las bases de datos vectoriales evoluciona rápidamente, las organizaciones se enfrentan a un mercado abarrotado, lleno de afirmaciones contradictorias y opciones confusas. ¿Cómo puedes elegir la solución adecuada para tu caso de uso?
Nuestro nuevo recurso integral, La guía definitiva para elegir una base de datos vectorial, responde a esta pregunta. En su interior, descubrirás:
Por qué las bases de datos vectoriales creadas específicamente superan a los sistemas tradicionales como PostgreSQL y Elasticsearch para manejar datos no estructurados a gran escala.
Cómo los algoritmos de vecino más cercano aproximado (ANN) permiten búsquedas rápidas y escalables, incluso con miles de millones de vectores de alta dimensionalidad.
Las características más importantes para las aplicaciones impulsadas por IA, desde capacidades de búsqueda híbrida y optimización de GPU hasta flexibilidad de esquemas y multitenencia.
Comparaciones de los principales actores del mercado de bases de datos vectoriales, incluidos Milvus, Zilliz, Pinecone y Weaviate, para ayudarte a entender sus fortalezas y compromisos.
Cómo ejecutar benchmarks con tus propios datos entre proveedores usando herramientas de código abierto para evaluar el rendimiento, la escalabilidad y la rentabilidad para tus cargas de trabajo específicas.
Ya sea que estés creando pipelines de generación aumentada por recuperación (RAG) para reducir las alucinaciones de la IA, implementando sistemas de recomendación o mejorando la búsqueda semántica, esta guía te proporciona el conocimiento necesario para tomar una decisión informada.
No dejes que la complejidad del mercado de bases de datos vectoriales te frene. Descarga La guía definitiva para elegir una base de datos vectorial hoy y da el primer paso para aprovechar al máximo tus datos no estructurados.
Sigue leyendo
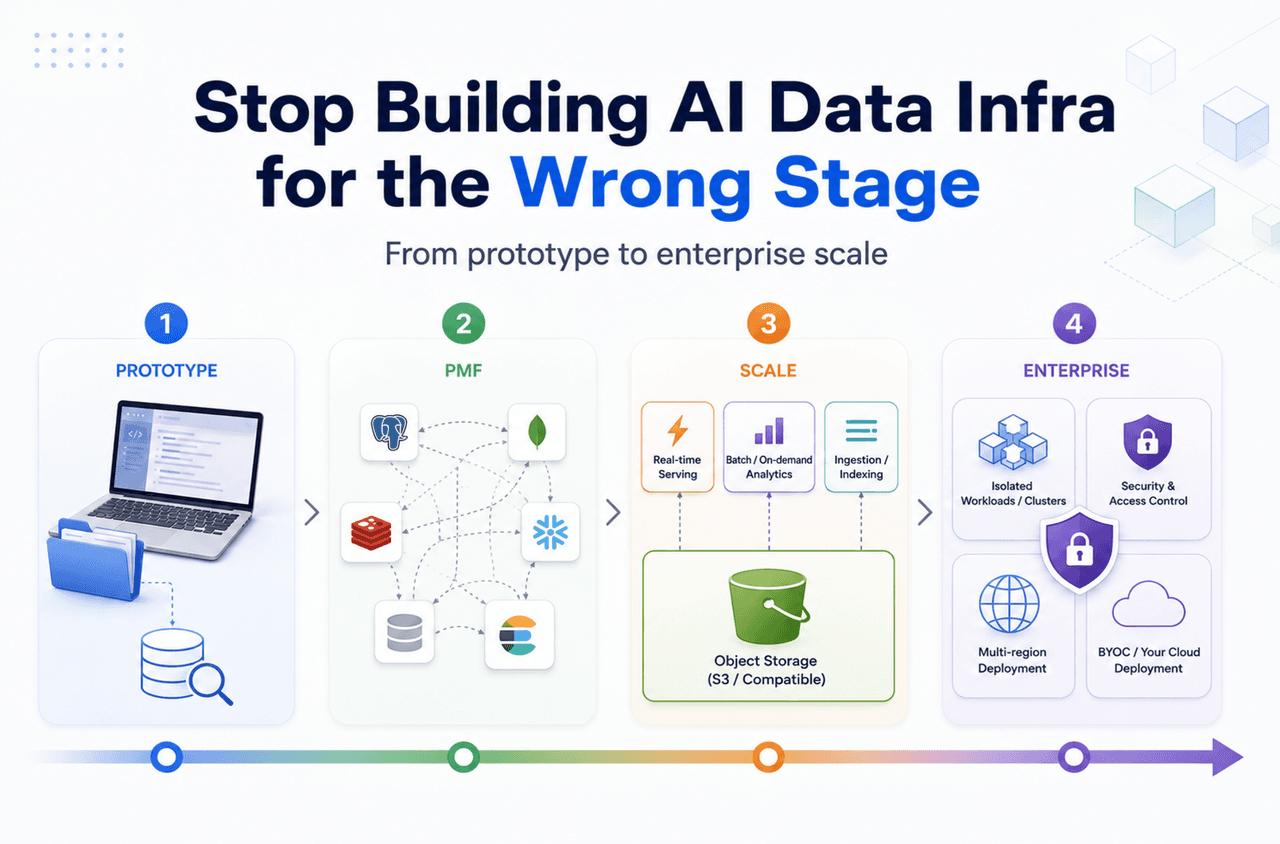
Stop Building AI Data Infra for the Wrong Stage
Learn how AI data infrastructure should evolve from prototype to enterprise scale, and when Vector Lakebase becomes the right architecture for AI apps.

Data Deduplication at Trillion Scale: How to Solve the Biggest Bottleneck of LLM Training
Explore how MinHash LSH and Milvus handle data deduplication at the trillion-scale level, solving key bottlenecks in LLM training for improved AI model performance.
AI Agents Are Quietly Transforming E-Commerce — Here’s How
Discover how AI agents transform e-commerce with autonomous decision-making, enhanced product discovery, and vector search capabilities for today's retailers.