Consensus baut agentische akademische Suche über 400M+ wissenschaftliche Quellen mit Zilliz Cloud auf
400 Mio.+
Wissenschaftliche Quellen durchsuchbar
~45 ms
P99-Dense-Retrieval-Latenz in Produktion
14% höher
Präzision in den Suchergebnissen nach dem Hinzufügen der semantischen Suche
4× größer
Vektoren für nur das 2,5-Fache der Clustergröße, ohne Latenzeinbuße.
1 Tag → 1 Stunde
Vollständige Neuindizierung der gesamten 400M+ Vektor-Sammlung durch täglichen Massenimport
Unsere Aufgabe ist es, die beste Forschung für alle auffindbar zu machen, die Consensus nutzen. Zilliz Cloud bietet unserem Research-Agent schnelle, hochwertige semantische Suche und erweitert damit direkt die Reichweite der Belege, auf die er zugreifen kann.
Christian Salem
Über Consensus
Consensus baut das Betriebssystem für wissenschaftliche Forschung: eine Agentenplattform, die von mehr als 10 Millionen Forschern, Studierenden und Klinikern an über 12.500 Universitäten genutzt wird, um Papiere zu sichten, Evidenz zu synthetisieren und die mühsamen Teile der Forschung zu automatisieren, damit sie sich wieder der echten Wissenschaft widmen können. Consensus hat bisher mehr als 150 Millionen Forschungsfragen bearbeitet und 45 Millionen Dollar eingesammelt, um die nächsten 100 Millionen Forscher weltweit voranzubringen.
 Consensus插图1.png
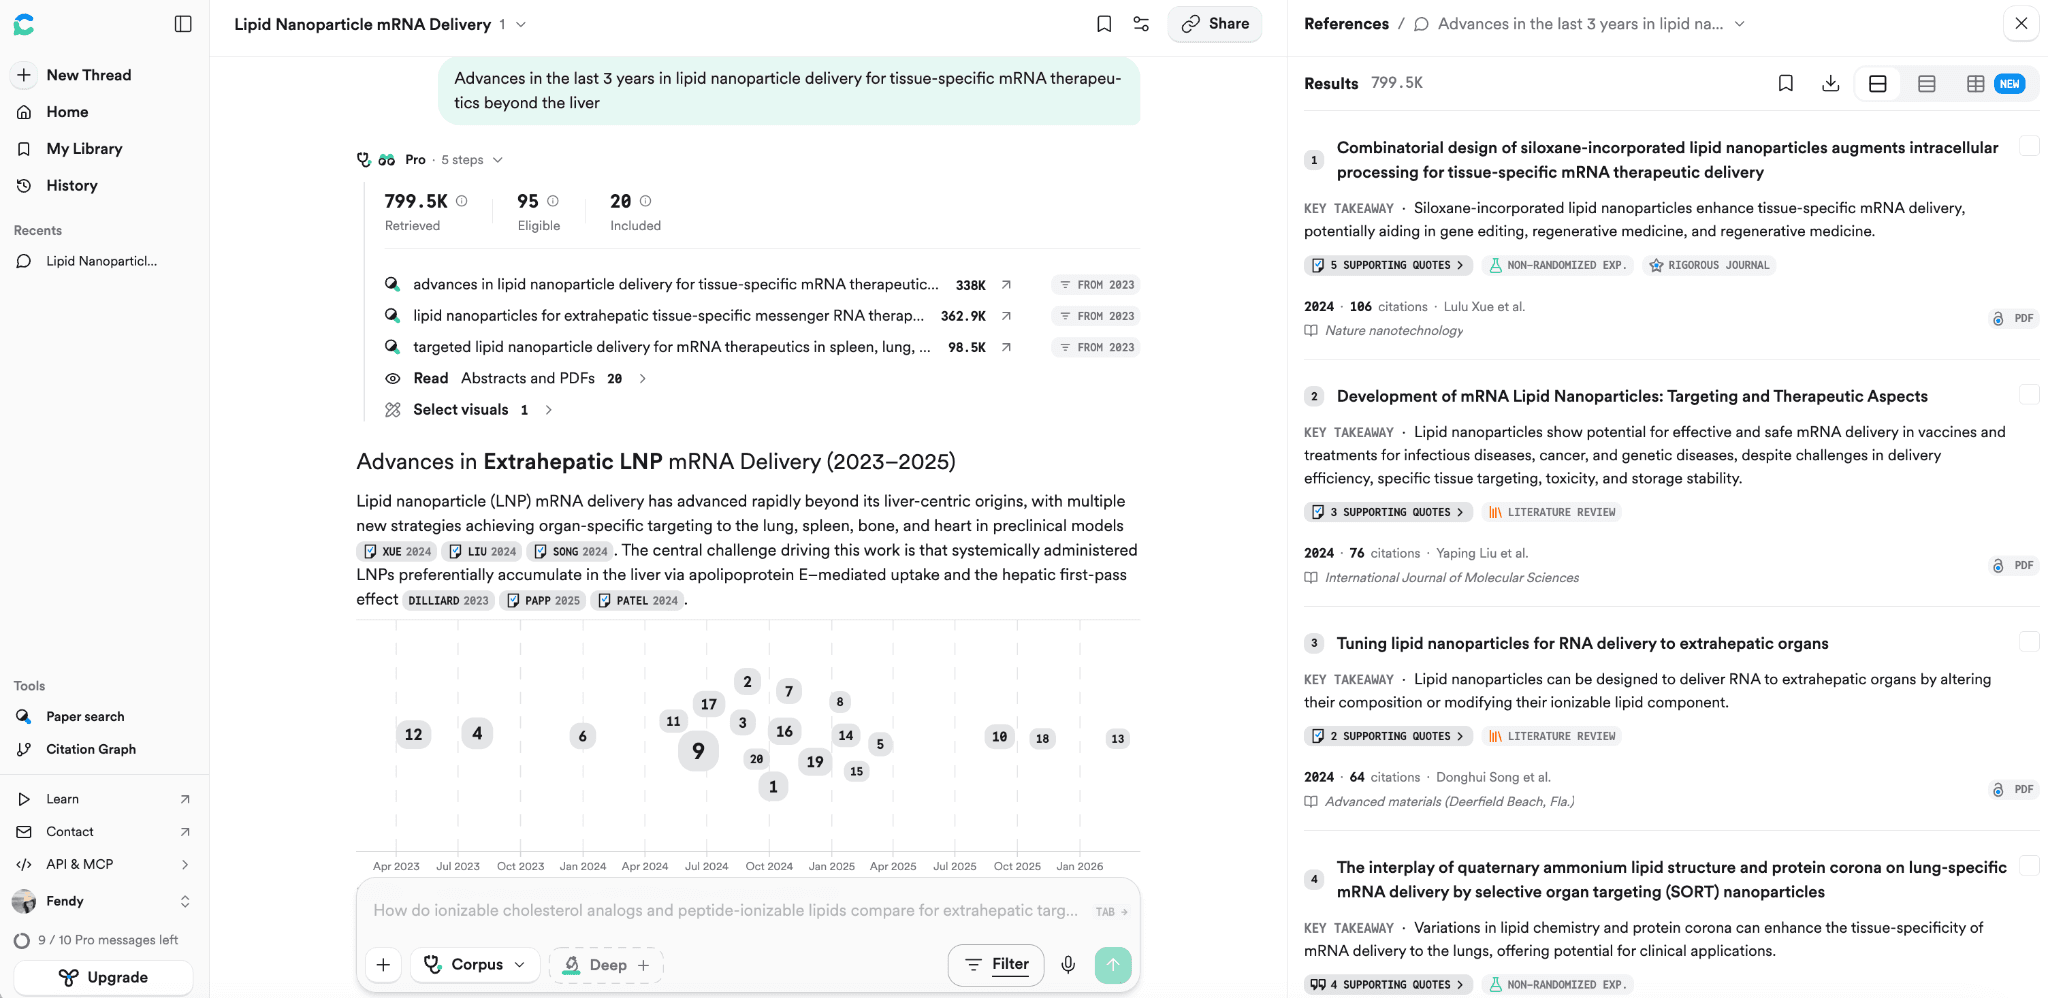
Das Fundament der Plattform ist eine erstklassige agentische Suche über mehr als 400 Millionen wissenschaftliche Quellen. Consensus antwortet niemals aus dem eigenen Wissen des KI-Modells; stattdessen muss jede Behauptung auf ein echtes, abgerufenes Papier zurückgehen, und der Forschungsagent kann das Retrieval viele Male aufrufen, um eine einzige Frage zu beantworten. Das Produkt ist nur so gut wie die Papiere, die es findet, was das Retrieval zum Herzstück von Consensus macht. Zilliz Cloud betreibt eine seiner wichtigsten Komponenten: die semantische Suche, die versteht, was ein Forscher wirklich fragt, und die Forschung liefert, die darauf antwortet.
Die Herausforderung
Die Retrieval-Engine von Consensus betrieb zuvor zwei Retrieval-Methoden: Sparse- und BM25-Keyword-Suche. Sie bewältigten die meisten Anfragen gut. Aber die Messlatte wurde höher gelegt: Consensus verlagerte seine Literaturübersicht auf eine agentische Architektur, bei der eine Frage in viele Retrieval-Aufrufe münden kann, sodass das Retrieval bei jedem Aufruf die richtigen Papiere finden und schnell zurückgeben musste. Keyword- und Sparse-Suche übersehen Papiere, die dasselbe aussagen, aber eine andere Terminologie verwenden. Forscher stoßen ständig darauf, weil das Papier, das eine Frage beantwortet, oft aus einem benachbarten Fachgebiet stammt, das für dieselbe Idee eigene Begriffe verwendet. Die Dense-Vektor-Suche ist der Schlüssel, um diese Lücke zu schließen. Deshalb testete das Team sie zuerst in Elasticsearch und stieß auf drei weitere Probleme.
- Die Retrieval-Qualität fiel bei Hunderten Millionen von Vektoren ab. Um so viele Dense-Vektoren unterzubringen, musste das Team sie mit binärer Quantisierung komprimieren, und die Komprimierung kostete messbare Ranking-Qualität. Für ein Forschungsprodukt ist das der falsche Kompromiss.
- Die Neuindizierung der gesamten Sammlung dauerte mehr als 24 Stunden. Neue Forschung musste einen Tag oder länger warten, bis sie durchsuchbar wurde, und jeder Kandidat für ein Embedding-Modell kostete einen ganzen Tag, um in der Produktion evaluiert zu werden, was die Einführung besserer Modelle durch das Team verlangsamte.
- Größere Vektoren bedeuteten eine viel höhere Speicherrechnung. Bei Hunderten Millionen von Vektoren wird jede Vergrößerung der Vektorgröße oder der Abdeckung über die gesamte Sammlung bezahlt, sodass das Team seine Vektoren kleiner hielt, als es wollte.
Das Team suchte nach einer zweckgebauten Engine für semantisches Retrieval: hohe Ranking-Qualität, schnelle Aktualisierungen der Sammlung, tragbare Kosten im großen Maßstab und eine verwaltete Produktionsumgebung, die es nicht selbst personell besetzen musste.
Warum Zilliz Cloud
Consensus führte einen echten Vergleichstest über vier Optionen durch: Dense-Vektor-Suche in Elasticsearch, die es bereits betrieben hatte; FAISS, eine selbst betriebene Open-Source-Vektorbibliothek, die es prototypisiert hatte; Pinecone; und Zilliz Cloud. Zilliz Cloud gewann aus vier Gründen.
- Bessere Ergebnisse ohne Komprimierung der Vektoren. In den eigenen Tests des Teams lieferte Zilliz Cloud im Hundertmillionenbereich präzisere Retrieval-Ergebnisse bei hoher Trefferquote, ohne die Komprimierung, die zuvor Qualität gekostet hatte.
- Ein vollständiger Neuaufbau der Collection in etwa einer Stunde, statt zuvor mehr als einem Tag. Ein täglicher Massenimport der gesamten Collection verwandelt einen vollständigen Neuaufbau von einem Sonderprojekt in eine nächtliche Aufgabe. Dies ermöglicht auch wesentlich schnellere Iterationen beim Testen neuer Embedding-Modelle.
- Geringere Speicherkosten bei gleichem Traffic und gleicher Vektoranzahl. Die Einsparungen ermöglichten viermal so große Vektoren zu bis zu viermal geringeren Kosten, was zu deutlich höherer Relevanz führte.
- Ein verwalteter Dienst mit einer Entwicklererfahrung, die dem Team gefiel. Consensus erstellte einen Prototyp auf Basis von FAISS und fand ihn technisch leistungsfähig, aber der Produktionsbetrieb hätte bedeutet, Orchestrierungs- und Betriebsaufwand zu übernehmen, den das Team nicht übernehmen wollte. Das Team fand außerdem, dass das Zilliz-Cloud-SDK gut dokumentiert und angenehm zu entwickeln ist, mit einer übersichtlichen Konsole für die täglichen Collection-Operationen.
Die Lösung
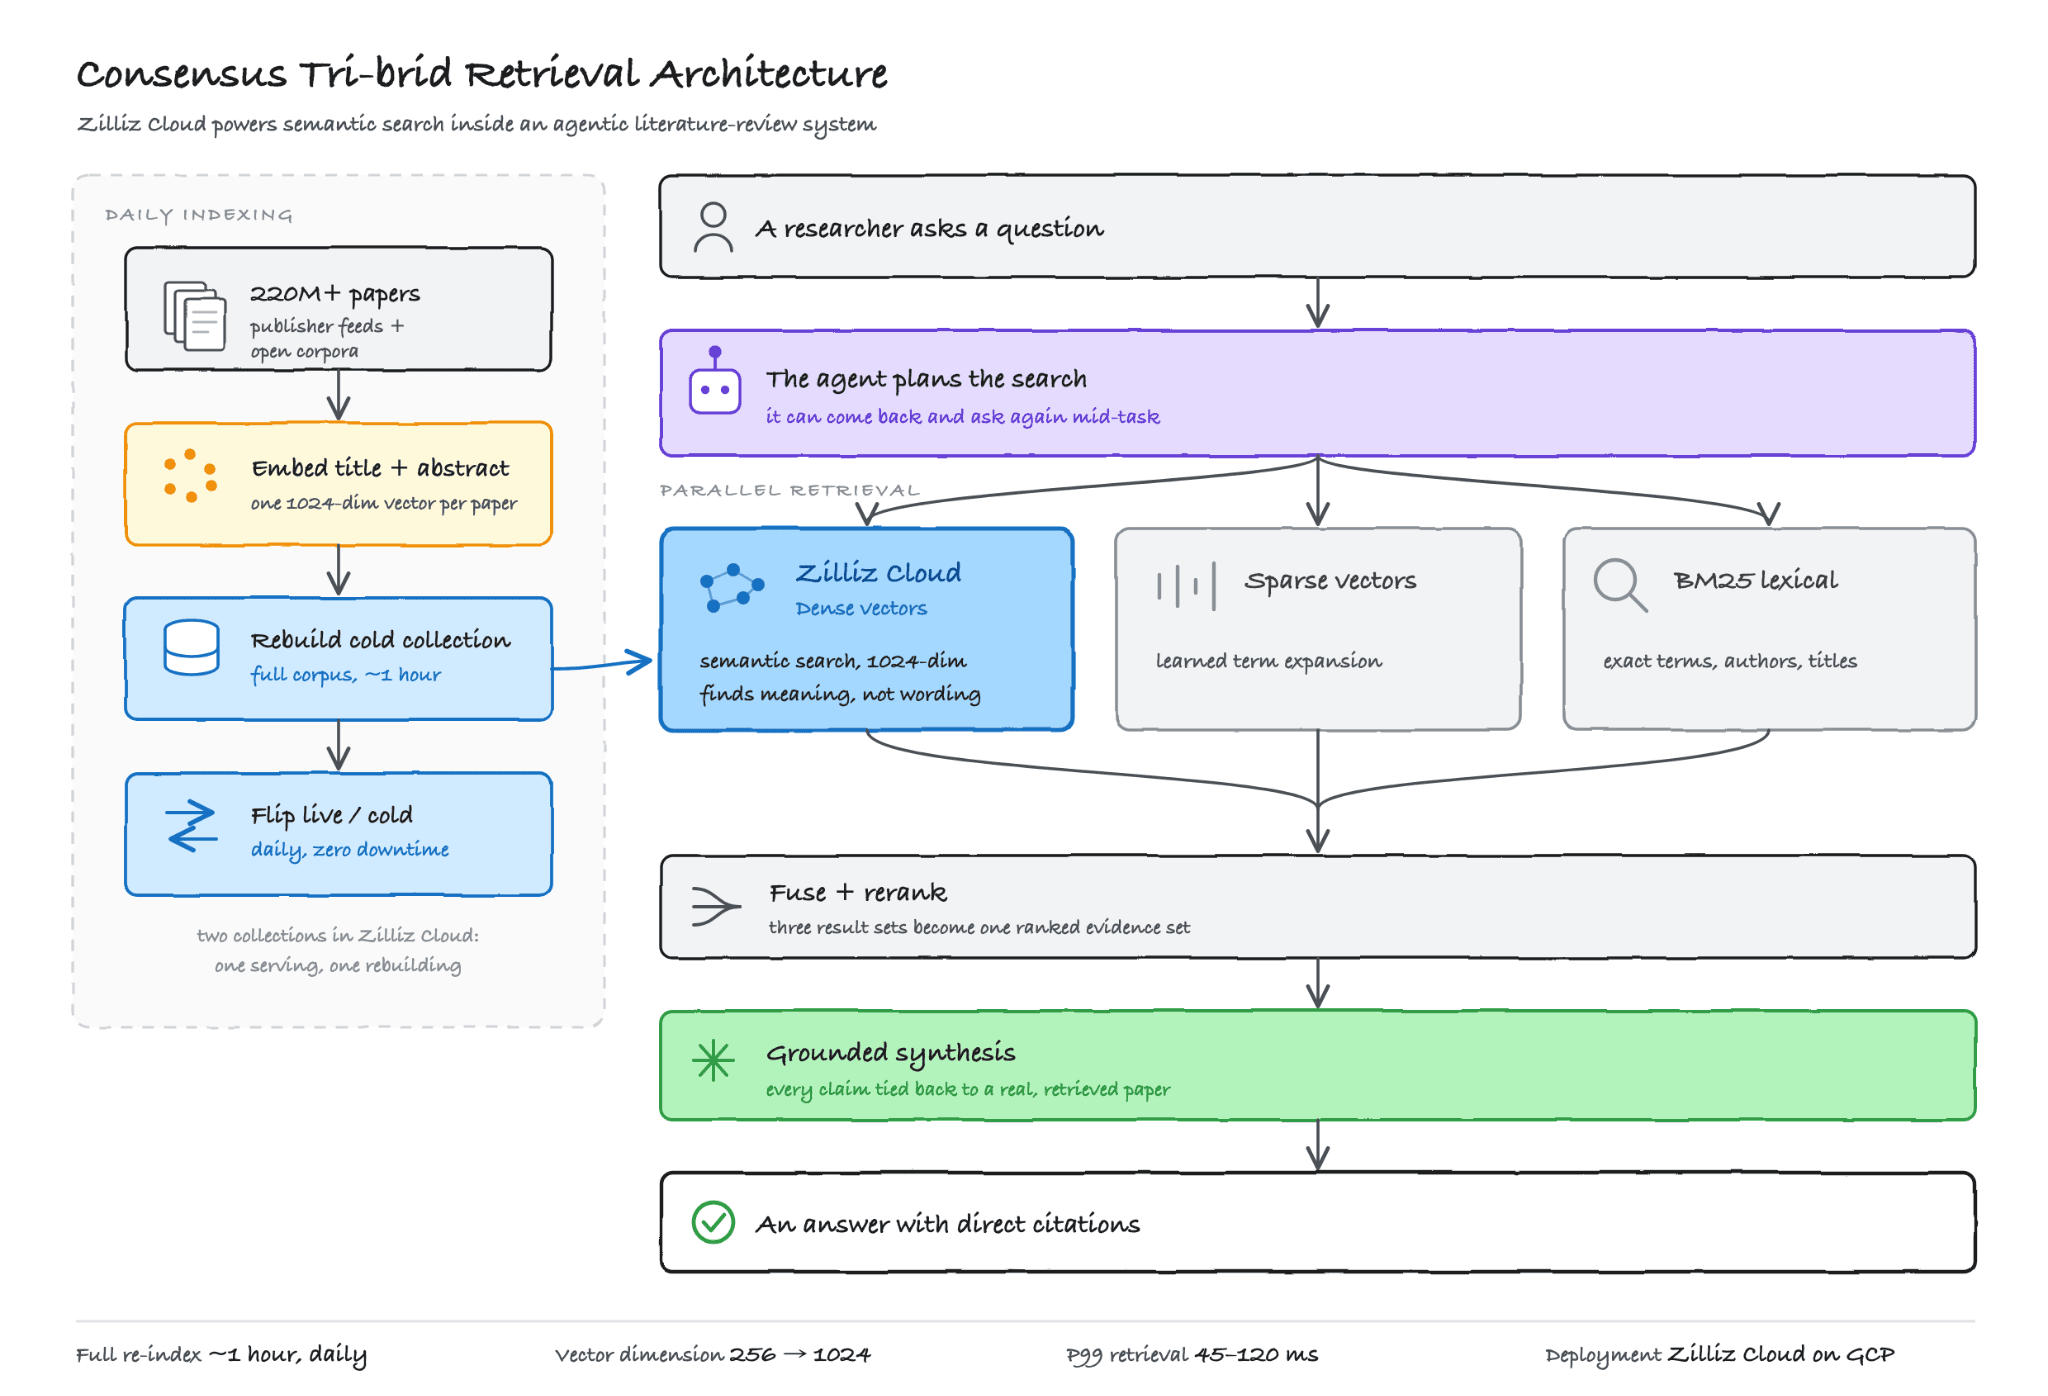
Consensus beantwortet eine Forschungsfrage, indem es die richtigen Paper oder Paper-Ausschnitte abruft und daraus eine Antwort synthetisiert, wobei jede Behauptung auf eine echte Publikation zurückgeführt wird. Drei Retrieval-Pfade laufen parallel, um diese Paper zu finden – eine Architektur, die das Team „tri-brid search“ nennt – und Zilliz Cloud bildet die semantische Suchschicht: Sie gleicht eine Frage mit einem Paper anhand seiner Bedeutung ab, nicht anhand der verwendeten Wörter, und findet so die Paper, die die anderen Pfade übersehen. Zilliz Cloud läuft auf Google Cloud neben dem übrigen Stack.
 Concensus插图2.png
Zur Abfragezeit plant der Agent die Suche und ruft den Abruf als Werkzeug auf. Die Pfade laufen parallel, ihre Ergebnisse werden zu einem einzigen Belegsatz fusioniert und neu bewertet, und das Modell schreibt die Antwort, wobei es jede Behauptung auf ein abgerufenes Paper zurückführt. Das ist die Maschinerie hinter dem Literatur-Review-Agenten und dem Consensus Meter, der die veröffentlichte Evidenz für und gegen eine Behauptung abwägt.
Drei Designentscheidungen machen das möglich.
Ein Paar aus Live- und Cold-Collection in Zilliz Cloud, das jeden Tag von Grund auf neu aufgebaut wird.
Der übliche Weg, einen Index dieser Größe aktuell zu halten, besteht darin, ihn direkt zu aktualisieren: Änderungen erkennen, neue Vektoren schreiben, alte löschen und die Buchhaltung sauber halten. Consensus überspringt all das. Es hält zwei Kopien der Collection in Zilliz Cloud, insgesamt mehr als 400 Millionen Vektoren, eine bedient Abfragen, die andere ist im Leerlauf, und jeden Tag wird die inaktive Kopie per Massenimport von Grund auf neu aufgebaut und live geschaltet.
Das ist nur dann ein sinnvolles Design, wenn ein vollständiger Neuaufbau schnell genug ist, um täglich durchgeführt zu werden, und der Speicher günstig genug ist, um eine zweite Kopie zu halten. Beim bisherigen System traf keines von beidem zu. Bei Zilliz Cloud trifft beides zu: Die gesamte Collection wird in etwa einer Stunde importiert, indexiert und einsatzbereit gemacht, bei geringeren Speicherkosten. Das einfachere Design setzt sich also durch: In die aktive Collection wird nie geschrieben, es gibt keinen Rückstand, der abgeglichen werden müsste, und ein neues Embedding-Modell ist einfach derselbe Neuaufbau mit anderen Vektoren. Das Korpus ist immer auf dem neuesten Stand, sodass Forscher jederzeit Zugriff auf die neuesten Publikationen haben.
„Was das Team mit Zilliz festgestellt hat, ist, dass wir praktisch die gesamte Collection von Grund auf neu einlesen können, so schnell ist es. Wir haben zwei Kopien des Index; wir lesen das Ganze in einer Stunde ein und legen dann den Schalter um. Das können wir inzwischen praktisch täglich tun. Das hat auch die Experimentierfreude enorm gefördert, da keine Hemmung besteht, neue Ideen auszuprobieren.“ — Heath Hohwald, Technischer Leiter und Suchmanager, Consensus
Ein 1.024-dimensionaler Vektor pro wissenschaftlicher Quelle.
Jede Quelle wird aus ihrem Titel und Abstract in einen einzigen Vektor eingebettet. Das Team startete mit 256 Dimensionen und ging davon aus, dass Kosten und Latenz proportional zur Vektorgröße steigen würden. In Zilliz Cloud benötigte die Vervierfachung der Dimension von 256 auf 1.024 ungefähr die 2,5-fache Clustergröße – nicht die 4-fache, die das Team erwartet hatte – und das bei nur sehr geringer zusätzlicher Latenz. Im internen Benchmark des Teams lieferten die 1.024-dimensionalen Embeddings eine um 27 % höhere Qualität der gefundenen Papers im Vergleich zum kleineren Modell, daher führte Consensus 1.024 ein.
Semantische Suche als Werkzeug, das der Agent direkt aufruft.
Zilliz Cloud wird dem Literaturrecherche-Agenten als aufrufbares Werkzeug bereitgestellt, anstatt hinter einem einzelnen Abrufschritt verborgen zu sein. Der Agent kann die Frage umformulieren, aus mehreren Blickwinkeln suchen und nach dem Lesen der Ergebnisse weitere Suchanfragen stellen – eine Aufgabe kann also viele Aufrufe bedeuten. Ein solcher Werkzeugaufruf funktioniert nur, wenn jeder Aufruf schnell und präzise ist, denn eine langsame oder ungenaue Suche wird durch jeden zusätzlichen Aufruf des Agenten vervielfacht. Mit ~45 ms P99 über 400M+ Vektoren hinweg ist die semantische Suche schnell und präzise genug, um sie dem Agenten als Werkzeug zur Verfügung zu stellen, damit er die letzten schwer auffindbaren Papers aufspüren kann, die eine einzelne Abfrage übersehen würde.
Ergebnisse & Vorteile
- Bis zu 4× geringere Speicherkosten, und die Ersparnis floss in eine bessere Suche. Die Speicherung kostet bei gleichem Traffic und gleicher Vektoranzahl weniger und schafft so den Spielraum, den das Team anschließend in Qualität investierte.
- 14 % höhere Präzision der Suchergebnisse nach Einführung der semantischen Suche, gemessen am eigenen internen Benchmark von Consensus. Der Gewinn ist am größten bei Papers, die eine Frage mit Worten beantworten, die der Forscher nie verwendet hat und die der bisherige Stack übersehen hätte.
- P99-Abruf bei ~45 ms über 400M+ Vektoren hinweg, ein Drittel des 150-ms-P90-Ziels, das das Team für Zilliz Cloud festgelegt hatte. Schnell genug, damit der Forschungsagent in einer einzigen Anfrage mehrfach suchen, reflektieren und iterieren kann, anstatt nur einen Versuch zu haben und dabei manchmal kritische Ergebnisse zu verpassen.
- 4x größere Vektordimensionen (256 → 1.024) kosteten in Zilliz Cloud nur das 2,5-fache des Clusters, etwa 40 % weniger als lineare Skalierung, ohne Latenznachteil. Im internen Benchmark von Consensus lieferten die größeren Embeddings eine um 27 % höhere Qualität der gefundenen Papers.
- Ein vollständiger Neuaufbau der gesamten Sammlung: 24+ Stunden → etwa 1 Stunde, als täglicher Bulk-Import. Consensus baut die gesamte Sammlung nun täglich neu auf und ersetzt sie, ohne den Betrieb zu unterbrechen. Neue Forschung ist noch am Tag ihrer Veröffentlichung durchsuchbar.
- Die Iterationsschleife wird schneller. Größere Embeddings, neue Modelle und neue Retrieval-Strategien müssen nicht mehr gegen einen ganztägigen Neuaufbau abgewogen werden, bevor man sehen kann, ob sie helfen.
Was als Nächstes kommt
Jede Richtung, in die sich Consensus bewegt, legt mehr Gewicht auf Zilliz Cloud. Die breitere Verfügbarmachung der semantischen Suche über das agentische Framework bedeutet mehr Abrufaufrufe pro Aufgabe und mehr Traffic gegen die dichte Sammlung. Neue Embedding-Modelle werden weiterhin im täglichen Rhythmus ausgeliefert, den der einstündige Neuaufbau ermöglicht. Metadaten-Filterung, die derzeit in der Anwendungsschicht erfolgt, ist ein Kandidat für die Verlagerung in Zilliz Cloud.
Die größte Chance liegt darin, die Volltextinhalte stärker auszuschöpfen. Consensus verfügt über lizenzierte Volltextinhalte durch seine Verlags-Partnerschaften, und diese Tiefe in Zilliz‘ dichte Sammlung einzubringen, ist ein natürlicher nächster Schritt: Den Hauptteil jedes Papers zu indexieren statt nur dessen Titel und Abstract würde die Sammlung um ein Vielfaches vergrößern und Forschern ein weitaus feineres Matching ermöglichen.
„Consensus tut etwas wirklich Schwieriges: die wissenschaftliche Literatur der Welt nach Bedeutung durchsuchbar zu machen – für einen Agenten, der in einer einzigen Aufgabe denselben Korpus auf ein Dutzend verschiedene Arten befragen kann. Wir sind stolz darauf, dass Zilliz Cloud das Retrieval-Fundament dahinter ist, und wir freuen uns darauf, weiter gemeinsam zu bauen, während agentische Forschung skaliert.“ — James Luan, CTO von Zilliz
Bauen Sie agentische KI mit Zilliz Cloud
Agentische Systeme setzen das Retrieval unter neuen Druck: Eine einzelne Benutzeranfrage kann zu mehreren semantischen Suchen, Neuformulierungen und Durchläufen zur Evidenzgewinnung werden. Ob Sie nun RAG skalieren oder agentische Suche aufbauen – Zilliz Cloud bietet Ihnen dieselbe Retrieval-Grundlage, die auch Consensus antreibt.
Starten Sie kostenlos mit Zilliz Cloud, oder sprechen Sie direkt mit unserem Team.
"Einer der größten Erfolge, die wir gesehen haben, ist die bessere Verarbeitung von Suchanfragen, die semantisch, aber nicht textuell relevant sind. Längere, eher gesprächsartige Suchanfragen haben sich ebenfalls drastisch verbessert."
Heath Hohwald