A Zilliz participou do VLDB Workshop 2021
Quais são os principais avanços no setor de bancos de dados em 2021?
Em agosto, a Zilliz foi convidada para o VLDB Workshop 2021 para compartilhar seus mais recentes progressos e conquistas de pesquisa na aplicação de métodos de machine learning a sistemas de bancos de dados, juntamente com a Harvard University, Carnegie Mellon University, Tsinghua University, Microsoft e muitas outras organizações. O pesquisador sênior da Zilliz, Dr. Xiaomeng Yi, apresentou o contexto de desenvolvimento, as ideias de design, os desafios e as inovações tecnológicas durante o desenvolvimento do Milvus, um banco de dados vetorial de código aberto.
VLDB, SIGMOD e ICDE são conhecidas como as três conferências mais prestigiadas na área de bancos de dados. Recentemente, o resultado de pesquisa da equipe de pesquisa da Zilliz, Milvus: A Purpose Built Vector Data Management System, foi selecionado pela SIGMOD e incluído como um dos 21 artigos deste ano devido à excelente funcionalidade subjacente e à aplicação perfeita em cenários de negócios do Milvus.
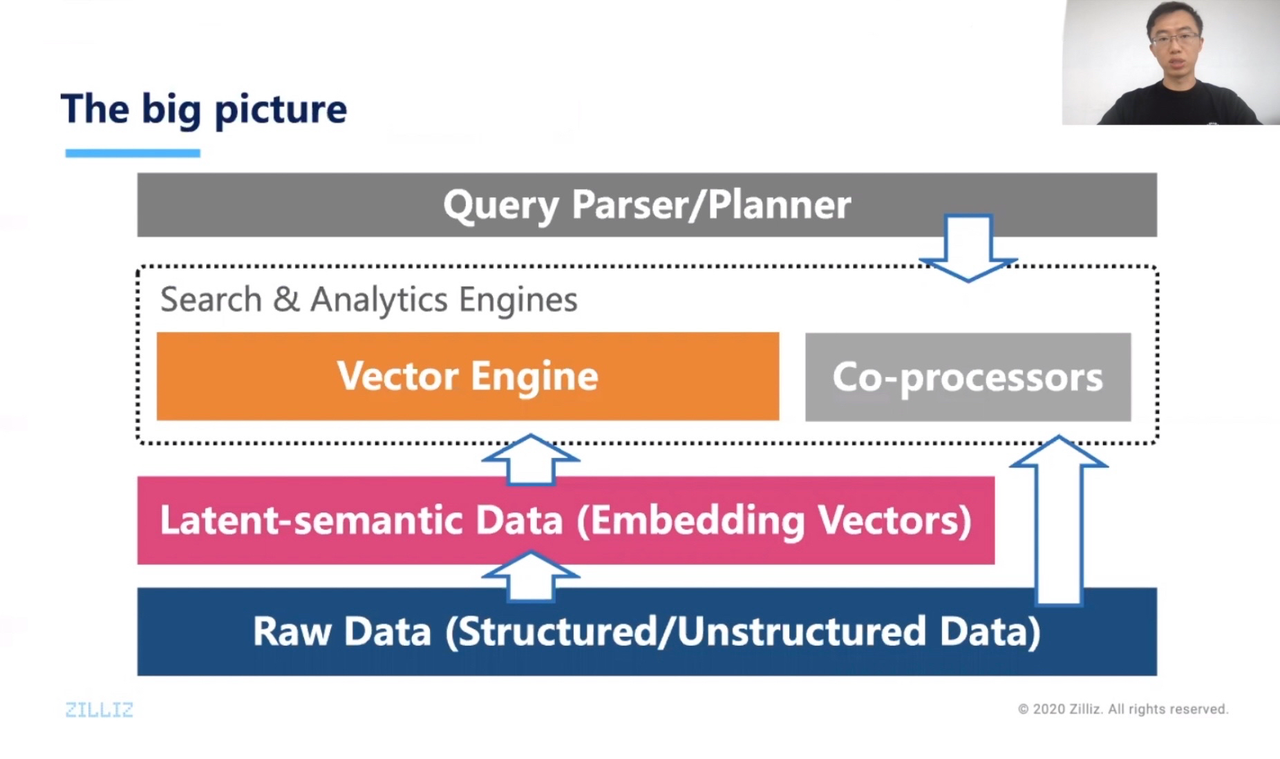
Todos os dias, o mundo produz uma enorme quantidade de dados, dos quais mais de 80% são dados não estruturados difíceis de processar. Enquanto os bancos de dados tradicionais só conseguem armazenar dados estruturados, a equipe de engenharia do Milvus propôs uma hipótese: todos os dados podem ser representados uniformemente por vetores no nível semântico, independentemente dos tipos de dados. O Dr. Yi observou que, se o modelo de rede neural de IA for usado para extrair a semântica dos dados e apresentá-los uniformemente como vetores, a lógica de processamento de muitos dados poderá ser executada diretamente no nível dos vetores.
O Milvus foi projetado especificamente para análise e recuperação de enormes quantidades de vetores de características. Ele fornece uma estrutura completa para atualização, indexação e busca por similaridade de dados vetoriais, que não apenas pode ser realizada em tempo real em dados em streaming, mas também atende aos diversos requisitos de busca em cenários de negócios reais. Até agora, o Milvus lançou duas versões: 1.0 e 2.0. O código-fonte do Milvus é completamente open source no GitHub e tem sido amplamente usado nos campos de fronteira da inteligência artificial. Testado por 1.000 usuários ao redor do mundo, seu desempenho supera amplamente os produtos concorrentes.
 VLDB
No compartilhamento, o Dr. Yi apresentou o conceito de design do Milvus 2.0: cloud-native, log-as-data e processamento unificado em lote e streaming. Com base em seu antecessor, o Milvus 2.0 oferece aos usuários uma experiência de busca inteligente, estável e fluida.
Diante dos dois principais desafios de seleção de índices e ajuste de dados no desenvolvimento de bancos de dados, o Dr. Yi acredita que a IA pode abrir portas para as melhores soluções. Por exemplo, uma nova configuração pode primeiro ser testada e avaliada em um pequeno conjunto de dados e, depois, transferida para um grande conjunto de dados. Use machine learning para analisar o conjunto de dados existente e orientar a configuração do novo conjunto de dados, a fim de alcançar um desempenho melhor do que o do algoritmo BOHB atual.
Dr. Xiaomeng Yi (Ph.D. em Arquitetura de Computadores, Huazhong University of Science and Technology), Pesquisador Sênior e líder da equipe de Pesquisa da Zilliz. Sua pesquisa concentra-se em gerenciamento de dados de alta dimensão, recuperação de informações em larga escala e alocação de recursos em sistemas distribuídos. Os trabalhos de pesquisa do Dr. Yi foram publicados em periódicos de destaque e conferências internacionais, incluindo IEEE Network Magazine, IEEE/ACM TON, ACM SIGMOD, IEEE ICDCS e ACM TOMPECS.
Continue lendo
Zilliz Cloud BYOC Now Available Across AWS, GCP, and Azure
Zilliz Cloud BYOC is now generally available on all three major clouds. Deploy fully managed vector search in your own AWS, GCP, or Azure account — your data never leaves your VPC.
Zilliz Cloud Introduces Advanced BYOC-I Solution for Ultimate Enterprise Data Sovereignty
Explore Zilliz Cloud BYOC-I, the solution that balances AI innovation with data control, enabling secure deployments in finance, healthcare, and education sectors.
Vector Databases vs. Graph Databases
Use a vector database for AI-powered similarity search; use a graph database for complex relationship-based queries and network analysis.