Cómo migrar de Chroma a Zilliz Cloud
Chroma Cloud deja de aceptar escrituras el 22 de noviembre de 2026 y deja de atender lecturas el 22 de diciembre de 2026, según el calendario de cierre de Chroma. Si tu aplicación escribe en Chroma Cloud, necesita un nuevo hogar antes de la primera fecha, y tus datos deben estar fuera antes de la segunda.
El Chroma de código abierto no se ve afectado. Pero si lo ejecutas tú mismo y lo estás llevando a producción, con más datos de los que una sola máquina puede manejar cómodamente, un objetivo de disponibilidad y nadie con ganas de estar de guardia para ello, el traslado es el mismo, sin la fecha límite.
Esta guía migra cualquiera de los dos a Zilliz Cloud, la base de datos vectorial completamente administrada construida sobre Milvus de código abierto. Tus embeddings se transfieren tal cual, así que nada se vuelve a incrustar, y tus IDs, documentos, URIs y metadatos vienen con ellos. Si prefieres ejecutar Milvus de código abierto tú mismo, se aplican los mismos pasos; consulta Cómo mover Chroma a Milvus de código abierto en el Paso 1.
La migración incluye cuatro pasos: mover tus datos, verificarlos, actualizar tu aplicación y hacer el cambio.
Antes de comenzar
Necesitas:
- Un clúster de Zilliz Cloud, con su endpoint público y una clave de API. Regístrate si no tienes uno. El plan gratuito permite hasta 5 colecciones; para más, usa un clúster Serverless o Dedicated.
- Los detalles de tu conexión a Chroma. En Chroma Cloud, el panel Connect del panel de control muestra tu clave de API, ID de tenant y nombre de la base de datos. Para Chroma autoalojado, necesitas la dirección del servidor, además de un token o un nombre de usuario y contraseña si habilitaste la autenticación.
- Python 3.10 o posterior con ambos clientes, para verificar la copia y actualizar tu aplicación:
pip install chromadb==1.5.9 pymilvus==3.0.2
- Docker, si usas el Servicio de Transporte de Vectores de código abierto (Opción B en el Paso 1).
Cómo se mapean tus datos
Cada colección de Chroma se convierte en una colección de Zilliz Cloud con cuatro campos. Los metadatos van al campo dinámico de la colección, de modo que cada clave de metadatos sigue siendo filtrable, igual que en Chroma. La página de documentación de Zilliz Cloud Migrate from Chroma to Zilliz Cloud contiene el mapeo completo, incluida la conversión de los tipos de metadatos en campos tipados.
| Chroma | Zilliz Cloud |
|---|---|
| Colección | Colección con el mismo nombre, con - convertido a _: support-docs se convierte en support_docs. Los nombres de Zilliz Cloud solo aceptan letras, dígitos y guiones bajos y no pueden comenzar con un dígito, por lo que un nombre como kb.v2 o 2024-notes necesita un nombre nuevo al configurar la copia. También lo necesita uno de dos nombres que se conviertan en el mismo, como support-docs y support_docs |
id | id, la clave primaria VARCHAR. Los IDs no cambian |
embedding | embedding, un campo FLOAT_VECTOR con la misma dimensión |
document | document, un campo VARCHAR nullable de hasta 65,535 bytes |
uri | uri, un campo VARCHAR nullable. La cadena del URI se copia; el archivo al que apunta no |
| Metadatos | Claves en el campo dinámico. También puedes convertir las claves elegidas en campos tipados al configurar la copia |
Espacio de distancia: cosine, l2 o ip | Métrica de índice: COSINE, L2 o IP. La métrica no se copia; la configuras cuando se crea el índice |
| Función de embedding | No se almacena en la base de datos. Tu aplicación genera los embeddings de las consultas (Paso 3) |
¿Una colección por usuario? Cada colección de Chroma se convierte en su propia colección de Zilliz Cloud, y un clúster alberga un número limitado de ellas: 5 en Free, 100 en Serverless y, en clústeres Dedicated, 1,024 por unidad de cómputo, hasta 16,384. Si tienes más colecciones por usuario que eso, o esperas tenerlas, habla con nosotros antes de migrar: el mejor diseño es una sola colección con una clave de partición, que admite millones de inquilinos.
Paso 1: Mueve tus datos
Puedes copiar los datos de dos maneras. Cuál se adapta depende de dónde se ejecute tu Chroma:
| Tu Chroma | Uso |
|---|---|
| Chroma Cloud | Opción A: Servicio de migración integrado |
| Tu propio servidor de Chroma, accesible desde internet | Opción A: Servicio de migración integrado |
| Tu propio Chroma en una red privada o en tu laptop, o integrado en tu aplicación | Opción B: Vector Transport Service (de código abierto) |
La diferencia es quién se conecta con quién. El servicio de migración se ejecuta en Zilliz Cloud y lee desde tu Chroma, por lo que necesita una dirección a la que pueda acceder. Vector Transport Service se ejecuta en una máquina que tú elijas y escribe hacia Zilliz Cloud, por lo que funciona desde cualquier lugar que pueda acceder a ambos.
Primero, anota el recuento de registros y el espacio de distancia de cada colección. Necesitas el espacio de distancia para configurar la métrica del índice, independientemente de la opción que uses, y el recuento para verificar la copia:
import chromadb

client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud: chromadb.CloudClient(api_key=..., tenant=..., database=...)

for collection in client.list_collections():
    config = collection.configuration_json
    space = (config.get("hnsw") or config.get("spann") or {}).get("space") or "l2"
    print(f"{collection.name}: {collection.count()} records, space {space}")
Chroma usa l2 para las colecciones creadas sin un espacio de distancia. Deja fuera de la copia las colecciones vacías: Chroma no registra una dimensión hasta que llega el primer embedding, por lo que no hay nada desde lo que crear el destino.
Opción A: Servicio de migración de Zilliz Cloud
El servicio de migración está integrado en la consola de Zilliz Cloud y es gratuito. Necesitas el rol de Propietario de la Organización o Administrador del Proyecto. Un servidor de Chroma autohospedado debe servir la API REST v2 de Chroma y ser accesible desde Zilliz Cloud. Si se encuentra detrás de un firewall, añade las direcciones IP de Zilliz Cloud a su lista de permitidos.
- Conectar. En la consola, abre Migraciones y elige Chroma como origen. Introduce el endpoint de Chroma, el tenant, la base de datos y las credenciales. Para Chroma Cloud, cópialos desde el panel Conectar: el endpoint es
https://api.trychroma.com, o el endpoint de tu región si tu base de datos está fuera de AWS us-east-1, y la credencial es tu clave de API. Un Chroma autohospedado puede funcionar sin autenticación, con un token, o con un nombre de usuario y contraseña, y su tenant y base de datos por defecto sondefault_tenantydefault_database. Luego elige el clúster y la base de datos de destino.
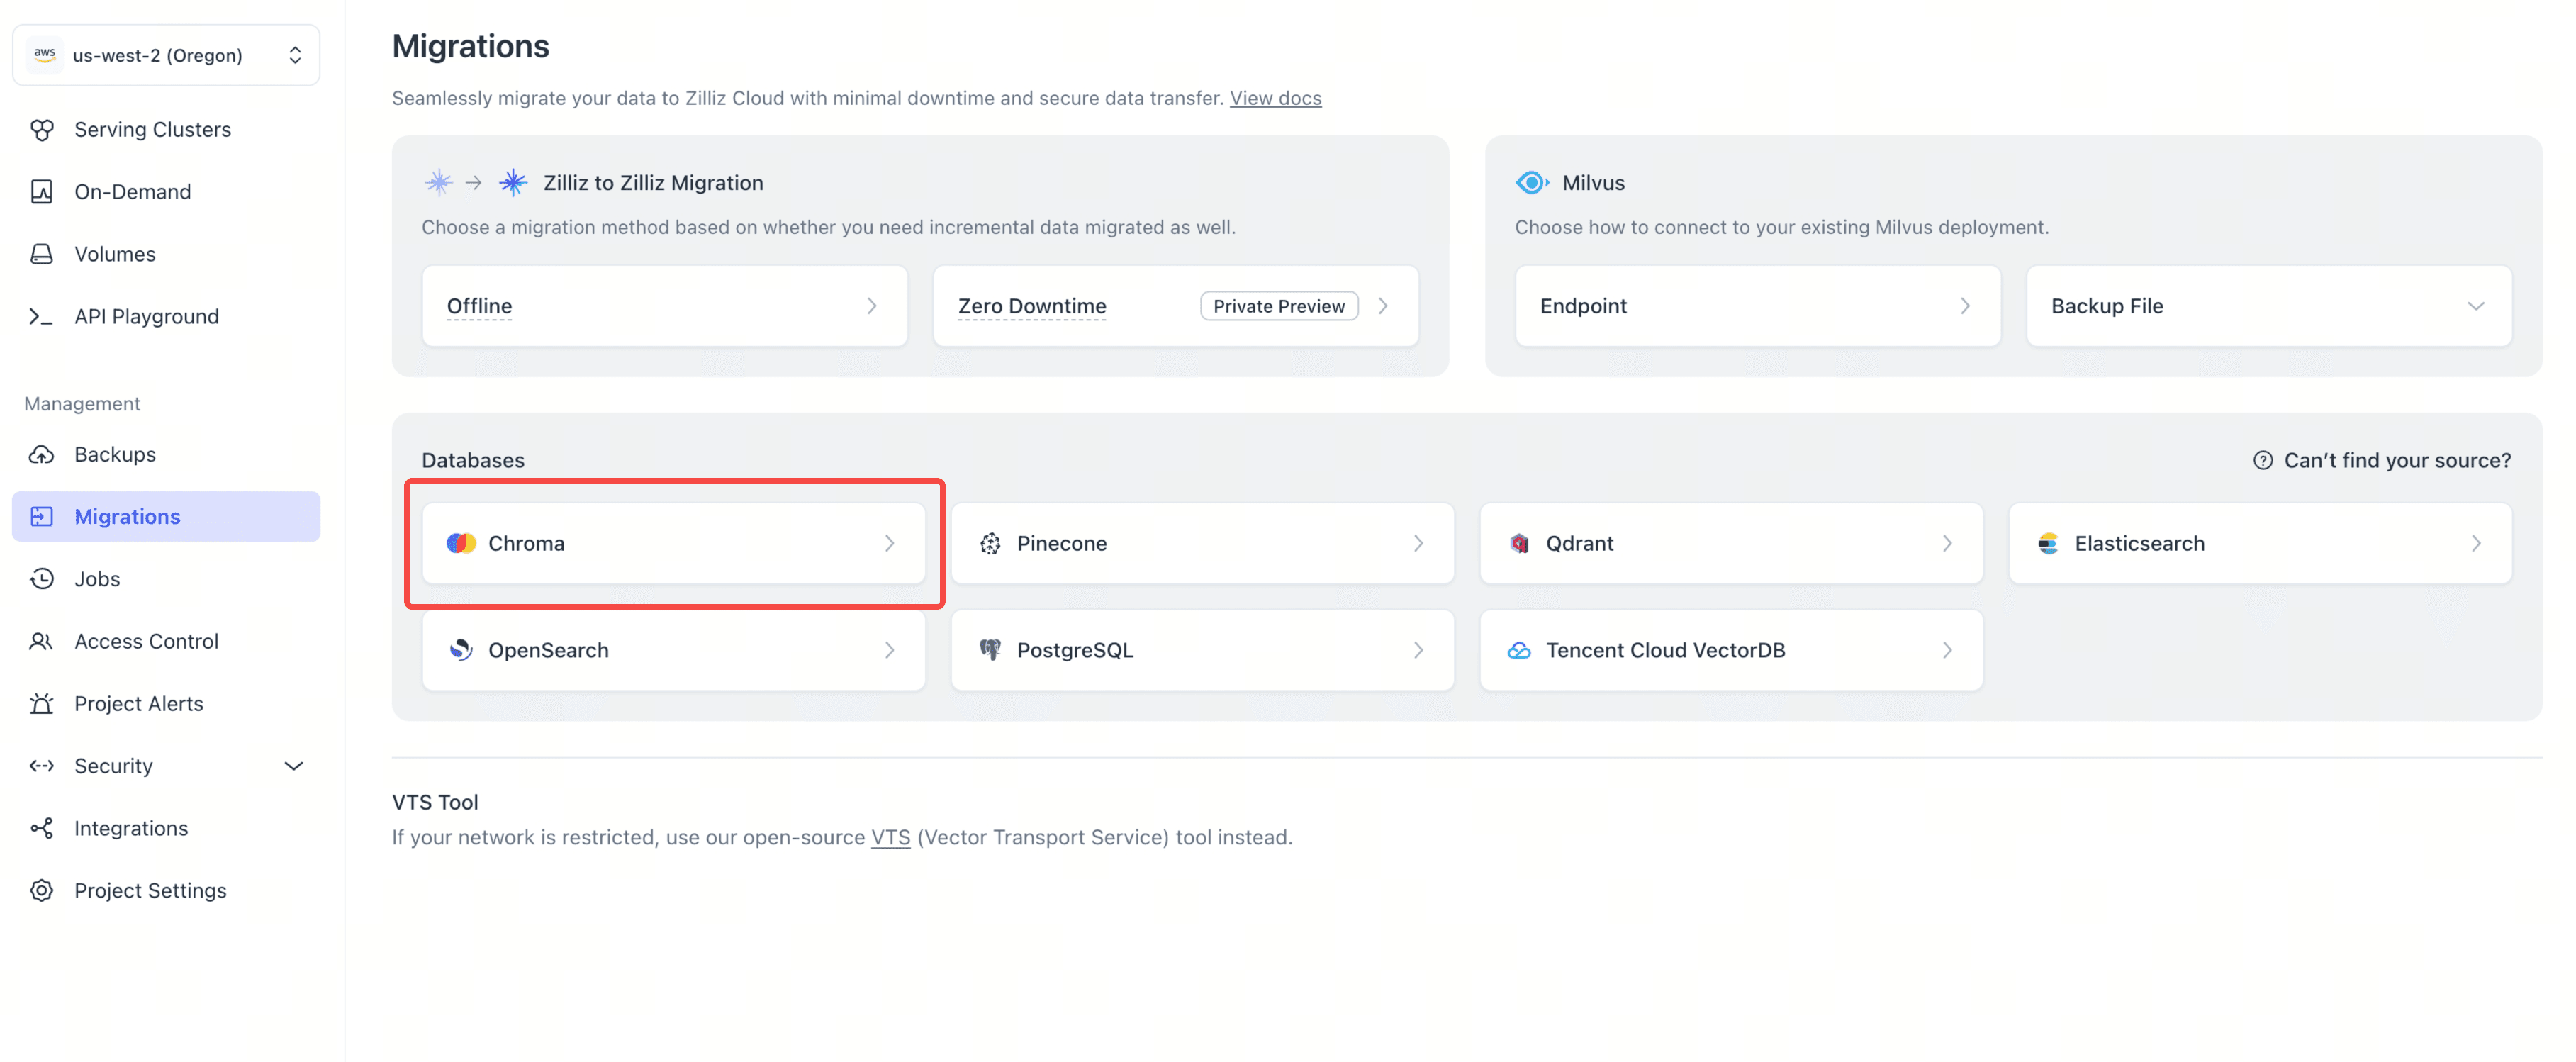
- Seleccionar y revisar. Selecciona las colecciones a mover. Comprueba cada nombre de destino y renombra cualquiera que Zilliz Cloud no pueda usar o que ya esté ocupado. Revisa la asignación de campos: los metadatos van al campo dinámico por defecto, y puedes convertir las claves elegidas en campos tipados aquí.
- Configurar el índice. Deja activada la opción Crear índices después de la migración para que las colecciones sean buscables en cuanto termine el trabajo. Configura la métrica de cada colección para que coincida con su espacio de distancia en Chroma:
cosineaCOSINE,l2aL2eipaIP. La métrica no se copia de Chroma. Consulta la configuración de índices. - Ejecutar. Inicia el trabajo y hazle seguimiento en la página Trabajos. Cuando termine, el trabajo informa el número de filas que verificó.
Todos los campos y opciones se describen en Migrar de Chroma a Zilliz Cloud en la documentación de Zilliz Cloud. Luego ve al Paso 2.
Opción B: Vector Transport Service
Vector Transport Service (VTS) es la herramienta de migración de código abierto de Zilliz, y el motor sobre el que se ejecuta el servicio de migración. Tú mismo lo ejecutas en Docker, a partir de un archivo de configuración. Lee Chroma a través de su API REST v2, la cual sirve cualquier servidor de Chroma con versión 0.6 o posterior.
Si tu Chroma está integrado en tu aplicación, con sus datos en un directorio local mediante chromadb.PersistentClient, todavía no hay ningún servidor del que VTS pueda leer. Inicia uno en ese directorio:
chroma run --path ./chroma_data --port 8000
Luego escribe la configuración del job. Guárdala como migration.conf y reemplaza cada marcador $ con un valor real; no son variables de entorno y no se expanden automáticamente.
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  ChromaDB {
    url = "$CHROMA_URL"                  # e.g. http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # e.g. ["support-docs"]

    # If your Chroma requires auth, see the table below
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"

    id_split_size = 300
    batch_size = 300
  }
}

sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"                 # must already exist
    batch_size = 50
    enable_dynamic_field = true          # required, this is where metadata goes
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
La configuración contiene credenciales, así que restríngela con chmod 600 migration.conf.
| Parámetro | Qué poner ahí |
|---|---|
url (source) | La raíz del servidor de Chroma, sin /api/v2, que VTS añade. VTS se ejecuta en un contenedor, donde localhost significa el propio contenedor. Si Chroma se ejecuta en la misma máquina, usa http://host.docker.internal:8000 en macOS y Windows; en Linux, añade --network host a docker run y mantén localhost. Para Chroma Cloud, usa https://api.trychroma.com, o el endpoint de tu región |
tenant y database | default_tenant y default_database a menos que hayas creado otros. En Chroma Cloud, tu ID de tenant y nombre de base de datos |
auth_type y token | Omite ambos si tu servidor funciona sin autenticación. De lo contrario, usa X_CHROMA_TOKEN o BEARER con un token, o BASIC con username y password. Chroma Cloud usa X_CHROMA_TOKEN con tu clave de API |
id_split_size y batch_size | 300 para ambos funciona en todas partes, y en Chroma Cloud ambos deben mantenerse en 300 o menos. Para una colección self-hosted grande, 10000000 y 1000 escanean IDs en bloque y luego obtienen los registros por ID, lo que evita la lenta paginación profunda |
collection_rename (sink) | Opcional, { "source" = "target" }. Obligatorio para cualquier nombre de origen que no sea un nombre válido de Zilliz Cloud una vez que - se convierte en _ |
Para convertir claves de metadatos seleccionadas en campos tipados, añade un bloque field_schema al sink. La guía del sink de Milvus cubre field_schema y collection_rename, y la guía de fuente de ChromaDB cubre tamaños de lote, autenticación y las demás opciones de fuente.
Ejecuta el job:
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
El job se considera completado cuando el log termina con end with state FINISHED, Total Read Count es igual a Total Write Count y Total Failed Count es 0.
El job añade datos, así que no lo vuelvas a ejecutar en la misma colección. Una segunda ejecución escribe cada registro de nuevo. Si un job falla a mitad de camino, o necesitas una copia nueva, elimina primero la colección de destino, o envía el job a una nueva con collection_rename.
Construye el índice. Usa el espacio de distancia que anotaste para esa colección:
from pymilvus import MilvusClient
client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE",  # cosine -> COSINE, l2 -> L2, ip -> IP
)
client.create_index(collection_name="support_docs", index_params=index_params)
client.load_collection("support_docs")
Migración de Chroma a Milvus de código abierto
Todo en esta guía funciona con Milvus de código abierto 2.5 o posterior. Usa la opción B, que escribe en cualquier Milvus al que pueda acceder: configura la url del sink con la dirección de tu Milvus, como http://host.docker.internal:19530 cuando Milvus se ejecuta en la misma máquina, y token con username:password, o elimina la línea token si la autenticación está desactivada. Los pasos 2 a 4 son los mismos, y en tu aplicación solo cambian uri y token. Debido a que Milvus y Zilliz Cloud comparten una misma API, puedes cambiar entre ellos más adelante sin tocar tu código.
Paso 2: Verifica tus datos
Primero, compara los recuentos de registros. El Servicio de migración informa del número de filas que verificó; para VTS, es Total Write Count en el registro. Cualquiera de ellos debería coincidir con el recuento en Chroma.
Los recuentos te dicen que llegó cada registro. No te dicen que el índice responda a las consultas como lo hacía Chroma: un índice creado con la métrica incorrecta supera la comprobación de recuento y aun así devuelve los vecinos equivocados. Así que ejecuta algunas búsquedas en ambos lados y compara:
import chromadb
from pymilvus import MilvusClient

chroma = chromadb.CloudClient(api_key="YOUR_CHROMA_API_KEY", tenant="YOUR_TENANT_ID", database="YOUR_DATABASE_NAME")
# Self-hosted Chroma: chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY")

source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(query_embeddings=[vector], n_results=10, include=[])["ids"][0]
    hits = milvus.search("support_docs", data=[vector.tolist()], limit=10)[0]
    overlaps.append(len(set(expected) & {hit["id"] for hit in hits}) / len(expected))
print(f"top-10 overlap: {sum(overlaps) / len(overlaps):.0%}")
Esto usa 20 registros como consultas y cuenta cuántos de los 10 mejores resultados coinciden. Ambos sistemas usan índices aproximados, por lo que una cifra ligeramente inferior al 100% es normal. Una mucho más baja casi siempre significa que la métrica del índice no coincide con el espacio de distancia de la colección.
Ninguna de las dos comprobaciones examina el interior de los registros. Antes de que la copia final entre en producción, compara también esos elementos: verifica que cada ID haya llegado, luego compara vectores, documentos, URIs y metadatos. En una colección pequeña, compara todos los registros; en una grande, una muestra aleatoria.
Si tu aplicación siguió escribiendo en Chroma durante la copia, los recuentos pueden diferir. Eso está bien para una primera pasada; para la copia final cuando hagas el cambio, deben coincidir.
Paso 3: Actualiza tu aplicación
Conéctate a Zilliz Cloud:
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
Para Milvus de código abierto, configura uri con la dirección de tu Milvus y token con username:password, o no incluyas token si la autenticación está desactivada. Todo lo demás es igual.
Genera los embeddings de las consultas con el mismo modelo que antes. Cuando pasaste query_texts a Chroma, Chroma ejecutó por ti la función de embeddings de la colección. Las colecciones migradas no llevan esa función, así que llama al mismo modelo en tu código. Si dejaste que Chroma generara los embeddings de tu texto y nunca configuraste una función de embeddings, usó su modelo predeterminado, all-MiniLM-L6-v2. El paquete chromadb aún puede ejecutarlo localmente:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction() query_vector = embed(["How do I get a refund?"])[0].tolist()
Si usaste OpenAI u otro proveedor, llama al mismo modelo con la misma configuración.

**Búsqueda con filtros.** Antes, en Chroma:

```python
results = collection.query(
    query_embeddings=[query_vector],
    n_results=5,
    where={"category": "billing"},
    where_document={"$contains": "refund"},
)
Después, en Zilliz Cloud:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
Cada resultado es un diccionario con id, distance y los campos que pediste bajo entity. Los filtros where y where_document de Chroma se convierten en una sola expresión de filtro:
| Chroma | Zilliz Cloud |
|---|---|
{"category": "billing"} | category == "billing" |
{"category": {"$ne": "billing"}} | category != "billing" |
{"year": {"$gte": 2023}} (también $gt, $lt, $lte) | year >= 2023 (también >, <, <=) |
{"category": {"$in": ["billing", "account"]}} | category in ["billing", "account"] |
{"category": {"$nin": ["billing", "account"]}} | category not in ["billing", "account"] |
{"$and": [...]} y {"$or": [...]} | ... and ... y ... or ... |
{"is_public": True} | is_public == true |
{"tags": {"$contains": "faq"}} (metadatos de array) | array_contains(tags, "faq") |
where_document={"$contains": "refund"} | document like "%refund%" |
where_document={"$not_contains": "refund"} | not (document like "%refund%") |
Lee las puntuaciones en el sentido contrario. Chroma devuelve distancias, donde un valor más bajo significa más similar. Para COSINE e IP, Zilliz Cloud devuelve puntuaciones de similitud, donde un valor más alto significa más similar. Los rankings no cambian, pero cualquier umbral en tu código sí. En nuestra prueba, el primer resultado de la búsqueda anterior tuvo una distancia de Chroma de 0.0545 y una puntuación de Zilliz Cloud de 0.9455.
| Espacio de Chroma | Chroma devuelve | Zilliz Cloud devuelve | Un umbral como distance < 0.3 se convierte en |
|---|---|---|---|
cosine | 1 − similitud de coseno | Similitud de coseno | score > 0.7 |
ip | 1 − producto interior | Producto interior | score > 0.7 |
l2 | Distancia L2 al cuadrado | Distancia L2 al cuadrado | Sin cambios |
Escribe y elimina registros. Las claves de metadatos están junto a los demás campos en cada fila, por lo que no hay un argumento metadatas separado. add y upsert se asignan ambos a upsert (o insert para ID nuevos), y delete funciona por ID o por filtro:
client.upsert(
    collection_name="support_docs",
    data=[{"id": "doc-1001", "embedding": vector, "document": "How to change your billing address", "category": "billing"}],
)
client.delete(collection_name="support_docs", ids=["doc-1001"])
client.delete(collection_name="support_docs", filter='category == "archived"')
Aquí vector es un embedding del mismo modelo que el resto de la colección. Puedes omitir uri; es nullable.
¿Usas LangChain? Cambia la clase del almacén de vectores y apúntala a los nombres de campos migrados. Antes:
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, filter={"category": "billing"})
Después, con pip install langchain-milvus:
from langchain_milvus import Milvus
vector_store = Milvus(
    embedding_function=embeddings,
    collection_name="support_docs",
    connection_args={"uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT", "token": "YOUR_ZILLIZ_CLOUD_API_KEY"},
    primary_field="id",
    text_field="document",
    vector_field="embedding",
    enable_dynamic_field=True,
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, expr='category == "billing"')
embeddings es el mismo objeto de embeddings de LangChain que usaste con Chroma, y los filtros pasan de filter={...} a expr="...". Los usuarios de LlamaIndex pueden cambiar al almacén vectorial de Milvus de la misma manera.
Paso 4: Cambio
- Copia tus datos, verifícalos y apunta una compilación de prueba (staging) de tu aplicación a Zilliz Cloud.
- Pausa las escrituras en Chroma. Después del 22 de noviembre, Chroma Cloud las bloquea de todos modos.
- Copia de nuevo, para obtener todas las escrituras hasta la pausa, y verifica que los recuentos coincidan exactamente. Elimina la primera copia antes de comenzar, o envía esta a otra base de datos.
- Implementa tu aplicación en Zilliz Cloud.
- En Chroma Cloud, elimina o rota tus credenciales antes del 22 de diciembre, como lo solicita el aviso de cierre de Chroma.
¿Estás leyendo esto después del 22 de noviembre? Tus datos de Chroma Cloud ya son de solo lectura, así que omite el paso 2 y copia una vez. Aún puedes copiarlos hasta el 22 de diciembre.
En Chroma autoalojado, no hay fecha límite, pero mantén el orden: copia, pausa las escrituras, copia de nuevo, cambia. Mantén tu servidor de Chroma durante un tiempo después. Hasta que tu aplicación escriba algo nuevo en Zilliz Cloud, volver atrás es solo un cambio de configuración.
Próximos pasos
- ¿Estás migrando una carga de trabajo grande o de producción? Habla con nuestro equipo de soporte sobre la planificación del cambio.
- ¿Comparando opciones primero? Chroma vs. Zilliz Cloud cubre características, escala y qué se mapea desde Chroma Cloud.
- ¿Usabas búsqueda híbrida en Chroma Cloud? La búsqueda híbrida de Zilliz Cloud combina vectores densos con BM25 u otros vectores dispersos en una sola solicitud.
- ¿También migras otras bases de datos? El mismo Migration Service maneja Pinecone, Qdrant, Elasticsearch, OpenSearch y PostgreSQL.
 Fendy Feng
 is the Product Marketing Manager at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Sebastian Huang
Staff Software Engineer at Zilliz
 Shawn He
Senior Software Engineer at Zilliz
Sigue leyendo
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.
A Developer's Guide to Exploring Milvus 2.6 Features on Zilliz Cloud
Milvus 2.6 marks a shift from “vector search + glue code” to a more advanced retrieval engine, and it is now Generally Available (GA) on Zilliz Cloud (a managed Milvus service).
Zilliz Cloud BYOC Upgrades: Bring Enterprise-Grade Security, Networking Isolation, and More
Discover how Zilliz Cloud BYOC brings enterprise-grade security, networking isolation, and infrastructure automation to vector database deployments in AWS