
Nomic / nomic-embed-vision-v1
Um modelo de incorporação visual com 92 milhões de parâmetros, compatível com busca unimodal e multimodal em combinação com nomic-embed-text-v1
Milvus Integrated
Tarefa: Incorporação
Modalidade: Imagem
Métrica de Similaridade: Cosseno
Licença: Apache 2.0
Dimensões: 768
Tokens Máximos de Entrada:
Preço: Grátis
Introdução ao nomic-embed-vision-v1
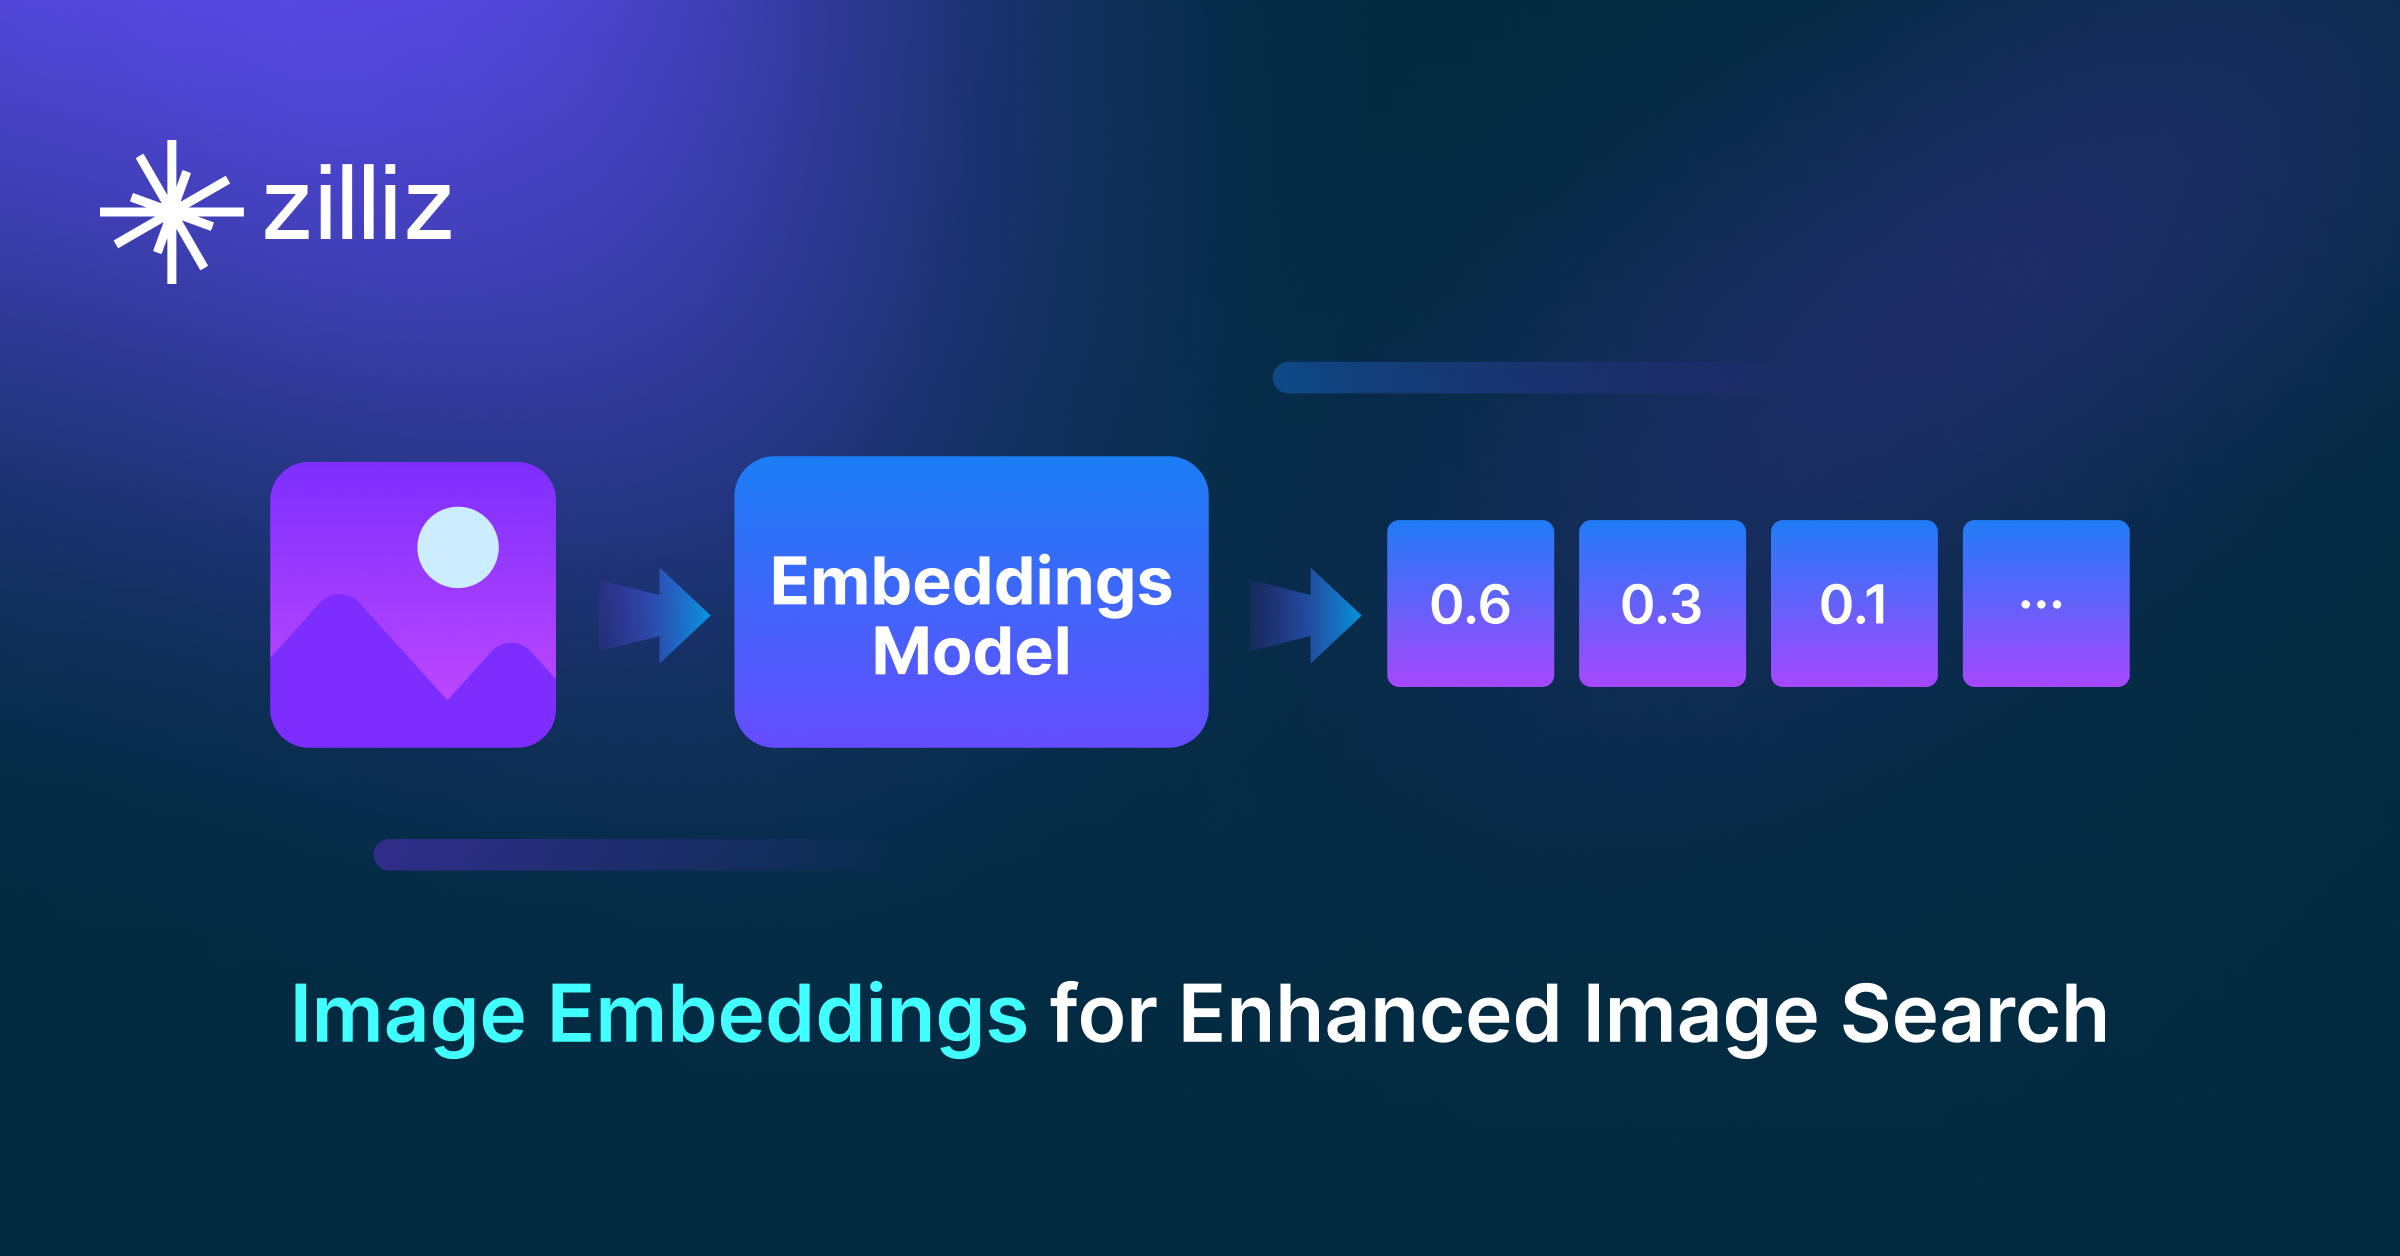
O modelo nomic-embed-vision-v1 é um modelo de embedding de visão totalmente replicável que compartilha o mesmo espaço latente que o nomic-embed-text-v1, permitindo uso multimodal em que embeddings de texto e imagem podem consultar uns aos outros diretamente. Com um codificador de visão de 92M parâmetros, ele oferece suporte a embedding de imagem e texto, busca unimodal dentro de cada modalidade e busca multimodal entre ambas.
Como criar embeddings com nomic-embed-vision-v1
Há duas formas principais de gerar embeddings vetoriais:
- PyMilvus: o SDK Python para Milvus que integra perfeitamente o modelo
nomic-embed-vision-v1. - O módulo
embedno SDK Python da Nomic fornece funcionalidade de embedding usando a Nomic Embedding API.
Depois que os embeddings vetoriais são gerados, eles podem ser armazenados no Zilliz Cloud (um serviço de banco de dados vetorial totalmente gerenciado, desenvolvido com Milvus) e usados para busca por similaridade semântica. Aqui estão quatro etapas principais:
- Cadastre-se gratuitamente para uma conta do Zilliz Cloud.
- Configure um cluster serverless e obtenha o Public Endpoint e a API Key.
- Crie uma coleção vetorial e insira seus embeddings vetoriais.
- Execute uma busca semântica nos embeddings armazenados.
Crie embeddings via PyMilvus e insira-os no Zilliz Cloud para busca semântica
from pymilvus import MilvusClient
from nomic import embed

# Prepare images (can be local paths or URLs)
images = ["path/to/image1.jpg", "path/to/image2.jpg", "path/to/image3.jpg"]

# Generate embeddings for images using nomic-embed-vision-v1
image_embeddings = embed.image(images=images, model="nomic-embed-vision-v1")[
    "embeddings"
]

# Prepare query image
query_images = ["path/to/query_image.jpg"]

# Generate embeddings for query
query_embeddings = embed.image(images=query_images, model="nomic-embed-vision-v1")[
    "embeddings"
]

# Connect to Zilliz Cloud with Public Endpoint and API Key
client = MilvusClient(uri=ZILLIZ_PUBLIC_ENDPOINT, token=ZILLIZ_API_KEY)

COLLECTION = "nomic_vision_v1_images"

# Drop collection if it exists
if client.has_collection(collection_name=COLLECTION):
    client.drop_collection(collection_name=COLLECTION)

# Create collection with dimension 768 (nomic-embed-vision-v1 output dimension)
client.create_collection(collection_name=COLLECTION, dimension=768, auto_id=True)

# Insert images with embeddings
for image, embedding in zip(images, image_embeddings):
    client.insert(COLLECTION, {"image_path": image, "vector": embedding})

# Search for similar images
results = client.search(
    collection_name=COLLECTION,
    data=query_embeddings,
    # consistency_level="Strong",  # Strong consistency ensures accurate results but may increase latency
    output_fields=["image_path"],
    limit=3,
)

# Print search results
print("Similar images found:")
for result in results[0]:
    print(f"  - {result['entity']['image_path']} (distance: {result['distance']:.4f})")
Para mais informações, consulte nossa documentação do Modelo de Embedding PyMilvus.