Alexandr Guzhva: Perché sono entrato in Zilliz
Mi chiamo Alexandr Guzhva e lavoro in Zilliz sull’ottimizzazione delle prestazioni.
Sono entrato in Zilliz per superare i concorrenti dell’azienda. E perché sentivo che avrei potuto utilizzare appieno la mia competenza.
Ho trascorso 15 anni nella finanza, dove ho iniziato a usare l’approccio di ricerca approssimata dei vicini più prossimi (ANNS) per accelerare le previsioni di serie temporali per la simulazione di algo trading, sia su CPU sia su GPU. Il motore di calcolo che ho creato poteva eseguire simulazioni diversi ordini di grandezza più velocemente rispetto alla baseline, grazie ad ANNS.
Dopo di ciò, ho trascorso circa 2 anni in Meta, dove ho aggiunto codice relativo alle prestazioni alla libreria FAISS e utilizzato le sue potenti funzionalità per applicare codec vettoriali per comprimere enormi modelli di raccomandazione che Meta usa per Ads. Sono stato considerato uno degli autori della libreria FAISS grazie alle mie donazioni di codice.
Nel complesso, ho scritto più di 2M righe di codice durante la mia carriera e mi occupo di metodi di ricerca per similarità da 10 anni.
Zilliz come azienda è diventata interessante per me, perché sapevo che utilizza vari modi per accelerare i suoi prodotti, come l’integrazione con NVIDIA Raft, esperimenti con varie piattaforme hardware e metodi avanzati di ricerca per similarità. Questo mi ha dato la fiducia che le attività di ingegneria e ricerca richieste siano piuttosto non banali, non in stile python-monkey :) Molte aziende la usano, il che indica che i suoi prodotti sono competitivi.
Durante il colloquio tecnico James Luan, VP of Engineering di Zilliz, mi ha detto che l’azienda punta a essere la numero 1 nell’area dei database vettoriali, non sono accettabili altre opzioni. Oggi, i database vettoriali sono un campo in rapidissima evoluzione, e ciò implica un livello molto elevato di competitività. Questa particolare frase di James mi ha convinto definitivamente a entrare in Zilliz, perché corrisponde al mio modo di pensare ed è molto familiare e naturale per me. Inoltre, sono diventato curioso, perché il campo dei database vettoriali introduce sfide aggiuntive rispetto alle applicazioni tradizionali di ricerca per similarità, come la necessità di modificare i dati o di includere metadati aggiuntivi con ogni campione.
Continuerò a donare i miei miglioramenti a Milvus OSS e prevedo di essere sempre più coinvolto nel rendere i prodotti Zilliz il migliori possibile. Forse, a un certo punto, riuscirò ad applicare la mia conoscenza dell’uso di ANNS per la previsione di serie temporali.
Continua a leggere
How to Choose the Best Embedding Model for RAG in 2026: 10 Models Benchmarked
We benchmarked 10 embedding models on cross-modal, cross-lingual, long-document, and dimension compression tasks. See which one fits your RAG pipeline.
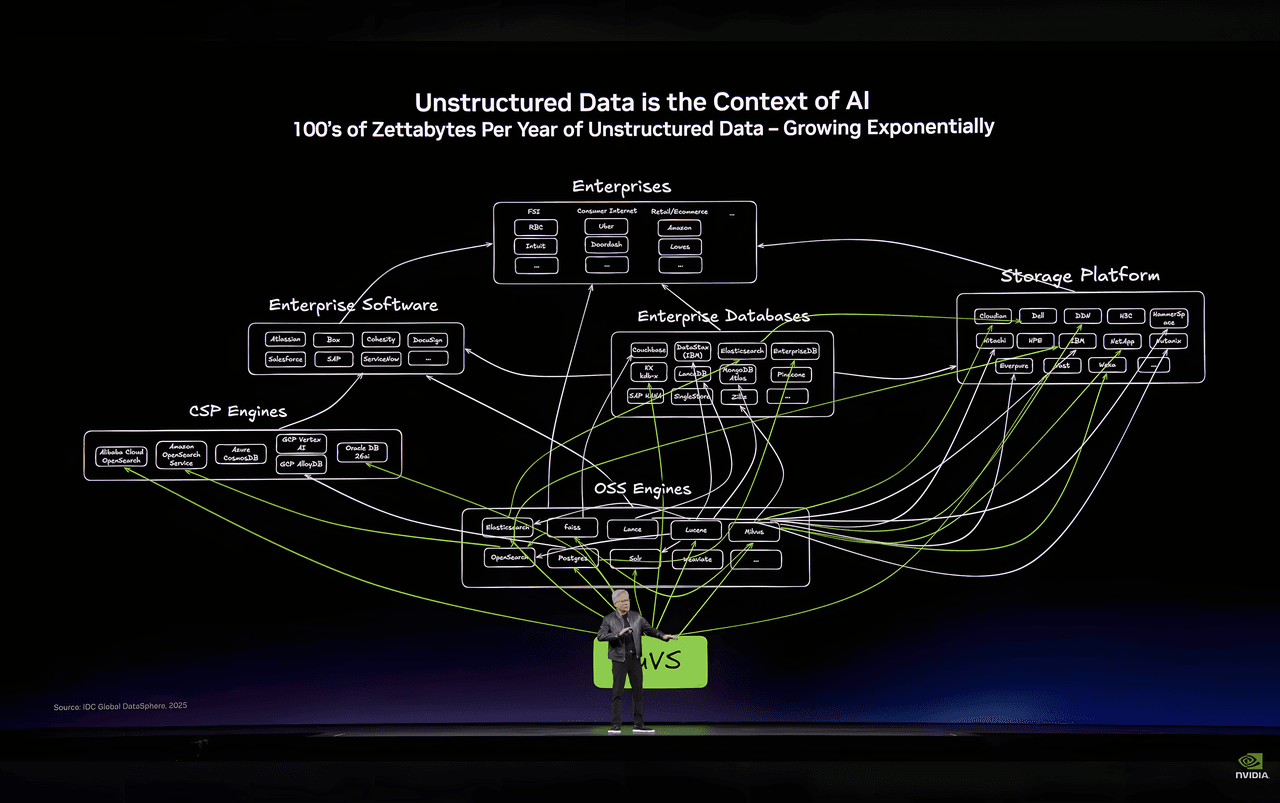
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.
Why and How to Migrate from Self-Hosted Milvus to Zilliz Cloud
A simple, step-by-step guide to migrating from Milvus to Zilliz Cloud. Learn both endpoint and backup methods for a smooth, scalable vector database migration.