🚀 Nouveautés du filtrage des métadonnées dans Milvus v2.4.3
Milvus v2.4.3 a introduit la correspondance de métadonnées sur chaîne complète ! 🎉 Désormais, vous pouvez faire correspondre des chaînes à l’aide de recherches par préfixe, infixe, suffixe, ou même avec caractère générique.
# Prefix example, matches any string starting with “The”.
expression='title like "The%"'
# Infix example, matches any string with the word “the” anywhere in the sentence.
expression='title like "%the%"'
# Postfix example, matches any string ending with “Rye”.
expression='title like "%Rye"'
# Single character wildcard example, matches any one single character at a specific position.
expression='title like "Flip_ed"'
Dans des blogs précédents, nous n’avions parlé que de la correspondance de chaînes par préfixe. Cependant, depuis Milvus v2.4.3, toutes les variantes sont également possibles, tout comme l’utilisation de valeurs de tableau, soit par correspondances exactes, soit en vérifiant si des éléments du tableau correspondent (contains_any()). 🗂️🔍
Ces mises à jour rendent le filtrage des métadonnées plus polyvalent et plus puissant !
Rendons tout cela plus clair avec un exemple. Pour ce blog, j’utiliserai les données de films IMDB, que j’ai téléchargées depuis Kaggle.
# Import common libraries.
import sys, os, time, pprint
import pandas as pd

# Read CSV data.
df = pd.read_csv("data/original_data.csv")

# Shortcut the data for demo.
df = df.tail(200)
display(df.head())
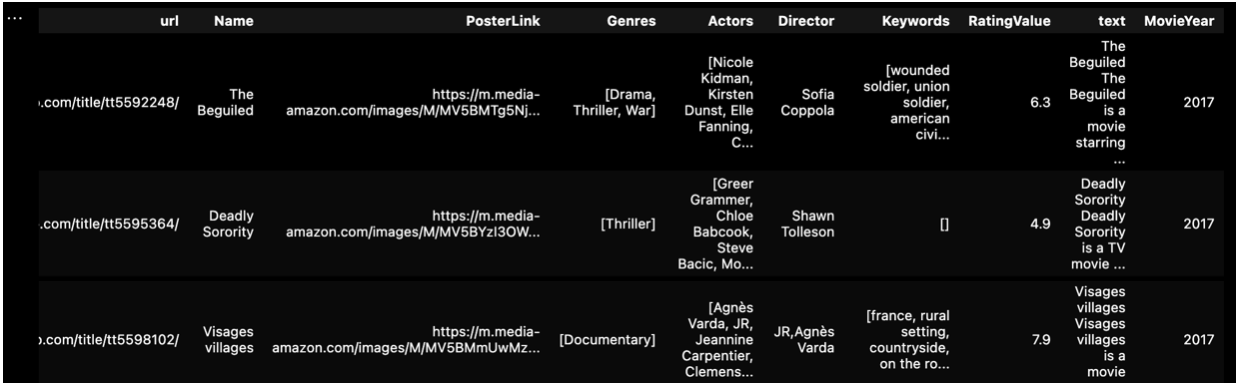
Chaque film possède un champ ‘text’ avec sa description et ses critiques. 📝
Chaque film inclut des métadonnées comme l’année de sortie, la note, ainsi que des listes de genres, d’acteurs et de mots-clés. 🎬⭐️📅
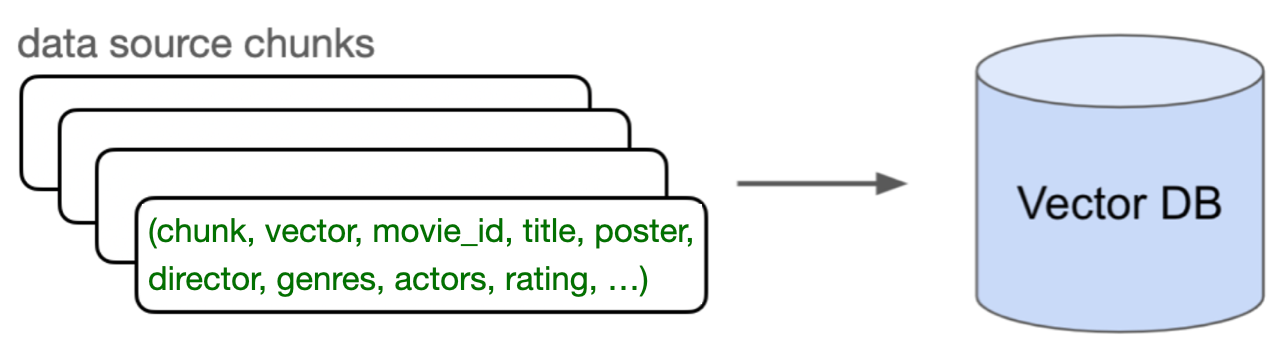
Chaque “ligne” représente un fragment de texte d’une critique de film, sa représentation vectorielle et des métadonnées telles que movie_id, le titre du film, le lien de l’affiche, les genres et les acteurs.
En suivant le modèle habituel de RAG : 📝🎬
Se connecter à Milvus : Tout d’abord, connectez-vous à Milvus Lite, le déploiement local de Milvus. C’est notre base de données pour stocker et gérer les vecteurs. 🖥️🔗
Transformer le texte des films en vecteurs : Prenez le champ texte de chaque film, qui inclut la description et la critique, et transformez-le en vecteur. Nous utiliserons le modèle HuggingFace BAAI/bge-large-en-v1.5 pour cela. 🧠➡️📏
📥📊 Insérer les vecteurs et les métadonnées dans Milvus : Insérez ce vecteur, avec le texte d’origine (appelé le “chunk”) et ses métadonnées (comme l’année, la note, les genres, etc.) dans Milvus. 📥📊
Gérer les requêtes utilisateur : Transformez la requête de l’utilisateur en vecteur à l’aide du même modèle d’embedding. Ensuite, lancez une recherche des plus proches voisins approximatifs pour trouver les vecteurs de données les plus proches du vecteur de requête. 🔍🎬
Vous pouvez trouver le code complet sur mon GitHub.
Tout d’abord, connectez-vous à Milvus. Vous devrez installer Pymilvus avec pip. (En spécifiant simplement un nom de fichier local, il utilise Milvus Lite, une base de données vectorielle locale. Si vous avez un autre Milvus, par exemple déployé avec docker ou K8s, ou Zilliz Cloud entièrement managé, vous pouvez spécifier l’URI et le Token pour vous y connecter. Le reste du code fonctionne de la même manière.)
# !python -m pip install -U pymilvus
import pymilvus
# Connect a client to the Milvus Lite server.
from pymilvus import MilvusClient
client = MilvusClient("milvus_demo.db")
Ensuite, segmentez et vectorisez la colonne de texte contenant la critique de film en vecteurs. De nombreuses ressources donnent des exemples de la manière de procéder, je ne montrerai donc pas à nouveau le code ici. Ci-dessous, je montre comment assembler le texte segmenté, la représentation vectorielle et les métadonnées, puis insérer les données dans Milvus.
# Create chunk_list and dict_list in a single loop
dict_list = []
for id, title, chunk, vector, poster_url, director,\
   genres, actors, keywords, film_year, rating in zip(
       df.id, df.Name, chunks, converted_values, df.PosterLink,
       df.Director, df.Genres, df.Actors, df.Keywords,
       df.MovieYear, df.RatingValue):

   # Assemble embedding vector, original text chunk, metadata.
   chunk_dict = {
       'movie_index': id,
       'title': title,
       'chunk': chunk.page_content,
       'poster_url': poster_url,
       'director': director,
       'genres': genres,
       'actors': actors,
       'keywords': keywords,
       'film_year': film_year,
       'rating': rating,
       'vector': vector,
   }
   dict_list.append(chunk_dict)

# Insert data into the Milvus collection.
print("Start inserting entities")
start_time = time.time()
client.insert(
   COLLECTION_NAME,
   data=dict_list,
   progress_bar=True)

end_time = time.time()
print(f"Milvus insert time for {len(dict_list)} vectors: ", end="")
print(f"{np.round(end_time - start_time, 2)} seconds")

Maintenant que les données sont dans Milvus, nous sommes prêts à effectuer une recherche !
Recherche à l’aide de filtres de métadonnées de chaîne
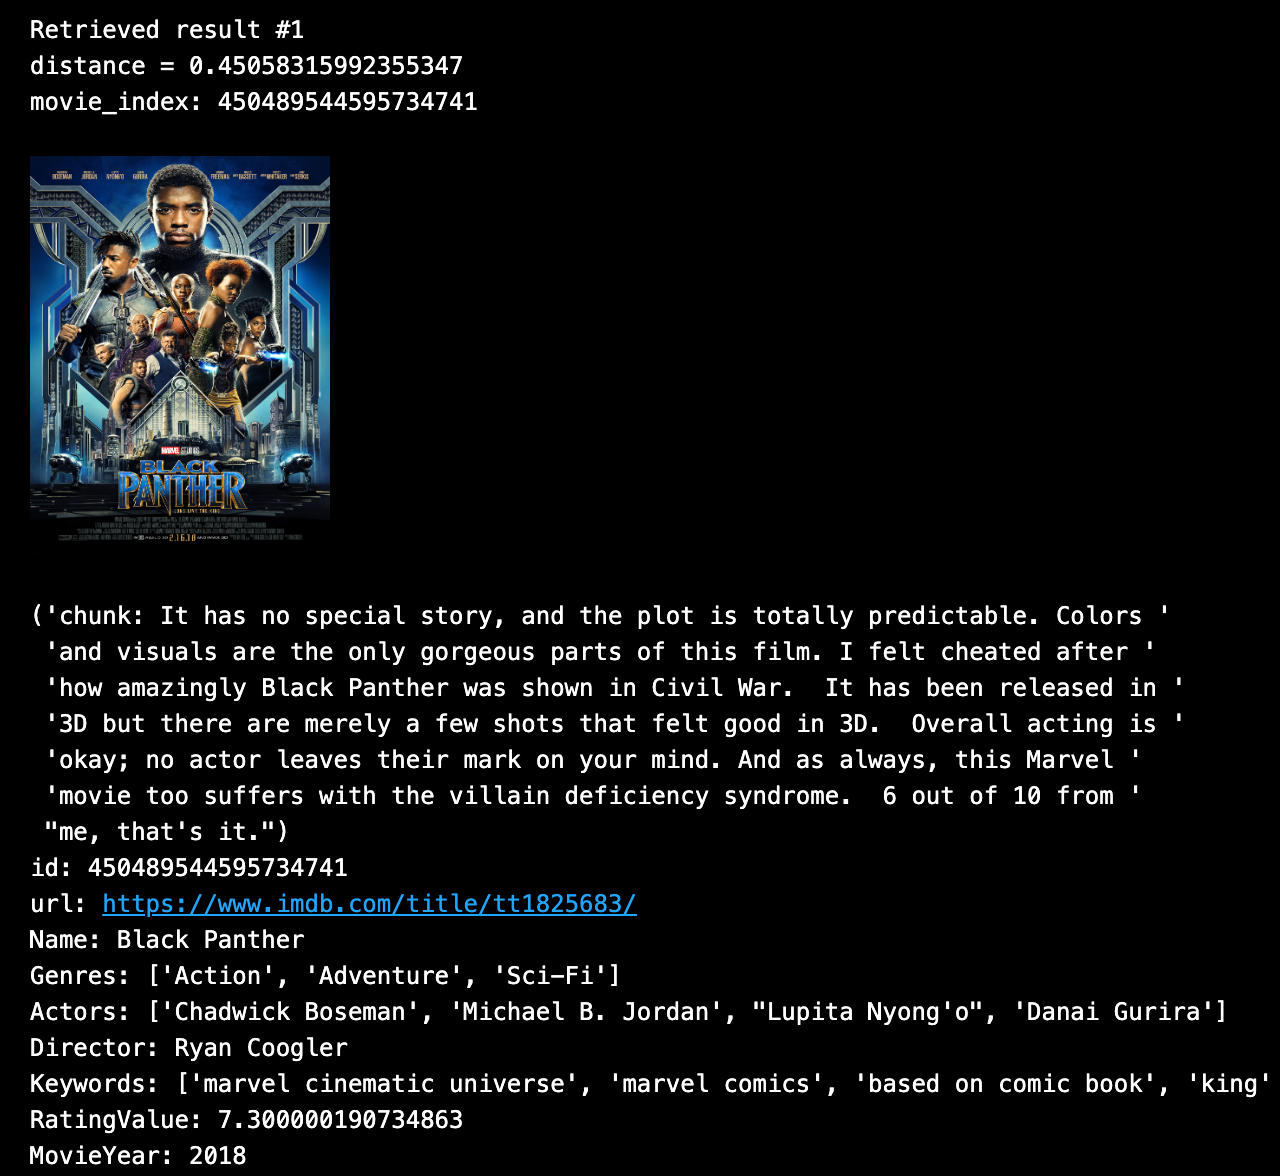
Disons que nous voulons trouver des films de science-fiction qui présentent un futur dystopique avec des robots et qui sont très bien notés. Nos données d’exemple contiennent des métadonnées que nous pouvons utiliser pour cette recherche.
Voici un exemple de filtrage de métadonnées utilisant des correspondances de chaîne approximatives. Ci-dessous, j’ai encapsulé l’API de recherche Milvus standard uniquement pour afficher plus facilement les métadonnées après chaque recherche.
SAMPLE_QUESTION = "Dystopia science fiction with a robot."
TOP_K = 1
# Metadata filters.
expression='rating >= 7'
# Infix string match.
expression=expression + ' && title like "%Panther%"'
formatted_results, contexts, context_metadata = \
     mc_run_search(SAMPLE_QUESTION, expression, TOP_K)
Ressources et lectures complémentaires
Guide de démarrage rapide de Milvus
Utiliser des champs de tableau | Documentation Milvus
https://github.com/milvus-io/pymilvus/blob/2.4/examples/fuzzy_match.py
https://milvus.io/docs/boolean.md#Usage
https://milvus.io/docs/single-vector-search.md#Filtered-search
Continuer à lire
Introducing Loon: A New Storage Engine for Vector Data That Never Stops Changing
Loon is a new storage engine for Milvus 3.0 and Zilliz Vector Lakebase, built to manage evolving vector datasets with ColumnGroups, row ID alignment, and Manifests.
Zilliz Cloud Update: Tiered Storage, Business Critical Plan, Cross-Region Backup, and Pricing Changes
This release offers a rebuilt tiered storage with lower costs, a new Business Critical plan for enhanced security, and pricing updates, among other features.
Zilliz Cloud Launches in AWS Australia, Expanding Global Reach to Australia and Neighboring Markets
We're thrilled to announce that Zilliz Cloud is now available in the AWS Sydney, Australia region (ap-southeast-2).