OpenArt impulsa la búsqueda multimodal para más de 8M de creadores de video con IA mediante Zilliz Cloud
25 s → 300 ms
Latencia de búsqueda P99, ES → Zilliz
~85% inferior
Calcular el costo después de la migración
Búsqueda nativa multi-vector
Vectores de imagen y texto consultados juntos
456M
Vectores migrados sin re-embedding
"Los creadores no hacen una imagen y se van. Construyen un personaje, un mundo, una historia, y todo lo que han generado se convierte en material para la siguiente escena. Zilliz Cloud nos permite tratar toda esa biblioteca como una única memoria creativa."
John Qiao
Acerca de OpenArt
OpenArt es una de las plataformas de generación de imágenes y vídeo con IA más utilizadas del mundo, con más de 8 millones de creadores: aficionados, especialistas en marketing y profesionales del entretenimiento en activo. Reúne más de 100 modelos de Google, OpenAI, Seedance y otros en un único lienzo, pero los modelos son la parte commoditizada. Lo que OpenArt construye sobre ellos es la continuidad: un Character Builder que mantiene un personaje a lo largo de las escenas, One-Click Story para narraciones de múltiples escenas y un conjunto de herramientas de storyboard que los creadores usan para hacer tráileres, anuncios y vídeo social. La ambición detrás de todo ello es poner la propiedad intelectual nativa de IA al alcance de cualquier creador: personajes y mundos que persisten y crecen, en lugar de imágenes que no lo hacen.
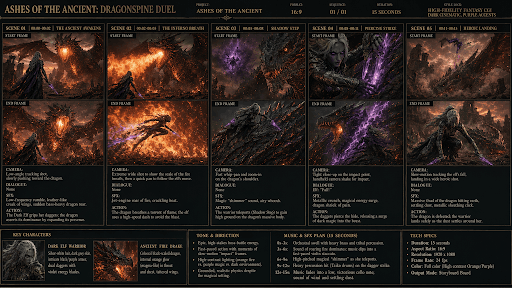
La continuidad es la parte difícil, y no solo en el momento de la generación. El reto del vídeo con IA no es producir quince buenos segundos, sino producir los siguientes quince y conseguir que pertenezcan a la misma historia. También tiene una consecuencia posterior: los creadores vuelven a un mundo durante meses, y todo lo que han generado se convierte en material de referencia para la siguiente escena. El catálogo anterior del propio creador tiene que poder encontrarse por significado, no por nombre de archivo o fecha, y ahí es donde OpenArt aprovecha Zilliz Cloud.
El reto
La búsqueda de creadores de OpenArt se ejecutaba en la búsqueda vectorial de Elasticsearch. Funcionaba bien mientras la colección era pequeña. Cuando el historial de generación superó unos cientos de millones de vectores, cuatro cosas se habían roto.
- La latencia de búsqueda P99 alcanzó los 25 segundos. La gestión del ciclo de vida de los índices de Elasticsearch está diseñada para datos de registros, por lo que rotaba los índices de OpenArt de caliente a templado a frío a congelado aproximadamente cada 90 días, y la mayor parte del corpus acababa congelada — pero la búsqueda vectorial tiene el patrón de acceso opuesto, porque clasificar un top K implica puntuar todo. Cada búsqueda llegaba al nivel congelado y traía datos a través de la red para responderla.
- El número de índices crecía exponencialmente. Elasticsearch creaba al menos un índice nuevo cada 90 días y nunca los fusionaba, por lo que el número de índices por los que una consulta tenía que distribuirse seguía multiplicándose. En una colección que solo crece, el equipo proyectó que la búsqueda se degradaría drásticamente en unos dos años.
- OpenArt estaba pagando por una plataforma de búsqueda completa para usar una única función limitada de ella. Además, el clúster estaba sobredimensionado porque el equipo lo dimensionó antes de medir las necesidades reales de la carga de trabajo.
- La recuperación multivector tenía que construirse a mano. Elasticsearch no tenía una forma nativa de consultar un vector de imagen y un vector de texto juntos, así que OpenArt tuvo que escribir su propio algoritmo de doble kNN e integrar componentes de terceros para ejecutar ambas búsquedas, fusionar los resultados y filtrarlos: un elemento de mantenimiento permanente sobre una capacidad que no es el diferenciador de OpenArt.
Por qué Zilliz Cloud
El equipo de ingeniería de OpenArt evaluó Pinecone y Qdrant, y ninguno era el adecuado. El equipo también había operado el propio Milvus en los primeros días de la empresa y le gustaba; lo que lo descartó en ese momento fue la carga operativa de autoalojarlo. Zilliz Cloud eliminó esa objeción: está construido por el mismo equipo detrás de Milvus de código abierto y es 100% compatible con las API de Milvus, por lo que el conocimiento existente y el código de cliente del equipo se trasladaron sin problemas.
Los benchmarks con los datos propios de OpenArt confirmaron el rendimiento, y la evaluación se detuvo ahí. Cuatro cosas hacen que Zilliz Cloud destaque:
Una arquitectura construida para cómo la búsqueda vectorial lee los datos. Zilliz Cloud gestiona los niveles de datos por sí mismo según la temperatura de los datos: promueve los datos a la caché cuando se recuperan con frecuencia o los degrada a almacenamiento en frío cuando no se necesitan, sin una política de ciclo de vida que la aplicación tenga que considerar, y la autocompactación a nivel de segmento fusiona los datos en segundo plano a medida que crecen. Esas dos capacidades abordan exactamente los modos de fallo con los que OpenArt había estado conviviendo — el recorrido de nivel congelado y la proliferación ilimitada de índices — de modo que la búsqueda de OpenArt no se vuelve más lenta a medida que la biblioteca crece.
Búsqueda nativa de múltiples vectores. Una sola colección de Zilliz Cloud contiene múltiples campos vectoriales y los consulta juntos en una sola solicitud, fusionando los resultados mediante una ponderación configurable. Esa es precisamente la capacidad que OpenArt había estado construyendo a mano sobre Elasticsearch, y obtenerla de forma nativa es lo que permitió al equipo eliminar su propio código.
Precios vinculados a la computación bajo demanda, no a los datos almacenados. Una de las alternativas facturaba según el volumen de datos — el eje incorrecto para un archivo creativo, donde el corpus crece para siempre pero solo se consulta una fracción en cada momento. El modelo de Zilliz Cloud basado en computación bajo demanda permite a OpenArt dimensionar el rendimiento que necesita y redimensionarlo a medida que cambia la carga de trabajo, en lugar de pagar un impuesto sobre el historial.
Operable sin un especialista en infraestructura. Un servicio gestionado aún debe ser utilizable en el día a día por las personas que lo tienen. OpenArt encontró que la consola era lo bastante clara como para navegarla por intuición, sin leer documentación — un fuerte contraste con una plataforma de búsqueda de propósito general que carga con una década de funciones acumuladas que nunca usarían.
"Atendemos a millones de creadores, así que cada pieza de infraestructura debe ser rápida, predecible y no necesitar que nadie la vigile. Zilliz Cloud es uno de los pocos que superó ese listón al primer intento." — Danny Xiong, Ingeniero de Software, OpenArt
La solución: cómo Zilliz Cloud impulsa OpenArt
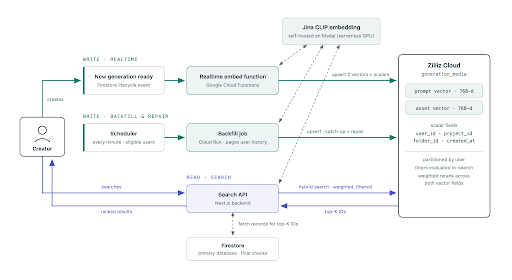
OpenArt utiliza Zilliz Cloud para ejecutar la búsqueda vectorial tras el cuadro de búsqueda sobre el historial de generaciones del propio creador, disponible para suscriptores en planes elegibles. Un creador que ha hecho miles de imágenes y clips a lo largo de meses escribe una frase — un nombre de personaje, un estado de ánimo, una escena — y recupera su propio trabajo pasado, ordenado por significado en lugar de por nombre de archivo o fecha.
Esa tarea es más difícil de lo que parece, porque una generación llega sin metadatos. No hay título, ni etiqueta, ni carpeta. Solo dos artefactos la describen: el propio activo y el prompt que la produjo. OpenArt indexa ambos, porque cada uno contiene algo que el otro no — el prompt guarda lo que el creador pidió, en nombres, intención y palabras de estilo, y el activo guarda lo que el modelo realmente produjo, que con frecuencia no es lo mismo. Buscar solo en uno de ellos pierde la mitad de la biblioteca.
OpenArt divide el trabajo entre tres servicios.
- Su aplicación y base de datos principal se ejecutan en Google Cloud.
- Su servicio de embeddings se ejecuta en Modal — un modelo Jina CLIP que el equipo aloja en una función sin servidor con GPU.
- El almacenamiento y la recuperación de vectores van a Zilliz Cloud. El equipo mantiene la capa de modelos bajo su propio control y entrega la capa que debe escalar.
La generación de imágenes y videos con IA se crea continuamente y se busca mucho después, por lo que OpenArt construyó el sistema como dos mitades independientes que se ejecutan en momentos y ritmos completamente diferentes.
- La ruta de escritura convierte cada nueva generación en vectores y los deposita en Zilliz Cloud. Se ejecuta constantemente en segundo plano, activada por eventos de creación, y nadie la está esperando.
- La ruta de lectura se ejecuta solo cuando un creador escribe en el cuadro de búsqueda. Debe responder en unos pocos cientos de milisegundos, porque alguien está mirando un indicador de carga.
El lado de escritura nunca está en la ruta de consulta — el único lugar donde se encuentran es la propia colección. Esa separación es la razón por la que la ingesta continua nunca aparece como latencia de consulta.
La ruta de escritura: cómo OpenArt convierte una generación en dos vectores
- Un creador en un plan elegible genera una imagen o un clip, y OpenArt escribe una instantánea del mismo en su base de datos principal en Google Cloud.
- Una Cloud Function de Google Cloud se activa con ese evento y llama al servicio de embedding de OpenArt en Modal. Dado que Jina CLIP mapea imágenes y texto en el mismo espacio vectorial, un solo modelo proporciona al equipo ambos vectores que necesita.
- OpenArt escribe esos dos vectores en Zilliz Cloud — uno para el activo generado, otro para el prompt detrás de él — junto con el ID de generación y los campos escalares por los que la ruta de lectura filtrará: ID de usuario e ID de proyecto.
OpenArt maneja el video a través de la misma ruta, capturando un fotograma de instantánea de cada clip generado y aplicándole embedding como imagen, de modo que los clips se pueden recuperar junto con las imágenes fijas sin necesidad de un segundo pipeline.
Además, la búsqueda es una función de pago, por lo que todo el catálogo anterior de un creador elegible debe volverse buscable, no solo lo que creen a partir de ese día. Un trabajo de backfill programado se ejecuta continuamente en segundo plano, barriendo a los creadores en planes elegibles y paginando el historial de cada uno a través de la misma ruta de embedding y escritura. También actúa como red de seguridad del pipeline: cualquier cosa que la ruta en tiempo real no logre escribir, el backfill la recoge en una pasada posterior.
La ruta de lectura: cómo OpenArt responde a una búsqueda
- Un creador escribe una consulta, y OpenArt la envía al mismo modelo alojado en Modal para convertirla en un vector de consulta.
- OpenArt emite una única búsqueda multi-vector a Zilliz Cloud en ambos campos vectoriales, con pesos configurados entre ellos, y adjunta los filtros de usuario y proyecto.
- Zilliz Cloud fusiona los dos conjuntos de resultados, evalúa los filtros dentro de la búsqueda en lugar de después, y devuelve el top K. OpenArt ejecuta una coincidencia y un filtro finales contra su propia base de datos en Google Cloud antes de renderizar.
OpenArt solicita más de mil resultados por consulta — un top K inusualmente grande para búsqueda semántica, impulsado por la carga de trabajo y no por la interfaz: para un creador intensivo, los activos de un solo proyecto ya superan el millar, y una consulta amplia como "man" coincide legítimamente con varias veces esa cantidad.
La misma consulta en el stack anterior no se parecía en nada a esto. Se expandía a través de cada índice que la política de ciclo de vida había creado, la mayoría congelados, y traía datos a través de la red hasta que podía clasificar un top K. En Zilliz Cloud, OpenArt hace una sola llamada a una colección y obtiene una respuesta en aproximadamente 300 milisegundos.
Cómo OpenArt redujo dos búsquedas a una
Combinar los resultados de imagen y prompt es exactamente para lo que OpenArt había construido manualmente la capa de fusión dual-kNN en Elasticsearch. Debido a que Zilliz Cloud consulta de forma nativa múltiples campos vectoriales, el equipo eliminó ese código y reformuló la recuperación como una sola solicitud — luego envolvió la ponderación entre los dos campos en un feature flag. La relevancia se convirtió en algo que OpenArt ajusta en producción, no en algo que reimplementa.
Cómo migró OpenArt
OpenArt movió un conjunto heredado de aproximadamente 456 millones de vectores y aprovechó el cambio para aplicar higiene de datos sobre él: eliminando registros que el producto ya no necesitaba y corrigiendo errores que la ruta de ingesta anterior había estado introduciendo silenciosamente. Una decisión de alcance mantuvo acotado el proyecto: el equipo conservó su modelo de embedding existente. Re-aplicar embedding a cientos de millones de activos habría convertido una migración en una reconstrucción. Debido a que Zilliz Cloud almacena vectores de cualquier modelo que el cliente elija, OpenArt movió el almacenamiento y la recuperación sin tocar la capa de modelos.
Resultados y beneficios
- La latencia de búsqueda cayó de 25 segundos con Elasticsearch a aproximadamente 300 milisegundos en P99 — unas 80 veces más rápida, y la diferencia entre un buscador que los creadores evitan y uno que usan.
- El costo de cómputo se redujo aproximadamente un 85% — la misma carga de trabajo, en un motor construido para ella.
- OpenArt eliminó el algoritmo de fusión construido a mano del pipeline de producción. Con la búsqueda multi-vector nativa en Zilliz Cloud, el código de doble kNN y su pegamento de terceros han desaparecido, y ajustar la relevancia es un cambio de configuración, no un proyecto de ingeniería.
- 456 millones de vectores se trasladaron a Zilliz Cloud sin volver a ejecutar un solo embedding porque Zilliz Cloud es independiente del modelo — lo que convierte la migración en una migración, no en una reconstrucción.
El beneficio estratégico es el que OpenArt siente más: la búsqueda dejó de ser un proyecto de infraestructura. La capacidad de ingeniería que se había dedicado a mantener la recuperación con vida volvió al producto — específicamente, a la capa de agente en torno a la cual OpenArt está construyendo ahora toda su experiencia.
Consejos de OpenArt para equipos que eligen una base de datos vectorial
Habiendo hecho esto dos veces — primero saliendo de Milvus autoalojado, luego de Elasticsearch — el equipo de OpenArt destila la decisión en una lista breve.
- Comprueba que el modelo de precios coincida con la forma de tu carga de trabajo. Pregunta por qué te cobran y luego pregunta cuál de tus números crece más rápido. Si son el mismo número, tienes un problema que escala con tu éxito.
- Comprueba que la arquitectura coincida con tu patrón de acceso. Lee el diseño de almacenamiento, no la lista de funciones. Una política que envejece los datos fuera del alcance está bien para registros y es incorrecta para la búsqueda vectorial.
- Conoce tus propios requisitos de rendimiento antes de aprovisionar. El mayor error de costos de OpenArt fue aprovisionar hardware en exceso para una carga de trabajo que no había perfilado. Mide primero.
- Trata una migración como una oportunidad para desechar cosas. Todo lo que trasladas, lo pagas y lo buscas para siempre.
Lo que viene
OpenArt utiliza Zilliz Cloud hoy para la búsqueda en el historial de generación propio de un creador, y planea extenderlo en tres direcciones:
- La biblioteca compartida de activos y plantillas, donde tanto el trabajo de etiquetado del equipo como las plantillas de recomendación necesitan búsqueda semántica.
- El filtrado escalar, diferido durante la migración y ahora subiendo de nuevo en la lista.
- La memoria del agente, que es lo que más interesa al equipo. A medida que OpenArt pasa de herramientas discretas a un agente que las orquesta — alargando una generación de 15 segundos a una película de uno o tres minutos — el agente tiene que recordar entre sesiones en qué proyecto está un creador y para qué marca está haciendo anuncios. Eso es un problema de búsqueda vectorial, y es donde OpenArt espera que su uso de Zilliz Cloud crezca a continuación.
"OpenArt está definiendo cómo se ve la creación nativa de IA: millones de creadores construyendo personajes e historias que se mantienen coherentes entre escenas. Estamos orgullosos de que Zilliz Cloud sea la base de recuperación detrás de eso, y emocionados de seguir construyendo con ellos a medida que sus agentes comiencen a recordar." — James Luan, CTO, Zilliz
Prueba Zilliz Cloud gratis
Zilliz Cloud es una base de datos vectorial y un Vector Lakebase totalmente gestionados para IA empresarial, compatible con las APIs de Milvus. Ofrece búsqueda vectorial de alto rendimiento a escala masiva con seguridad de grado empresarial y operaciones sin mantenimiento, extendida con la apertura, escalabilidad y economía de los data lakes multimodales — una plataforma única para buscar, analizar y gobernar datos no estructurados para IA de producción.
Ya sea que estés construyendo búsqueda multimodal, RAG o memoria de agente, Zilliz Cloud proporciona la misma base de recuperación que impulsa a OpenArt. Comienza gratis con Zilliz Cloud, o habla con nuestro equipo.
"Nuestra búsqueda anterior tardaba 25 segundos en P99. Eso era inaceptable. Zilliz Cloud la redujo a menos de un tercio de segundo y nos permitió eliminar el código de recuperación que habíamos estado manteniendo nosotros mismos."
Danny Xiong