Aclarando malentendidos sobre la velocidad de inserción de datos en Milvus
Muchos usuarios que dependen de LangChain o LlamaIndex por sus pasos de API convenientes y más cortos podrían pensar que "Insertar datos en Milvus es lento." Sin embargo, esta percepción a menudo surge de pasar por alto los pasos detallados del proceso.
Los pasos ocultos
Al usar LangChain o LlamaIndex, estas bibliotecas convierten datos no estructurados (como textos, imágenes o sonidos) en vectores mediante modelos de embeddings. Luego insertan estos vectores en Milvus Lite. Las bibliotecas simplifican este proceso complejo al encargarse de múltiples pasos entre bastidores por ti.
Esta abstracción puede crear la ilusión de que el proceso de inserción de datos tarda mucho tiempo.
El devorador de tiempo: generación de embeddings
El tiempo promedio dedicado a generar embeddings a partir de datos no estructurados es significativamente mayor que el tiempo requerido para insertar datos en Milvus. La lentitud percibida a menudo se debe al proceso computacionalmente intensivo de transformar los datos en representaciones vectoriales, más que al paso de inserción de datos.
Para ilustrar la diferencia entre los tiempos de generación de embeddings y de inserción de datos, mostraré un ejemplo en este blog donde el tiempo promedio de embedding es de aproximadamente 5 segundos. En contraste, el tiempo promedio de inserción en la base de datos vectorial Milvus es de solo alrededor de una décima de segundo. El código completo está en mi GitHub.
En otras palabras, alrededor del 97% del tiempo de "inserción en Milvus" observado en LangChain o LlamaIndex se dedica a la generación de embeddings, mientras que alrededor del 3% se dedica al paso real de inserción en la base de datos.
Mostré en un blog anterior cómo conectarse a Milvus Lite usando LlamaIndex o LangChain.
En las siguientes secciones, cubriré:
Ejemplo de código de LlamaIndex para insertar datos en Milvus
Ejemplo de código de LangChain para insertar datos en Milvus
Ejemplo de código de la API de Pymilvus para insertar datos en Milvus
Ejemplo de código de LlamaIndex para insertar datos en Milvus
Aquí hay un ejemplo de código en LlamaIndex.
from llama_index.core import (
   ServiceContext,
   StorageContext,
   VectorStoreIndex,
)
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.vector_stores.milvus import MilvusVectorStore
import time

# Define the embedding model.
service_context = ServiceContext.from_defaults(
   # LlamaIndex local: translates to the same location as default HF cache.
   embed_model="local:BAAI/bge-large-en-v1.5",
)

# Create a Milvus collection from the documents and embeddings.
EMBEDDING_DIM = 1024
vectorstore = MilvusVectorStore(
   uri="./milvus_llamaindex.db",
   dim=EMBEDDING_DIM,
   # Override LlamaIndex default values for Milvus.
   consistency_level="Eventually",
   drop_old=True,
   index_params = {
       "metric_type": "COSINE",
       "index_type": "AUTOINDEX",
       "params": {},}
)
storage_context = StorageContext.from_defaults(
   vector_store=vectorstore
)
llamaindex = VectorStoreIndex.from_documents(
   lli_docs[:1],
   storage_context=storage_context,
   service_context=service_context
)
Ejemplo de código de LangChain para insertar datos en Milvus
Aquí hay un ejemplo de código en LangChain.
from langchain_milvus import Milvus
from langchain_huggingface import HuggingFaceEmbeddings
from langchain.text_splitter import RecursiveCharacterTextSplitter
import time

# Define the embedding model.
model_name = "BAAI/bge-large-en-v1.5"
model_kwargs = {'device': 'cpu'}
encode_kwargs = {'normalize_embeddings': True}
embed_model = HuggingFaceEmbeddings(
   model_name=model_name,
   model_kwargs=model_kwargs,
   encode_kwargs=encode_kwargs
)
EMBEDDING_DIM = embed_model.dict()['client'].get_sentence_embedding_dimension()

# Define the chunking strategy.
text_splitter = RecursiveCharacterTextSplitter(chunk_size=512, chunk_overlap=51)

# Create a Milvus collection from the documents with chunking and embeddings.
start_time = time.time()
docs = text_splitter.split_documents(docs)
vectorstore = Milvus.from_documents(
   documents=docs,
   embedding=embed_model,
   connection_args={"uri": "./milvus_demo.db"},
   # Override LangChain default values for Milvus.
   consistency_level="Eventually",
   drop_old=True,
   index_params = {
       "metric_type": "COSINE",
       "index_type": "AUTOINDEX",
       "params": {},}
)

Ejemplo de código de la API de Pymilvus para insertar datos en Milvus
Usando llamadas a la API de Pymilvus directamente, mostremos qué está ocurriendo realmente entre bastidores en esas codificaciones breves y convenientes de LangChain y LlamaIndex.
Los ejemplos anteriores utilizaron páginas web de la documentación de Milvus descargadas directamente de Internet. Para mostrar la diferencia entre los tiempos de embedding y los tiempos de inserción, usaré a continuación un modelo de embedding multimodal de código abierto para 1) embeber tanto imágenes como textos y 2) insertar los vectores densos en Milvus.
import pymilvus
import requests
from io import BytesIO

# Run this in small batches to avoid memory issues.
BATCH_SIZE = 10

# Batch embed text and images and insert data into Milvus.
batch_embedding_times = []
batch_insert_times = []
for i in range(0, 300, BATCH_SIZE):
   batch_images = []
   batch_texts = []
   batch_urls = []
   for j in range(BATCH_SIZE):
       if i + j < len(image_texts):
           text = image_texts[i + j]
           url = image_urls[i + j]
           with Image.open(f"./images/{url}.jpg") as img:
               batch_images.append(img.copy())
               batch_texts.append(text)
               batch_urls.append(url)

   # STEP 1. EMBEDDING INFERENCE FOR TEXT AND IMAGES.
   start_time = time.time()
   image_embeddings, text_embeddings = embedding_model(
       batch_images=batch_images,
       batch_texts=batch_texts)
   end_time = time.time()
   # print(f"Embedding time for batch size {len(batch_images)}: ", end="")
   # print(f"{np.round(end_time - start_time, 2)} seconds")
   batch_embedding_times.append(end_time - start_time)

   # STEP 2. INSERT CHUNK LIST INTO MILVUS OR ZILLIZ.
   chunk_dict_list = []
   # Create chunk dict_list.
   for chunk, img_url, img_embed, text_embed in zip(
       batch_texts,
       batch_urls,
       image_embeddings, text_embeddings):
       chunk_dict = {
           'chunk': chunk,
           'image_filepath': img_url,
           'text_vector': text_embed,
           'image_vector': img_embed
       }
       chunk_dict_list.append(chunk_dict)

   start_time = time.time()
   try:
       col.insert(data=chunk_dict_list)
   except:
       print(f"Insert error: {img_url}")
   end_time = time.time()
   # print(f"Insert time for {len(chunk_dict_list)} vectors: ", end="")
   # print(f"{np.round(end_time - start_time, 4)} seconds")
   batch_insert_times.append(end_time - start_time)
   col.flush()

# Calculate the average embedding time.
average_time = np.mean(batch_embedding_times)
print(f"Average embedding time: {round(average_time,2)} seconds")

# Calculate the average insert time.
average_time = np.mean(batch_insert_times)
print(f"Average insert time: {round(average_time,2)} seconds")
Aquí está la salida de los tiempos de embedding por lotes.
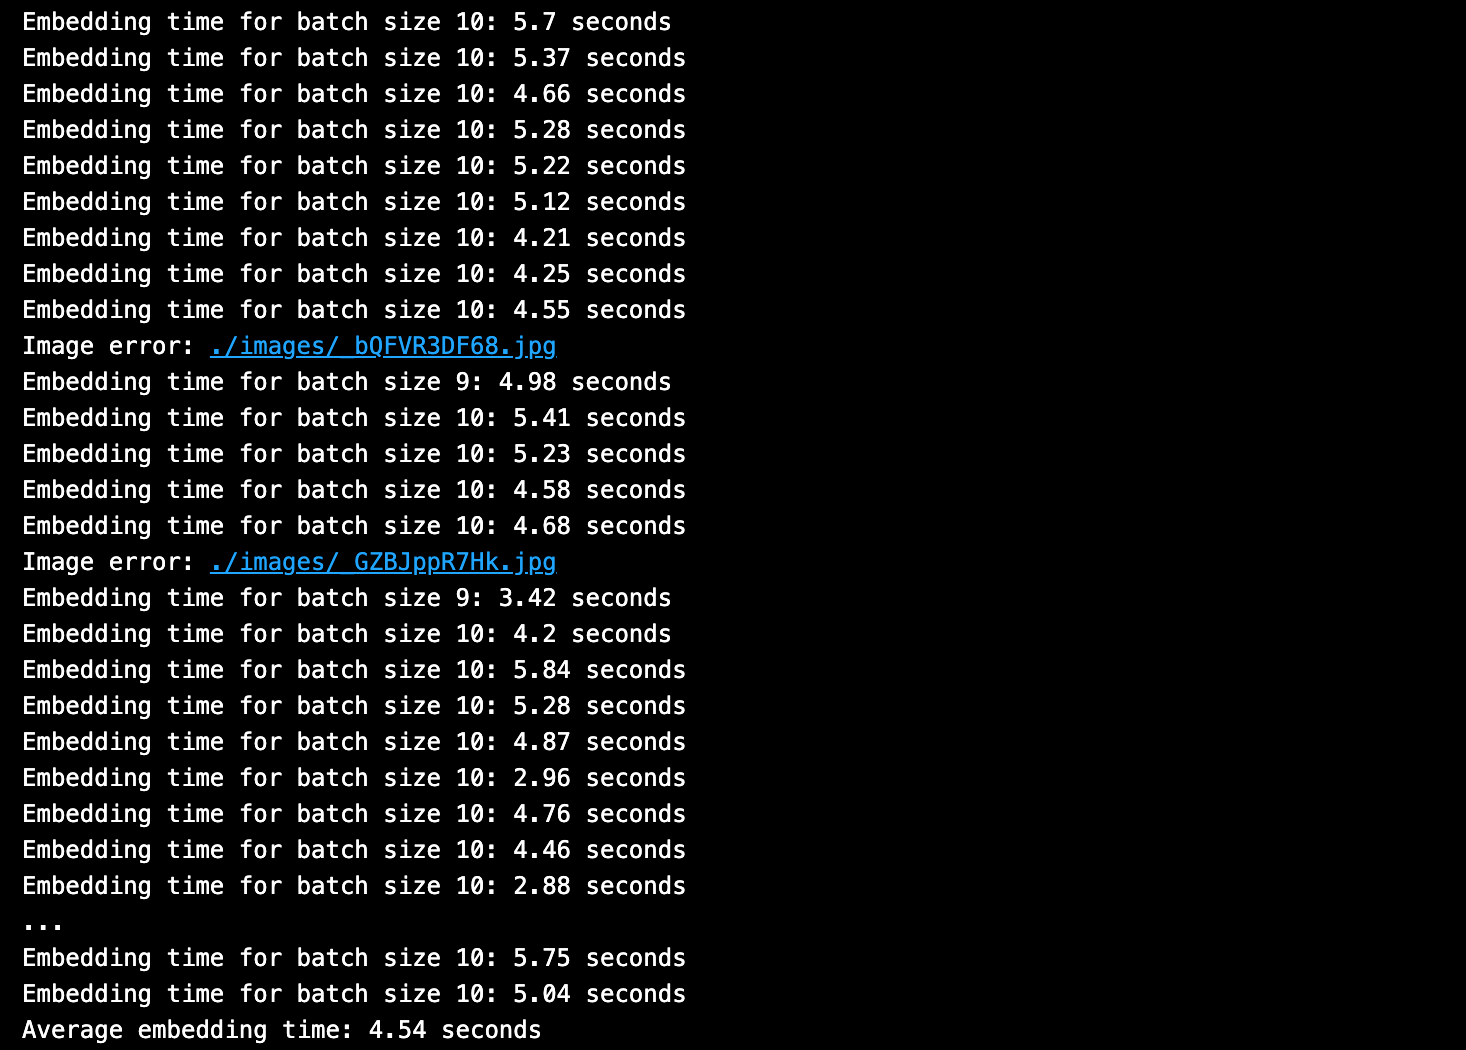
Aquí está la salida de los tiempos de inserción de datos por lotes en Milvus.

El tiempo promedio de embedding fue de ~5 segundos, y el tiempo promedio de inserción en la base de datos vectorial Milvus fue de aproximadamente una décima de segundo. Esto se traduce en aproximadamente el 97% del tiempo total dedicado a realizar la generación de embeddings, mientras que alrededor del 3% se dedicó a la inserción en la base de datos.
Como puedes ver, ¡el paso de embedding es el que más tarda!
Recursos y lecturas adicionales
Sigue leyendo
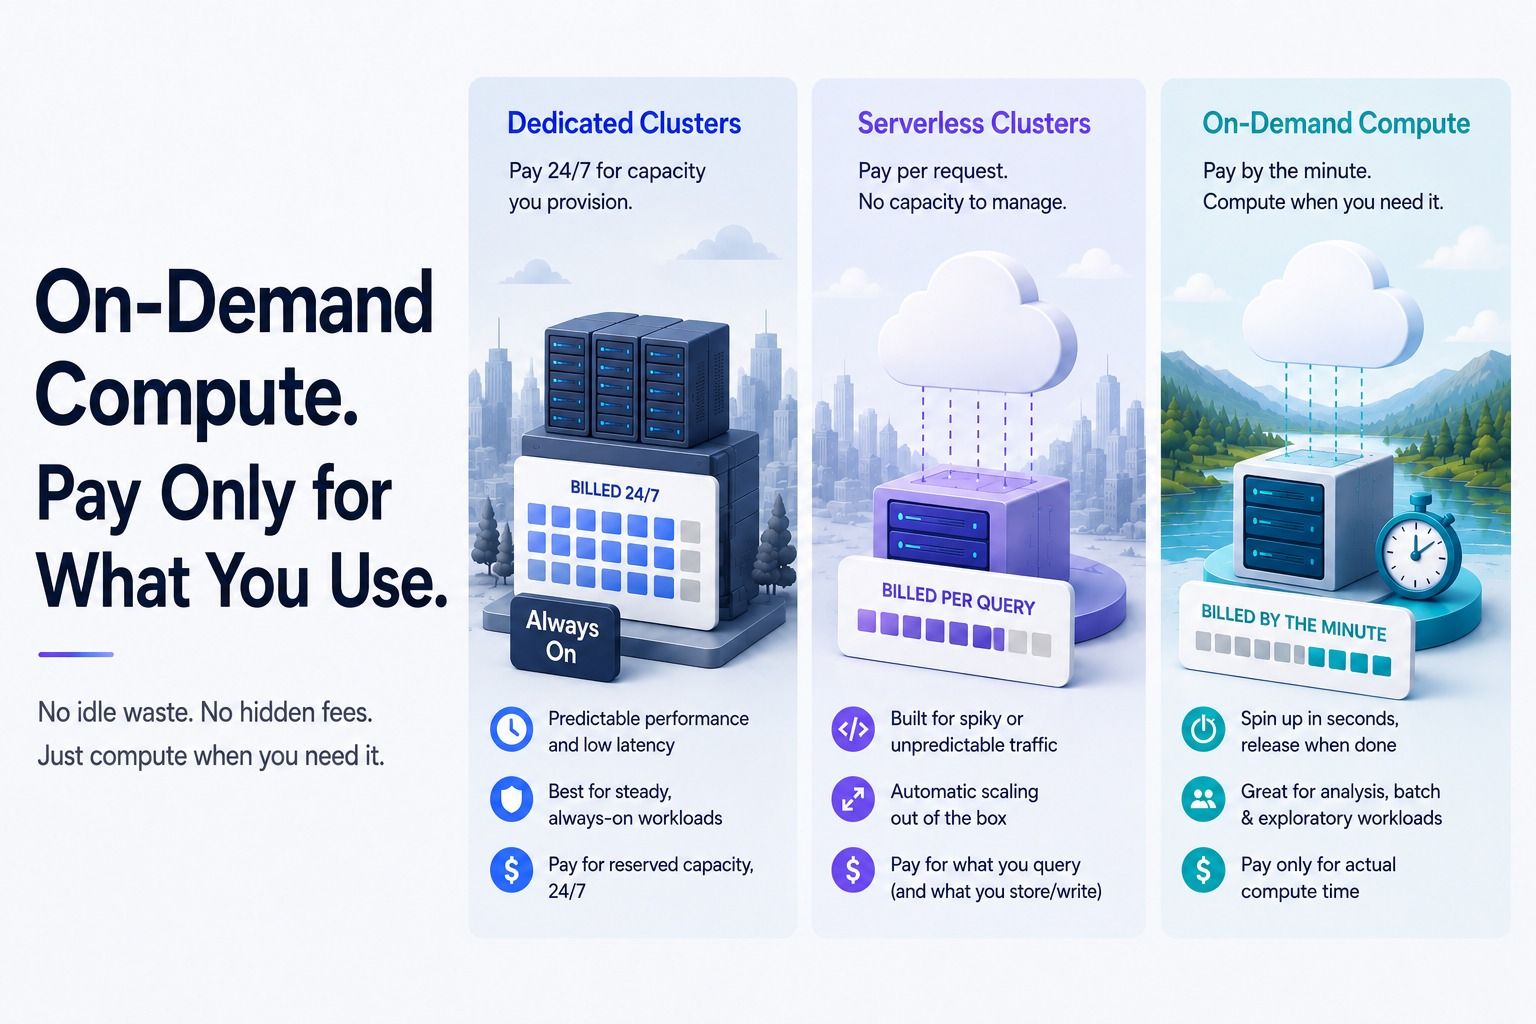
Zilliz Cloud On-Demand Compute: Pay Only for What You Use
The customer case behind Zilliz Cloud On-Demand: how a $10K vector search bill came down to under $500, and the engineering changes that made it possible.
Milvus 2.6.x Now Generally Available on Zilliz Cloud, Making Vector Search Faster, Smarter, and More Cost-Efficient for Production AI
Milvus 2.6.x is now GA on Zilliz Cloud, delivering faster vector search, smarter hybrid queries, and lower costs for production RAG and AI applications.
Announcing the General Availability of Zilliz Cloud BYOC on Google Cloud Platform
Zilliz Cloud BYOC on GCP offers enterprise vector search with full data sovereignty and seamless integration.