OpenArt Potencializa a Busca Multimodal para 8M+ Criadores de Vídeo com IA usando o Zilliz Cloud
25 s → 300 ms
Latência de busca P99, ES → Zilliz
~85% menor
Calcular custo após migração
Pesquisa multivetorial nativa
Vetores de imagem e texto consultados juntos
456M
Vetores migrados sem re-embedding
"Criadores não fazem uma imagem e vão embora. Eles constroem um personagem, um mundo, uma história, e tudo o que já geraram se torna material para a próxima cena. O Zilliz Cloud nos permite tratar toda essa biblioteca como uma memória criativa."
John Qiao
Sobre a OpenArt
A OpenArt é uma das plataformas de geração de imagens e vídeos com IA mais usadas do mundo, com mais de 8 milhões de criadores — hobistas, profissionais de marketing e profissionais de entretenimento em atividade. Ela coloca mais de 100 modelos do Google, OpenAI, Seedance e outros em um único canvas, mas os modelos são a parte comoditizada. O que a OpenArt constrói por cima deles é continuidade: um Character Builder que mantém um personagem entre cenas, One-Click Story para narrativas de múltiplas cenas e uma suíte de storyboard que os criadores usam para fazer trailers, anúncios e vídeos para redes sociais. A ambição por trás de tudo isso é colocar IP nativo de IA ao alcance de qualquer criador — personagens e mundos que persistem e crescem, em vez de imagens que não persistem.
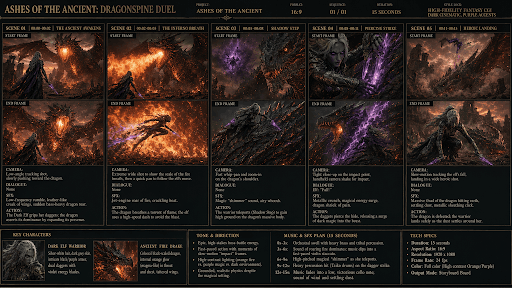
Continuidade é a parte difícil, e não apenas no momento da geração. O desafio no vídeo com IA não é produzir quinze bons segundos — é produzir os próximos quinze e fazer com que eles pertençam à mesma história. Isso também tem uma consequência a jusante: os criadores voltam a um mundo por meses, e tudo o que já geraram se torna material de referência para a próxima cena. O próprio catálogo histórico de um criador precisa ser encontrável pelo significado, e não por nome de arquivo ou data, e é aí que a OpenArt utiliza a Zilliz Cloud.
O Desafio
A busca de criadores da OpenArt era executada na busca vetorial do Elasticsearch. Ela aguentou enquanto o acervo era pequeno. Quando o histórico de geração ultrapassou algumas centenas de milhões de vetores, quatro coisas haviam quebrado.
- A latência de busca P99 chegou a 25 segundos. O gerenciamento do ciclo de vida de índices do Elasticsearch é feito para dados de log, então ele alternava os índices da OpenArt de hot para warm para cold para frozen aproximadamente a cada 90 dias, e a maior parte do corpus acabava congelada — mas a busca vetorial tem o padrão de acesso oposto, porque classificar um top K significa pontuar tudo. Cada busca acessava a camada congelada e trazia dados de volta pela rede para respondê-la.
- O número de índices crescia exponencialmente. O Elasticsearch criava pelo menos um novo índice a cada 90 dias e nunca os mesclava, então o número de índices pelos quais uma consulta precisava se espalhar continuava se multiplicando. Em um acervo que só cresce, a equipe projetou que a busca se degradaria drasticamente em cerca de dois anos.
- A OpenArt estava pagando por uma plataforma de busca inteira para usar um recurso limitado dela. Além disso, o cluster estava superdimensionado porque a equipe o dimensionou antes de medir as necessidades reais da carga de trabalho.
- A recuperação multivetorial teve que ser construída manualmente. O Elasticsearch não tinha uma forma nativa de consultar um vetor de imagem e um vetor de texto juntos, então a OpenArt teve que escrever seu próprio algoritmo de kNN duplo e integrar componentes de terceiros para executar as duas buscas, fundir os resultados e filtrá-los — um item de manutenção permanente sobre um recurso que não é o diferencial da OpenArt.
Por que a Zilliz Cloud
A equipe de engenharia da OpenArt avaliou a Pinecone e a Qdrant, e nenhuma era a opção certa. A equipe também havia executado o próprio Milvus nos primeiros dias da empresa e gostado; o que o descartou na época foi a carga operacional do self-hosting. A Zilliz Cloud removeu essa objeção: ela é construída pela mesma equipe por trás do Milvus de código aberto e é 100% compatível com as APIs do Milvus, então o conhecimento existente e o código de cliente da equipe foram aproveitados. Benchmarks com os dados da própria OpenArt confirmaram o desempenho, e a avaliação parou por aí. Quatro coisas fazem a Zilliz Cloud se destacar:
Uma arquitetura construída para a forma como a busca vetorial lê dados. O Zilliz Cloud gerencia as camadas de dados por conta própria com base na temperatura dos dados: ele promove dados para o cache quando são frequentemente recuperados ou os rebaixa para armazenamento frio quando não são necessários, sem que a aplicação precise lidar com políticas de ciclo de vida, e a compactação automática em nível de segmento mescla dados em segundo plano conforme eles crescem. Essas duas capacidades atacam exatamente os modos de falha com os quais a OpenArt convivia — varredura de camada congelada e proliferação ilimitada de índices —, então a busca da OpenArt não fica mais lenta à medida que o acervo cresce.
Busca multivetorial nativa. Uma única coleção no Zilliz Cloud armazena múltiplos campos vetoriais e os consulta em conjunto em uma única requisição, fundindo os resultados por uma ponderação configurável. Essa é precisamente a capacidade que a OpenArt vinha construindo manualmente sobre o Elasticsearch, e obtê-la de forma nativa foi o que permitiu ao time eliminar seu próprio código.
Precificação atrelada à computação sob demanda, não aos dados armazenados. Uma das alternativas cobrava com base no volume de dados — o eixo errado para um arquivo criativo, onde o corpus cresce para sempre, mas apenas uma fração é consultada a cada momento. O modelo do Zilliz Cloud baseado em computação sob demanda permite que a OpenArt dimensione a infraestrutura para o desempenho que precisa e a redimensione conforme a carga muda, em vez de pagar um imposto sobre o histórico.
Operável sem um especialista em infraestrutura. Um serviço gerenciado ainda precisa ser utilizável no dia a dia pelas pessoas que o adotam. A OpenArt achou o console claro o suficiente para navegar por intuição, sem precisar ler documentação — um contraste nítido com uma plataforma de busca de propósito geral que carrega uma década de recursos acumulados que eles nunca usariam.
"Atendemos milhões de criadores, então cada peça de infraestrutura precisa ser rápida, previsível e não exigir que ninguém fique monitorando. O Zilliz Cloud é um dos poucos que superou essa barreira na primeira tentativa." — Danny Xiong, Engenheiro de Software, OpenArt
A Solução: Como o Zilliz Cloud Potencializa a OpenArt
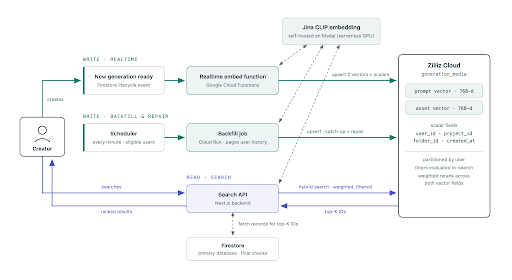
A OpenArt usa o Zilliz Cloud para executar a busca vetorial por trás da caixa de pesquisa sobre o histórico de gerações do próprio criador, disponível para assinantes de planos qualificados. Um criador que fez milhares de imagens e clipes ao longo de meses digita uma frase — um nome de personagem, um clima, uma cena — e recebe de volta seus próprios trabalhos passados, classificados por significado em vez de nome de arquivo ou data.
Essa tarefa é mais difícil do que parece, porque uma geração chega sem metadados. Não há título, nem tag, nem pasta. Apenas dois artefatos a descrevem: o ativo em si e o prompt que o produziu. A OpenArt indexa ambos, porque cada um carrega algo que o outro não tem — o prompt guarda o que o criador pediu, em nomes, intenções e palavras de estilo, e o ativo guarda o que o modelo realmente produziu, que frequentemente não é a mesma coisa. Buscar apenas um deles perde metade do acervo.
A OpenArt divide o trabalho entre três serviços.
- Sua aplicação e banco de dados principal rodam no Google Cloud.
- Seu serviço de embeddings roda na Modal — um modelo Jina CLIP que o time hospeda em uma função GPU serverless.
- O armazenamento e a recuperação vetorial ficam no Zilliz Cloud. O time mantém a camada de modelo sob seu próprio controle e entrega a camada que precisa escalar.
A geração de imagens e vídeos por IA é criada continuamente e pesquisada muito tempo depois, então a OpenArt construiu o sistema como duas metades independentes que operam em tempos e ritmos completamente diferentes.
- O caminho de escrita transforma cada nova geração em vetores e os deposita no Zilliz Cloud. Ele roda constantemente em segundo plano, acionado por eventos de criação, e ninguém fica esperando por ele.
- O caminho de leitura roda apenas quando um criador digita na caixa de pesquisa. Ele precisa responder em algumas centenas de milissegundos, porque alguém está olhando para um spinner.
O lado de escrita nunca fica no caminho da consulta — o único lugar onde eles se encontram é a própria coleção. Essa separação é o motivo pelo qual a ingestão contínua nunca aparece como latência de consulta.
O caminho de escrita: como a OpenArt transforma uma geração em dois vetores
- Um criador em um plano elegível gera uma imagem ou um clipe, e a OpenArt grava um snapshot disso em seu banco de dados primário no Google Cloud.
- Uma Google Cloud Function é acionada nesse evento e chama o serviço de embedding da OpenArt no Modal. Como o Jina CLIP mapeia imagens e textos para o mesmo espaço vetorial, um único modelo fornece à equipe os dois vetores de que precisa.
- A OpenArt grava esses dois vetores no Zilliz Cloud — um para o ativo gerado, um para o prompt por trás dele — juntamente com o ID de geração e os campos escalares que o caminho de leitura usará para filtrar: ID do usuário e ID do projeto.
A OpenArt lida com vídeo pelo mesmo caminho, capturando um quadro de snapshot de cada clipe gerado e incorporando-o como imagem, para que os clipes possam ser recuperados junto com as imagens estáticas sem um segundo pipeline.
Além disso, a busca é um recurso pago, então todo o catálogo anterior de um criador elegível precisa se tornar pesquisável, não apenas o que eles criarem a partir daquele dia. Um job de backfill agendado é executado continuamente em segundo plano, varrendo criadores em planos elegíveis e percorrendo o histórico de cada um pela mesma rota de incorporação e gravação. Ele também serve como a rede de segurança do pipeline: qualquer coisa que o caminho em tempo real não conseguir gravar, o backfill captura em uma passagem posterior.
O caminho de leitura: como a OpenArt responde a uma busca
- Um criador digita uma consulta, e a OpenArt a envia para o mesmo modelo hospedado no Modal para ser transformada em um vetor de consulta.
- A OpenArt emite uma única busca multivetorial para o Zilliz Cloud em ambos os campos vetoriais, com pesos configurados entre eles, e os filtros de usuário e projeto anexados.
- O Zilliz Cloud funde os dois conjuntos de resultados, avalia os filtros dentro da busca em vez de depois dela e retorna o top K. A OpenArt executa uma correspondência e filtro finais contra seu próprio banco de dados no Google Cloud antes da renderização.
A OpenArt solicita mais de mil resultados por consulta — um top K excepcionalmente grande para busca semântica, impulsionado pela carga de trabalho em vez da interface: para um criador intenso, os ativos de um único projeto já ultrapassam mil, e uma consulta ampla como "man" legitima correspondências várias vezes mais.
A mesma consulta na stack antiga não se parecia em nada com isso. Ela se espalhava por todos os índices que a política de ciclo de vida já havia criado, a maioria deles congelados, e puxava dados de volta pela rede até conseguir classificar um top K. No Zilliz Cloud, a OpenArt faz uma única chamada para uma única collection e tem uma resposta em aproximadamente 300 milissegundos.
Como a OpenArt reduziu duas buscas a uma
Combinar os resultados de imagem e prompt é exatamente para o que a OpenArt havia construído manualmente a camada de fusão dual-kNN no Elasticsearch. Como o Zilliz Cloud consulta nativamente vários campos vetoriais, a equipe removeu esse código e reexpressou a recuperação como uma única solicitação — e depois envolveu a ponderação entre os dois campos em um feature flag. A relevância se tornou algo que a OpenArt ajusta em produção, em vez de algo que ela reimplementa.
Como a OpenArt migrou
A OpenArt migrou um conjunto legado de aproximadamente 456 milhões de vetores e usou a transição para realizar uma higienização de dados: removendo registros que o produto não precisava mais e corrigindo bugs que o antigo caminho de ingestão vinha introduzindo silenciosamente. Uma decisão de escopo manteve o projeto delimitado: a equipe manteve seu modelo de embedding existente. Refazer o embedding de centenas de milhões de ativos teria transformado uma migração em uma reconstrução. Como o Zilliz Cloud armazena vetores de qualquer modelo que o cliente escolha, a OpenArt moveu armazenamento e recuperação sem tocar na camada de modelo.
Resultados e Benefícios
- A latência de busca caiu de 25 segundos usando Elasticsearch para aproximadamente 300 milissegundos no P99 — cerca de 80× mais rápida, e a diferença entre uma caixa de busca que os criadores evitam e uma que eles usam.
- Custo de computação reduzido em cerca de 85% — a mesma carga de trabalho, em um mecanismo feito para ela.
- A OpenArt removeu o algoritmo de fusão construído manualmente do pipeline de produção. Com a busca multi-vetorial nativa no Zilliz Cloud, o código de kNN duplo e sua cola de terceiros desapareceram, e ajustar a relevância é uma mudança de configuração em vez de um projeto de engenharia.
- 456 milhões de vetores foram movidos para o Zilliz Cloud sem reexecutar um único embedding porque o Zilliz Cloud é agnóstico em relação a modelos — mantendo a migração como uma migração, não uma reconstrução.
O retorno estratégico é o que a OpenArt mais sente: a busca deixou de ser um projeto de infraestrutura. A capacidade de engenharia que era dedicada a manter a recuperação funcionando voltou para o produto — especificamente, para a camada de agente em torno da qual a OpenArt está construindo toda a sua experiência agora.
Conselhos da OpenArt para equipes escolhendo um banco de dados vetorial
Tendo feito isso duas vezes — saindo do Milvus auto-hospedado no início, depois do Elasticsearch — a equipe da OpenArt resume a decisão a uma lista curta.
- Verifique se o modelo de preços corresponde ao formato da sua carga de trabalho. Pergunte pelo que você é cobrado e, em seguida, pergunte qual dos seus números cresce mais rápido. Se forem o mesmo número, você tem um problema que cresce junto com seu sucesso.
- Verifique se a arquitetura corresponde ao seu padrão de acesso. Leia o design de armazenamento, não a lista de recursos. Uma política que envelhece os dados até ficarem fora de alcance é boa para logs e errada para busca vetorial.
- Conheça seus próprios requisitos de desempenho antes de provisionar. O maior erro de custo da OpenArt foi provisionar hardware em excesso para uma carga de trabalho que não havia sido perfilada. Meça primeiro.
- Trate a migração como uma oportunidade de jogar coisas fora. Tudo o que você carrega, você paga e pesquisa para sempre.
O que vem a seguir
Hoje a OpenArt usa o Zilliz Cloud para busca no histórico de gerações de um criador e planeja estendê-lo em três direções:
- A biblioteca compartilhada de ativos e templates, onde o trabalho de rotulagem da equipe e os templates de recomendação precisam de busca semântica.
- Filtragem escalar, adiada durante a migração e agora voltando ao topo da lista.
- Memória do agente, que é o que mais interessa à equipe. À medida que a OpenArt passa de ferramentas discretas para um agente que as orquestra — estendendo uma geração de 15 segundos para um filme de um a três minutos — o agente precisa lembrar entre sessões em qual projeto um criador está e para qual marca ele está fazendo anúncios. Esse é um problema de busca vetorial, e é onde a OpenArt espera que seu uso do Zilliz Cloud cresça em seguida.
"A OpenArt está definindo como é a criação nativa de IA: milhões de criadores construindo personagens e histórias que se sustentam em todas as cenas. Temos orgulho de que o Zilliz Cloud é a base de recuperação por trás disso e estamos animados em continuar construindo com eles à medida que seus agentes começam a lembrar." — James Luan, CTO, Zilliz
Experimente o Zilliz Cloud gratuitamente
O Zilliz Cloud é um Vector Database e Vector Lakebase totalmente gerenciado para IA empresarial, compatível com as APIs do Milvus. Ele oferece busca vetorial de alto desempenho em escala massiva com segurança de nível empresarial e operações sem manutenção, estendido com a abertura, escalabilidade e economia de data lakes multimodais — uma plataforma única para pesquisar, analisar e governar dados não estruturados para IA em produção.
Quer você esteja construindo busca multimodal, RAG ou memória de agente, o Zilliz Cloud fornece a mesma base de recuperação que potencializa a OpenArt. Comece gratuitamente com o Zilliz Cloud ou fale com nossa equipe.
"Nossa busca antiga levava 25 segundos no P99. Isso era inaceitável. O Zilliz Cloud reduziu para menos de um terço de segundo e nos permitiu excluir o código de recuperação que mantínhamos por conta própria."
Danny Xiong