O que há de novo no Milvus 2.3.2 e 2.3.3
Apresentando as versões 2.3.2 e 2.3.3 do Milvus! Estes lançamentos mais recentes trazem uma série de melhorias destinadas a aprimorar o desempenho e a experiência do usuário do nosso sistema de banco de dados vetorial. Consideramos cuidadosamente o feedback da nossa comunidade de desenvolvedores para fazer essas atualizações.
📦 PyPI: https://pypi.org/project/milvus/
📚 Docs: https://milvus.io/docs
🛠️ Notas de lançamento:
🐳 Imagem Docker: docker pull
🚀 Lançamento: milvus-2.3.3
Principais destaques:
Novos recursos
🔍 Suporte a Tipos de Dados Array - O Milvus agora oferece suporte a tipos de dados Array, permitindo filtragem precisa de metadados. Por exemplo, no e-commerce, isso possibilita pesquisas avançadas com base em várias tags de produtos, garantindo que os resultados da busca sejam altamente relevantes para as consultas dos usuários.
🧹 Suporte a Expressões de Exclusão Complexas - Com o Milvus 2.3.2 ou 2.3.3, os desenvolvedores podem especificar critérios detalhados para remoção de dados, possibilitando limpeza precisa, como rotação de dados antigos ou exclusão orientada por conformidade com o GDPR com base em IDs de usuário. Observe que a exclusão não é atômica; use-a com cautela para um gerenciamento preciso de dados.
🗂️ Integração com TiKV para Armazenamento de Metadados - Ao integrar o TiKV para armazenamento de metadados, o Milvus obtém maior escalabilidade e estabilidade. A arquitetura do TiKV foi projetada para lidar com armazenamento de metadados em larga escala de forma eficiente, garantindo que o Milvus possa escalar para atender às demandas de conjuntos de dados crescentes sem sacrificar a estabilidade.
🌀 Suporte ao Tipo de Vetor FP16 - O suporte do Milvus ao tipo de vetor FP16 melhora a eficiência do aprendizado de máquina. Esse formato de dados é amplamente usado em aprendizado profundo e ML por sua capacidade de representar e processar valores numéricos com mais eficiência, resultando em operações de aprendizado de máquina mais rápidas e com uso mais eficiente de recursos.
📊 Suporte a MMAP para Índice Vetorial - Vá além do mapeamento apenas dos dados brutos 2.3.0; agora você também pode mapear o índice. Esse recurso permite armazenar mais dados na mesma máquina e oferece flexibilidade no armazenamento de dados, ao mesmo tempo em que reduz custos.
Aprimoramento
🔄 Experiência de Atualização Contínua - O Milvus fortaleceu seu recurso de atualização contínua nas versões 2.3.2 e 2.3.3, oferecendo uma transição simplificada e eficiente para usuários que atualizam a partir da versão 2.2.15 em menos de 5 minutos.
🚀 Otimização de Desempenho - Minimize operações de cópia de dados para carregamento de dados otimizado, simplifique inserções de grande capacidade usando leitura varchar em lote, remova verificações de offset desnecessárias durante o preenchimento de dados e resolva o alto consumo de CPU em cenários com inserções substanciais de dados.
Além dos aprimoramentos destacados, o Milvus 2.3.2 e 2.3.3 oferecem uma infinidade de novos recursos e melhorias. Isso inclui um CDC (Change Data Capture) atualizado, agora capaz de replicar mensagens MQ (Message Queue), possibilitando sincronização de dados em tempo real. Os desenvolvedores também podem usar a inserção em massa de dados binlog com chaves de partição, simplificando os processos de ingestão de dados. Além disso, essas versões marcam o retorno de tipos de métricas binárias, como SUBSTRUCTURE e SUPERSTRUCTURE, ampliando a gama de opções de representação de dados. Incentivamos os desenvolvedores a visitar nossas notas de lançamento para uma visão geral abrangente de todos os novos recursos e aprimoramentos.
Observações finais
Estamos firmes em nosso compromisso de aprimorar continuamente o Milvus, alinhando-nos às necessidades dinâmicas da nossa comunidade de desenvolvedores. Um sincero agradecimento à nossa vibrante comunidade de desenvolvedores, cujas contribuições, PRs e feedback perspicaz foram fundamentais para moldar o roadmap do Milvus. Estamos ansiosos para ver como estas atualizações se integram perfeitamente aos seus projetos de desenvolvimento e aguardamos seu feedback. Continuem programando, inovando e moldando o futuro da IA! 🤖🧠
Continue lendo
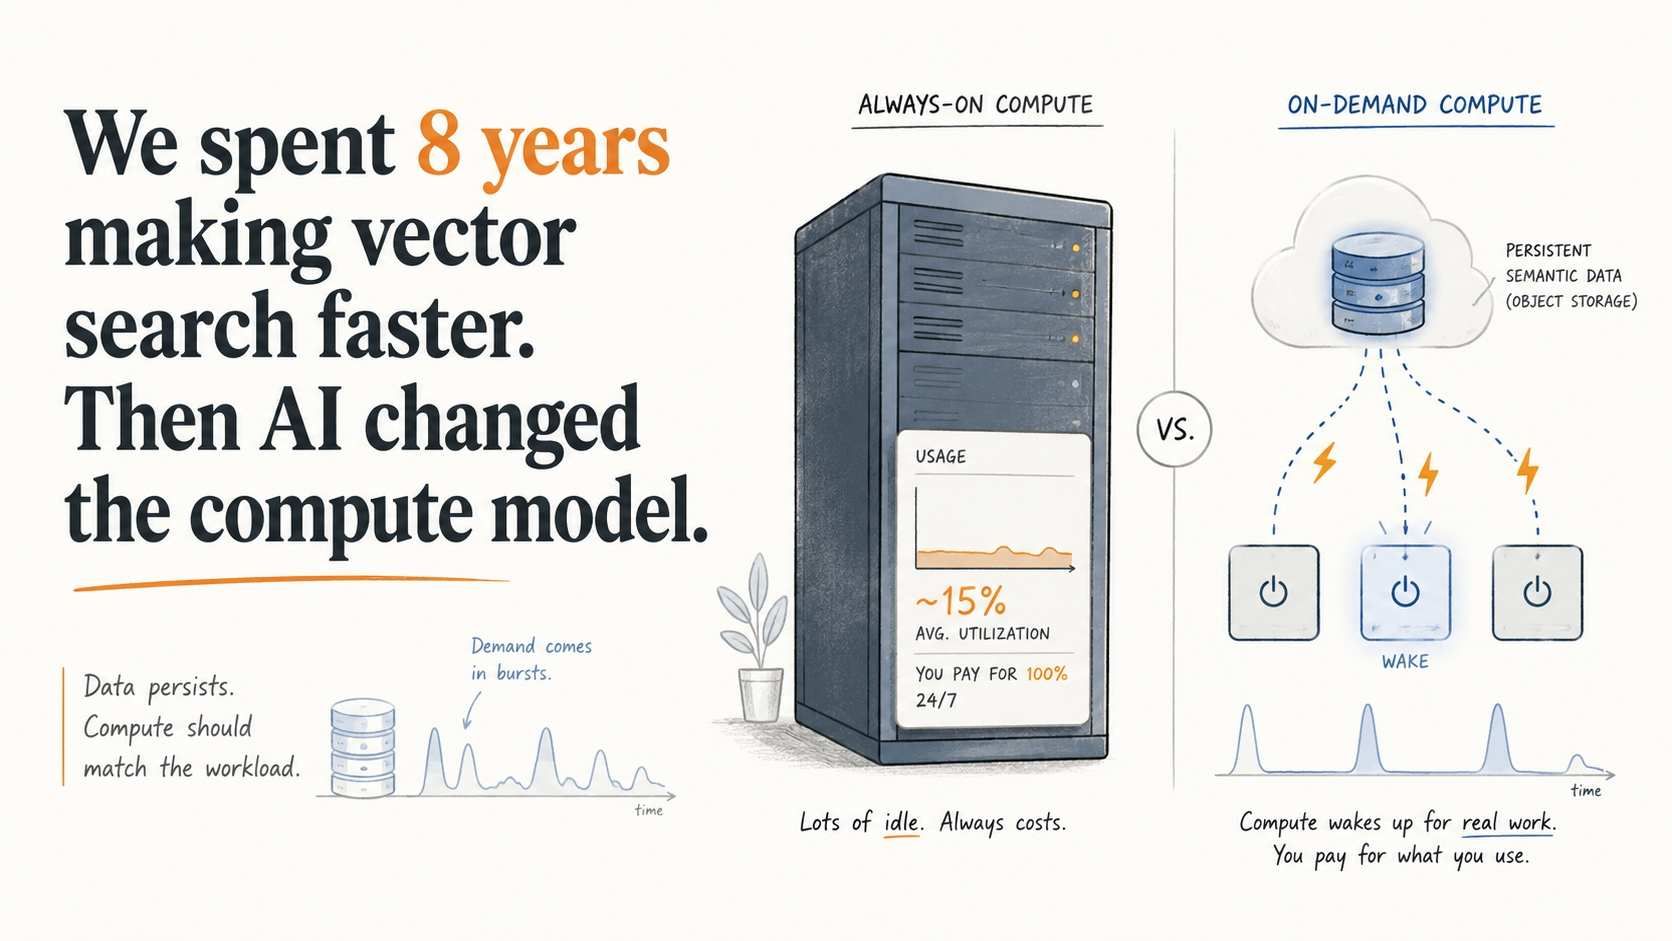
We spent 8 years making vector databases faster. Then we stopped.
Rarely queried embeddings still need to stay searchable. See how Vector Lakebase enables on-demand vector search without always-on compute costs.
Zilliz Cloud BYOC Now Available Across AWS, GCP, and Azure
Zilliz Cloud BYOC is now generally available on all three major clouds. Deploy fully managed vector search in your own AWS, GCP, or Azure account — your data never leaves your VPC.

Data Deduplication at Trillion Scale: How to Solve the Biggest Bottleneck of LLM Training
Explore how MinHash LSH and Milvus handle data deduplication at the trillion-scale level, solving key bottlenecks in LLM training for improved AI model performance.