




Milvus apresentou o MMap para redefinir o gerenciamento de dados e aumentar a capacidade de armazenamento
Milvus é a solução mais rápida entre os bancos de dados vetoriais de código aberto, atendendo a usuários com requisitos intensivos de desempenho. No entanto, a diversidade das necessidades dos usuários reflete os dados com os quais trabalham. Alguns priorizam soluções econômicas e armazenamento amplo em vez de velocidade pura. Compreendendo esse espectro de demandas, o Milvus apresenta o recurso MMap, redefinindo como lidamos com grandes volumes de dados, ao mesmo tempo em que promete eficiência de custos sem sacrificar a funcionalidade.
O que é MMap?
MMap, abreviação de arquivos mapeados em memória, preenche a lacuna entre arquivos e memória nos sistemas operacionais. Essa tecnologia permite que o Milvus mapeie arquivos grandes diretamente no espaço de memória do sistema, transformando arquivos em blocos de memória contíguos. Essa integração elimina a necessidade de operações explícitas de leitura ou gravação, mudando fundamentalmente como o Milvus gerencia dados. Ela garante acesso contínuo e armazenamento eficiente para arquivos grandes ou situações em que os usuários precisam acessar arquivos aleatoriamente.
Quem se beneficia do MMap?
Bancos de dados vetoriais exigem capacidade substancial de memória devido aos requisitos de armazenamento dos dados vetoriais. Com o recurso MMap, processar mais dados dentro de uma memória limitada se torna realidade. No entanto, essa capacidade aumentada vem com um custo de desempenho. O sistema gerencia a memória de forma inteligente, removendo alguns dados com base na carga e no uso. Essa remoção permite que o Milvus processe mais dados dentro da mesma capacidade de memória.
Durante nossos testes, observamos que, com memória abundante, todos os dados permanecem na memória após um período de aquecimento, preservando o desempenho do sistema. No entanto, à medida que o volume de dados aumenta, o desempenho diminui gradualmente. Portanto, recomendamos o recurso MMap para usuários menos sensíveis a flutuações de desempenho.
Habilitando o MMap no Milvus: uma configuração simples
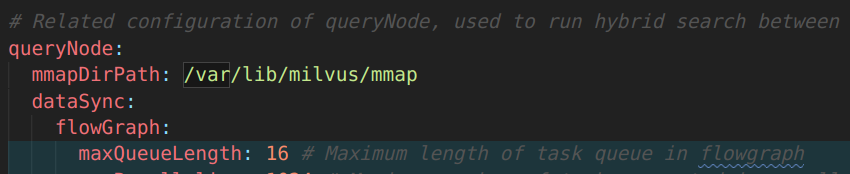
Habilitar o MMap no Milvus é notavelmente simples. Tudo o que você precisa fazer é modificar o arquivo milvus.yaml: adicione o item mmapDirPath na configuração queryNode e defina um caminho válido como seu valor.
Encontrando o equilíbrio: desempenho, armazenamento e limites do sistema
Os padrões de acesso a dados impactam significativamente o desempenho. O recurso MMap do Milvus otimiza o acesso a dados com base na localidade. O MMap permite que o Milvus grave dados escalares diretamente no disco para segmentos de dados acessados sequencialmente. Dados de comprimento variável, como strings, passam por achatamento e são indexados usando um array de offsets na memória. Essa abordagem garante a localidade do acesso aos dados e elimina a sobrecarga de armazenar separadamente cada dado de comprimento variável. As otimizações para índices vetoriais são meticulosas. O MMap é empregado seletivamente para dados vetoriais, mantendo listas de adjacência na memória, conservando memória significativa sem comprometer o desempenho.
Além disso, o MMap maximiza o processamento de dados minimizando o uso de memória. Diferentemente das versões anteriores do Milvus, nas quais o QueryNode copiava conjuntos de dados inteiros, o MMap adota um processo de streaming simplificado e sem cópia durante o desenvolvimento. Essa otimização reduz drasticamente a sobrecarga de memória.
Nossos resultados de testes internos mostram que o Milvus pode lidar eficientemente com o dobro do volume de dados ao habilitar o MMap.
O caminho à frente: inovação contínua e aprimoramentos centrados no usuário
Embora o recurso MMap esteja em sua fase beta, a equipe do Milvus está comprometida com a melhoria contínua. Atualizações futuras refinarão o uso de memória do sistema, permitindo que o Milvus ofereça suporte a volumes de dados ainda mais extensos em um único nó. Os usuários podem esperar um controle mais granular sobre o recurso MMap, permitindo alterações dinâmicas em coleções e modos avançados de carregamento de campos. Esses aprimoramentos proporcionam flexibilidade sem precedentes, permitindo que os usuários adaptem suas estratégias de processamento de dados a requisitos específicos.
Conclusão: redefinindo a excelência no processamento de dados com o Milvus MMap
O recurso MMap do Milvus 2.3 marca um avanço significativo na tecnologia de processamento de dados. Ao alcançar um equilíbrio delicado entre desempenho, custo e limites do sistema, o Milvus capacita os usuários a lidar com grandes quantidades de dados de forma eficiente e econômica. À medida que o Milvus continua a evoluir, ele permanece na vanguarda das soluções inovadoras, redefinindo os limites do que é possível alcançar no gerenciamento de dados.
Fique atento a mais desenvolvimentos revolucionários à medida que o Milvus continua sua jornada rumo à excelência incomparável no processamento de dados.
Continue lendo
Why We Built Vector Lakebase: Rethinking Unstructured Data Architecture for AI
Vector Lakebase: a unified, lake-native data foundation for AI workloads — and an answer to what happens after vector databases succeed.
Introducing Functions and Model Inference on Zilliz Cloud: Automatic Embedding and Reranking with Hosted Models
Zilliz Cloud Functions auto-generate embeddings via OpenAI, Voyage AI, Cohere, or Zilliz Hosted Models. Built-in reranking — just insert text and search.
Why Not All VectorDBs Are Agent-Ready
Explore why choosing the right vector database is critical for scaling AI agents, and why traditional solutions fall short in production.