OpenArt potenzia la ricerca multimodale per oltre 8 milioni di creatori di video AI con Zilliz Cloud
25 s → 300 ms
Latenza di ricerca P99, ES → Zilliz
~85% in meno
Calcola il costo dopo la migrazione
Ricerca nativa multi-vettore
Vettori di immagini e testo interrogati insieme
456M
Vettori migrati senza re-embedding
"I creator non realizzano un'immagine e se ne vanno. Costruiscono un personaggio, un mondo, una storia, e tutto ciò che hanno mai generato diventa materiale per la scena successiva. Zilliz Cloud ci permette di trattare l'intera libreria come un'unica memoria creativa."
John Qiao
Informazioni su OpenArt
OpenArt è una delle piattaforme di generazione di immagini e video con intelligenza artificiale più utilizzate al mondo, con oltre 8 milioni di creatori — hobbisti, marketer e professionisti dell'intrattenimento in attività. Riunisce oltre 100 modelli di Google, OpenAI, Seedance e altri in un'unica tela, ma i modelli rappresentano la parte standardizzata. Ciò che OpenArt costruisce sopra questi è la continuità: un Character Builder che mantiene un personaggio attraverso le scene, One-Click Story per narrative multi-scena e una suite di storyboard che i creatori usano per realizzare trailer, annunci e video per i social. L'ambizione dietro tutto questo è di mettere la proprietà intellettuale nativa dell'IA alla portata di qualsiasi creatore — personaggi e mondi che persistono e crescono, piuttosto che immagini che non lo fanno.
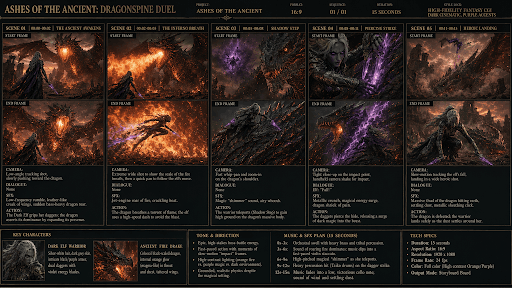
La continuità è la parte difficile, e non solo al momento della generazione. La sfida nel video con IA non è produrre quindici buoni secondi — è produrre i successivi quindici e far sì che appartengano alla stessa storia. Ha anche una conseguenza a valle: i creatori tornano in un mondo per mesi e tutto ciò che hanno mai generato diventa materiale di riferimento per la scena successiva. Il catalogo personale di un creatore deve essere reperibile per significato piuttosto che per nome file o data, ed è qui che OpenArt sfrutta Zilliz Cloud.
La sfida
Il motore di ricerca dei creatori di OpenArt funzionava con la ricerca vettoriale di Elasticsearch. Ha retto finché la libreria era piccola. Nel momento in cui la cronologia delle generazioni ha superato qualche centinaio di milioni di vettori, quattro cose si erano rotte.
- La latenza di ricerca P99 ha raggiunto i 25 secondi. La gestione del ciclo di vita degli indici di Elasticsearch è progettata per i dati di log, quindi ruotava gli indici di OpenArt da hot a warm a cold a frozen circa ogni 90 giorni, e la maggior parte del corpus finiva congelata — ma la ricerca vettoriale ha il modello di accesso opposto, perché classificare un top K significa valutare tutto. Ogni ricerca penetrava nel livello frozen e recuperava i dati attraverso la rete per rispondere.
- Il numero di indici cresceva in modo esponenziale. Elasticsearch creava almeno un nuovo indice ogni 90 giorni e non li univa mai, quindi il numero di indici su cui una query doveva estendersi continuava a moltiplicarsi. Su una libreria che diventa solo più grande, il team prevedeva un degrado netto della ricerca entro circa due anni.
- OpenArt stava pagando un'intera piattaforma di ricerca per usarne una sola funzione ristretta. In aggiunta, il cluster era sovradimensionato perché il team lo aveva calibrato prima di misurare le reali esigenze del carico di lavoro.
- Il recupero multi-vettore doveva essere costruito a mano. Elasticsearch non aveva un modo nativo per interrogare insieme un vettore immagine e un vettore testo, quindi OpenArt ha dovuto scrivere il proprio algoritmo dual-kNN e collegare componenti di terze parti per eseguire entrambe le ricerche, fondere i risultati e filtrarli — un elemento di manutenzione permanente su una funzionalità che non è il fattore distintivo di OpenArt.
Perché Zilliz Cloud
Il team di ingegneria di OpenArt ha valutato Pinecone e Qdrant, e nessuno dei due era la soluzione giusta. Il team aveva anche eseguito Milvus stesso nei primi giorni dell'azienda e lo apprezzava; ciò che all'epoca lo escludeva era il carico operativo della gestione autonoma. Zilliz Cloud ha rimosso questa obiezione: è costruita dallo stesso team dietro Milvus open-source ed è compatibile al 100% con le API Milvus, quindi le conoscenze esistenti e il codice client del team sono stati riutilizzati.
I benchmark sui dati stessi di OpenArt hanno confermato le prestazioni, e la valutazione si è fermata lì. Quattro cose fanno risaltare Zilliz Cloud:
Un'architettura costruita su come la ricerca vettoriale legge i dati. Zilliz Cloud gestisce autonomamente i livelli dei dati in base alla temperatura dei dati: promuove i dati nella cache quando vengono recuperati di frequente o li declassa verso il cold storage quando non servono, senza alcuna policy del ciclo di vita di cui l'applicazione debba farsi carico, e l'auto-compattazione a livello di segmento unisce i dati in background man mano che crescono. Queste due funzionalità affrontano esattamente i modi di cedimento con cui OpenArt aveva convissuto — attraversamento di livelli congelati e proliferazione illimitata degli indici — quindi la ricerca di OpenArt non rallenta con la crescita della libreria.
Ricerca multi-vettore nativa. Un'unica collection di Zilliz Cloud contiene più campi vettoriali e li interroga insieme in una sola richiesta, fondendo i risultati con una ponderazione configurabile. È esattamente ciò che OpenArt aveva creato manualmente sopra Elasticsearch, e averlo in modo nativo è ciò che ha permesso al team di cancellare il proprio codice.
Prezzi legati al calcolo on-demand, non ai dati memorizzati. Una delle alternative fatturava in base al volume dei dati — l'asse sbagliato per un archivio creativo, dove il corpus cresce all'infinito ma in ogni momento viene interrogata solo una frazione. Il modello basato sul calcolo on-demand di Zilliz Cloud permette a OpenArt di dimensionare le prestazioni di cui ha bisogno e di ridimensionarle al variare del carico di lavoro, invece di pagare una tassa sulla storia.
Operabile senza uno specialista di infrastrutture. Un servizio gestito deve comunque essere utilizzabile giorno per giorno dalle persone che lo adottano. OpenArt ha trovato la console abbastanza chiara da poterci navigare per intuizione, senza leggere documentazione — un netto contrasto con una piattaforma di ricerca generica carica di un decennio di funzionalità accumulate che non avrebbero mai usato.
"Serviamo milioni di creatori, quindi ogni infrastruttura deve essere veloce, prevedibile e non richiedere nessuno che la sorvegli. Zilliz Cloud è uno dei pochi che ha superato questa soglia al primo tentativo." — Danny Xiong, Software Engineer, OpenArt
La soluzione: come Zilliz Cloud alimenta OpenArt
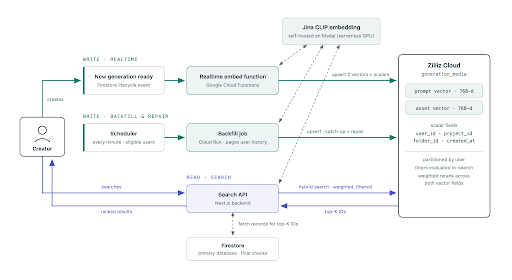
OpenArt usa Zilliz Cloud per eseguire la ricerca vettoriale dietro la casella di ricerca sulla cronologia di generazione di un creatore, disponibile per gli abbonati ai piani idonei. Un creatore che ha realizzato migliaia di immagini e clip nell'arco di mesi digita una frase — un nome di personaggio, un'atmosfera, una scena — e riceve i propri lavori passati, ordinati per significato piuttosto che per nome file o data.
Questo compito è più difficile di quanto sembri, perché una generazione arriva senza metadati. Non c'è titolo, non c'è tag, non c'è cartella. Solo due artefatti la descrivono: l'asset stesso e il prompt che l'ha prodotta. OpenArt indicizza entrambi, perché ciascuno contiene qualcosa che l'altro non ha — il prompt contiene ciò che il creatore ha chiesto, in termini di nomi, intenzioni e parole di stile, e l'asset contiene ciò che il modello ha effettivamente prodotto, che spesso non è la stessa cosa. Cercare in uno solo dei due significa perdere metà della libreria.
OpenArt distribuisce il lavoro su tre servizi.
- La sua applicazione e il database primario girano su Google Cloud.
- Il suo servizio di embedding gira su Modal — un modello Jina CLIP che il team ospita autonomamente su una funzione GPU serverless.
- Lo stoccaggio e il recupero dei vettori vanno su Zilliz Cloud. Il team tiene il livello del modello sotto il proprio controllo e affida il livello che deve scalare.
La generazione di immagini e video con IA avviene in continuazione e viene cercata molto più tardi, quindi OpenArt ha costruito il sistema come due metà indipendenti che operano in tempi e ritmi completamente diversi.
- Il percorso di scrittura trasforma ogni nuova generazione in vettori e li deposita in Zilliz Cloud. Gira costantemente in background, attivato dagli eventi di creazione, e nessuno lo attende.
- Il percorso di lettura gira solo quando un creatore digita nella casella di ricerca. Deve rispondere in poche centinaia di millisecondi, perché qualcuno sta guardando uno spinner.
Il lato di scrittura non si trova mai sul percorso della query — l'unico punto in cui i due si incontrano è la collection stessa. Questa separazione è il motivo per cui l'ingestione continua non si presenta mai come latenza di query.
Il percorso di scrittura: come OpenArt trasforma una generazione in due vettori
- Un creatore con un piano idoneo genera un'immagine o una clip, e OpenArt scrive un'istantanea di essa nel proprio database primario su Google Cloud.
- Una Google Cloud Function si attiva su quell'evento e chiama il servizio di embedding di OpenArt su Modal. Poiché Jina CLIP mappa immagini e testo nello stesso spazio vettoriale, un singolo modello fornisce al team entrambi i vettori di cui ha bisogno.
- OpenArt scrive quei due vettori su Zilliz Cloud — uno per l'asset generato, uno per il prompt sottostante — insieme all'ID di generazione e ai campi scalari su cui il percorso di lettura filtrerà: ID utente e ID progetto.
OpenArt gestisce il video attraverso lo stesso percorso, catturando un frame istantaneo da ogni clip generata e incorporandolo come immagine, così le clip sono recuperabili insieme alle immagini fisse senza una seconda pipeline.
Inoltre, la ricerca è una funzionalità a pagamento, quindi l'intero catalogo pregresso di un creatore idoneo deve diventare ricercabile, non solo ciò che viene creato da quel giorno in poi. Un job di backfill pianificato viene eseguito continuamente in background, analizzando i creatori con piani idonei e scorrendo la cronologia di ciascuno attraverso lo stesso percorso di embedding e scrittura. Funge anche da rete di sicurezza della pipeline: tutto ciò che il percorso in tempo reale non riesce a scrivere, il backfill lo recupera in un passaggio successivo.
Il percorso di lettura: come OpenArt risponde a una ricerca
- Un creatore digita una query e OpenArt la invia allo stesso modello ospitato su Modal per trasformarla in un vettore di query.
- OpenArt lancia una singola ricerca multi-vettore a Zilliz Cloud su entrambi i campi vettoriali, con pesi configurati tra di essi, e i filtri utente e progetto allegati.
- Zilliz Cloud fonde i due insiemi di risultati, valuta i filtri all'interno della ricerca piuttosto che dopo, e restituisce i top K. OpenArt esegue un abbinamento e un filtro finali sul proprio database su Google Cloud prima del rendering.
OpenArt richiede più di mille risultati per query — un top K insolitamente alto per la ricerca semantica, guidato dal carico di lavoro piuttosto che dall'interfaccia: per un creatore intensivo, gli asset di un singolo progetto superano già il migliaio, e una query ampia come "uomo" corrisponde legittimamente a diverse volte quel numero.
La stessa query sul vecchio stack non assomigliava affatto a questo. Si diramava su ogni indice che la politica del ciclo di vita avesse mai creato, la maggior parte congelati, e recuperava dati attraverso la rete fino a quando non poteva classificare un top K. Su Zilliz Cloud, OpenArt fa una sola chiamata a una sola collection e ottiene una risposta in circa 300 millisecondi.
Come OpenArt ha ridotto due ricerche in una
Combinare i risultati di immagine e prompt è esattamente ciò per cui OpenArt aveva costruito manualmente il layer di fusione dual-kNN su Elasticsearch. Poiché Zilliz Cloud interroga nativamente più campi vettoriali, il team ha rimosso quel codice e ha re-espresso il recupero come una singola richiesta — per poi avvolgere la ponderazione tra i due campi in un feature flag. La rilevanza è diventata qualcosa che OpenArt ottimizza in produzione piuttosto che qualcosa che re-implementa.
Come OpenArt ha migrato
OpenArt ha spostato un set legacy di circa 456 milioni di vettori e ha usato il cutover per eseguire un'igiene dei dati su di esso: eliminando i record di cui il prodotto non aveva più bisogno e correggendo bug che il vecchio percorso di ingestione stava silenziosamente introducendo. Una decisione di scope ha mantenuto il progetto circoscritto: il team ha mantenuto il proprio modello di embedding esistente. Ri-incorporare centinaia di milioni di asset avrebbe trasformato una migrazione in una ricostruzione. Poiché Zilliz Cloud memorizza vettori da qualsiasi modello scelga il cliente, OpenArt ha spostato storage e recupero senza toccare il layer del modello.
Risultati e benefici
- La latenza di ricerca è scesa da 25 secondi con Elasticsearch a circa 300 millisecondi al P99 — circa 80 volte più veloce, e fa la differenza tra una barra di ricerca che i creator evitano e una che usano.
- Costo di calcolo ridotto di circa l'85% — lo stesso carico di lavoro, su un motore costruito per quello scopo.
- OpenArt ha rimosso l'algoritmo di fusione sviluppato internamente dalla pipeline di produzione. Con la ricerca multi-vettore nativa in Zilliz Cloud, il codice dual-kNN e i suoi componenti di terze parti sono spariti, e ottimizzare la rilevanza è un cambio di configurazione, non un progetto di ingegneria.
- 456 milioni di vettori sono stati migrati a Zilliz Cloud senza rilanciare nemmeno un embedding perché Zilliz Cloud è agnostico rispetto ai modelli — mantenendo la migrazione una migrazione, non una ricostruzione.
Il vantaggio strategico è quello che OpenArt sente di più: la ricerca ha smesso di essere un progetto infrastrutturale. La capacità ingegneristica che prima serviva a mantenere vivo il recupero dei dati è tornata al prodotto — in particolare, al layer agente attorno a cui OpenArt sta costruendo l'intera esperienza.
I consigli di OpenArt per i team che scelgono un database vettoriale
Avendolo fatto due volte — prima abbandonando Milvus self-hosted, poi Elasticsearch — il team di OpenArt riduce la decisione a una breve lista.
- Verificate che il modello di prezzo corrisponda alla forma del vostro carico di lavoro. Chiedete su cosa vi viene fatturato, poi chiedete quale dei vostri numeri cresce più velocemente. Se sono lo stesso numero, avete un problema che scala con il vostro successo.
- Verificate che l'architettura corrisponda al vostro modello di accesso. Leggete la progettazione dello storage, non la lista delle funzionalità. Una policy che invecchia i dati rendendoli irraggiungibili va bene per i log, ed è sbagliata per la ricerca vettoriale.
- Conoscete i vostri requisiti di performance prima di fare provisioning. Il più grande errore di costo di OpenArt è stato il provisioning eccessivo di hardware per un carico di lavoro che non era stato profilato. Misurate prima.
- Trattate una migrazione come un'occasione per buttare via cose. Tutto ciò che trasportate, lo pagate e lo cercate per sempre.
Cosa succede dopo
OpenArt oggi usa Zilliz Cloud per la ricerca nella cronologia di generazione di ogni creator e prevede di estenderlo in tre direzioni:
- La libreria condivisa di asset e template, dove sia il lavoro di etichettatura del team sia i template di raccomandazione richiedono ricerca semantica.
- Il filtraggio per scalari, rinviato durante la migrazione e ora risalito in cima alla lista.
- La memoria dell'agente, che è ciò che interessa di più al team. Mentre OpenArt passa da strumenti discreti a un agente che li orchestra — trasformando una generazione di 15 secondi in un film di uno o tre minuti — l'agente deve ricordare attraverso le sessioni in quale progetto si trova un creator e per quale brand sta creando pubblicità. Questo è un problema di ricerca vettoriale, ed è dove OpenArt prevede che il suo uso di Zilliz Cloud crescerà.
"OpenArt sta definendo cosa significa creazione nativa AI: milioni di creator che costruiscono personaggi e storie che reggono attraverso le scene. Siamo orgogliosi che Zilliz Cloud sia la base di recupero dietro tutto questo, ed entusiasti di continuare a costruire insieme mentre i loro agenti iniziano a ricordare." — James Luan, CTO, Zilliz
Prova Zilliz Cloud gratuitamente
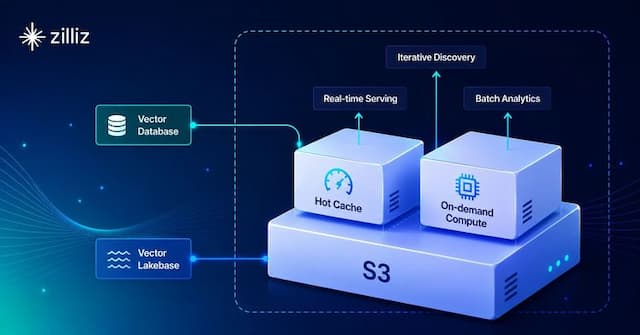
Zilliz Cloud è un Vector Database e Vector Lakebase completamente gestito per l'AI enterprise, compatibile con le API Milvus. Offre ricerca vettoriale ad alte prestazioni su scala massiccia, con sicurezza di livello enterprise e operazioni a manutenzione zero, esteso con l'apertura, la scalabilità e l'economia dei data lake multimodali — una piattaforma unica per cercare, analizzare e governare dati non strutturati per l'AI in produzione.
Che tu stia costruendo ricerca multimodale, RAG o memoria per agenti, Zilliz Cloud fornisce la stessa base di recupero che alimenta OpenArt. Inizia gratuitamente con Zilliz Cloud oppure parlane con il nostro team.
"Il nostro vecchio motore di ricerca impiegava 25 secondi al P99. Era inaccettabile. Zilliz Cloud lo ha riportato sotto un terzo di secondo e ci ha permesso di eliminare il codice di retrieval che avevamo mantenuto noi stessi."
Danny Xiong