Come migrare da Chroma a Zilliz Cloud
Chroma Cloud smette di accettare scritture il 22 novembre 2026 e smette di servire letture il 22 dicembre 2026, secondo la tempistica di chiusura di Chroma. Se la tua applicazione scrive su Chroma Cloud, deve trovare una nuova casa prima della prima data, e i tuoi dati devono essere trasferiti prima della seconda.
Chroma open-source non è interessato. Ma se lo gestisci tu stesso e lo stai portando in produzione, con più dati di quanti una singola macchina possa contenerne comodamente, un obiettivo di uptime e nessuno che voglia essere reperibile per gestirlo, la migrazione è la stessa, senza la scadenza.
Questa guida sposta entrambi su Zilliz Cloud, il database vettoriale completamente gestito costruito su Milvus open-source. I tuoi embedding vengono trasferiti così come sono, quindi nessun embedding viene ricalcolato, e i tuoi ID, documenti, URI e metadati vengono con loro. Se preferisci eseguire Milvus open-source da solo, valgono gli stessi passaggi; vedi Spostare Chroma su Milvus open-source nel Passo 1.
Prima di iniziare
Ti serve:
- Un cluster Zilliz Cloud, con il suo endpoint pubblico e una chiave API. Registrati se non ne hai uno. Il piano gratuito supporta fino a 5 collection; per di più, usa un cluster Serverless o Dedicated.
- I dettagli di connessione di Chroma. Su Chroma Cloud, il pannello Connect nella dashboard mostra la tua chiave API, l'ID tenant e il nome del database. Per Chroma self-hosted, ti serve l'indirizzo del server, più un token o un nome utente e password se hai abilitato l'autenticazione.
- Python 3.10 o successivo con entrambi i client, per verificare la copia e aggiornare la tua applicazione:
pip install chromadb==1.5.9 pymilvus==3.0.2
- Docker, se usi il servizio open-source Vector Transport Service (Opzione B nel Passo 1).
Come vengono mappati i tuoi dati
Ogni collection Chroma diventa una collection Zilliz Cloud con quattro campi. I metadati confluiscono nel campo dinamico della collection, quindi ogni chiave di metadati rimane filtrabile, proprio come in Chroma. La pagina della documentazione di Zilliz Cloud Migrare da Chroma a Zilliz Cloud contiene la mappatura completa, inclusa la conversione dei tipi di metadati in campi tipizzati.
| Chroma | Zilliz Cloud |
|---|---|
| Collection | Collection con lo stesso nome, con - convertito in _: support-docs diventa support_docs. I nomi di Zilliz Cloud accettano solo lettere, cifre e underscore e non possono iniziare con una cifra, quindi un nome come kb.v2 o 2024-notes richiede un nuovo nome quando configuri la copia. Così anche uno di due nomi qualsiasi che si convertono nello stesso nome, come support-docs e support_docs |
id | id, la chiave primaria VARCHAR. Gli ID non cambiano |
embedding | embedding, un campo FLOAT_VECTOR con la stessa dimensione |
document | document, un campo VARCHAR nullable fino a 65.535 byte |
uri | uri, un campo VARCHAR nullable. La stringa URI viene copiata; il file a cui punta no. |
| Metadata | Chiavi nel campo dinamico. Puoi anche trasformare chiavi scelte in campi tipizzati quando configuri la copia |
Spazio di distanza: cosine, l2 o ip | Metrica dell'indice: COSINE, L2 o IP. La metrica non viene copiata; la imposti quando viene creato l'indice |
| Funzione di embedding | Non è memorizzata nel database. La tua applicazione calcola gli embedding delle query (Passo 3) |
Una collection per utente? Ogni collection Chroma diventa una collection Zilliz Cloud a sé, e un cluster ne contiene un numero limitato: 5 su Free, 100 su Serverless, e sui cluster Dedicated 1.024 per unità di calcolo, fino a 16.384. Se hai più collection per utente di così, o prevedi di averne, parlaci prima di migrare: la soluzione migliore è una collection con una partition key, che supporta milioni di tenant.
Passo 1: Sposta i tuoi dati
Puoi copiare i dati in due modi. Quale dei due si adatta dipende da dove gira il tuo Chroma:
| Il tuo Chroma | Uso |
|---|---|
| Chroma Cloud | Opzione A: servizio di migrazione integrato |
| Il tuo server Chroma personale, raggiungibile da Internet | Opzione A: servizio di migrazione integrato |
| Il tuo Chroma su una rete privata o sul tuo laptop, o incorporato nella tua applicazione | Opzione B: Vector Transport Service (open-source) |
La differenza è chi si connette a chi. Il Migration Service è eseguito in Zilliz Cloud e legge dal tuo Chroma, quindi ha bisogno di un indirizzo che può raggiungere. Vector Transport Service gira su una macchina scelta da te e scrive su Zilliz Cloud, quindi funziona da qualsiasi luogo che possa raggiungere entrambi.
Per prima cosa, annota il numero di record e lo spazio di distanza di ogni raccolta. Ti serve lo spazio di distanza per impostare la metrica dell'indice, qualunque opzione tu scelga, e il conteggio per verificare la copia:
import chromadb

client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud: chromadb.CloudClient(api_key=..., tenant=..., database=...)

for collection in client.list_collections():
    config = collection.configuration_json
    space = (config.get("hnsw") or config.get("spann") or {}).get("space") or "l2"
    print(f"{collection.name}: {collection.count()} records, space {space}")
Chroma usa l2 per le raccolte create senza uno spazio di distanza. Lascia fuori dalla copia le raccolte vuote: Chroma non registra una dimensione finché non arriva il primo embedding, quindi non c'è nulla da cui creare la destinazione.
Opzione A: Zilliz Cloud Migration Service
Il Migration Service è integrato nella console di Zilliz Cloud ed è gratuito. Devi avere il ruolo Organization Owner o Project Admin. Un server Chroma self-hosted deve servire la REST API v2 di Chroma ed essere raggiungibile da Zilliz Cloud. Se si trova dietro un firewall, aggiungi gli indirizzi IP di Zilliz Cloud alla sua allowlist.
- Connetti. Nella console, apri Migrazioni e scegli Chroma come origine. Inserisci endpoint, tenant, database e credenziali di Chroma. Per Chroma Cloud, copiali dal pannello Connetti: l'endpoint è
https://api.trychroma.com, oppure l'endpoint della tua regione se il tuo database è al di fuori di AWS us-east-1, e la credenziale è la tua chiave API. Il Chroma self-hosted può usare nessuna autenticazione, un token, oppure nome utente e password, e i suoi tenant e database predefiniti sonodefault_tenantedefault_database. Poi scegli il cluster e il database di destinazione.
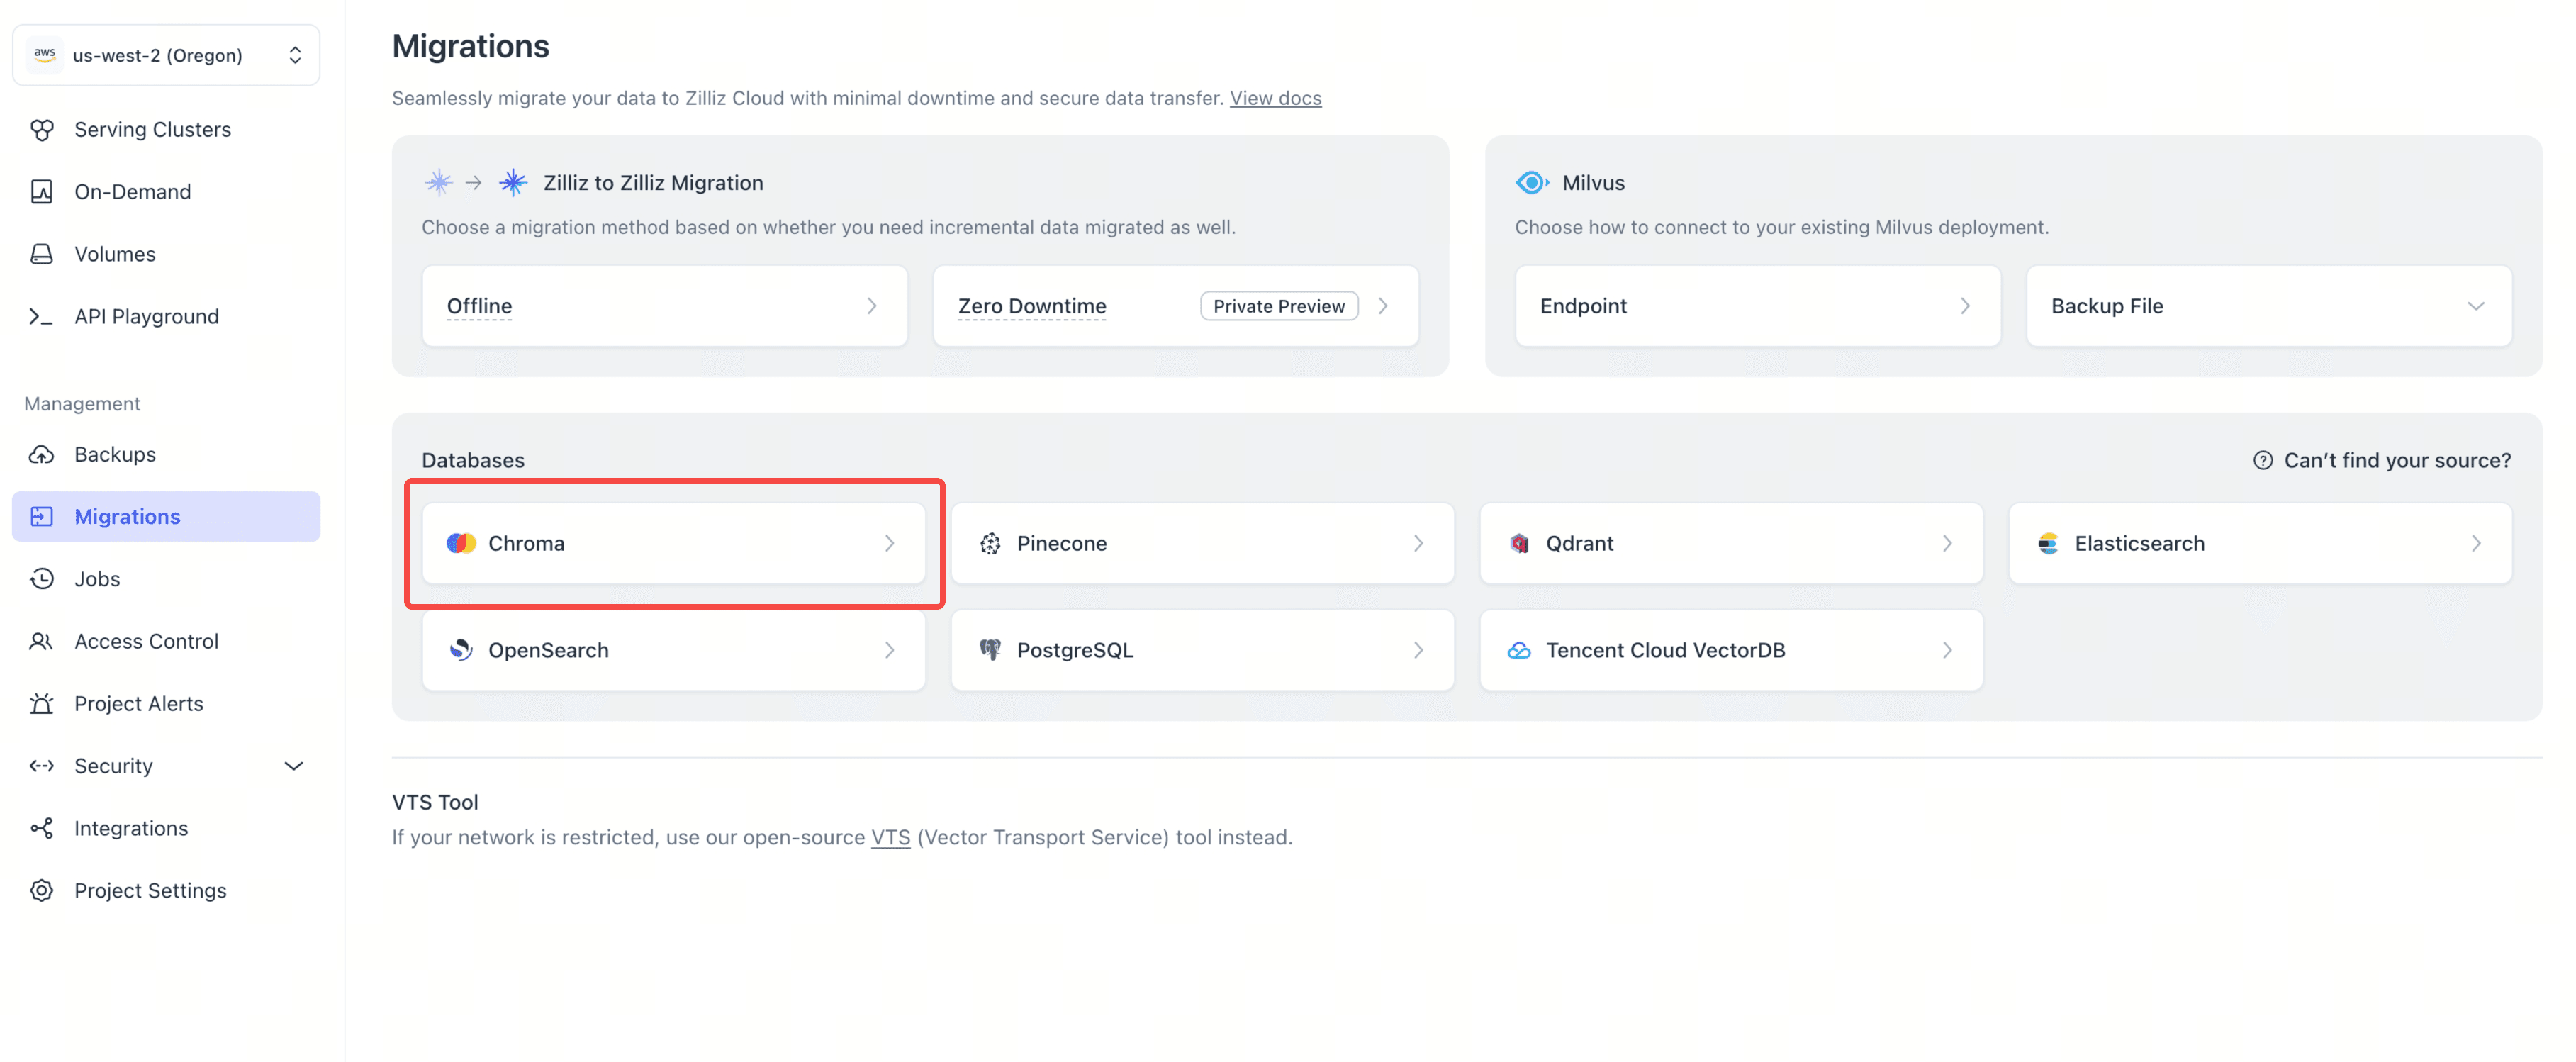
- Seleziona e verifica. Seleziona le raccolte da spostare. Controlla ogni nome di destinazione e rinomina quelli che Zilliz Cloud non può usare o che sono già occupati. Rivedi la mappatura dei campi: i metadati vanno nel campo dinamico per impostazione predefinita e puoi trasformare le chiavi scelte in campi tipizzati qui.
- Imposta l'indice. Lascia attiva l'opzione Crea indici dopo la migrazione, così le raccolte sono ricercabili appena il job termina. Imposta la metrica di ogni raccolta in modo che corrisponda al suo spazio di distanza Chroma: da
cosineaCOSINE, dal2aL2e daipaIP. La metrica non viene copiata da Chroma. Vedi le impostazioni dell'indice. - Esegui. Avvia il job e seguilo nella pagina Jobs. Quando termina, il job riporta il numero di righe che ha verificato.
Ogni campo e ogni opzione sono descritti in Migrate from Chroma to Zilliz Cloud nella documentazione di Zilliz Cloud. Poi vai al Passo 2.
Opzione B: Vector Transport Service
Vector Transport Service (VTS) è lo strumento di migrazione open-source di Zilliz e il motore su cui gira il Migration Service. Lo esegui tu stesso in Docker, da un file di configurazione. Legge Chroma tramite la sua API REST v2, che qualsiasi server Chroma dalla versione 0.6 in poi espone.
Se il tuo Chroma è integrato nella tua applicazione, con i dati in una directory locale tramite chromadb.PersistentClient, non c'è ancora un server da cui VTS possa leggere. Avviane uno su quella directory:
chroma run --path ./chroma_data --port 8000
Poi scrivi la configurazione del job. Salvala come migration.conf e sostituisci ogni segnaposto $ con un valore reale; non sono variabili d'ambiente e non vengono espansi automaticamente.
hocon
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  ChromaDB {
    url = "$CHROMA_URL"                  # e.g. http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # e.g. ["support-docs"]

    # If your Chroma requires auth, see the table below
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"

    id_split_size = 300
    batch_size = 300
  }
}

sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"                 # must already exist
    batch_size = 50
    enable_dynamic_field = true          # required, this is where metadata goes
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
La configurazione contiene credenziali, quindi limitane l'accesso con chmod 600 migration.conf.
| Parametro | Cosa inserire |
|---|---|
url (source) | La radice del server Chroma, senza /api/v2, che VTS aggiunge in coda. VTS gira in un container, dove localhost indica il container stesso. Se Chroma gira sulla stessa macchina, usa http://host.docker.internal:8000 su macOS e Windows; su Linux, aggiungi --network host a docker run e tieni localhost. Per Chroma Cloud, usa https://api.trychroma.com, oppure l'endpoint della tua regione |
tenant e database | default_tenant e default_database a meno che tu non ne abbia creati altri. Su Chroma Cloud, il tuo tenant ID e il nome del database |
auth_type e token | Ometti entrambi se il server gira senza autenticazione. In caso contrario usa X_CHROMA_TOKEN o BEARER con un token, oppure BASIC con username e password. Chroma Cloud usa X_CHROMA_TOKEN con la tua API key |
id_split_size e batch_size | 300 per entrambi funziona ovunque, e su Chroma Cloud entrambi devono rimanere a 300 o meno. Per una grande collection self-hosted, 10000000 e 1000 eseguono la scansione degli ID in blocco e poi recuperano i record per ID, evitando la lenta paginazione profonda |
collection_rename (sink) | Opzionale, { "source" = "target" }. Obbligatorio per qualsiasi nome della sorgente che non sia un nome valido di Zilliz Cloud quando - diventa _ |
Per trasformare le chiavi dei metadati scelte in campi tipizzati, aggiungi un blocco field_schema al sink. La guida al sink Milvus copre field_schema e collection_rename, e la guida alla sorgente ChromaDB copre le dimensioni dei batch, l'autenticazione e le altre opzioni della sorgente.
Esegui il job:
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
Il job è riuscito quando il log termina con end with state FINISHED, Total Read Count è uguale a Total Write Count e Total Failed Count è 0.
Il job aggiunge dati, quindi non rieseguirlo nella stessa collection. Una seconda esecuzione riscrive ogni record. Se un job fallisce a metà, o se ti serve una copia nuova, elimina prima la collection di destinazione, oppure invia il job a una nuova con collection_rename.
Costruisci l'indice. Usa la metrica di distanza che hai annotato per quella collection:
from pymilvus import MilvusClient
client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE",  # cosine -> COSINE, l2 -> L2, ip -> IP
)
client.create_index(collection_name="support_docs", index_params=index_params)
client.load_collection("support_docs")
Passare da Chroma a Milvus open-source
Tutto in questa guida funziona con Milvus open-source 2.5 o successivo. Usa l'Opzione B, che scrive su qualsiasi Milvus raggiungibile: imposta l'url del sink all'indirizzo del tuo Milvus, ad esempio http://host.docker.internal:19530 quando Milvus gira sulla stessa macchina, e token a username:password, oppure elimina la riga token se l'autenticazione è disattivata. I passi da 2 a 4 sono gli stessi, e nella tua applicazione cambiano solo uri e token. Poiché Milvus e Zilliz Cloud condividono la stessa API, potrai passare da uno all'altro in seguito senza toccare il codice.
Step 2: Controlla i tuoi dati
Per prima cosa, confronta i conteggi dei record. Il Migration Service riporta il numero di righe che ha verificato; per VTS, è Total Write Count nel log. Entrambi dovrebbero corrispondere al conteggio in Chroma.
I conteggi ti dicono che ogni record è arrivato. Non ti dicono che l'indice risponde alle query come faceva Chroma: un indice costruito con la metrica sbagliata supera il controllo del conteggio e restituisce comunque i vicini sbagliati. Quindi esegui alcune ricerche su entrambi i lati e confronta:
import chromadb
from pymilvus import MilvusClient

chroma = chromadb.CloudClient(api_key="YOUR_CHROMA_API_KEY", tenant="YOUR_TENANT_ID", database="YOUR_DATABASE_NAME")
# Self-hosted Chroma: chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY")

source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(query_embeddings=[vector], n_results=10, include=[])["ids"][0]
    hits = milvus.search("support_docs", data=[vector.tolist()], limit=10)[0]
    overlaps.append(len(set(expected) & {hit["id"] for hit in hits}) / len(expected))
print(f"top-10 overlap: {sum(overlaps) / len(overlaps):.0%}")
Questo usa 20 record come query e conta quanti dei primi 10 risultati corrispondono. Entrambi i sistemi usano indici approssimati, quindi un valore di poco inferiore al 100% è normale. Un valore molto più basso significa quasi sempre che la metrica dell'indice non corrisponde allo spazio delle distanze della raccolta.
Nessuno dei due controlli guarda all'interno dei record. Prima che la copia finale venga messa in produzione, confronta anche quelli: verifica che ogni ID sia arrivato, poi confronta vettori, documenti, URI e metadati. Su una raccolta piccola, confronta ogni record; su una grande, un campione casuale.
Se la tua applicazione ha continuato a scrivere su Chroma durante la copia, i conteggi possono differire. Va bene per una prima passata; per la copia finale quando effettui il passaggio, devono corrispondere.
Step 3: Aggiorna la tua applicazione
La maggior parte delle chiamate si traduce uno a uno. Due cose richiedono attenzione: la tua applicazione ora crea autonomamente gli embedding delle query, e i punteggi per le raccolte cosine e ip vanno nella direzione opposta.
Connettiti a Zilliz Cloud:
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
Per Milvus open-source, imposta uri all'indirizzo del tuo Milvus e token a username:password, oppure ometti token se l'autenticazione è disattivata. Tutto ciò che segue è uguale.
Esegui l'embedding delle query con lo stesso modello di prima. Quando passavi query_texts a Chroma, Chroma eseguiva la funzione di embedding della raccolta per te. Le raccolte migrate non includono quella funzione, quindi chiama lo stesso modello nel tuo codice. Se hai lasciato che Chroma facesse l'embedding del tuo testo e non hai mai impostato una funzione di embedding, ha usato il suo modello predefinito, all-MiniLM-L6-v2. Il pacchetto chromadb può ancora eseguirlo localmente:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction() query_vector = embed(["How do I get a refund?"])[0].tolist()
Se hai usato OpenAI o un altro provider, chiama lo stesso modello con le stesse impostazioni.

**Ricerca con filtri.** Prima, in Chroma:

```python
results = collection.query(
    query_embeddings=[query_vector],
    n_results=5,
    where={"category": "billing"},
    where_document={"$contains": "refund"},
)
Dopo, in Zilliz Cloud:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
Ogni risultato è un dict con id, distance e i campi richiesti sotto entity. I filtri where e where_document di Chroma diventano una sola espressione di filtro:
| Chroma | Zilliz Cloud |
|---|---|
{"category": "billing"} | category == "billing" |
{"category": {"$ne": "billing"}} | category != "billing" |
{"year": {"$gte": 2023}} (anche $gt, $lt, $lte) | year >= 2023 (anche >, <, <=) |
{"category": {"$in": ["billing", "account"]}} | category in ["billing", "account"] |
{"category": {"$nin": ["billing", "account"]}} | category not in ["billing", "account"] |
{"$and": [...]} e {"$or": [...]} | ... and ... e ... or ... |
{"is_public": True} | is_public == true |
{"tags": {"$contains": "faq"}} (metadati di array) | array_contains(tags, "faq") |
where_document={"$contains": "refund"} | document like "%refund%" |
where_document={"$not_contains": "refund"} | not (document like "%refund%") |
Leggere i punteggi al contrario. Chroma restituisce le distanze, dove un valore più basso significa maggiore similarità. Per COSINE e IP, Zilliz Cloud restituisce punteggi di similarità, dove un valore più alto significa maggiore similarità. Le classifiche non cambiano, ma qualsiasi soglia nel tuo codice sì. Nel nostro test, il primo risultato per la ricerca sopra aveva una distanza Chroma di 0.0545 e un punteggio Zilliz Cloud di 0.9455.
| Spazio Chroma | Chroma restituisce | Zilliz Cloud restituisce | Una soglia come distance < 0.3 diventa |
|---|---|---|---|
cosine | 1 − similarità coseno | Similarità coseno | score > 0.7 |
ip | 1 − prodotto interno | Prodotto interno | score > 0.7 |
l2 | Distanza L2 al quadrato | Distanza L2 al quadrato | Nessuna modifica |
Scrivere ed eliminare record. Le chiavi dei metadati stanno accanto agli altri campi in ogni riga, quindi non c'è un argomento metadatas separato. add e upsert corrispondono entrambi a upsert (o insert per nuovi ID), e delete funziona per ID o per filtro:
client.upsert(
    collection_name="support_docs",
    data=[{"id": "doc-1001", "embedding": vector, "document": "How to change your billing address", "category": "billing"}],
)
client.delete(collection_name="support_docs", ids=["doc-1001"])
client.delete(collection_name="support_docs", filter='category == "archived"')
Qui vector è un embedding dello stesso modello usato per il resto della collezione. Puoi omettere uri; è nullable.
Stai usando LangChain? Sostituisci la classe del vector store e puntala ai nomi dei campi migrati. Prima:
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, filter={"category": "billing"})
Dopo, con pip install langchain-milvus:
from langchain_milvus import Milvus
vector_store = Milvus( embedding_function=embeddings, collection_name="support_docs", connection_args={"uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT", "token": "YOUR_ZILLIZ_CLOUD_API_KEY"}, primary_field="id", text_field="document", vector_field="embedding", enable_dynamic_field=True, ) docs = vector_store.similarity_search("How do I get a refund?", k=5, expr='category == "billing"')
embeddings è lo stesso oggetto di embeddings LangChain che hai usato con Chroma, e i filtri passano da filter={...} a expr="...". Gli utenti di LlamaIndex possono passare al Milvus vector store nello stesso modo.
Passaggio 4: Commutazione
- Copia i tuoi dati, verificali e indirizza una build di staging della tua applicazione a Zilliz Cloud.
- Metti in pausa le scritture su Chroma. Dopo il 22 novembre, Chroma Cloud le bloccherà comunque.
- Copia di nuovo, così da ottenere ogni scrittura fino alla pausa, e verifica che i conteggi corrispondano esattamente. Elimina la prima copia prima di iniziare, oppure invia questa a un altro database.
- Distribuisci la tua applicazione su Zilliz Cloud.
- Su Chroma Cloud, rimuovi o ruota le tue credenziali prima del 22 dicembre, come richiesto dall'avviso di chiusura di Chroma.
Stai leggendo questo dopo il 22 novembre? I tuoi dati Chroma Cloud sono già in sola lettura, quindi salta il passaggio 2 e copia una volta sola. Puoi ancora copiarli fino al 22 dicembre.
Su Chroma self-hosted non c'è una scadenza, ma mantieni l'ordine: copia, metti in pausa le scritture, copia di nuovo, passa. Tieni il tuo server Chroma per un po' di tempo dopo. Finché la tua applicazione non scrive qualcosa di nuovo su Zilliz Cloud, il rollback è una modifica di configurazione.
Passi successivi
- Stai spostando un carico di lavoro grande o di produzione? Contatta il nostro team di supporto per pianificare la commutazione.
- Prima vuoi confrontare le opzioni? Chroma vs. Zilliz Cloud copre funzionalità, scala e cosa viene mappato da Chroma Cloud.
- Hai usato la ricerca ibrida in Chroma Cloud? La ricerca ibrida di Zilliz Cloud combina vettori densi con BM25 o altri vettori sparsi in un'unica richiesta.
- Stai migrando anche altri database? Lo stesso Migration Service gestisce Pinecone, Qdrant, Elasticsearch, OpenSearch e PostgreSQL.
 Fendy Feng
 is the Product Marketing Manager at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Sebastian Huang
Staff Software Engineer at Zilliz
 Shawn He
Senior Software Engineer at Zilliz
Continua a leggere
Zilliz Cloud Now Available in AWS Europe (Ireland)
Zilliz Cloud launches in AWS eu-west-1 (Ireland) — bringing low-latency vector search, EU data residency, and full GDPR-ready infrastructure to European AI teams. Now live across 30 regions on five cloud providers.
Why Teams Are Migrating from Weaviate to Zilliz Cloud — and How to Do It Seamlessly
Explore how Milvus scales for large datasets and complex queries with advanced features, and discover how to migrate from Weaviate to Zilliz Cloud.
How to Build RAG with Milvus, QwQ-32B and Ollama
Hands-on tutorial on how to create a streamlined, powerful RAG pipeline that balances efficiency, accuracy, and scalability using the QwQ-32B and Milvus.