
Nomic / nomic-embed-vision-v1
Un modello di embedding visivo con 92 milioni di parametri, supporta la ricerca sia unimodale sia multimodale in abbinamento con nomic-embed-text-v1
Milvus Integrated
Compito: Incorporamento
Modalità: Immagine
Metrica di Similarità: Coseno
Licenza: Apache 2.0
Dimensioni: 768
Token di Input Massimi:
Prezzo: Gratis
Introduzione a nomic-embed-vision-v1
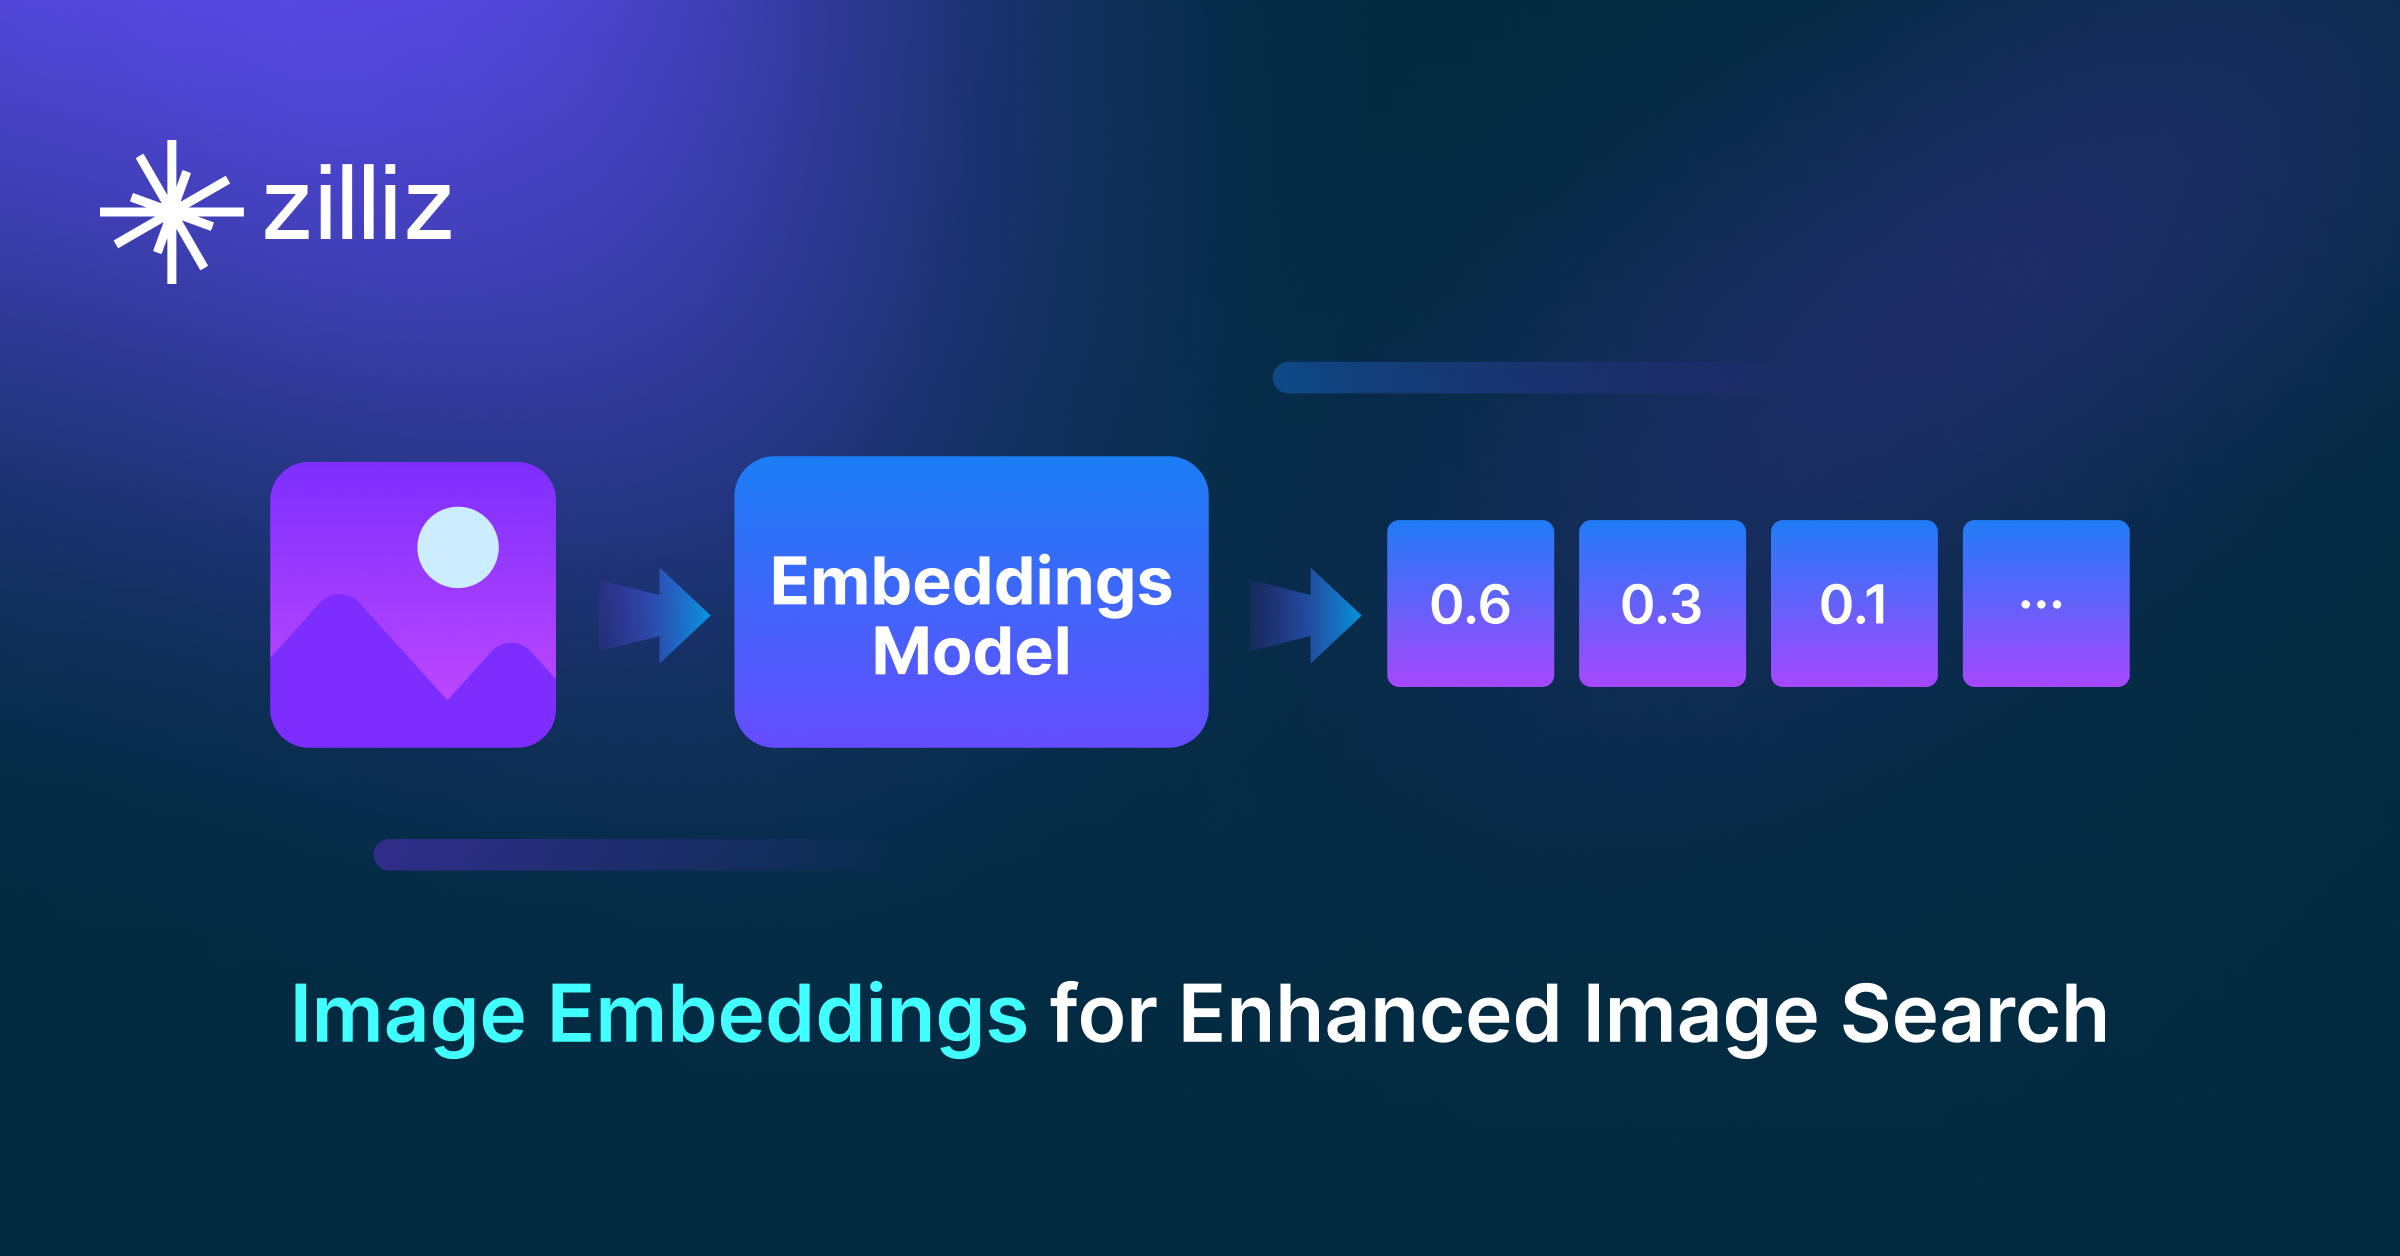
Il modello nomic-embed-vision-v1 è un modello di embedding visivo completamente replicabile che condivide lo stesso spazio latente di nomic-embed-text-v1, consentendo un uso multimodale in cui gli embedding di testo e immagini possono interrogarsi direttamente a vicenda. Con un encoder visivo da 92 milioni di parametri, supporta embedding di immagini e testo, ricerca unimodale all'interno di ciascuna modalità e ricerca multimodale su entrambe.
Come creare embedding con nomic-embed-vision-v1
Esistono due modi principali per generare embedding vettoriali:
- PyMilvus: l'SDK Python per Milvus che integra senza problemi il modello
nomic-embed-vision-v1. - Il modulo
embednell'SDK Python di Nomic fornisce funzionalità di embedding utilizzando la Nomic Embedding API.
Una volta generati gli embedding vettoriali, possono essere archiviati in Zilliz Cloud (un servizio di database vettoriale completamente gestito basato su Milvus) e utilizzati per la ricerca per similarità semantica. Ecco quattro passaggi chiave:
- Registrati gratuitamente per un account Zilliz Cloud.
- Configura un cluster serverless e ottieni il Public Endpoint e l'API Key.
- Crea una raccolta vettoriale e inserisci i tuoi embedding vettoriali.
- Esegui una ricerca semantica sugli embedding archiviati.
Crea embedding tramite PyMilvus e inseriscili in Zilliz Cloud per la ricerca semantica
from pymilvus import MilvusClient
from nomic import embed

# Prepare images (can be local paths or URLs)
images = ["path/to/image1.jpg", "path/to/image2.jpg", "path/to/image3.jpg"]

# Generate embeddings for images using nomic-embed-vision-v1
image_embeddings = embed.image(images=images, model="nomic-embed-vision-v1")[
    "embeddings"
]

# Prepare query image
query_images = ["path/to/query_image.jpg"]

# Generate embeddings for query
query_embeddings = embed.image(images=query_images, model="nomic-embed-vision-v1")[
    "embeddings"
]

# Connect to Zilliz Cloud with Public Endpoint and API Key
client = MilvusClient(uri=ZILLIZ_PUBLIC_ENDPOINT, token=ZILLIZ_API_KEY)

COLLECTION = "nomic_vision_v1_images"

# Drop collection if it exists
if client.has_collection(collection_name=COLLECTION):
    client.drop_collection(collection_name=COLLECTION)

# Create collection with dimension 768 (nomic-embed-vision-v1 output dimension)
client.create_collection(collection_name=COLLECTION, dimension=768, auto_id=True)

# Insert images with embeddings
for image, embedding in zip(images, image_embeddings):
    client.insert(COLLECTION, {"image_path": image, "vector": embedding})

# Search for similar images
results = client.search(
    collection_name=COLLECTION,
    data=query_embeddings,
    # consistency_level="Strong",  # Strong consistency ensures accurate results but may increase latency
    output_fields=["image_path"],
    limit=3,
)

# Print search results
print("Similar images found:")
for result in results[0]:
    print(f"  - {result['entity']['image_path']} (distance: {result['distance']:.4f})")
Per ulteriori informazioni, consulta la nostra documentazione del modello di embedding PyMilvus.