Points clés
Le stockage objet est une architecture de stockage de données qui gère les données sous forme d’objets distincts dans des compartiments plats, accessibles par ID via une API HTTP.
Il est devenu la couche de stockage par défaut pour l’infrastructure d’IA, car les charges de travail d’IA génèrent d’énormes quantités de données non structurées (embeddings, médias d’entraînement, journaux de conversation, checkpoints de modèles), que le stockage objet conserve à faible coût et à une échelle quasi illimitée.
Les principaux services sont Amazon S3, Google Cloud Storage et Azure Blob Storage, ainsi que les solutions open source MinIO et Ceph.
Mais le stockage objet seul ne peut pas servir les trois charges de travail dont les applications d’IA ont besoin sur ces données : récupération en temps réel, découverte interactive et analyses par lots. Chacune nécessite généralement son propre système, avec des copies des données maintenues synchronisées.
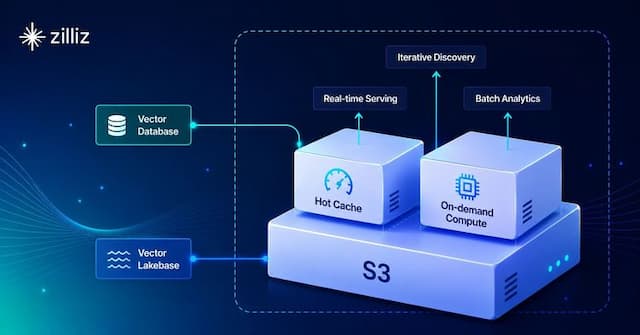
Zilliz Vector Lakebase comble ces lacunes en ajoutant un index vectoriel, des lectures sélectives et un cache à plusieurs niveaux directement au-dessus du stockage objet, afin que les trois charges de travail s’exécutent sur les mêmes données sans copies.
Qu’est-ce que le stockage objet
Le stockage objet est une architecture de stockage de données qui gère les données sous forme d’objets distincts dans un conteneur plat, accessibles par ID via une API HTTP. Il est conçu pour les données non structurées : photos, vidéos, audio, e-mails, pages web, relevés de capteurs et embeddings vectoriels produits par les applications d’IA.
Un stockage objet cloud répartit ces données sur de nombreuses machines, mais vous permet d’accéder à l’ensemble comme à un pool unique via cette API HTTP. Chaque objet contient trois éléments : les données elles-mêmes, les métadonnées que vous ajoutez et un ID unique. Vous récupérez ou analysez n’importe quel objet grâce à cet ID, quel que soit son type de fichier.
Amazon S3, le premier stockage objet cloud, contient désormais plus de 500 billions d’objets. Il est devenu la couche de stockage par défaut du cloud.
Aujourd’hui, avec les applications d’IA qui génèrent des embeddings et consomment des données non structurées à très grande échelle, le stockage objet est devenu l’emplacement par défaut des données d’IA. La plupart de ces données sont non structurées : embeddings vectoriels, médias d’entraînement, journaux de conversation, checkpoints de modèles. Une seule tâche de génération d’embeddings peut produire des milliards de vecteurs, et une pile de génération augmentée par récupération en stocke souvent des centaines de millions de plus.
Les équipes d’IA ont choisi le stockage objet pour les mêmes raisons que tout le monde : faible coût et forte durabilité à une échelle quasi illimitée. La nouvelle exigence consiste à effectuer un travail utile sur ces données sans les déplacer : récupération à faible latence, analyses sur l’ensemble du corpus et découverte interactive, le tout exécuté sur les mêmes fichiers.
Fonctionnement du stockage objet
Pour comprendre le fonctionnement du stockage objet, il est utile de le comparer aux deux autres modèles de stockage utilisés par les logiciels. Le stockage de fichiers place les données dans des dossiers imbriqués. Le stockage par blocs divise les données en blocs de taille fixe sur un disque. Le stockage objet conserve chaque élément entier dans un conteneur plat appelé bucket, sans dossiers.
Pour stocker un fichier, le système prend les données, ajoute les métadonnées que vous lui fournissez et associe un ID. Les applications lisent, écrivent et suppriment des objets grâce à cet ID via une API HTTP. Il n’y a ni chemin de fichier ni point de montage.
PUT /my-bucket/embedding-batch-042.parquet     # stocker un objet
GET /my-bucket/embedding-batch-042.parquet     # le récupérer par ID
DELETE /my-bucket/embedding-batch-042.parquet  # le supprimer
La structure plate est ce qui permet au stockage objet de passer à l’échelle. Vous ajoutez de la capacité en ajoutant des machines au pool, et non en remaniant une arborescence de dossiers, de sorte qu’un seul bucket peut croître presque sans limite.
Principaux services de stockage objet
| Service | Fournisseur | Standard d’API |
|---|---|---|
| Amazon S3 | AWS | S3 (le standard de facto) |
| Cloud Storage | Google Cloud | Compatible S3 + natif |
| Blob Storage | Microsoft Azure | Natif + passerelles compatibles S3 |
| MinIO / Ceph | Auto-hébergé (open source) | Compatible S3 |
Amazon S3, lancé par AWS en 2006, a établi l’API de stockage objet que le reste du secteur copie désormais. Il offre la plus large gamme de classes de stockage, de S3 Standard pour les données fréquemment consultées à S3 Glacier Deep Archive pour le stockage froid à long terme, et sa classe S3 Intelligent-Tiering déplace automatiquement les objets vers des niveaux moins coûteux à mesure que leurs modèles d’accès changent.
Google Cloud Storage donne accès à ses quatre classes de stockage, Standard, Nearline, Coldline et Archive, via un seul bucket et une seule API. Sa fonctionnalité Autoclass surveille le modèle d’accès de chaque objet et le déplace d’elle-même entre ces classes, ce qui supprime le travail consistant à écrire manuellement des règles de cycle de vie.
Azure Blob Storage est le stockage objet de Microsoft, avec quatre niveaux d’accès, Hot, Cool, Cold et Archive, définis par blob ou par compte. Sa couche distinctive est Azure Data Lake Storage Gen2, un espace de noms hiérarchique construit au-dessus de Blob qui ajoute de vrais répertoires et des autorisations au niveau des fichiers, donnant aux moteurs d’analyse une sémantique de système de fichiers au coût du stockage objet. Blob expose la propre API d’Azure plutôt que S3, de sorte que les outils S3 se connectent via une passerelle de compatibilité.
MinIO et Ceph sont la façon open source d’exécuter un stockage objet compatible S3 sur votre propre matériel, dans un cloud privé ou dans un environnement isolé. MinIO est léger et exclusivement objet, conçu pour un haut débit et courant dans les clusters Kubernetes. Ceph est un système unifié qui fournit du stockage objet, bloc et fichier à partir d’un seul cluster, exposant l’API S3 via sa RADOS Gateway. Les deux permettent aux applications écrites pour S3 de continuer à fonctionner sans réécriture.
Principales fonctionnalités et limites du stockage objet
La conception du stockage objet lui donne un ensemble clair d’atouts et un ensemble clair de limites.
Principales fonctionnalités du stockage objet
Évolue presque sans limite. Un seul bucket contient autant d’objets que nécessaire. Vous ajoutez de la capacité en écrivant plus de données, et vous ne payez que ce que vous stockez, sans cluster à dimensionner à l’avance.
Durable et résilient. Les stockages objet conservent des copies de chaque objet sur plusieurs machines, souvent entre centres de données ou régions. Amazon S3 est conçu pour onze neuf (99,999999999 %) de durabilité, chaque objet étant stocké sur au moins trois Availability Zones.
Peu coûteux, avec des niveaux. Les prix par gigaoctet sont nettement inférieurs à ceux du stockage bloc ou fichier, et les données froides passent automatiquement à des niveaux moins coûteux.
Contient n’importe quelles données, avec des métadonnées riches. Un bucket peut contenir tout type de données non structurées, et chaque objet porte des métadonnées que vous définissez. Vous pouvez trouver et filtrer les objets selon ces métadonnées, quel que soit le type de fichier.
Ouvert et facile d’accès. Les objets sont lus via une simple API HTTP. L’API S3 est une norme de facto, de sorte que de nombreux outils lisent les mêmes buckets sans connecteurs spéciaux.
Limites du stockage objet
Plus lent que le stockage bloc. Chaque requête passe par HTTP, ce qui rend le stockage objet peu adapté aux charges de travail à faible latence, à accès aléatoire ou aux bases de données transactionnelles.
Pas de modification sur place. Vous remplacez un objet entier plutôt que d’en modifier une partie, ce qui rend le stockage objet mal adapté aux données qui changent souvent.
Les petites lectures deviennent coûteuses. Une charge de travail qui effectue de nombreuses très petites lectures peut générer des frais d’API importants même lorsque les données elles-mêmes sont petites.
Pas de couche intégrée de récupération ou d’analyse. Le stockage objet stocke et sert des octets. Prêt à l’emploi, il n’a pas d’index, pas de moteur de requête, pas de recherche de similarité. AWS S3 Vectors (généralement disponible en décembre 2025) a ajouté une couche vectorielle native, et S3 Select peut exécuter des requêtes légères, mais tout ce qui va au-delà de « récupérer cet objet par ID » nécessite encore généralement une couche de requête ou d’index par-dessus.
Cas d’utilisation, et le pont vers l’IA
L’échelle, la durabilité et le faible coût du stockage objet en font l’emplacement par défaut de nombreuses charges de travail :
Lacs de données (la base de stockage standard)
Sauvegarde et reprise après sinistre
Archives à long terme
Stockage et diffusion de médias
Journaux et données d’analyse
Jeux d’entraînement de ML (les grands ensembles de données à partir desquels les modèles apprennent)
La recherche IA demande désormais au stockage objet de faire plus que conserver des données. Les embeddings sont les vecteurs numériques derrière la recherche sémantique et la génération augmentée par récupération (RAG). Ils sont extrêmement nombreux, chacun est volumineux, et les stocker dans une base de données spécialisée devient coûteux.
Les équipes ont donc commencé à conserver les embeddings directement dans le stockage objet. Amazon S3 Vectors, disponible de manière générale depuis décembre 2025, ajoute à S3 un stockage et une recherche vectoriels natifs. AWS affirme que cela réduit le coût de stockage et d’interrogation des vecteurs jusqu’à 90 % par rapport aux bases de données vectorielles spécialisées, prend en charge jusqu’à deux milliards de vecteurs par index, et répond aux requêtes fréquentes en environ 100 millisecondes et aux requêtes rares en moins d’une seconde.
Le problème tient à la vitesse et à l’étendue. Le stockage objet peut désormais conserver et rechercher des vecteurs à moindre coût, mais le faire avec une latence de production, pour la récupération, la découverte et l’analytique, tout en gardant les données dans le stockage objet sans jamais les copier dans un magasin rapide séparé, est la partie difficile.
Le stockage objet dans l’infrastructure IA
Le stockage objet est l’endroit où résident les données IA. La plupart de ce qu’une application IA manipule, comme les embeddings, les médias d’entraînement, les artefacts de modèles et les journaux de conversation, est volumineux, non structuré et peu pratique à conserver dans un système spécialisé à grande échelle. Le stockage objet les conserve pour une fraction du coût, à n’importe quelle taille, et reste accessible à tout moteur capable de parler HTTP.
Mais trois charges de travail sollicitent ces données, et chacune est difficile à servir par le seul stockage objet :
- récupération en temps réel (trouver les K embeddings les plus similaires pour une requête, en millisecondes),
- découverte itérative (permettre à des humains ou à des agents d’explorer le jeu de données de manière interactive),
- analytique par lots (exécuter de grands traitements sur l’ensemble du corpus).
Aujourd’hui, les équipes gèrent cela en plaçant chaque charge de travail dans son propre système : une base de données vectorielle pour la récupération, un moteur OLAP pour l’analytique, un outil d’exploration de jeux de données pour la découverte. Cela signifie plusieurs systèmes à exploiter, plusieurs copies de données à maintenir synchronisées, et des pipelines ETL qui déplacent les données entre eux à mesure que les charges de travail évoluent.
À lui seul, le stockage objet ne sert pas bien ces trois charges de travail. Il ne possède pas d’index vectoriel, donc la recherche de similarité doit se faire dans un système séparé. Il ne dispose pas de récupération sélective à une granularité inférieure au fichier, donc même une petite requête extrait des fichiers entiers via HTTP. Il n’a pas de couche de cache, donc chaque requête supporte l’aller-retour complet vers le stockage objet.
Zilliz Vector Lakebase est disponible en version Public Preview
Zilliz Vector Lakebase est une plateforme conçue pour combler directement ces trois lacunes du stockage objet. Elle ajoute un index vectoriel qui réside sur le stockage objet aux côtés des données, des lectures de requêtes qui ne récupèrent que les pages d’index et les fragments de données touchés par une requête, et un cache hiérarchisé devant le stockage objet. Il en résulte une plateforme unique qui prend en charge la récupération en temps réel, la découverte itérative et l’analytique par lots sur les mêmes données dans le stockage objet, sans les copier entre systèmes.
Vector Lakebase est l’évolution de Zilliz Cloud, d’une base de données vectorielle managée vers une plateforme de données sémantiques native du lac. Ses capacités principales comprennent :
External Collections. Pointez vers les tables de lac que vous possédez déjà, en Lance, Apache Iceberg, Apache Parquet, ou dans son propre format Vortex, et exécutez une recherche vectorielle dessus sur place, sans copie de données.
Tiered Serving. Trois niveaux de service (Performance-Optimized en mémoire, Capacity-Optimized en mémoire plus NVMe local, Tiered-Storage couvrant la mémoire, le NVMe local et le stockage objet) alignent le coût sur la latence de la charge de travail.
On-Demand Search. Le calcul passe à zéro lorsqu’il est inactif, de sorte que les charges de travail avec des requêtes par à-coups ou peu fréquentes paient pour ce qu’elles exécutent plutôt que pour une capacité toujours active.
Unified Lake-Native Storage. Le format Vortex associe les vecteurs à leurs métadonnées dans un seul fichier colonnaire que la plateforme peut servir et analyser directement, sans assemblage entre plusieurs formats.
Dans le benchmark de Zilliz sur une table Iceberg d’un milliard de vecteurs, la latence des requêtes dépend de l’état du cache : un scan Spark en force brute sans index prend des heures ; à froid, avec l’index tout juste construit en environ 20 minutes, les requêtes aboutissent en gros en 30 secondes ; à chaud, depuis le cache SSD local, en dizaines de millisecondes ; très chaud, depuis la mémoire, en quelques millisecondes. Dans un benchmark Zilliz distinct portant sur 3 millions de lignes de vecteurs à 128 dimensions sur S3, avec 256 lecteurs concurrents lisant des lots de 10 lignes, le format Vortex a déplacé environ 135 fois moins de données par lecture que Parquet, passant de 9,44 Mo par lecture à 0,07 Mo.
Zilliz Vector Lakebase est désormais en aperçu public. Si votre stack actuel sépare le service et la découverte en systèmes distincts, Vector Lakebase pourrait valoir le détour. Essayez-le sur Zilliz Cloud — les nouvelles inscriptions avec une adresse e-mail professionnelle bénéficient de 100 $ de crédits gratuits — ou parlez-nous de votre cas d’usage.
Ce modèle dépasse largement un seul produit. Le stockage objet devient un lieu où les données d’IA sont recherchées directement, en plus d’être l’endroit où elles sont stockées.
Foire aux questions
Le stockage objet est-il adapté aux charges de travail d’IA ?
Oui, pour stocker des données d’entraînement, des embeddings et des artefacts de modèles à grande échelle, là où sa durabilité, sa capacité quasi illimitée et son faible coût sont avantageux. La limite est la vitesse : pour récupérer, explorer ou analyser rapidement ces données, vous avez besoin d’un index et d’une couche de calcul au-dessus du stockage brut.
Quels sont des exemples de stockage objet ?
Les stockages objet cloud les plus utilisés sont Amazon S3, Google Cloud Storage et Azure Blob Storage. Pour les déploiements auto-hébergés, MinIO et Ceph sont les standards open source. Tous les cinq exposent les données via une API HTTP, et l’API de S3 est devenue un standard de facto, si bien que les applications écrites pour S3 fonctionnent souvent avec les autres moyennant seulement de légers ajustements.
Quelle est la différence entre le stockage objet et une base de données vectorielle ?
Le stockage objet est un stockage généraliste pour toutes les données non structurées, accessibles par ID. Une base de données vectorielle est conçue pour la recherche de similarité sur des embeddings, avec des index optimisés pour des requêtes rapides de plus proches voisins. Les deux convergent : les équipes conservent de plus en plus les vecteurs dans le stockage objet et ajoutent une couche de recherche au-dessus.
Peut-on exécuter une recherche vectorielle directement sur le stockage objet ?
De plus en plus, oui. AWS S3 Vectors ajoute la recherche vectorielle native, et les plateformes qui pointent directement vers des tables de lake vous permettent de rechercher des données en stockage objet sans les copier ailleurs. Les requêtes s’exécutent plus lentement qu’avec un index en mémoire, mais le coût est bien inférieur, et les données n’ont pas besoin d’être déplacées.
Pourquoi les data lakes utilisent-ils le stockage objet ?
Un data lake doit contenir d’énormes volumes de données structurées et non structurées de manière économique et durable, dans des formats ouverts, accessibles par de nombreux moteurs à la fois. Le pool plat du stockage objet, adressé par ID, répond mieux à ce besoin que le stockage fichier ou bloc.
Le stockage objet est-il plus lent que le stockage bloc ?
Pour une opération unique, généralement oui. Le stockage bloc offre une latence très faible pour les travaux transactionnels et à accès aléatoire. Le stockage objet échange cela contre du débit, de la durabilité et un coût réduit sur de grands objets majoritairement statiques lus via HTTP. L’écart se réduit pour les grandes lectures séquentielles, mais reste important pour les petites opérations sensibles à la latence.
- Points clés
- Qu’est-ce que le stockage objet
- Fonctionnement du stockage objet
- Principales fonctionnalités et limites du stockage objet
- Cas d’utilisation, et le pont vers l’IA
- Le stockage objet dans l’infrastructure IA
- Zilliz Vector Lakebase est disponible en version Public Preview
- Foire aux questions
Contenu
Commencez gratuitement, évoluez facilement
Essayez la base de données vectorielle entièrement managée conçue pour vos applications GenAI.
Essayer Zilliz Cloud gratuitement