OpenArt propulse la recherche multimodale pour plus de 8 millions de créateurs de vidéos IA avec Zilliz Cloud.
25 s → 300 ms
Latence de recherche P99, ES → Zilliz
~85% inférieur
Calculer le coût après la migration
Recherche multi-vecteurs native
Vecteurs d'image et de texte interrogés ensemble
456M
Vecteurs migrés sans ré-encodage
Les créateurs ne font pas une seule image puis s'en vont. Ils construisent un personnage, un monde, une histoire, et tout ce qu'ils ont jamais généré devient matière pour la scène suivante. Zilliz Cloud nous permet de traiter toute cette bibliothèque comme une seule mémoire créative.
John Qiao
À propos d'OpenArt
OpenArt est l'une des plateformes de génération d'images et de vidéos par IA les plus utilisées au monde, avec plus de 8 millions de créateurs — passionnés, spécialistes du marketing et professionnels du divertissement en activité. Elle réunit plus de 100 modèles de Google, OpenAI, Seedance et d'autres dans un canevas unique, mais les modèles n'en sont que la partie générique. Ce qu'OpenArt construit par-dessus, c'est la continuité : un Character Builder qui conserve un personnage à travers les scènes, One-Click Story pour les récits multi-scènes, et une suite de storyboards que les créateurs utilisent pour réaliser des bandes-annonces, des publicités et des vidéos sociales. L'ambition derrière tout cela est de rendre la propriété intellectuelle native de l'IA accessible à tout créateur — des personnages et des mondes qui persistent et évoluent, plutôt que des images qui ne persistent pas.
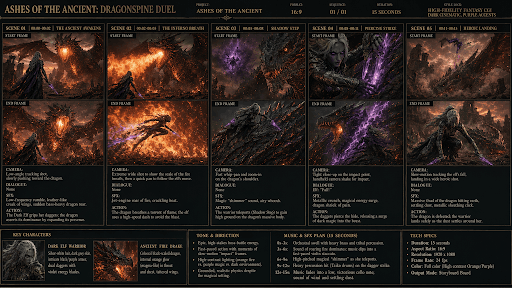
La continuité est la partie difficile, et pas seulement au moment de la génération. Le défi de la vidéo par IA ne consiste pas à produire quinze bonnes secondes — il consiste à produire les quinze suivantes et à les faire appartenir à la même histoire. Cela a aussi une conséquence en aval : les créateurs reviennent dans un monde pendant des mois, et tout ce qu'ils ont généré devient une référence pour la scène suivante. Le catalogue personnel d'un créateur doit pouvoir être retrouvé par le sens plutôt que par le nom de fichier ou la date, et c'est là qu'OpenArt exploite Zilliz Cloud.
Le défi
La recherche des créateurs d'OpenArt reposait sur la recherche vectorielle d'Elasticsearch. Elle a tenu tant que la bibliothèque était petite. Quand l'historique de génération a dépassé quelques centaines de millions de vecteurs, quatre choses ont cassé.
- La latence de recherche P99 a atteint 25 secondes. La gestion du cycle de vie des index d'Elasticsearch est conçue pour les données de journaux : elle a donc fait passer les index d'OpenArt de chaud à tiède à froid à gelé environ tous les 90 jours, et la majeure partie du corpus s'est retrouvée gelée — mais la recherche vectorielle a un schéma d'accès opposé, car classer un top K signifie tout scorer. Chaque recherche atteignait le niveau gelé et rapatriait les données sur le réseau pour y répondre.
- Le nombre d'index a augmenté de façon exponentielle. Elasticsearch créait au moins un nouvel index tous les 90 jours et ne les fusionnait jamais, si bien que le nombre d'index sur lesquels une requête devait se répartir ne cessait de se multiplier. Pour une bibliothèque qui ne fait que grandir, l'équipe prévoyait une dégradation marquée de la recherche d'ici environ deux ans.
- OpenArt payait pour une plateforme de recherche entière afin d'utiliser une seule fonctionnalité limitée. De plus, le cluster était surdimensionné parce que l'équipe l'avait dimensionné avant de mesurer les besoins réels de la charge de travail.
- La récupération multi-vecteurs a dû être construite à la main. Elasticsearch n'avait aucun moyen natif d'interroger simultanément un vecteur d'image et un vecteur de texte. OpenArt a donc dû écrire son propre algorithme double kNN et intégrer des composants tiers pour exécuter les deux recherches, fusionner les résultats et les filtrer — un élément de maintenance permanent pour une capacité qui n'est pas le différenciateur d'OpenArt.
Pourquoi Zilliz Cloud
L'équipe d'ingénierie d'OpenArt a évalué Pinecone et Qdrant, et ni l'un ni l'autre ne convenait. L'équipe avait également utilisé Milvus en interne aux débuts de l'entreprise et l'appréciait ; ce qui l'avait écarté à l'époque, c'était la charge opérationnelle de l'auto-hébergement. Zilliz Cloud a levé cette objection : il est développé par la même équipe que Milvus open source et est 100% compatible avec les API Milvus, de sorte que les connaissances existantes de l'équipe et son code client ont été réutilisés.
Les benchmarks effectués sur les propres données d'OpenArt ont confirmé les performances, et l'évaluation s'est arrêtée là. Quatre choses distinguent Zilliz Cloud :
Une architecture conçue pour la manière dont la recherche vectorielle lit les données. Zilliz Cloud gère lui-même les niveaux de données en fonction de la température des données : il promeut les données dans le cache lorsqu'elles sont fréquemment récupérées ou les rétrograde vers un stockage froid lorsqu'elles ne sont pas nécessaires, sans politique de cycle de vie dont l'application doive se préoccuper, et la compaction automatique au niveau des segments fusionne les données en arrière-plan à mesure qu'elles croissent. Ces deux capacités répondent exactement aux modes de défaillance auxquels OpenArt était confronté — la traversée de niveaux figés et la prolifération illimitée des index — ainsi la recherche d'OpenArt ne ralentit pas à mesure que la bibliothèque grandit.
Recherche multi-vecteurs native. Une seule collection Zilliz Cloud contient plusieurs champs vectoriels et les interroge ensemble dans une seule requête, fusionnant les résultats selon une pondération configurable. C'est précisément la capacité qu'OpenArt construisait à la main sur Elasticsearch, et l'obtenir nativement est ce qui a permis à l'équipe de supprimer son propre code.
Tarification liée au calcul à la demande, et non aux données stockées. L'une des alternatives facturait selon le volume de données — le mauvais axe pour une archive créative, où le corpus croît sans cesse mais où seule une fraction est interrogée à un moment donné. Le modèle de calcul à la demande de Zilliz Cloud permet à OpenArt de dimensionner les performances dont il a besoin et de redimensionner à mesure que la charge de travail évolue, au lieu de payer une taxe sur l'historique.
Exploitable sans spécialiste de l'infrastructure. Un service managé doit rester utilisable au quotidien par les personnes qui l'utilisent. OpenArt a trouvé la console assez claire pour naviguer intuitivement, sans lire la documentation — un contraste saisissant avec une plateforme de recherche généraliste qui porte une décennie de fonctionnalités accumulées dont ils ne se serviraient jamais.
"Nous servons des millions de créateurs, donc chaque élément d'infrastructure doit être rapide, prévisible et n'avoir besoin de personne pour le surveiller. Zilliz Cloud est l'un des rares à avoir franchi cette barre du premier coup." — Danny Xiong, Ingénieur logiciel, OpenArt
La solution : comment Zilliz Cloud alimente OpenArt
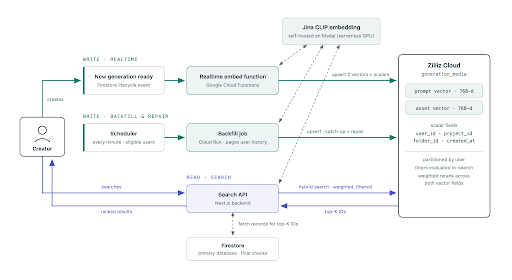
OpenArt utilise Zilliz Cloud pour exécuter la recherche vectorielle derrière la zone de recherche sur l'historique de générations d'un créateur, disponible pour les abonnés aux formules éligibles. Un créateur qui a réalisé des milliers d'images et de clips au fil des mois saisit une phrase — un nom de personnage, une ambiance, une scène — et retrouve ses propres travaux passés, classés par sens plutôt que par nom de fichier ou date.
Cette tâche est plus difficile qu'il n'y paraît, car une génération arrive sans métadonnées. Il n'y a ni titre, ni tag, ni dossier. Seuls deux artefacts la décrivent : le fichier lui-même et le prompt qui l'a générée. OpenArt indexe les deux, car chacun porte quelque chose que l'autre ne porte pas — le prompt contient ce que le créateur a demandé, en noms, en intention et en mots de style, et le fichier contient ce que le modèle a réellement produit, ce qui n'est souvent pas la même chose. Rechercher sur l'un seul perd la moitié de la bibliothèque.
OpenArt répartit le travail entre trois services.
- Son application et sa base de données principale s'exécutent sur Google Cloud.
- Son service d'embedding s'exécute sur Modal — un modèle Jina CLIP que l'équipe héberge elle-même sur une fonction GPU serverless.
- Le stockage et la récupération vectoriels vont à Zilliz Cloud. L'équipe conserve la couche de modèle sous son propre contrôle et délègue la couche qui doit passer à l'échelle.
La génération d'images et de vidéos par IA est créée en continu et recherchée bien plus tard, OpenArt a donc construit le système comme deux moitiés indépendantes qui s'exécutent à des moments et à des rythmes complètement différents.
- Le chemin d'écriture transforme chaque nouvelle génération en vecteurs et les dépose dans Zilliz Cloud. Il s'exécute constamment en arrière-plan, déclenché par les événements de création, et personne ne l'attend.
- Le chemin de lecture ne s'exécute que lorsqu'un créateur saisit du texte dans la zone de recherche. Il doit renvoyer un résultat en quelques centaines de millisecondes, car quelqu'un regarde un spinner.
Le côté écriture ne se trouve jamais sur le chemin des requêtes — le seul endroit où ils se rencontrent est la collection elle-même. C'est cette séparation qui fait que l'ingestion continue ne se manifeste jamais comme une latence de requête.
Le chemin d'écriture : comment OpenArt transforme une génération en deux vecteurs
- Un créateur abonné à un plan éligible génère une image ou un clip, et OpenArt en écrit un instantané dans sa base de données principale sur Google Cloud.
- Une fonction Google Cloud se déclenche sur cet événement et appelle le service d'embedding d'OpenArt sur Modal. Comme Jina CLIP projette les images et les textes dans le même espace vectoriel, un seul modèle fournit à l'équipe les deux vecteurs dont elle a besoin.
- OpenArt écrit ces deux vecteurs sur Zilliz Cloud — l'un pour l'actif généré, l'autre pour le prompt qui lui correspond — avec l'ID de génération et les champs scalaires sur lesquels le chemin de lecture appliquera des filtres : l'ID utilisateur et l'ID projet.
OpenArt traite la vidéo par le même chemin, en capturant une image instantanée de chaque clip généré et en en faisant un embedding en tant qu'image, de sorte que les clips sont récupérables aux côtés des images fixes, sans second pipeline.
En outre, la recherche est une fonctionnalité payante, donc l'intégralité du catalogue passé d'un créateur éligible doit devenir interrogeable, et pas seulement ce qu'il crée à partir de ce jour. Un job de backfill planifié s'exécute en continu en arrière-plan, parcourant les créateurs ayant un plan éligible et faisant passer l'historique de chacun par le même chemin d'embedding-écriture. Il sert aussi de filet de sécurité pour le pipeline : tout ce que le chemin temps réel ne parvient pas à écrire, le backfill le récupère lors d'un passage ultérieur.
Le chemin de lecture : comment OpenArt répond à une recherche
- Un créateur saisit une requête, et OpenArt l'envoie au même modèle hébergé sur Modal pour qu'il soit transformé en vecteur de requête.
- OpenArt émet une seule recherche multi-vecteurs vers Zilliz Cloud sur les deux champs vectoriels, avec des poids configurés entre eux, et les filtres utilisateur et projet attachés.
- Zilliz Cloud fusionne les deux ensembles de résultats, évalue les filtres à l'intérieur de la recherche plutôt qu'après, et renvoie le top K. OpenArt effectue une correspondance et un filtrage finaux contre sa propre base de données sur Google Cloud avant le rendu.
OpenArt demande plus d'un millier de résultats par requête — un top K inhabituellement grand pour la recherche sémantique, dicté par la charge de travail plutôt que par l'interface : pour un créateur prolifique, les actifs d'un seul projet dépassent déjà le millier, et une requête large comme "man" correspond légitimement à plusieurs fois ce nombre.
La même requête sur l'ancienne pile ne ressemblait en rien à cela. Elle se déployait sur chaque index que la politique de cycle de vie avait jamais créé, la plupart gelés, et ramenait des données via le réseau jusqu'à ce qu'elle puisse classer un top K. Sur Zilliz Cloud, OpenArt fait un seul appel à une seule collection et obtient une réponse en environ 300 millisecondes.
Comment OpenArt a regroupé deux recherches en une seule
Combiner les résultats d'image et de prompt est exactement ce pour quoi OpenArt avait construit à la main la couche de fusion dual-kNN sur Elasticsearch. Parce que Zilliz Cloud prend en charge nativement la recherche sur plusieurs champs vectoriels, l'équipe a supprimé ce code et a ré-exprimé la récupération comme une seule requête — puis a enveloppé la pondération entre les deux champs dans un feature flag. La pertinence est devenue quelque chose qu'OpenArt ajuste en production plutôt que quelque chose qu'il réimplémente.
Comment OpenArt a migré
OpenArt a déplacé un ensemble hérité d'environ 456 millions de vecteurs et a utilisé la bascule pour y effectuer une hygiène des données : supprimer les enregistrements dont le produit n'avait plus besoin et corriger les bogues que l'ancien chemin d'ingestion introduisait discrètement. Une décision de cadrage a permis de circonscrire le projet : l'équipe a conservé son modèle d'embedding existant. Ré-embedder des centaines de millions d'actifs aurait transformé une migration en une reconstruction. Parce que Zilliz Cloud stocke des vecteurs provenant de n'importe quel modèle choisi par le client, OpenArt a déplacé le stockage et la récupération sans toucher à la couche modèle.
Résultats et bénéfices
- La latence de recherche est passée de 25 secondes avec Elasticsearch à environ 300 millisecondes au P99 — environ 80× plus rapide, et la différence entre une barre de recherche que les créateurs évitent et une qu'ils utilisent.
- Coût de calcul réduit d'environ 85 % — la même charge de travail, sur un moteur conçu pour cela.
- OpenArt a retiré l'algorithme de fusion artisanal du pipeline de production. Grâce à la recherche multi-vecteurs native dans Zilliz Cloud, le code dual-kNN et ses éléments de colle tiers ont disparu, et ajuster la pertinence est un changement de configuration plutôt qu'un projet d'ingénierie.
- 456 millions de vecteurs ont été déplacés vers Zilliz Cloud sans relancer un seul embedding car Zilliz Cloud est indépendant du modèle — ce qui fait de la migration une migration plutôt qu'une reconstruction.
Le bénéfice stratégique est celui qu'OpenArt ressent le plus : la recherche a cessé d'être un projet d'infrastructure. La capacité d'ingénierie qui avait été consacrée à maintenir la récupération en vie est revenue au produit — plus précisément, à la couche d'agent autour de laquelle OpenArt construit désormais toute son expérience.
Les conseils d'OpenArt aux équipes qui choisissent une base de données vectorielle
- Vérifiez que le modèle de tarification correspond à la forme de votre charge de travail. Demandez sur quoi vous êtes facturé, puis demandez lequel de vos chiffres croît le plus vite. Si ce sont les mêmes, vous avez un problème qui évolue avec votre succès.
- Vérifiez que l'architecture correspond à votre modèle d'accès. Lisez la conception du stockage, pas la liste des fonctionnalités. Une politique qui éloigne les données est acceptable pour les journaux et inappropriée pour la recherche vectorielle.
- Connaissez vos propres exigences de performance avant de provisionner. La plus grosse erreur de coût d'OpenArt a été de sur-provisionner du matériel pour une charge de travail qu'elle n'avait pas profilée. Mesurez d'abord.
- Considérez une migration comme une occasion de vous débarrasser de certaines choses. Tout ce que vous transférez, vous le payez et le parcourez pour toujours.
Prochaines étapes
OpenArt utilise Zilliz Cloud pour la recherche dans l'historique de génération d'un créateur aujourd'hui, et prévoit de l'étendre dans trois directions :
- La bibliothèque partagée d'actifs et de modèles, où le travail d'étiquetage de l'équipe et les modèles de recommandation ont tous deux besoin de recherche sémantique.
- Le filtrage scalaire, différé pendant la migration et qui remonte maintenant dans la liste.
- La mémoire d'agent, ce qui intéresse le plus l'équipe. Alors qu'OpenArt passe d'outils distincts à un agent qui les orchestre — transformant une génération de 15 secondes en un film d'une ou trois minutes — l'agent doit se souvenir, d'une session à l'autre, du projet dans lequel se trouve un créateur et de la marque pour laquelle il crée des publicités. C'est un problème de recherche vectorielle, et c'est là qu'OpenArt s'attend à voir son utilisation de Zilliz Cloud croître ensuite.
"OpenArt est en train de définir à quoi ressemble la création native IA : des millions de créateurs construisant des personnages et des histoires qui tiennent ensemble à travers les scènes. Nous sommes fiers que Zilliz Cloud soit la base de récupération derrière cela, et ravis de continuer à construire avec eux alors que leurs agents commencent à se souvenir." — James Luan, CTO, Zilliz
Essayez Zilliz Cloud gratuitement
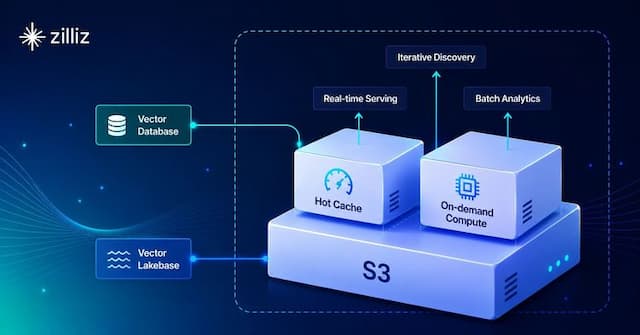
Zilliz Cloud est une base de données vectorielle et une base de lac vectorielle entièrement gérées pour l'IA d'entreprise, compatible avec les API Milvus. Elle offre une recherche vectorielle haute performance à grande échelle avec une sécurité de niveau entreprise et des opérations sans maintenance, enrichie de l'ouverture, de l'évolutivité et de l'économie des lacs de données multimodaux — une plateforme unique pour rechercher, analyser et gérer des données non structurées pour l'IA de production.
Que vous construisiez une recherche multimodale, un RAG ou une mémoire d'agent, Zilliz Cloud fournit la même base de récupération qui alimente OpenArt. Commencez gratuitement avec Zilliz Cloud, ou parlez-en à notre équipe.
« Notre ancien moteur de recherche mettait 25 secondes au P99. C'était inacceptable. Zilliz Cloud l'a ramené sous le tiers de seconde et nous a permis de supprimer le code de récupération que nous maintenions nous-mêmes. »
Danny Xiong