Consensus desarrolla búsqueda académica agéntica en 400M+ fuentes académicas con Zilliz Cloud
400M+
Fuentes académicas buscables
~45 ms
Latencia de recuperación densa P99 en producción
14% más alto
Precisión en los resultados de búsqueda tras añadir la búsqueda semántica
4× más grande
vectores por solo 2.5× el tamaño del clúster, sin penalización de latencia
1 día → 1 hora
Reindexación completa de toda la colección de vectores de 400M+ mediante importación masiva diaria
"Nuestro trabajo es hacer que la mejor investigación sea localizable para cualquiera que use Consensus. Zilliz Cloud le brinda a nuestro agente de investigación una recuperación semántica rápida y de alta calidad, ampliando directamente la evidencia a la que puede acceder."
Christian Salem
Acerca de Consensus
Consensus está construyendo el sistema operativo para la investigación científica: una plataforma de agentes utilizada por más de 10 millones de investigadores, estudiantes y clínicos en más de 12,500 universidades para seleccionar artículos, sintetizar evidencia y automatizar las partes tediosas de la investigación, para que puedan volver a la ciencia real. Consensus ha gestionado más de 150 millones de preguntas de investigación hasta la fecha y ha recaudado $45M para acelerar a los próximos 100 millones de investigadores en todo el mundo.
 Consensus插图1.png
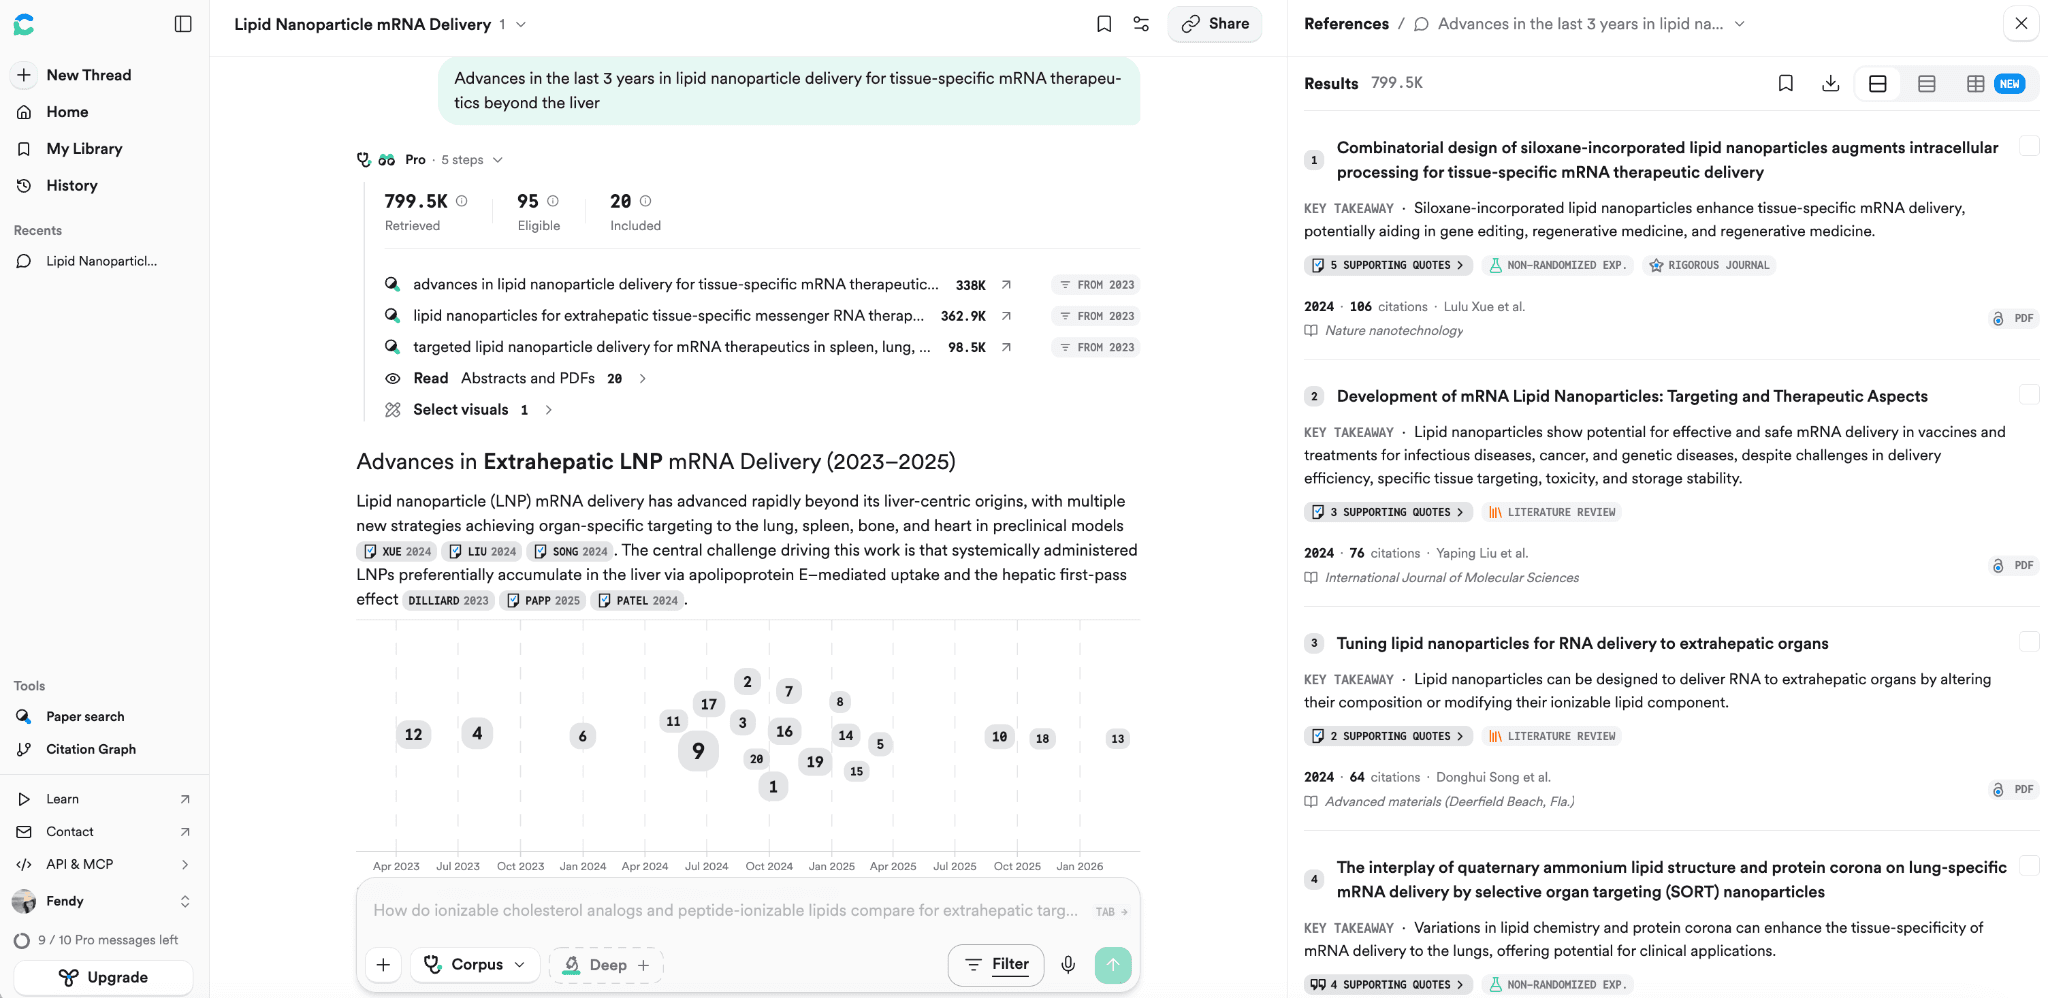
La base de la plataforma es una búsqueda agéntica de primer nivel en más de 400 millones de fuentes académicas. Consensus nunca responde desde el conocimiento propio del modelo de IA; en cambio, cada afirmación debe poder rastrearse hasta un artículo real recuperado, y el agente de investigación puede invocar la recuperación muchas veces para responder una sola pregunta. El producto es tan bueno como los artículos que encuentra, lo que convierte a la recuperación en el corazón de Consensus. Zilliz Cloud impulsa uno de sus componentes más importantes: la búsqueda semántica que entiende lo que un investigador realmente pregunta y muestra la investigación que la responde.
El Desafío
El motor de recuperación de Consensus anteriormente ejecutaba dos métodos de recuperación: búsqueda dispersa y búsqueda por palabras clave BM25. Manejaban bien la mayoría de las consultas. Pero el listón estaba subiendo: Consensus estaba trasladando su revisión de literatura a una arquitectura de agentes, donde una pregunta puede convertirse en muchas llamadas de recuperación, por lo que la recuperación tenía que encontrar los artículos correctos y devolverlos rápido, en cada llamada. La búsqueda por palabras clave y la búsqueda dispersa pierden artículos que dicen lo mismo pero con terminología diferente. Los investigadores se encuentran con esto constantemente porque el artículo que responde a una pregunta a menudo proviene de un campo vecino que usa sus propios términos para la misma idea. La búsqueda por vectores densos es clave para cerrar esa brecha, así que el equipo primero la probó en Elasticsearch y encontró tres problemas más.
- La calidad de recuperación disminuyó con cientos de millones de vectores. Para que cupieran tantos vectores densos, el equipo tuvo que comprimirlos con cuantización binaria, y la compresión costó una pérdida medible en la calidad del ranking. Para un producto de investigación, ese es el intercambio incorrecto.
- Reindexar toda la colección tomó más de 24 horas. La nueva investigación esperaba un día o más para poder ser buscable, y cada modelo de embeddings candidato costaba un día completo de evaluación en producción, lo que ralentizó la adopción de mejores modelos por parte del equipo.
- Hacer vectores más grandes significaba una factura de almacenamiento mucho mayor. Con cientos de millones de vectores, cada aumento en el tamaño o la cobertura de los vectores se paga en toda la colección, por lo que el equipo mantuvo sus vectores más pequeños de lo que quería.
El equipo buscó un motor diseñado específicamente para la recuperación semántica: alta calidad de ranking, actualizaciones rápidas de la colección, una economía viable a escala y una experiencia de producción gestionada que no tuvieran que operar ellos mismos.
Por qué Zilliz Cloud
Consensus realizó una verdadera prueba comparativa entre cuatro opciones: búsqueda de vectores densos dentro de Elasticsearch, que ya había ejecutado; FAISS, una biblioteca de vectores de código abierto auto-gestionada que había prototipado; Pinecone; y Zilliz Cloud. Zilliz Cloud ganó en cuatro aspectos.
- Mejores resultados sin comprimir los vectores. En las propias pruebas del equipo, Zilliz Cloud ofreció resultados de recuperación más precisos a escala de cien millones, manteniendo un recall alto, sin la compresión que antes había costado calidad.
- Reconstrucción completa de la colección en aproximadamente una hora, frente a más de un día. Una importación masiva diaria de toda la colección convierte la reconstrucción completa de un proyecto especial en un trabajo nocturno. Esto también permite una iteración mucho más rápida al probar nuevos modelos de embedding.
- Menor costo de almacenamiento para el mismo tráfico y la misma cantidad de vectores. Los ahorros permitieron vectores 4 veces más grandes y hasta 4 veces menos costo, lo que resultó en una relevancia notablemente mayor.
- Un servicio administrado, con una experiencia de desarrollador que al equipo le gustó. Consensus creó un prototipo con FAISS y lo encontró técnicamente capaz, pero ponerlo en producción habría significado asumir una carga de orquestación y operativa que al equipo no le interesaba asumir. El equipo también encontró que el SDK de Zilliz Cloud está bien documentado y es agradable para desarrollar, con una consola sencilla para las operaciones diarias de la colección.
La Solución
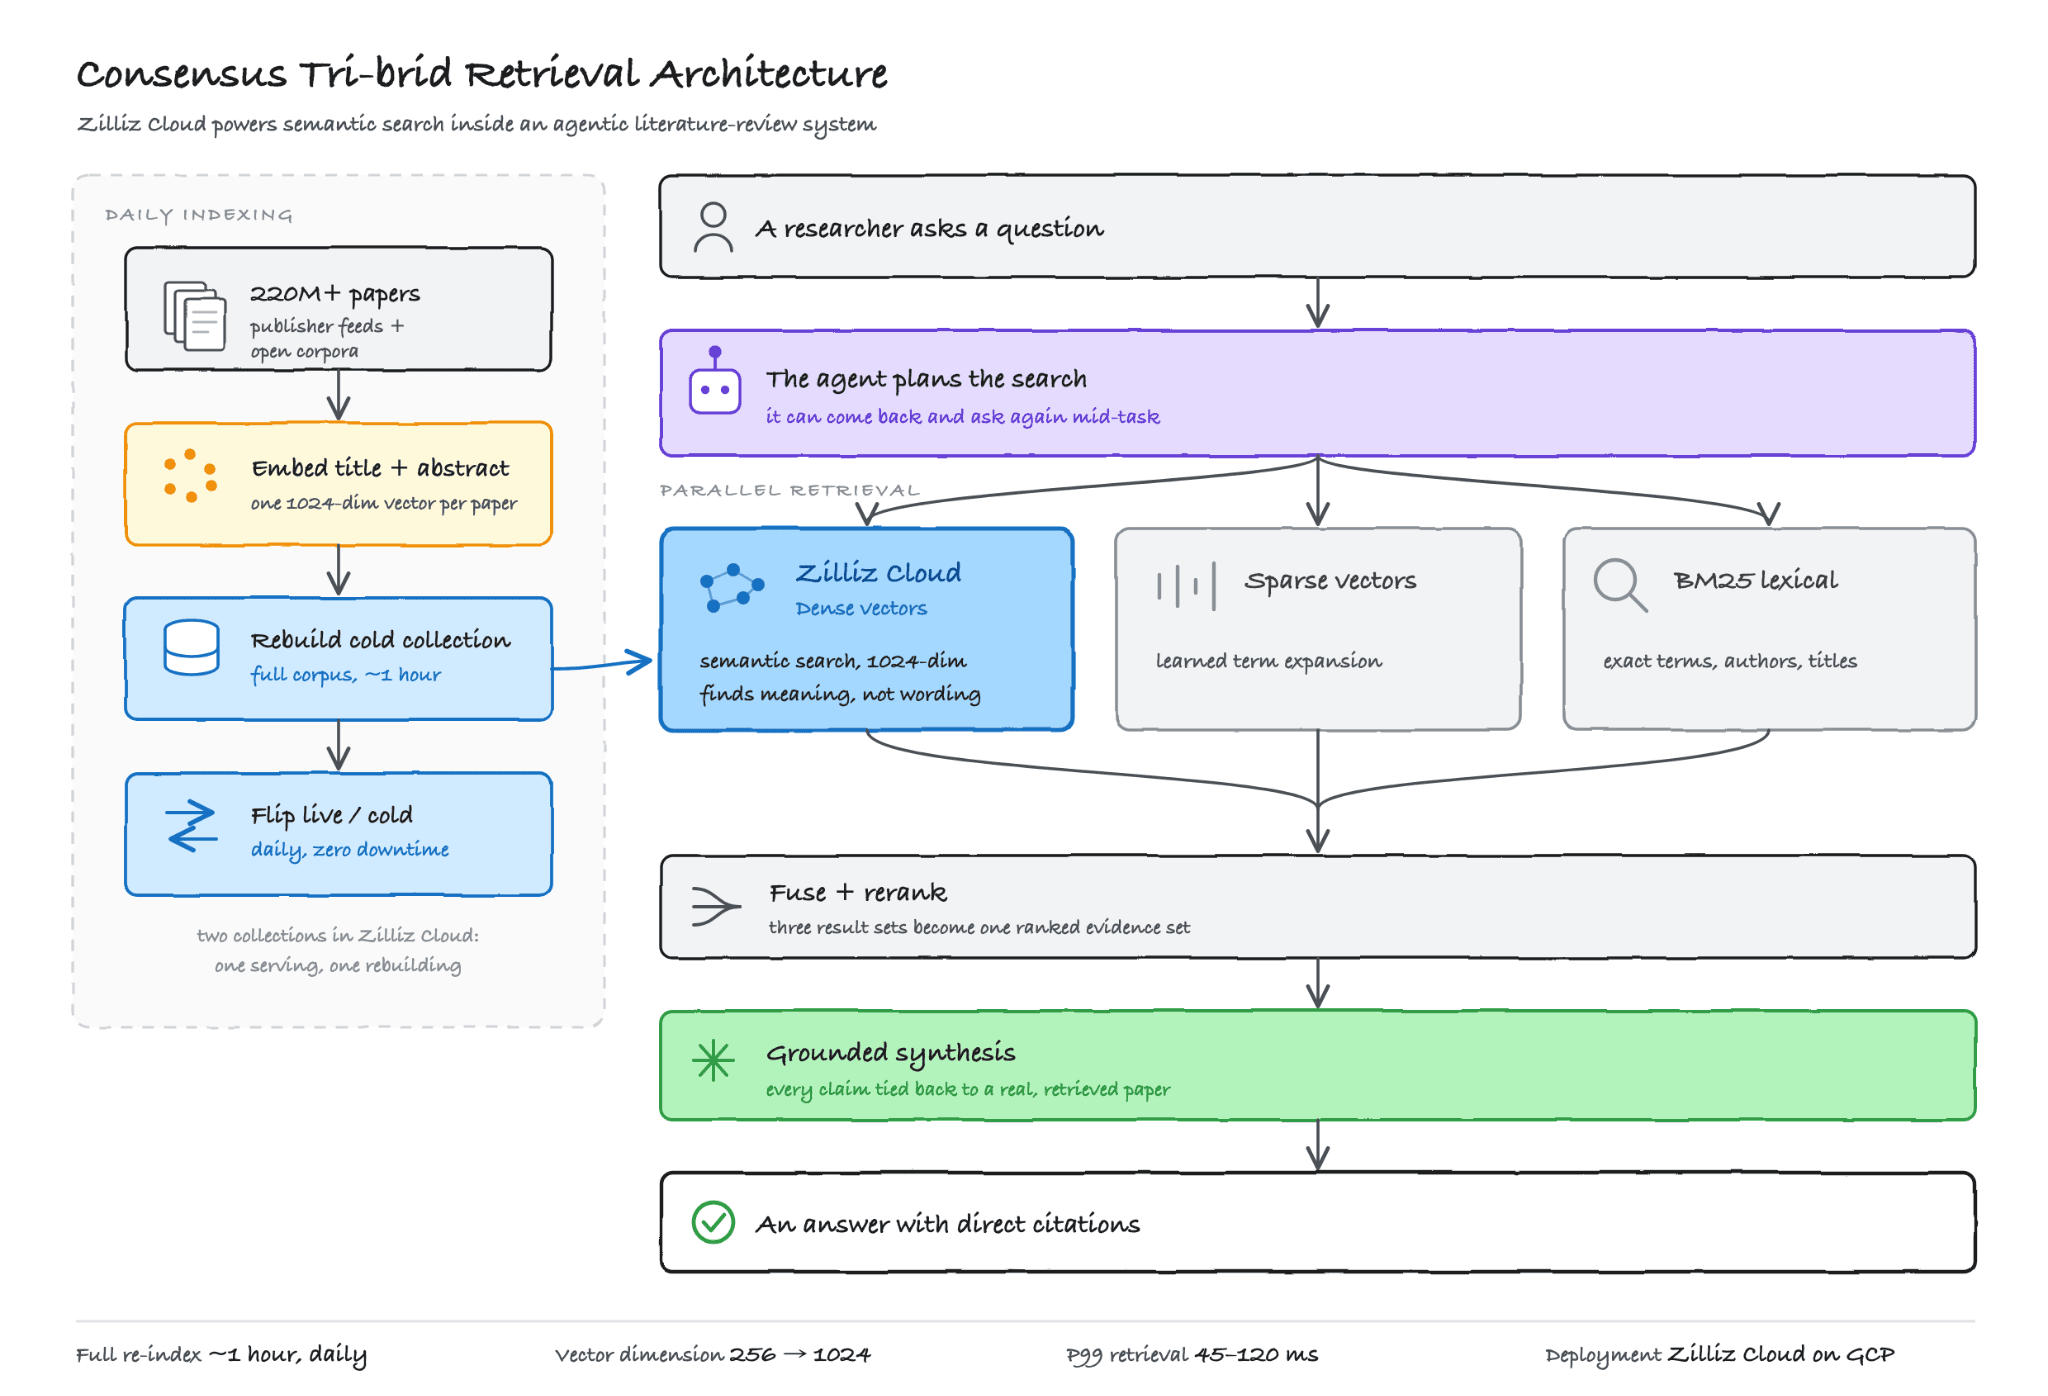
Consensus responde a una pregunta de investigación recuperando los artículos o fragmentos de artículos correctos y sintetizando una respuesta a partir de ellos, con cada afirmación citada de vuelta a una publicación real. Tres rutas de recuperación se ejecutan en paralelo para encontrar esos artículos, una arquitectura que el equipo llama búsqueda tri-brid, y Zilliz Cloud impulsa la capa de búsqueda semántica: emparejar una pregunta con un artículo por lo que significa en lugar de las palabras que usa, y encontrar los artículos que las otras rutas pasan por alto. Se ejecuta en Google Cloud junto con el resto de la pila.
 Concensus插图2.png
En el momento de la consulta, el agente planifica la búsqueda y llama a la recuperación como una herramienta. Las rutas se ejecutan de forma concurrente, sus resultados se fusionan y se reordenan en un único conjunto de evidencia, y el modelo escribe la respuesta, vinculando cada afirmación a un artículo recuperado. Esa es la maquinaria detrás del agente de revisión de literatura y del Consensus Meter, que sopesa la evidencia publicada a favor y en contra de una afirmación.
Tres decisiones de diseño hacen que esto funcione.
Un par de colecciones activa/en frío en Zilliz Cloud, reconstruidas desde cero todos los días.
La forma habitual de mantener un índice de este tamaño actualizado es actualizarlo en el lugar: detectar lo que ha cambiado, escribir los nuevos vectores, eliminar los antiguos y mantener la contabilidad en orden. Consensus se salta todo eso. Mantiene dos copias de la colección en Zilliz Cloud, más de 400 millones de vectores en total, una sirviendo consultas y otra inactiva, y cada día reconstruye la copia inactiva desde cero mediante importación masiva y la cambia a activa.
Ese diseño solo tiene sentido si una reconstrucción completa es lo bastante rápida como para ejecutarse a diario y el almacenamiento es lo bastante barato como para tener una segunda copia. En el sistema anterior, ninguna de las dos cosas era cierta. En Zilliz Cloud, ambas lo son: toda la colección se importa, indexa y queda lista en aproximadamente una hora, con un menor costo de almacenamiento. Así que el diseño más simple gana: nunca se escribe nada en la colección que sirve consultas, no hay acumulación que conciliar, y un nuevo modelo de embedding es simplemente la misma reconstrucción con vectores diferentes. El corpus está siempre actualizado, lo que garantiza que los investigadores siempre tengan acceso a las publicaciones más recientes.
"Lo que el equipo ha descubierto con Zilliz es que básicamente podemos volver a ingerir toda la colección desde cero, porque es muy rápido. Tenemos dos copias del índice; ingerimos todo en una hora y luego accionamos el interruptor. Básicamente podemos hacerlo a diario a estas alturas. Esto también ha facilitado enormemente la experimentación, ya que no hay dudas a la hora de probar nuevas ideas." — Heath Hohwald, Líder Técnico y Gerente de Búsqueda, Consensus
Un vector de 1.024 dimensiones por fuente académica.
Cada fuente se incrusta en un solo vector a partir de su título y resumen. El equipo comenzó con 256 dimensiones, asumiendo que el costo y la latencia crecerían en consonancia con el tamaño del vector. En Zilliz Cloud, cuadruplicar la dimensión de 256 a 1,024 requirió aproximadamente 2.5× el tamaño del clúster, no los 4× que el equipo esperaba, con muy poca latencia adicional. En el benchmark interno del equipo, los embeddings de 1,024 dimensiones lograron un aumento del 27% en la calidad de los artículos encontrados en comparación con el modelo más pequeño, por lo que Consensus adoptó 1,024.
Búsqueda semántica como una herramienta que el agente llama directamente.
Zilliz Cloud se expone al agente de revisión de literatura como una herramienta invocable, en lugar de ocultarse detrás de un único paso de recuperación. El agente puede reformular la pregunta, buscar desde varios ángulos y volver por más después de leer lo que encontró, por lo que una tarea puede implicar muchas llamadas. Este tipo de invocación de herramientas solo funciona si cada llamada es rápida y precisa, porque una búsqueda lenta o imprecisa se multiplica por cada llamada adicional que el agente hace. Con ~45 ms P99 en 400M+ vectores, la búsqueda semántica es lo suficientemente rápida y precisa como para entregársela al agente como herramienta, de modo que pueda rastrear los últimos artículos difíciles de encontrar que una sola consulta pasaría por alto.
Resultados y beneficios
- Hasta 4× menor costo de almacenamiento, y los ahorros se destinaron a una mejor búsqueda. El almacenamiento cuesta menos con el mismo tráfico y la misma cantidad de vectores, lo que creó el margen de maniobra que el equipo luego invirtió en calidad.
- 14% mayor precisión en los resultados de búsqueda tras añadir la búsqueda semántica, medido en el benchmark interno de Consensus. La mejora es más fuerte en los artículos que responden a una pregunta con palabras que el investigador nunca usó, que el stack anterior habría pasado por alto.
- Recuperación P99 en ~45 ms en 400M+ vectores, un tercio del objetivo P90 de 150 ms que el equipo fijó para Zilliz Cloud. Lo suficientemente rápida para que el agente de investigación busque, reflexione e itere varias veces en una sola solicitud, en lugar de tener una sola oportunidad y a veces perder resultados críticos.
- Dimensiones de vector 4x más grandes (256 → 1,024) costaron solo 2.5× el tamaño del clúster en Zilliz Cloud, aproximadamente un 40% menos que la escala lineal, sin penalización de latencia. En el benchmark interno de Consensus, los embeddings más grandes lograron un aumento del 27% en la calidad de los artículos encontrados.
- Una reconstrucción completa de toda la colección: 24+ horas → aproximadamente 1 hora, como una importación masiva diaria. Consensus ahora reconstruye e intercambia toda la colección a diario, sin interrupción del servicio. La nueva investigación se puede buscar el mismo día en que llega.
- El ciclo de iteración se acelera. Los embeddings más grandes, los nuevos modelos y las nuevas estrategias de recuperación ya no tienen que sopesarse contra una reconstrucción de un día entero antes de que alguien pueda ver si ayudan.
Próximos pasos
Cada dirección hacia la que se dirige Consensus pone más peso sobre Zilliz Cloud. Exponer la búsqueda semántica de manera más amplia a través del marco agéntico significa más llamadas de recuperación por tarea y más tráfico contra la colección densa. Los nuevos modelos de embeddings seguirán lanzándose en la cadencia diaria que hace posible la reconstrucción de una hora. El filtrado por metadatos, actualmente gestionado en la capa de aplicación, es candidato para migrar a Zilliz Cloud.
La mayor oportunidad es aprovechar aún más el contenido de texto completo. Consensus posee contenido de texto completo con licencia a través de sus alianzas con editoriales, y llevar esa profundidad a la colección densa de Zilliz es un paso natural: indexar el cuerpo de cada artículo en lugar de su título y resumen multiplicaría la colección varias veces y daría a los investigadores una coincidencia mucho más granular.
«Consensus está haciendo algo genuinamente difícil: hacer que la literatura científica del mundo sea buscable por significado, para un agente que puede preguntar al mismo corpus de una docena de formas diferentes en una sola tarea. Estamos orgullosos de que Zilliz Cloud sea la base de recuperación que lo sustenta, y estamos entusiasmados de seguir construyendo juntos a medida que la investigación agéntica escala.» — James Luan, CTO de Zilliz
Construye IA agéntica con Zilliz Cloud
Los sistemas agénticos ejercen nueva presión sobre la recuperación: una sola solicitud de usuario puede convertirse en varias búsquedas semánticas, reformulaciones y pasadas de recopilación de evidencia. Ya sea que estés escalando RAG o construyendo búsqueda agéntica, Zilliz Cloud te brinda la misma base de recuperación que impulsa a Consensus.
Comienza con Zilliz Cloud de forma gratuita, o habla con nuestro equipo directamente.
"Uno de los mayores logros que hemos visto es un mejor manejo de las consultas que son semánticamente, pero no textualmente, relevantes. Las consultas más largas y conversacionales también han mejorado drásticamente."
Heath Hohwald