Desarrollo de RAGs basado en métricas
En una presentación reciente en el Zilliz Unstructured Data Meetup, Jithin James y Shahul Es, mantenedores de Ragas, compartieron ideas sobre cómo aprovechar el desarrollo basado en métricas para evaluar sistemas de Generación Aumentada por Recuperación (RAG). Los desarrolladores pueden ajustar sus sistemas en función de los resultados de la evaluación para obtener un mejor rendimiento.
En su charla, Jithin y Shahul hablaron tanto de los fundamentos teóricos como de las aplicaciones prácticas de la evaluación de sistemas RAG. Explicaron cómo comprender la teoría detrás del código de evaluación puede proporcionar una visión más profunda de su funcionalidad. Después de esta parte, demostraron el proceso de evaluación utilizando un sistema RAG real impulsado por Milvus, una base de datos vectorial de código abierto líder conocida por su eficiencia en la búsqueda por similitud y las aplicaciones de IA.
Para una comprensión más detallada, mira la repetición de la charla del meetup.
Cómo evaluar el rendimiento de los sistemas RAG
Shahul abordó cómo Ragas calcula la veracidad de una respuesta generada por el sistema RAG. Esta es una métrica de evaluación crucial, ya que la respuesta es lo que ve el usuario final. Vayamos un poco más despacio y profundicemos. Ragas utiliza la siguiente fórmula para calcular la veracidad de una respuesta:
 Fig 1- Fórmula de cálculo de la métrica answer_truthfulness de Ragas
Cálculo de la corrección de la respuesta en sistemas de Generación Aumentada por Recuperación (RAG)
El proceso implica dos métricas principales: similitud factual y similitud semántica. Estas métricas ayudan a determinar la calidad y relevancia de la respuesta generada en comparación con la verdad fundamental.
Métricas clave
Similitud factual:
- Esta métrica mide la corrección factual de la respuesta generada comparando la presencia de información factual entre la verdad fundamental y la respuesta generada.
Similitud semántica:
- Esta métrica mide cuán semánticamente similar es la respuesta generada a la verdad fundamental, asegurando que el significado transmitido por la respuesta generada se alinee con la verdad fundamental.
Pasos para calcular la corrección de la respuesta
Identificar verdaderos positivos (TP), falsos positivos (FP) y falsos negativos (FN):
Verdaderos positivos: Enunciados correctamente presentes tanto en la verdad fundamental como en la respuesta generada.
Falsos positivos: Enunciados presentes en la respuesta generada pero no en la verdad fundamental.
Falsos negativos: Enunciados presentes en la verdad fundamental pero no en la respuesta generada.
Calcular la puntuación F1:
- La puntuación F1 es una media de precisión y exhaustividad, proporcionando un equilibrio entre ambas. La fórmula para la puntuación F1 se muestra en la Figura 1.
Ejemplo práctico
Considera un enunciado de verdad fundamental y una respuesta generada:
Verdad fundamental: "Alan Turing desarrolló el concepto de la máquina de Turing."
Respuesta generada: "Alan Turing es conocido por desarrollar el concepto de la máquina de Turing y la inteligencia artificial."
Paso 1: Identificar TP, FP y FN
Verdaderos positivos (TP):
- "Alan Turing desarrolló el concepto de la máquina de Turing."
Falsos positivos (FP):
- "Alan Turing es conocido por desarrollar la inteligencia artificial."
Falsos negativos (FN):
- Ninguno (ya que la respuesta generada incluye todos los elementos de la verdad fundamental).
Paso 2: Calcular la puntuación F1
TP = 1
FP = 1
FN = 0
F1 = 1 / (1 + 0.5 * (1 + 0))
= 1 / 1.5
≈ 0.67
Interpretación<
Similitud factual: La respuesta generada es factualmente correcta, ya que incluye la información esencial de la verdad fundamental.
Similitud semántica: La respuesta generada mantiene la alineación semántica con la verdad fundamental, aunque incluye información adicional.
La puntuación F1 combina estos aspectos para proporcionar una medida de la corrección de la respuesta, equilibrando la precisión y la exhaustividad. Este método ayuda a evaluar qué tan bien la respuesta generada coincide con la verdad de referencia en términos tanto de contenido factual como de significado general.
Pero la veracidad de la respuesta no es la única métrica que puedes usar para evaluar tus sistemas rag. Otras métricas son la fidelidad, la relevancia de la respuesta, la exhaustividad del contexto y la precisión del contexto. Veamos de forma práctica cómo puedes evaluar y mejorar un sistema RAG impulsado por Mivus.
Evaluación y mejora de un sistema RAG impulsado por Milvus
Ahora que has comprendido la base teórica para evaluar sistemas RAG, profundicemos en un ejemplo práctico de RAG construido con la base de datos vectorial Milvus. Recorreremos la configuración, implementación y evaluación de un sistema RAG. Según los resultados, luego veremos cómo podemos mejorar el sistema.
Configuración del entorno
Primero, necesitamos configurar nuestro entorno de desarrollo. Para hacerlo, primero, instala todas las bibliotecas requeridas:
!pip install pymilvus[model] ragas langchain langchain_openai python-dotenv nest_asyncio pypdf langchain_community
Desglosemos cuál será el uso de cada biblioteca en el código:
Pymilvus[model]te ayudará a conectarte a Milvus, crear colecciones, insertar datos y realizar búsquedas de similitud.Ragasproporcionará métricas de evaluación, generará conjuntos de prueba sintéticos y evaluará pipelines RAG.Langchaincargará documentos, los dividirá en fragmentos y preparará datos de texto para incrustación y consulta.Langchain_openaiinteractuará con los modelos de OpenAI, generará incrustaciones y responderá preguntas mediante llamadas a la API.Python-dotenvcargará variables de entorno desde un archivo .env para gestionar información confidencial como claves de API.Nest_asynciohabilitará operaciones asíncronas anidadas dentro de entornos síncronos. Especialmente si estás usando notebooks de Jupiter.Pypdfcargará documentos PDF, extraerá contenido y preparará texto para su procesamiento.Langchain_communityproporcionará cargadores de documentos adicionales y utilidades para integrar recursos aportados por la comunidad. Después de instalar las bibliotecas, impórtalas en tu código y configura tus claves de API:
import os

import pandas as pd

import nest_asyncio

import openai

from pymilvus import MilvusClient, model

from ragas import evaluate

from ragas.metrics import (

    faithfulness,

    answer_relevancy,

    context_recall,

    context_precision,

    answer_correctness,

)

from ragas.testset.generator import TestsetGenerator

from ragas.testset.evolutions import simple, reasoning, multi_context

from langchain_community.document_loaders import DirectoryLoader

from langchain.document_loaders import PyPDFLoader

from langchain_openai import ChatOpenAI, OpenAIEmbeddings

from dotenv import load_dotenv

from datasets import Dataset

# Load environment variables

# Apply nest_asyncio to allow nested event loops

nest_asyncio.apply()

# Set up OpenAI API key

os.environ["OPENAI_API_KEY"] = "Your API Key"

client = openai.OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
Importar las bibliotecas y módulos en el código te permitirá llamar y usar sus funciones. La clave de OpenAI te ayudará a autenticarte en OpenAI al realizar llamadas a la API. Si no tienes una, dirígete a la página de la API de OpenAI y genera una.
Carga y preparación de documentos
A continuación, cargaremos nuestros documentos y los prepararemos para su procesamiento:
# Load PDF documents from a directory

pdf_loader = DirectoryLoader("/content/data", loader_cls=PyPDFLoader)

documents = pdf_loader.load()

# Ensure each document has a filename in its metadata

for document in documents:

    document.metadata['filename'] = document.metadata['source'
El código carga documentos PDF desde un directorio usando la clase PyPDFLoader. Luego crea una instancia de DirectoryLoader, carga los documentos e itera por cada documento para añadir un atributo filename a sus metadatos. Esto garantiza que cada documento esté correctamente identificado y gestionado con su nombre de archivo correspondiente. Este paso es crucial, ya que constituye la base de conocimiento de nuestro sistema RAG. Estamos usando documentos PDF en este ejemplo, pero podrías adaptarlo a otros tipos de documentos según sea necesario.
Generación de un conjunto de prueba
Ahora que has cargado los datos, necesitas un conjunto diverso de preguntas de prueba para ayudar a evaluar eficazmente nuestro sistema RAG. Usaremos el framework Ragas para generar un conjunto de prueba sintético.
# Initialize OpenAI models for test set generation

generator_llm = ChatOpenAI(model="gpt-3.5-turbo-16k")

critic_llm = ChatOpenAI(model="gpt-4")

embeddings = OpenAIEmbeddings()

# Create a TestsetGenerator

generator = TestsetGenerator.from_langchain(

    generator_llm,

    critic_llm,

    embeddings

)

# Generate synthetic test set with 10 samples

testset = generator.generate_with_langchain_docs(documents, test_size=10, distributions={simple: 0.5, reasoning: 0.25, multi_context: 0.25})

# Convert test set to Pandas DataFrame

testset_df = testset.to_pandas()

print(testset_df)
Este código inicializa dos modelos de lenguaje (gpt-3.5-turbo-16k para generar conjuntos de prueba y gpt-4 para la evaluación) y un modelo de embeddings de OpenAI. Luego crea una instancia de TestsetGenerator usando estos modelos. El generador produce un conjunto de prueba sintético de 10 muestras a partir de los documentos PDF cargados, con distribuciones especificadas para diferentes tipos de preguntas. Este conjunto de prueba te ayudará a evaluar varios aspectos del rendimiento de tu sistema RAG, incluida su capacidad para manejar consultas simples, tareas de razonamiento y preguntas que requieren múltiples contextos. Aquí tienes un ejemplo de un conjunto de prueba generado.
 Fig 2- Conjunto de prueba generado usando Ragas
La verdad fundamental es la respuesta real a una pregunta dada. Más adelante la usaremos para medir qué tan bien funciona nuestro sistema RAG según qué tan cercana sea su salida a estas respuestas correctas. Como señala Shahul en la charla, generar el conjunto de prueba sintético usando Ragas no significa que lo uses a ciegas. Tienes que filtrar y usar las muestras que necesitas.
Ya que tienes el conjunto de prueba, construyamos un sistema RAG simple impulsado por Milvus y luego evaluémoslo usando el conjunto de prueba anterior.
Configuración de Milvus e inserción de embeddings de documentos
Ahora, configuremos nuestra base de datos vectorial Milvus e insertemos los embeddings de nuestros documentos. Asegúrate de tener Milvus instalado y en ejecución. Si no es así, sigue esta guía completa de instalación de Milvus.
# Connect to Milvus instance

milvus_client = MilvusClient(uri="http://localhost:19530")

# Define collection name

collection_name = "pdf_collection"

# Drop the collection if it already exists

if milvus_client.has_collection(collection_name):

    milvus_client.drop_collection(collection_name)

# Create a new collection

milvus_client.create_collection(

    collection_name=collection_name,

    dimension=768,  # Dimension of vectors

    overwrite=True

)

# Initialize the embedding function

embedding_fn = model.DefaultEmbeddingFunction()

# Extract document texts and generate embeddings

expanded_docs = [doc.page_content for doc in documents]

expanded_vectors = embedding_fn.encode_documents(expanded_docs)

# Prepare data for insertion

expanded_data = [

    {"id": i, "vector": expanded_vectors[i], "text": expanded_docs[i], "subject": "pdf_documents"}

    for i in range(len(expanded_vectors))

]

# Insert expanded data into the collection

milvus_client.insert(data=expanded_data, collection_name=collection_name)
El código anterior se conecta a una instancia de Milvus y configura una colección llamada pdf_collection para almacenar vectores de documentos. Si la colección ya existe, la elimina y la vuelve a crear con una dimensión de 768 para los vectores. Inicializa una función de embedding, extrae texto de los documentos cargados y genera sus embeddings. Luego, el código prepara los datos con embeddings y texto asociado e inserta estos datos en la colección de Milvus. Este paso es donde Milvus realmente destaca, ya que te permite realizar búsquedas de similitud rápidas y eficientes en los embeddings de datos almacenados, lo cual es crucial para la parte de recuperación de tu sistema RAG.
Realizar una búsqueda de similitud
Con tus documentos indexados en Milvus, ahora puedes realizar búsquedas de similitud para recuperar contextos relevantes para nuestras preguntas:
# Define the search parameters

search_params = {"metric_type": "COSINE", "params": {"nprobe": 20}}  # nprobe for better recall

# Perform the search

query_vectors = embedding_fn.encode_queries(testset_df['question'].tolist())

results = milvus_client.search(

    collection_name=collection_name,

    data=query_vectors,

    anns_field="vector",  # specify the vector field name

    search_params=search_params,

    limit=3,  # number of top results to retrieve

    output_fields=["id", "text"]

)
El código anterior configura los parámetros de búsqueda para la colección de Milvus usando similitud coseno y un valor de nprobe de 20 para una mejor recuperación. Codifica las preguntas del conjunto de prueba en vectores de consulta y realiza una búsqueda en la colección pdf_collection, recuperando los tres vectores más similares para cada consulta. Los resultados de búsqueda incluyen los IDs y el text de los documentos coincidentes.
Generar respuestas usando un modelo de lenguaje grande
Con los contextos relevantes recuperados, ahora puedes generar respuestas usando un modelo de lenguaje. En este caso, usaremos GPT 3.5 turbo.
# Function to generate answers using OpenAI

def generate_answer(question, contexts):

    context_text = " ".join(contexts)

    messages = [

        {"role": "system", "content": "You are a helpful assistant."},

        {"role": "user", "content": f"Context: {context_text}nnQuestion: {question}nAnswer:"}

    ]

    response = client.chat.completions.create(

        model="gpt-3.5-turbo",

        messages=messages,

        max_tokens=100,

        temperature=0.7,

    )

    return response.choices[0].message.content.strip()

# Extract contexts and generate answers using OpenAI

contexts = []

answers = []

for i, result in enumerate(results):

    context = [match['entity']['text'] for match in result]

    contexts.append(context)

    question = testset_df['question'].iloc[i]

    answer = generate_answer(question, context)

    answers.append(answer)
El código define una función generate_answer que usa el modelo gpt-3.5-turbo de OpenAI para generar respuestas basadas en una pregunta y un contexto dados. Prepara mensajes para la llamada a la API, concatena el contexto y consulta el modelo. Luego extrae y devuelve la respuesta generada. El bucle posterior itera por los resultados de búsqueda y usa la función generate_answer para generar respuestas para cada pregunta del conjunto de prueba, almacenando los contextos y las respuestas en listas. Las preguntas usadas en el bucle para generar respuestas son las mismas que se generaron en el conjunto de prueba.
Como ahora tienes las respuestas generadas por el sistema RAG y las respuestas de referencia, evaluemos qué tan bien está funcionando el sistema RAG.
Evaluar el sistema RAG
Finalmente, evaluaremos el rendimiento de nuestro sistema RAG usando las métricas discutidas anteriormente:
# Ensure all lists are the same length

min_length = min(len(testset_df['question']), len(testset_df['ground_truth']), len(answers), len(contexts))

questions = testset_df['question'][:min_length]

ground_truths = testset_df['ground_truth'][:min_length]

answers = answers[:min_length]

contexts = contexts[:min_length]

# Create the dataset with correct column names

data = {

    "question": questions,

    "answer": answers,

    "contexts": contexts,

    "ground_truth": ground_truths

}

from datasets import Dataset

# Convert dict to dataset

dataset = Dataset.from_pandas(pd.DataFrame(data))

# Evaluate using RAGAS

metrics = evaluate(

    dataset=dataset,

    metrics=[

        answer_correctness,

        context_precision,

        context_recall,

        faithfulness,

        answer_relevancy,

    ],

    raise_exceptions=False  #handle async issues

)

# Convert result to DataFrame for better readability

result_df = metrics.to_pandas()

print(result_df)
El código garantiza la consistencia en el proceso de evaluación al recortar todas las listas relevantes a la misma longitud mínima. Esto evita longitudes no coincidentes que podrían causar errores durante la evaluación. Luego crea un diccionario con estas listas recortadas y lo convierte en un DataFrame de Pandas, que después se transforma en un Dataset de Hugging Face. Este conjunto de datos estructurado permite una evaluación sistemática utilizando el marco RAGAS, que compara las respuestas generadas con las verdades fundamentales. Las métricas de evaluación (corrección de la respuesta, precisión del contexto, recuperación del contexto, fidelidad y relevancia de la respuesta) proporcionan una evaluación del rendimiento del pipeline RAG.
Echa un vistazo a los resultados de la evaluación a continuación:
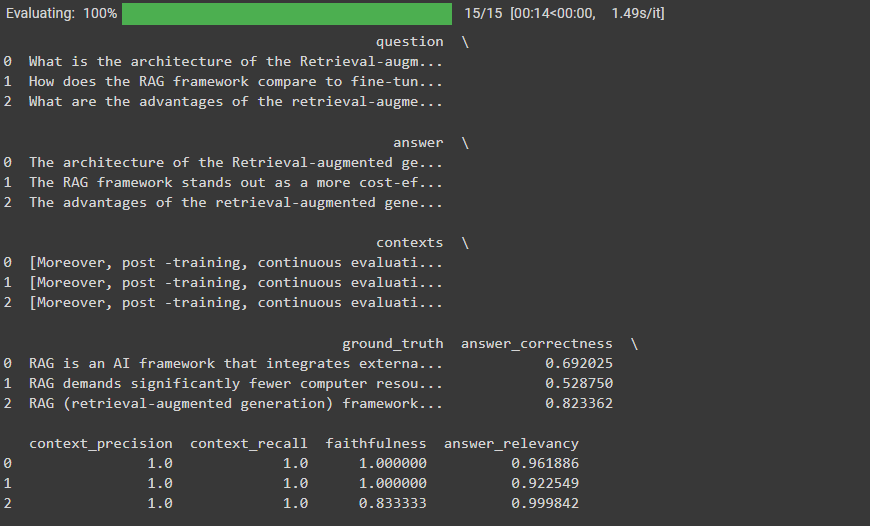 Fig. 3: resultados de evaluación del sistema RAG con Ragas
La precisión del contexto de nuestro sistema RAG y la recuperación son excelentes, y la relevancia de la respuesta es encomiable. Pero la corrección de la respuesta es bastante baja.
El lado de la recuperación es bueno debido a la excelente recuperación y precisión del contexto. Así que podemos concluir que la parte de generación podría estar afectando la corrección de nuestras respuestas. Para mejorar esto, puedes usar un modelo de generación de respuestas más potente como GPT-4.
Conclusión
Evaluar y mejorar los sistemas de generación aumentada por recuperación (RAG) es una tarea matizada pero esencial en el ámbito de la recuperación de información impulsada por IA. Al aprovechar un enfoque basado en métricas, como demostraron Jithin James y Shahul Es, puedes perfeccionar sistemáticamente tus sistemas RAG para asegurarte de que entreguen información precisa, relevante y confiable.
Para obtener más detalles sobre este tema, mira la repetición de la charla en YouTube.
Recursos adicionales
Sigue leyendo
The AWS Outage Was a Wake-Up Call for Vector Database Cross-Region Disaster Recovery
Zilliz Cloud Had the Answer Before the Crisis. Zilliz Cloud is the world's first vector database with native cross-region disaster recovery.
1 Table = 1000 Words? Foundation Models for Tabular Data
TableGPT2 automates tabular data insights, overcoming schema variability, while Milvus accelerates vector search for efficient, scalable decision-making.
What is the K-Nearest Neighbors (KNN) Algorithm in Machine Learning?
KNN is a supervised machine learning technique and algorithm for classification and regression. This post is the ultimate guide to KNN.