Plugin de recuperación de ChatGPT con Zilliz y Milvus
Introducción
OpenAI, el laboratorio de investigación de inteligencia artificial, anunció recientemente que había liberado como código abierto el código de un plugin de recuperación de base de conocimiento. Este proyecto, en el que participé, permite a ChatGPT ampliar su información recuperando datos basados en conocimiento a partir de fragmentos de documentos relevantes de diversas fuentes de datos. En esta publicación del blog, analizaré las implicaciones de este proyecto y los beneficios que ofrece para las empresas.
El plugin de recuperación de base de conocimiento
El plugin de recuperación de base de conocimiento es una herramienta que permite a ChatGPT recuperar información de fragmentos de documentos relevantes alojados por un tercero. ChatGPT puede recuperar datos pertinentes de diversas fuentes que hayas recopilado y almacenado, como archivos, notas o correos electrónicos, haciendo preguntas o expresando necesidades en lenguaje natural. Esta función ofrece una forma fácil y eficiente para que ChatGPT recupere información, haciéndolo más preciso y fiable.
Beneficios para las empresas
Las empresas pueden beneficiarse enormemente de este plugin al poner sus documentos internos a disposición de sus empleados a través de ChatGPT. Esto ofrece una forma simplificada para que los empleados recuperen información de documentos internos sin buscar en múltiples fuentes. También garantiza que la información recuperada sea precisa y esté actualizada. Los desarrolladores también pueden usar este plugin para alojar sus propias bases de conocimiento, lo que facilita la recuperación de datos de sus propias fuentes.
Cómo funciona
El plugin utiliza el modelo de embeddings text-embedding-ada-002 de OpenAI para generar embeddings de fragmentos de documentos y luego almacena y consulta el embedding en una base de datos vectorial. Aquí es donde entro yo. Trabajé con el equipo de OpenAI para hacer que Milvus y Zilliz fueran unas de las bases de datos vectoriales preferidas para almacenar estos embeddings.
La API simple expone los endpoints del plugin para insertar o actualizar, consultar y eliminar documentos. Puedes refinar sus resultados de búsqueda usando filtros de metadatos por fuente, fecha, autor, etc. Para mantener Milvus o Zilliz actualizados con los documentos más recientes, el plugin puede procesar y almacenar documentos continuamente desde diversas fuentes de datos, usando webhooks entrantes hacia los endpoints de inserción/actualización y eliminación.
Aquí tienes un ejemplo rápido usando el Zilliz Plugin para encontrar la política de DRM dentro de los términos de servicio (TOS) de Apple. ChatGPT comienza buscando el prompt dentro de Zilliz Cloud y luego resume los resultados. ChatGPT luego accede a Zilliz a través del plugin de recuperación para buscar los datos más relevantes.
Cómo configurar Zilliz Cloud
Con Zilliz Cloud simplemente necesitas crear una cuenta y configurar tu instancia con tus embeddings. Aquí está la guía de inicio rápido y las variables de entorno en el plugin de recuperación que necesitas configurar:
Variables de entorno
| Nombre | Requerido | Descripción |
|---|---|---|
DATASTORE | Sí | Nombre del datastore, establecido en zilliz |
BEARER_TOKEN | Sí | Tu token secreto |
OPENAI_API_KEY | Sí | Tu clave API de OpenAI |
ZILLIZ_COLLECTION | Opcional | Nombre de la colección de Zilliz. Por defecto, un UUID aleatorio |
ZILLIZ_URI | Opcional | URI para la instancia de Zilliz |
ZILLIZ_USER | Opcional | Nombre de usuario de Zilliz |
MILVUS_USER | Opcional | Contraseña de Zilliz |
Una vez que tengas esto configurado, ejecuta la siguiente prueba para confirmar que la integración funciona con este comando.
pytest ./tests/datastore/providers/zilliz/test_zilliz_datastore.py
Cómo configurar Milvus
Por supuesto, si prefieres Milvus de código abierto, puedes implementar y gestionar Milvus usando Docker Compose, Helm, K8's Operator o Ansible. Sigue las instrucciones para empezar.
Variables de entorno
| Nombre | Obligatorio | Descripción |
|---|---|---|
DATASTORE | Sí | Nombre del datastore, establecido en milvus |
BEARER_TOKEN | Sí | Tu bearer token |
OPENAI_API_KEY | Sí | Tu clave de API de OpenAI |
MILVUS_COLLECTION | Opcional | Nombre de la colección de Milvus, por defecto es un UUID aleatorio |
MILVUS_HOST | Opcional | IP del host de Milvus, por defecto es localhost |
MILVUS_PORT | Opcional | Puerto de Milvus, por defecto es 19530 |
MILVUS_USER | Opcional | Nombre de usuario de Milvus si RBAC está habilitado, por defecto es None |
MILVUS_PASSWORD | Opcional | Contraseña de Milvus si es necesaria, por defecto es None |
Una vez que tengas esto configurado, ejecuta la siguiente prueba para confirmar que la integración funciona con este comando.
pytest ./tests/datastore/providers/milvus/test_milvus_datastore.py
Implementa el plugin
Con el plugin probado, podemos pasar a implementarlo. ChatGPT accede a los plugins enviando solicitudes a dondequiera que se esté ejecutando tu servidor de plugin, ya sea Amazon ECS, Fly.io, Heroku, etc. Para obtener una guía detallada sobre cómo configurar esto, consulta la sección Deployment en el readme.
La función Memory
Una de las funciones interesantes de este nuevo plugin es una función que llaman memory. Esto le da a ChatGPT la capacidad de recordar información de las conversaciones y almacenarla en una base de datos vectorial para usarla más tarde.
Agradecimientos
Este fue un proyecto divertido y me gustaría agradecer al equipo de OpenAI de Isabella Fulford y al equipo de Ziliz de Frank Liu y Robert Guo. Si tienes algún comentario o quieres probarlo por ti mismo, consulta el repositorio de GitHub. ¡Personalmente, estoy deseando contribuir a una de las muchas grandes ideas enumeradas en el readme de ChatGPT Retrieval Plugin!
Sigue leyendo
What Is a Vector Lakebase?
A Vector Lakebase is a unified, lake-native data architecture for AI that combines vector-database-grade serving with open lake storage, reusable lake-level indexes, and a shared semantic layer.
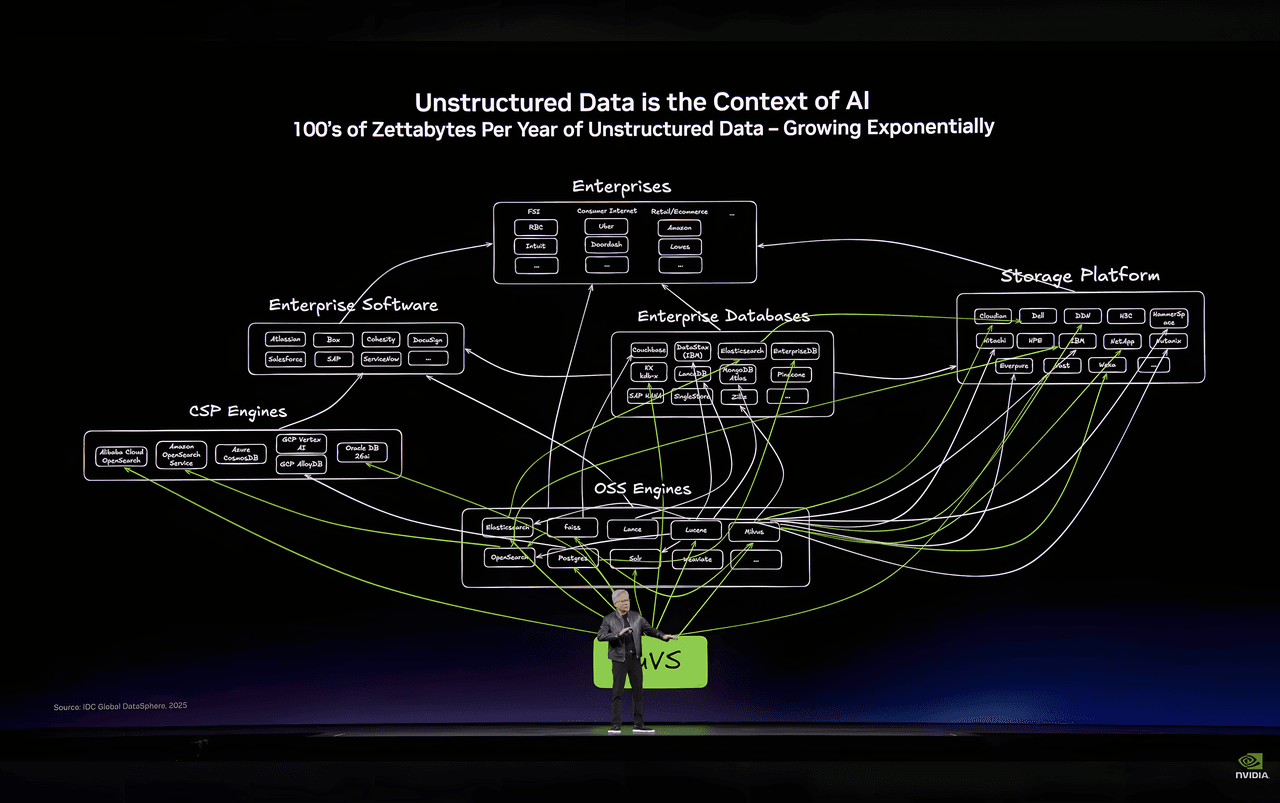
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.

Zilliz Named "Highest Performer" and "Easiest to Use" in G2's Summer 2025 Grid® Report for Vector Databases
Zilliz shines in G2's Summer 2025 Grid® Report as both "Highest Performer" and "Easiest to Use," solving the performance-usability dilemma.